

Python矩阵运算报错ValueError:shapes not aligned怎么解决
详细解析Python中NumPy进行矩阵乘法时报错ValueError: shapes not aligned的根本原因、四步排查流程、高频场景解决方案与防御性编码技巧。
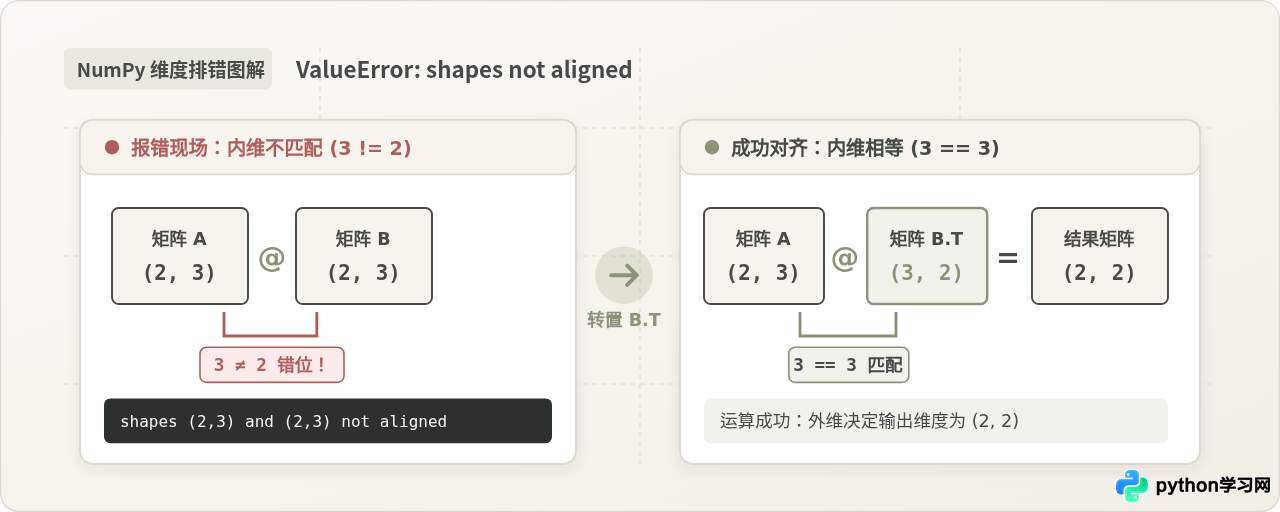
在 Python 中使用 NumPy 进行矩阵乘法运算(如 @ 运算符或 np.dot() 函数)时,若抛出类似 ValueError: shapes (2,3) and (2,3) not aligned: 3 (dim 1) != 2 (dim 0) 的异常,核心原因是左侧矩阵的列数(第 1 维)与右侧矩阵的行数(第 0 维)不相等,直接违反了线性代数中矩阵点积的“内维对齐”规则。标准排查与修复路径是:首先打印参与运算数组的 .shape 锁定冲突维度;其次确认数学意图——若为对应元素相乘则改用 *,若为线性代数点积则通过转置(.T)或 .reshape() 调整轴向;最后核实数组是否为一维数组,防止出现 1D 数组转置失效的隐蔽问题。
一、报错表现与核心机理剖析
在数据分析、机器学习建模或数值计算中,矩阵运算几乎无处不在。当我们在控制台中看到如下报错堆栈时,通常意味着 NumPy 拒绝执行当前的乘法指令:
仔细阅读这行提示信息,NumPy 已经准确指出了问题所在:
shapes (2,3) and (2,3):表示参与乘法的左操作数形状为 2 行 3 列,右操作数形状也是 2 行 3 列。not aligned:意为“未对齐”,说明两者的形状在代数规则上无法直接衔接。3 (dim 1) != 2 (dim 0):清晰交代了冲突细节——左矩阵的第 1 维(即列数,长度为 3)不等于右矩阵的第 0 维(即行数,长度为 2)。
从线性代数的数学法则来看,两个二维矩阵能够进行点积乘法 $A imes B$ 的充要条件是:$A$ 矩阵的列数等于 $B$ 矩阵的行数。若 $A$ 的形状为 $(M, K)$,$B$ 的形状必须为 $(K, N)$。运算过程中,$A$ 的每一行向量与 $B$ 的每一列向量进行内积求和,最终生成的矩阵形状为 $(M, N)$。这里的 $K$ 被称为内维(Inner Dimension),而 $(M, N)$ 则称为外维(Outer Dimension)。
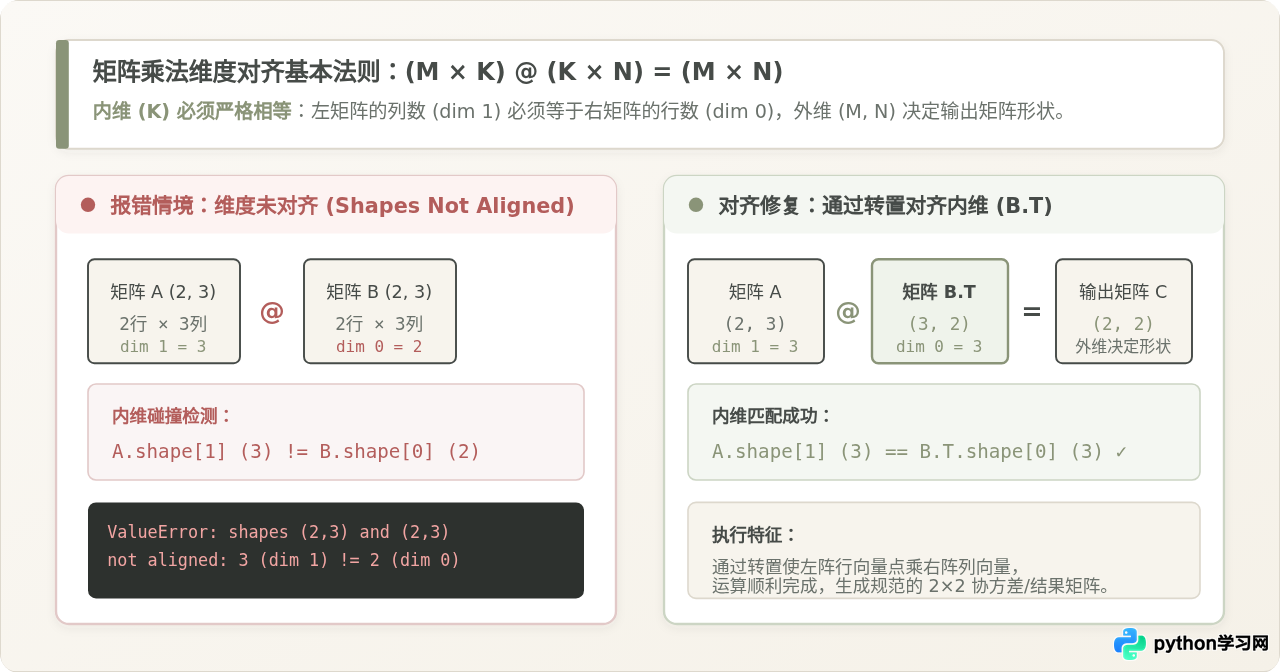
当左矩阵的每一行包含 3 个元素,而右矩阵的每一列仅有 2 个元素时,计算机在逐元素相乘并累加时会发现元素数量无法一一对应,因此 NumPy 抛出 shapes not aligned 保护程序不产生未定义行为。
二、标准四步排查与修复流程
面对维度未对齐的报错,建议按照以下经过实践检验的四步工作流进行系统化排查,避免盲目猜测或随意修改代码。
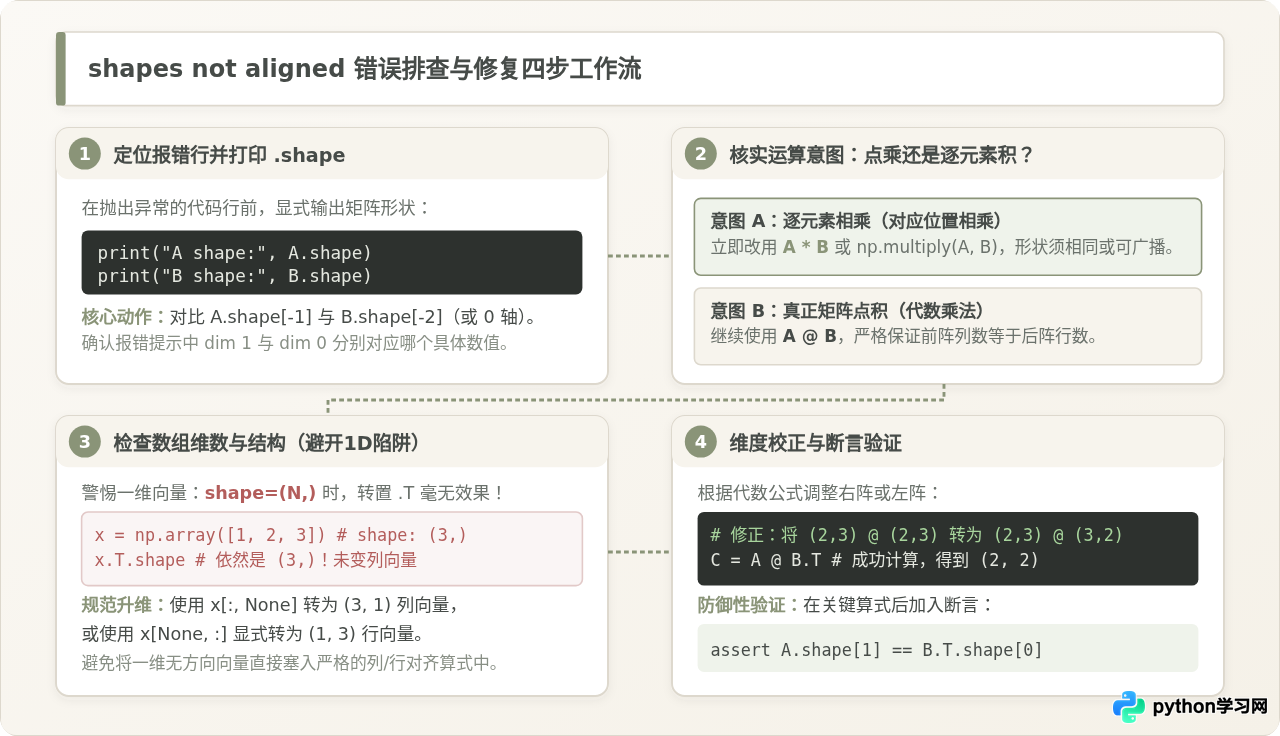
步骤一:定位报错行并打印数组形状
根据 Python 抛出的回溯信息(Traceback),定位到具体执行矩阵乘法的那一行代码。在执行计算之前,显式添加打印语句输出两个数组的 .shape 属性:
# 在运算前检查实际维度
print("Left matrix shape:", A.shape)
print("Right matrix shape:", B.shape)
result = A @ B  # 报错位置
判断依据:比对 A.shape[-1] 是否等于 B.shape[-2](对于二维数组即 A.shape[1] == B.shape[0])。若不相等,记录两者具体差值。
步骤二:核实运算意图:点乘还是逐元素积?
初学者最容易混淆的两种乘法:
- 逐元素乘法(Element-wise Multiplication):要求两个矩阵维度完全相同(或满足广播规则),对应位置元素相乘,符号为
*。 - 矩阵点乘(Dot / Matrix Multiplication):属于线性代数矩阵乘法,要求内维相等,符号为
@或函数np.dot()。
如果你的本意只是让两个数组中相同坐标的数值相乘,那么问题在于误用了点乘符号,直接将 @ 换回 * 即可解决。
步骤三:检查数组维数与结构(警惕 1D 数组)
若数学逻辑确为矩阵点积,紧接着检查参与运算对象的维度数量(ndim)。特别注意形如 (N,) 的一维向量。在 NumPy 中,一维向量既不是严格的行向量也不是严格的列向量,对其调用 .T 是不会改变任何维度的。必须通过重塑或扩维将其显式升级为严格的二维结构。
步骤四:实施对齐调整并添加断言验证
根据期望的数学结果,使用转置 .T、reshape() 或 np.newaxis 调整对应矩阵的轴向,并在关键运算后加入断言或形状检查,确保代码在后续维护中具有自检能力。
三、四类高频场景与对应代码解决方案
为了帮助读者快速对号入座,以下整理了日常开发中最常触发该报错的四类典型场景,并给出完整可执行的修复代码。
场景 1:混淆了逐元素相乘与矩阵点积
具体表现:有两个大小完全相同的矩阵(例如两个 $2 imes 3$ 的表格数据),希望求每个位置上数据的乘积,却随手写了 np.dot() 或 @。
import numpy as np

# 错误写法示例
a = np.array([[1, 2, 3], [4, 5, 6]])  # 形状 (2, 3)
b = np.array([[7, 8, 9], [1, 2, 3]])  # 形状 (2, 3)

# 误用了矩阵乘法 @ 导致报错
# c = a @ b  -> 报错 ValueError: shapes (2,3) and (2,3) not aligned: 3 != 2

# 正确修复方案:使用逐元素乘法运算符 *
c = a * b
print("逐元素相乘结果形状:", c.shape)
print("计算结果:
", c)场景 2:真正的矩阵点积,右侧矩阵遗漏转置
具体表现:例如在计算样本与特征权重、或者求相关系数矩阵时,样本矩阵 $X$ 为 $(N, D)$,权重或另一组特征 $W$ 也是 $(K, D)$。此时两者最后一维相同,若直接做 $X @ W$ 会因为 $D eq K$ 导致内维不匹配。
import numpy as np

# 场景:4 个样本,每个样本 3 个特征;以及 2 个类别,每个类别 3 个权重
X = np.random.randn(4, 3)  # (4, 3)
W = np.random.randn(2, 3)  # (2, 3)

# 错误运算:X @ W 会尝试拿 3(dim 1) 与 2(dim 0) 对齐,引发报错
# y = X @ W

# 正确修复方案:将 W 转置为 (3, 2),使内维 3 与 3 对齐
W_transposed = W.T
y = X @ W_transposed

print("输入 X 形状:", X.shape)
print("转置后权重形状:", W_transposed.shape)
print("输出 y 形状 (N, K):", y.shape)场景 3:一维数组(Rank-1 Array)转置失效陷阱
这是 NumPy 中最容易让初学者感到困惑的地方。许多人发现报错后,本能地在变量后加上 .T,结果发现依然报完全相同的错误。
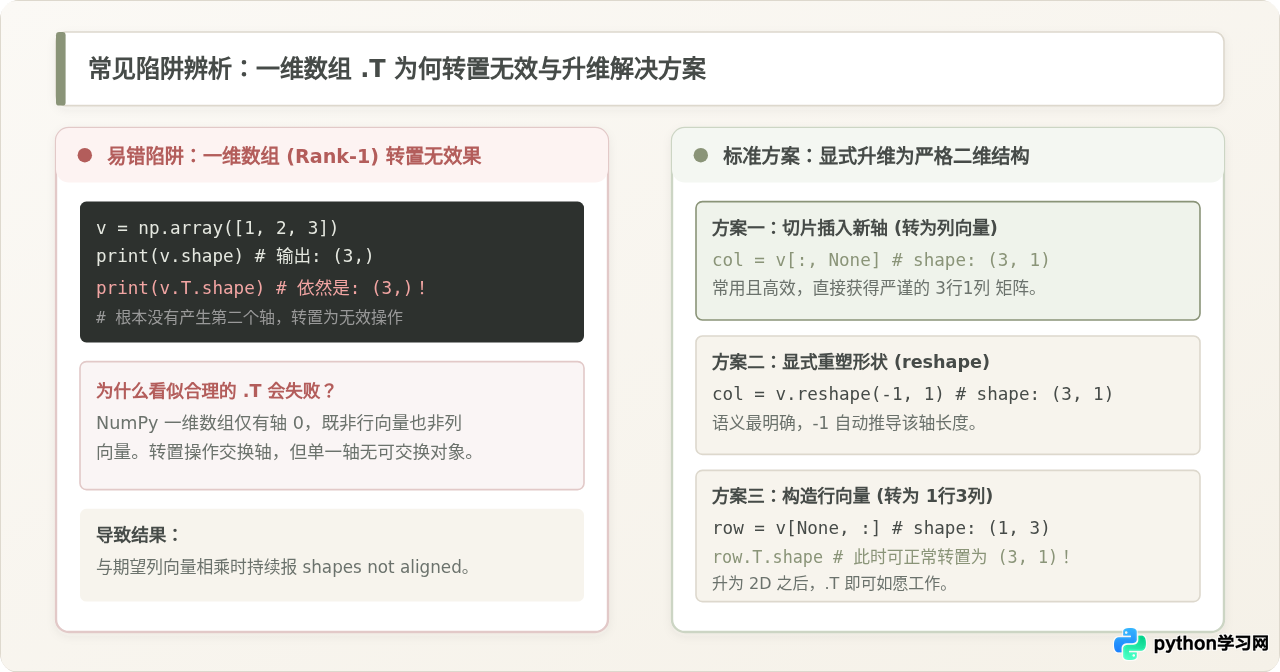
深入解释:当一个数组通过 np.array([1, 2, 3]) 创建时,其 shape 是 (3,)。它是一个秩为 1 的数组,只有一个轴(axis 0)。在线性代数中,转置操作的实质是“交换两个轴的索引”(行变列、列变行)。但对于只有一个轴的一维数组,根本没有第二个轴可供交换,因此 v.T 依然是 (3,),没有任何变化!
如果你需要一个严格的 $3 imes 1$ 列向量或 $1 imes 3$ 行向量,必须显式进行升维:
import numpy as np

v = np.array([1, 2, 3])  # shape: (3,)
M = np.array([[10, 20], [30, 40], [50, 60]])  # shape: (3, 2)

# 若需要将 v 视作 1x3 的行向量与 3x2 矩阵相乘:
# 方式 1:利用 np.newaxis 或 None 构造二维行向量
v_row = v[None, :]  # shape: (1, 3)
res_row = v_row @ M
print("行向量点乘结果形状:", res_row.shape)  # (1, 2)

# 若需要将 v 转换为 3x1 的列向量:
# 方式 2:使用 reshape(-1, 1)
v_col = v.reshape(-1, 1)  # shape: (3, 1)
print("显式列向量形状:", v_col.shape)

# 此时列向量可以正常与转置矩阵或外积运算对齐
out_outer = v_col @ v_row
print("外积矩阵形状 (3, 3):", out_outer.shape)场景 4:高维批量矩阵运算中的维度错位
在深度学习与时间序列处理中,数据往往带有 Batch 批次维度,例如形状为 (Batch, Sequence, Feature) 的三维数组。
在使用 @ 或 np.matmul() 时,NumPy 会将最后两个轴视作参与矩阵乘法的矩阵,而前面的轴作为批次进行广播匹配。如果数据形状是 (32, 10, 64),权重形状是 (128, 64),直接相乘就会出现 64 != 128 的错位。正确做法是将权重转置为 (64, 128),或者使用 np.transpose() 明确调整轴序列。
import numpy as np

batch_data = np.random.randn(32, 10, 64)  # (Batch=32, Seq=10, In_Dim=64)
linear_weight = np.random.randn(128, 64)   # (Out_Dim=128, In_Dim=64)

# 正确做法:转置权重后两个轴 (64, 128)
output = batch_data @ linear_weight.T
print("批量矩阵乘法成功,输出形状为:", output.shape)  # (32, 10, 128)
四、常见认知误区与辨析
在排查矩阵维度报错时,以下几个认知偏差常常会导致“代码修好了,但结果全错了”的情况,需要特别警惕:
| 常见说法 / 直觉认知 | 实际情况辨析 | 正确指导建议 |
|---|---|---|
| “只要两个数组元素总数相同,就能相乘” | 元素总数相同只能保证可以 reshape 成相同大小,矩阵点乘只认内维是否对齐。 |
永远检查 .shape,而不是 .size。 |
“报错了只要在右边矩阵加上 .T 就能解决” |
盲目转置虽然可能碰巧消除报错,但很可能改变了数学逻辑(如把行特征和列特征弄反)。 | 先在草稿纸或脑海中明确输入与输出的数学物理意义,再决定转置哪个对象。 |
“np.dot 和 @ 没有差别” |
对于 2D 矩阵两者结果相同;但对于多维数组,@ 执行标准的批次矩阵乘法,而 np.dot 执行复杂的张量缩并,极易导致高维形状失控。 |
现代 Python 代码中,进行矩阵运算优先推荐使用标准的 @ 运算符。 |
五、工程落地:防御性编程与预防体系
为了避免在复杂项目中频繁遭遇 shapes not aligned,建议在工程实践中建立以下三道防线:
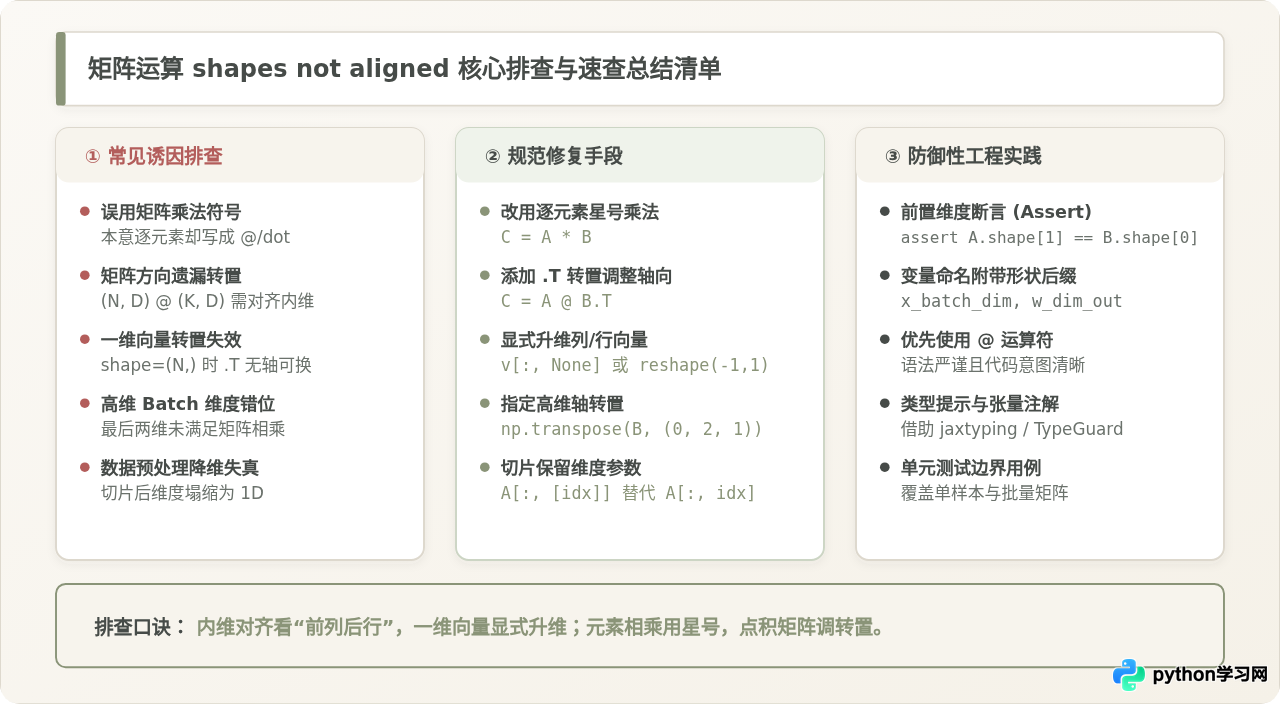
1. 在关键数学计算前添加前置断言(Assert Guard)
在编写自定义网络层、损失函数或特征转换函数时,直接在函数开头断言维度,能够将错误阻击在发生之前:
def calculate_projection(features, projection_matrix):
    # 防御性断言:检查内维对齐
    assert features.shape[1] == projection_matrix.shape[0],         f"维度未对齐!特征列数 ({features.shape[1]}) 与投影矩阵行数 ({projection_matrix.shape[0]}) 必须一致"
    return features @ projection_matrix
2. 变量命名中显式携带形状含义
在复杂的数学模型中,避免使用单一的 a、b、m 作为变量名。推荐使用类似 x_n_d(表示 $N imes D$)、w_d_k(表示 $D imes K$)的命名约定。在阅读代码 x_n_d @ w_d_k 时,内维的 d 一目了然,写错时能立即被人工审查发现。
3. 善用现代张量类型注解
在大型算法工程中,可以结合 Python 类型注解工具(如 jaxtyping 或利用注释声明维度规格),让 IDE 与静态检查工具协助捕获潜在的维度错位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









