

深入理解Python数据结构:切片、推导式与嵌套结构实战
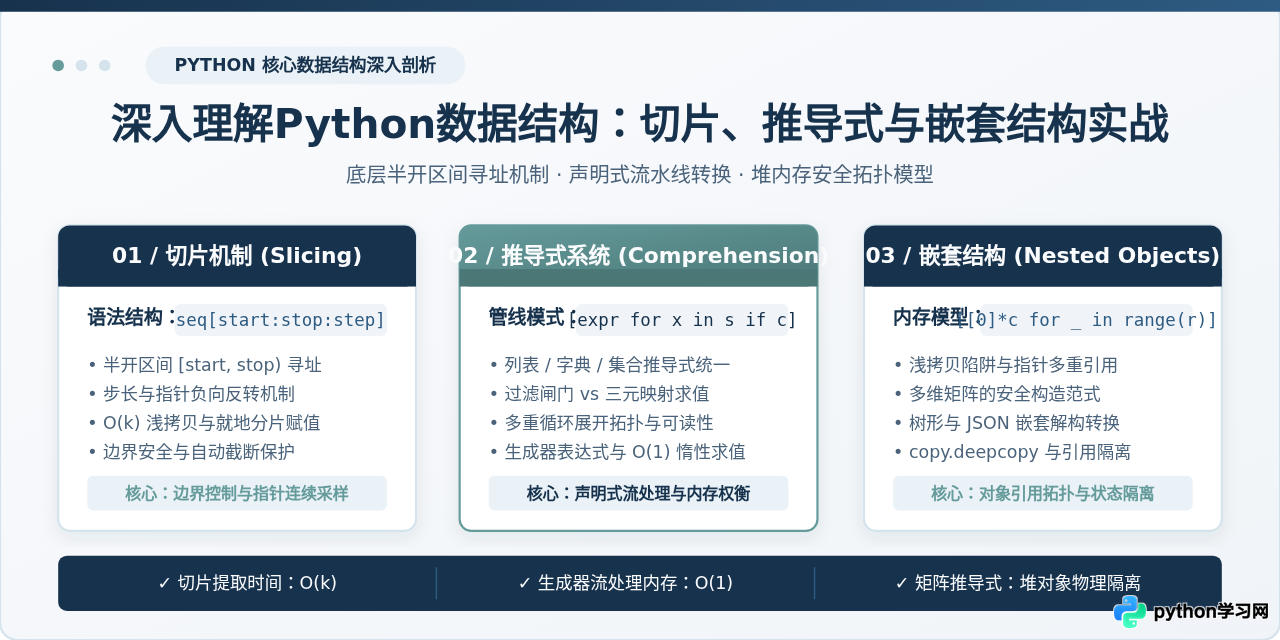
深入剖析Python中切片机制底层指针寻址、推导式数据流处理架构与多层嵌套数据结构的内存引用拓扑,结合实际业务场景提供避坑指南与高性能数据清洗实战方案。
一、切片机制深度剖析:从索引指针到底层半开区间
在 Python 中,切片(Slicing)是针对有序序列(如 list、tuple、str 等)进行子集提取、逆序翻转以及局部原地替换的高性能操作。切片的完整语法表达为 sequence[start:stop:step],它并非简单的语法糖,其底层实际上隐式创建了一个 slice(start, stop, step) 对象,并触发序列对象的 __getitem__ 或 __setitem__ 特殊方法。
1.1 为什么采用左闭右开区间 [start, stop)?
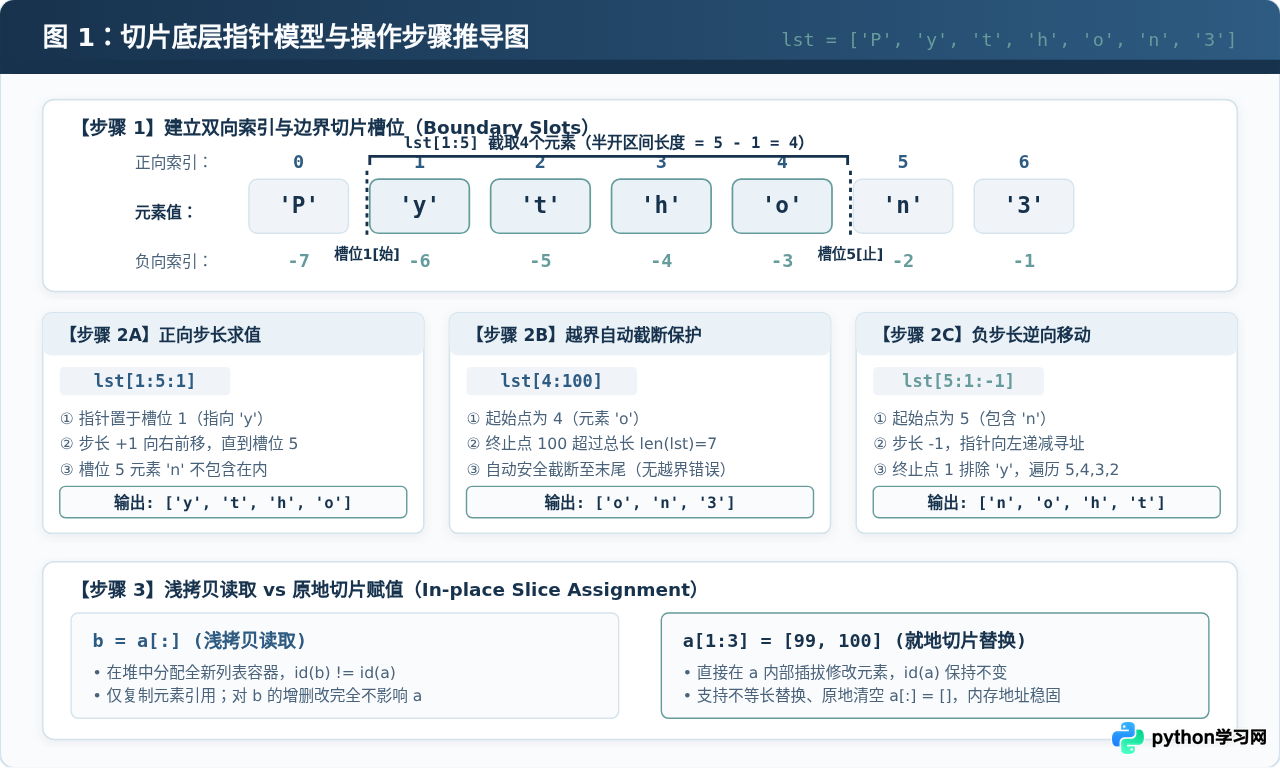
初学者常常困惑于为什么 lst[1:5] 包含下标 1 的元素却不包含下标 5 的元素。这种“左闭右开”(半开区间)设计源于计算机科学家 Edsger W. Dijkstra 的经典推导,在工程实践中具备显著的数学与编程优势:
- 子序列长度直观可见:截取结果的元素个数始终等于
stop - start。例如lst[1:5]的元素数量就是5 - 1 = 4个,无需在心智模型中进行“加一”或“减一”的偏移补偿。 - 相邻切片自然拼接:当以某个分割点
k拆分序列时,前半段seq[:k]与后半段seq[k:]能够无缝拼回原序列,即seq[:k] + seq[k:] == seq,既不会遗漏分界点元素,也不会产生重复项。 - 空区间表达明确:当
start == stop时,区间长度为 0,自然返回空序列,避免了边界重叠时的逻辑歧义。
1.2 边界处理与容错机制
单元素索引访问 seq[i] 在下标超出有效范围时会立即抛出 IndexError: list index out of range。但切片机制遵循容错截断原则:如果 start 或 stop 超过了序列边界,Python 解释器会自动将其规整为有效的极值边界(0 或 len(seq)),而绝不引发异常。例如对一个长度为 7 的列表执行 lst[4:100],解释器会自动将其收敛为 lst[4:7]。
1.3 负步长与反转机制
当 step 指定为负数时,切片指针的推进方向发生 180 度逆转,从右向左递减寻址。此时,start 必须位于 stop 的右侧(即 start > stop),否则返回空序列。最经典的表达式 lst[::-1] 中,由于未显式提供起点与终点,解释器会自动将 start 设定为末尾元素索引,stop 设定为超出最左边界的虚拟槽位,从而实现整个序列的高效反转。
1.4 切片的浅拷贝与切片赋值
切片在读取与写入场景下表现出截然不同的内存行为,这是编写安全代码的关键点:
- 浅拷贝读取(
b = a[:]):Python 会在堆内存中分配一个新的列表对象,并将其指针赋予b。虽然容器本身是全新的(id(b) != id(a)),但新容器中存储的元素依然是对原对象内部元素的浅层引用。对b执行append或删除操作不会波及a。 - 原地切片赋值(
a[start:stop] = iterable):等号左侧出现切片语法时,表示在原列表容器内部进行就地插拔与替换,原列表的内存地址(id(a))保持不变。这种赋值甚至支持不等长替换,例如a[1:3] = [10, 20, 30, 40]会直接将原本的两个元素替换为四个元素,原列表自动扩容。若执行a[:] = [],则可以在不改变对象引用的前提下将列表彻底清空。
# 切片读取与原地切片赋值代码示例
a = [10, 20, 30, 40, 50]
b = a[:]           # 创建浅拷贝
print("id(a) == id(b):", id(a) == id(b))  # False

# 原地切片替换(不等长替换)
old_id = id(a)
a[1:4] = [999]     # 将 [20, 30, 40] 替换为单个数字 999
print("更新后的 a:", a)
print("内存地址是否保持一致:", id(a) == old_id)

# 示例输出:
# id(a) == id(b): False
# 更新后的 a: [10, 999, 50]
# 内存地址是否保持一致: True
二、推导式(Comprehensions)精解与运行链路
推导式是 Python 提供的一种声明式(Declarative)构造容器的方法。相较于传统的 for 循环搭配 append() 调用,推导式在字节码层面由专门优化的 LIST_APPEND 等指令驱动,省去了每次循环中动态查找属性和函数调用的开销,因此执行速度更快、表达意图更直接。
2.1 列表、字典与集合推导式的规范范式
Python 支持三种核心容器的推导式语法,其统一范式如下:
- 列表推导式(List Comprehension):
[expression for item in iterable if condition],生成有序列表。 - 集合推导式(Set Comprehension):
{expression for item in iterable if condition},自动根据哈希去重。 - 字典推导式(Dict Comprehension):
{key_expr: value_expr for item in iterable if condition},用于快速重构映射表。
2.2 条件筛选 if 与三元映射 if-else 的严格区别
推导式中最常见的语法错误源于对 if 关键字摆放位置的混淆。在推导式中,if 可以承担两种完全不同的角色:
- 末尾的过滤闸门(Filter Gate):当
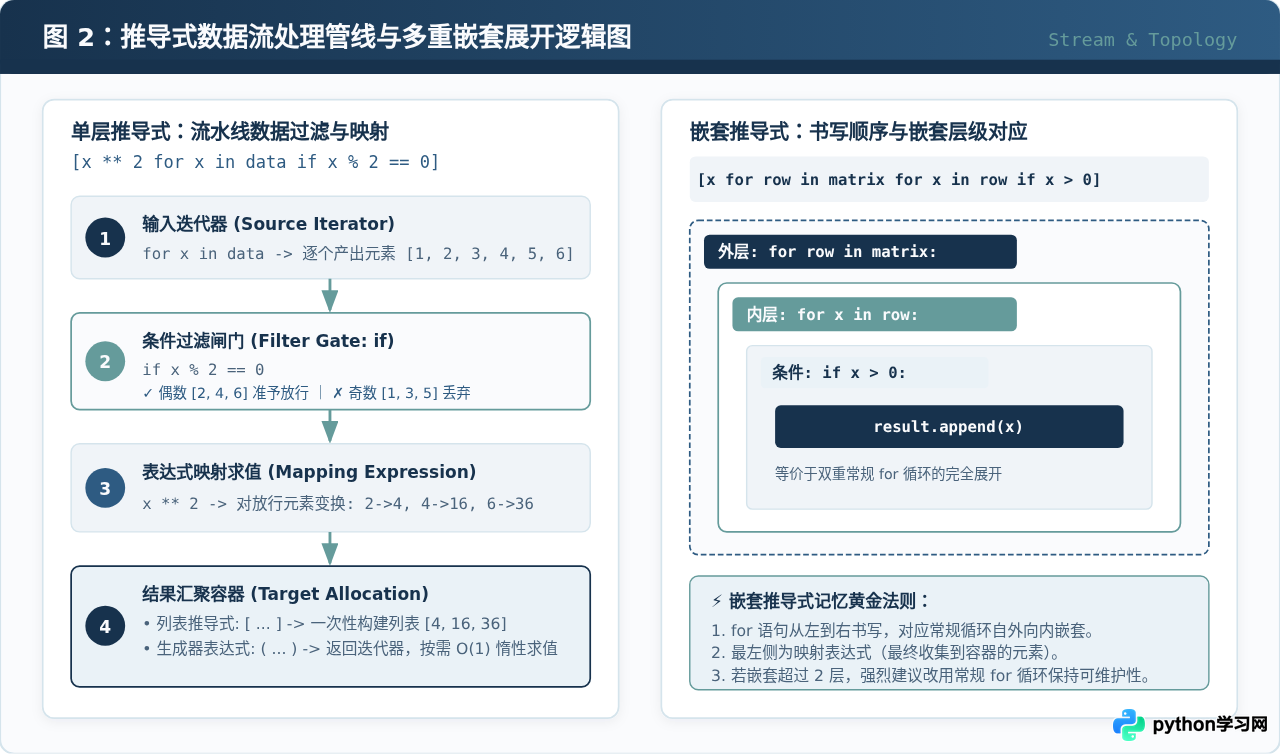
if位于for循环之后时(例如[x for x in seq if x > 0]),它充当布尔过滤器。只有满足条件的元素才会流向左侧表达式,不满足条件的元素直接被丢弃。此处绝对不能添加else子句。 - 开头的映射分支(Mapping Ternary Operator):当条件逻辑位于
for循环之前时(例如[x if x > 0 else 0 for x in seq]),它是一个三元条件表达式,用于决定最终产出值的具体内容。此处必须包含else子句,因为每个迭代出的元素都必须被映射为一个确定的值。
2.3 嵌套推导式的阅读法则:从左至右展开
面对包含多个 for 子句的复杂推导式时,牢记一条核心法则:书写顺序从左至右,严格对应常规循环从外向内的嵌套层级。例如扁平化一个二维矩阵:
# 嵌套推导式与等价常规循环对比
matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]

# 列表推导式单行写法
flattened = [item for row in matrix for item in row if item % 2 != 0]

# 等价的常规展开写法:
result = []
for row in matrix:          # 对应推导式中的第一个 for
    for item in row:        # 对应推导式中的第二个 for
        if item % 2 != 0:   # 对应推导式末尾的条件过滤
            result.append(item)

print("奇数扁平化结果:", flattened)

# 示例输出:
# 奇数扁平化结果: [1, 3, 5, 7, 9]for 循环,或封装为生成器函数(yield)。
2.4 生成器表达式:以 O(1) 内存拥抱海量数据
将列表推导式的方括号 [] 替换为圆括号 (),就得到了生成器表达式(Generator Expression)。列表推导式会立即在堆内存中开辟空间并一次性生成全部元素;而生成器表达式返回一个惰性求值的迭代器对象,只有在被显式迭代(例如通过 for 循环或 next())时才逐个产生元素,内存占用恒定为 O(1)。处理千万级大文件或长数据流时,生成器表达式是避免内存耗尽(OOM)的核心工具。
三、多维嵌套结构的内存拓扑与经典陷阱
在 Python 中,“变量是贴在对象上的标签”,这一引用模型在构建多维列表或复杂字典时尤其需要引起警惕。很多开发者在初始化多维矩阵时,由于误解了乘号操作符的语义,埋下了难以排查的状态联动 Bug。
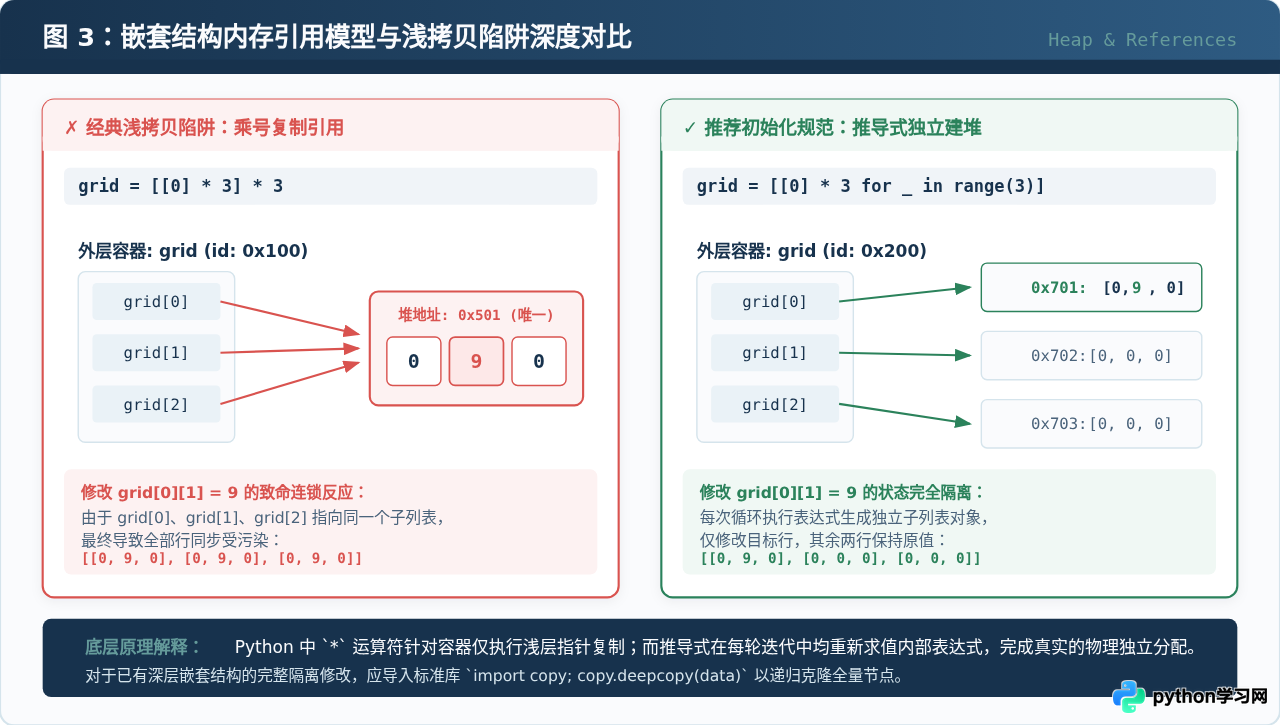
3.1 浅拷贝经典陷阱剖析:[[0] * 3] * 3 发生了什么?
当开发者希望创建一个 3x3 的全零矩阵时,常写出类似 grid = [[0] * 3] * 3 的代码。表面上打印出的结构完全符合预期,但当尝试修改某一个元素 grid[0][1] = 9 时,会发现 grid[1][1] 和 grid[2][1] 同样变成了 9!
造成这一现象的底层原因是:
- 表达式
[0] * 3首先在堆中分配了一个长度为 3 的子列表对象,假设其内存地址为0x501。 - 紧接着的外层乘法
[...] * 3,并没有克隆 3 份独立的子列表,而是将指向0x501的指针引用复制了 3 次,分别存入外部列表的槽位 0、1、2。 - 因此,
grid[0]、grid[1]和grid[2]在底层指向完全相同的同一个堆内存对象。对任何一行的修改,都会同步反映在所有行上。
3.2 正确的多维容器初始化方式
构建安全多维容器的标准做法是使用列表推导式:grid = [[0] * 3 for _ in range(3)]。在这段代码中,for _ in range(3) 驱动了 3 次独立循环迭代,内部表达式 [0] * 3 在每次迭代中都会被重新求值,从而在堆内存中独立分配 3 个互不干涉的新列表(内存地址分别为 0x701、0x702、0x703)。
# 错误与正确初始化的实际验证
# 错误方式
bad_grid = [[0] * 3] * 3
bad_grid[0][0] = 7
print("错误初始化修改后:", bad_grid)
print("各行地址是否相同:", id(bad_grid[0]) == id(bad_grid[1]))

# 正确方式
safe_grid = [[0] * 3 for _ in range(3)]
safe_grid[0][0] = 7
print("安全初始化修改后:", safe_grid)
print("各行地址是否相同:", id(safe_grid[0]) == id(safe_grid[1]))

# 示例输出:
# 错误初始化修改后: [[7, 0, 0], [7, 0, 0], [7, 0, 0]]
# 各行地址是否相同: True
# 安全初始化修改后: [[7, 0, 0], [0, 0, 0], [0, 0, 0]]
# 各行地址是否相同: Falsedict.copy(),必须显式调用标准库 import copy; copy.deepcopy(data) 进行递归全量复制。
四、综合实战演练:复杂嵌套业务数据的清洗与重塑
在实际生产项目中,后端服务经常需要对接第三方 API 返回的多层嵌套 JSON 数据。本节通过一个典型的电商订单日志处理案例,综合运用字典推导式、嵌套列表推导式与切片技术,完成从原始嵌套结构到目标数据结构的清洗与分页聚合。
4.1 业务场景与原始数据定义
假定我们接收到一批包含用户信息、多笔订单明细、商品类别与支付状态的原始数据结构如下:
# 原始业务嵌套数据
raw_data = {
    "batch_id": "BATCH-202610-01",
    "timestamp": "2026-10-31T12:00:00Z",
    "users": [
        {
            "uid": "U101",
            "name": "Alice",
            "tier": "VIP",
            "orders": [
                {"order_id": "ORD-01", "status": "PAID", "items": [{"name": "Python Book", "price": 89, "qty": 2}, {"name": "Mouse", "price": 120, "qty": 1}]},
                {"order_id": "ORD-02", "status": "CANCELLED", "items": [{"name": "Desk Mat", "price": 45, "qty": 1}]}
            ]
        },
        {
            "uid": "U102",
            "name": "Bob",
            "tier": "REGULAR",
            "orders": [
                {"order_id": "ORD-03", "status": "PAID", "items": [{"name": "Mechanical Keyboard", "price": 499, "qty": 1}]},
                {"order_id": "ORD-04", "status": "PAID", "items": [{"name": "USB Hub", "price": 79, "qty": 3}, {"name": "Cable", "price": 25, "qty": 2}]}
            ]
        },
        {
            "uid": "U103",
            "name": "Charlie",
            "tier": "VIP",
            "orders": [
                {"order_id": "ORD-05", "status": "PENDING", "items": [{"name": "Monitor", "price": 1899, "qty": 1}]}
            ]
        }
    ]
}
4.2 清洗任务目标
- 结构扁平化与字段提取:提取所有状态为
PAID(已支付)的商品行,计算每项商品的总金额(price * qty),并附带用户姓名与用户等级。 - 字典推导式快速索引:构建按订单号(
order_id)为键、订单内所有已支付商品总额为值的汇总字典。 - 安全切片分页与窗口抽样:将扁平化后的商品记录按总金额降序排列,利用切片提取指定页码的数据,并使用步长提取抽样日志。
4.3 完整清洗管道实现代码
# 数据清洗主程序
def process_order_pipeline(data, page=1, page_size=3):
    users = data.get("users", [])

    # 任务 1:双重嵌套推导式提取已支付的商品扁平清单
    paid_items = [
        {
            "uid": u["uid"],
            "user_name": u["name"],
            "user_tier": u["tier"],
            "order_id": ord_info["order_id"],
            "item_name": item["name"],
            "total_amount": item["price"] * item["qty"]
        }
        for u in users
        for ord_info in u.get("orders", [])
        if ord_info.get("status") == "PAID"
        for item in ord_info.get("items", [])
    ]

    # 任务 2:字典推导式汇总各订单实付总额
    # 利用 set 推导式先提取唯一的已支付 order_id
    paid_order_ids = {item["order_id"] for item in paid_items}
    order_summary = {
        oid: sum(it["total_amount"] for it in paid_items if it["order_id"] == oid)
        for oid in paid_order_ids
    }

    # 任务 3:排序并利用半开区间切片实现安全分页
    paid_items.sort(key=lambda x: x["total_amount"], reverse=True)
    start_idx = (page - 1) * page_size
    stop_idx = start_idx + page_size
    paged_result = paid_items[start_idx:stop_idx]  # 自动越界截断保护

    # 间隔采样(步长切片):隔行抽样检查
    sampled_items = paid_items[::2]

    return {
        "total_paid_items": len(paid_items),
        "order_summary": order_summary,
        "page_data": paged_result,
        "sampled_items": sampled_items
    }

# 执行清洗管道
result = process_order_pipeline(raw_data, page=1, page_size=2)
print("=== 订单实付汇总 ===")
print(result["order_summary"])
print("
=== 第 1 页分页数据(Top 2 高额商品)===")
for row in result["page_data"]:
    print(f"[{row['order_id']}] {row['item_name']} - ¥{row['total_amount']} ({row['user_name']})")

# 示例输出:
# === 订单实付汇总 ===
# {'ORD-01': 298, 'ORD-03': 499, 'ORD-04': 287}
#
# === 第 1 页分页数据(Top 2 高额商品)===
# [ORD-03] Mechanical Keyboard - ¥499 (Bob)
# [ORD-04] USB Hub - ¥237 (Bob)
五、工程避坑法则、性能考量与全景总结
在大型工业代码库中,代码不仅要追求运行正确,还需要平衡内存开销与团队维护成本。切片与推导式虽然精简优雅,但在极端场景下仍有边界陷阱需要注意。
| 技术机制 | 典型高频误区 | 底层风险后果 | 推荐规避与规范方案 |
|---|---|---|---|
| 切片机制 | 直接切片处理数百万级大列表 big_list[:half] |
产生新列表对象,引起峰值内存翻倍甚至 OOM | 使用 itertools.islice 实现无拷贝流式切片,或使用 memoryview 处理字节串 |
| 推导式 | 在过滤条件后添加 else 分支或滥用三重嵌套 |
触发 SyntaxError 语法错误,或导致代码难以排查 |
严格遵守“条件过滤在后,映射分支在前”;多重循环展开为常规函数 |
| 嵌套结构 | 使用乘法乘积初始化多维数组 [[None]*m]*n |
所有内部行共享同一对象引用,修改触发多行联动 | 始终使用推导式 [[None]*m for _ in range(n)] 确保独立堆分配 |
| 切片赋值 | 误以为 a[:] = [1, 2] 会新建变量 |
在原对象上就地修改,外部持有该列表引用的模块数据被篡改 | 需新建变量时使用 a = [1, 2],需更新全局共享容器时才用 a[:] = ... |
5.1 总结与技术选型建议
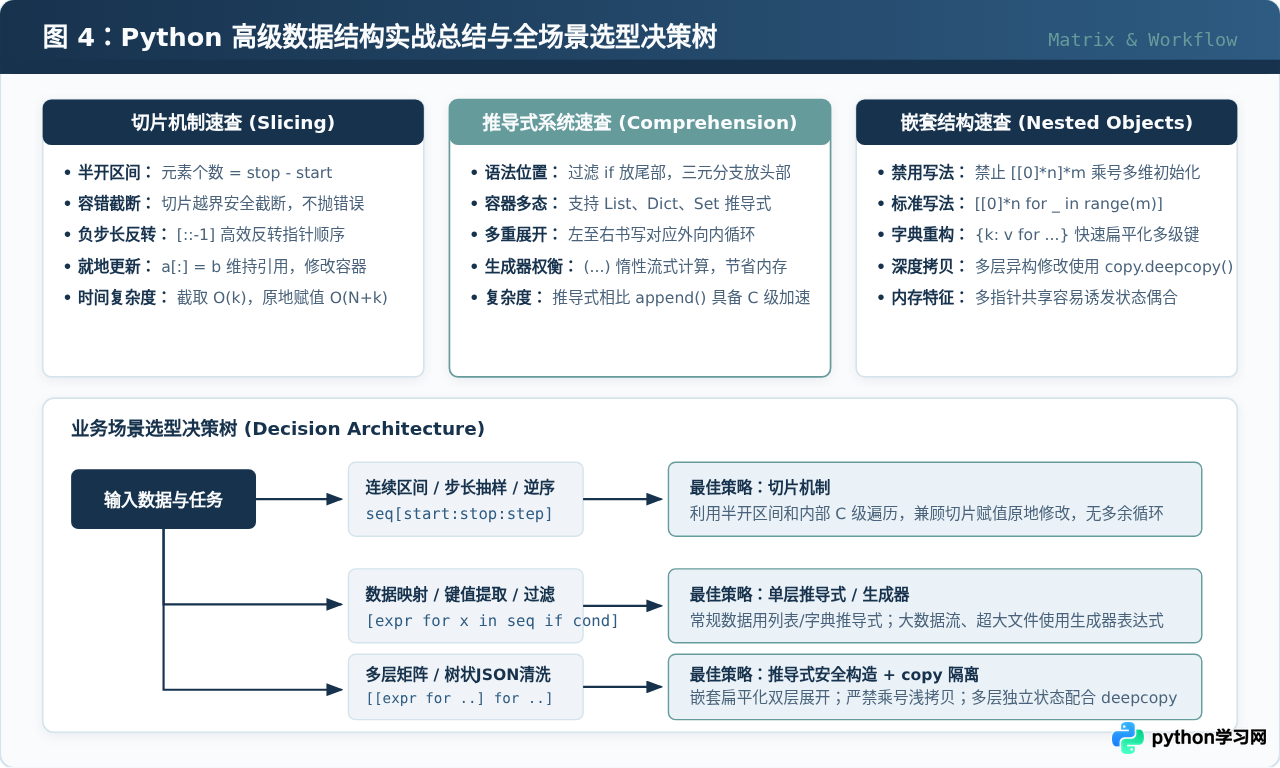
切片、推导式与嵌套结构是 Python 高阶数据操作的三大基石。在具体架构设计与业务开发中,建议遵循以下选型原则:
- 优先利用切片完成连续取样与逆序:序列切片直接由 CPython 底层内存块复制机制驱动,速度远快于手动循环
pop()或append()。 - 依据数据规模决策推导式与生成器:常规规模数据(万级以内)优先选用推导式,代码紧凑且具备 C 级指令加速;对于超大规模数据集或无限序列,必须切换为生成器表达式
(expr for x in seq),以恒定的 O(1) 空间复杂度守卫系统稳定性。 - 时刻保持对对象引用拓扑的敏锐度:牢记在 Python 中创建复合容器时,简单赋值与浅乘法均只传递内存指针。初始化多维矩阵请坚定使用推导式,面对复杂嵌套异构数据修改请使用深拷贝,从源头上杜绝隐式状态污染。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









