

Python数据分析常用第三方库:Pandas与NumPy核心用途解析
深入解析Python数据分析领域两大基石库NumPy与Pandas的核心用途、底层设计与协同模式。对比同构数组与异构表格、向量化与标签对齐,提供实操代码与选型决策指南。
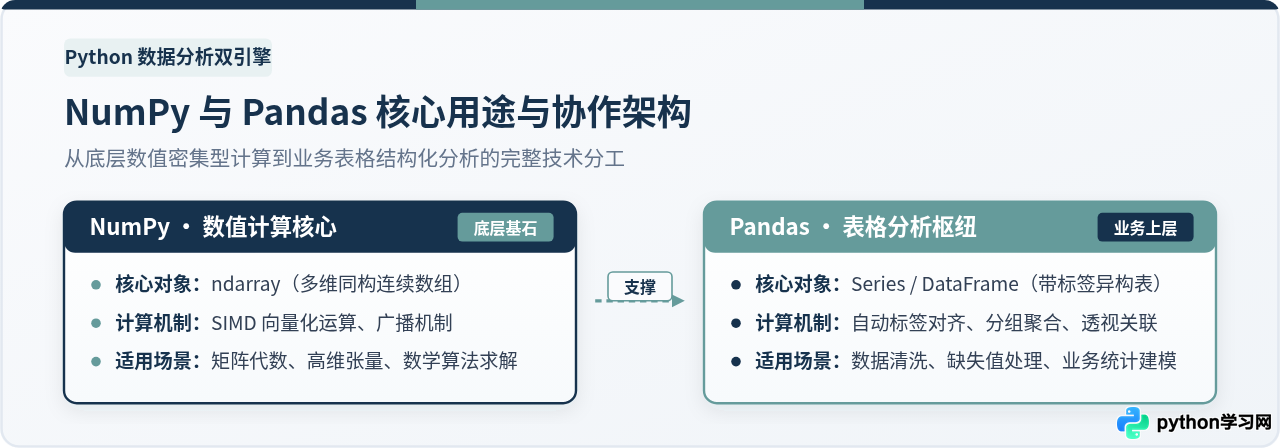
在 Python 数据分析与科学计算生态中,NumPy 专攻底层紧凑内存存储与高性能多维数值运算,是纯算法与矩阵代数的动力核心;Pandas 则构建在 NumPy 的数组基础之上,专门面向现实业务中的异构表格数据,提供以行列标签为轴心的清洗、对齐、分组聚合与多表关联能力。理解两者的分工边界与底层协同方式,是写出兼具执行性能与代码可维护性的数据分析程序的关键基石。
一、NumPy 核心用途与底层机制解析
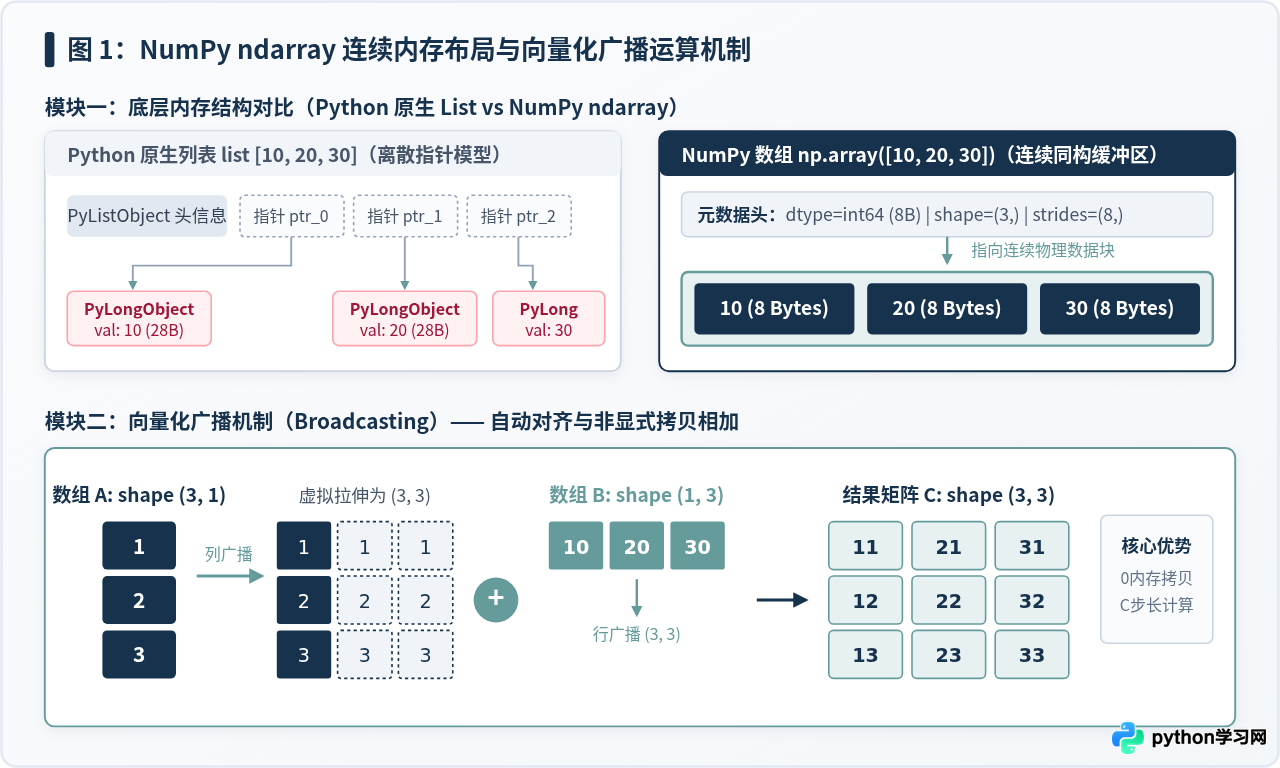
NumPy(Numerical Python)是整个 Python 科学计算技术栈的底层支柱。在没有 NumPy 时,Python 原生列表(list)由于其动态类型设计,内部仅保存指向各个具体 Python 对象的指针。每个对象(如 PyLongObject)不仅包含至少 28 字节的元数据开销,而且离散分散在系统内存的各个位置,这使得 CPU 在遍历计算时频繁发生缓存未命中(Cache Miss),计算效率极低。
1.1 核心数据结构:ndarray 与连续内存分布
NumPy 的核心对象是 ndarray(N-dimensional Array,N 维数组)。它在内存中分配的是一段严格连续、同构(所有元素数据类型相同,如 int64、float64)的物理或虚拟内存缓冲区。
- 连续物理块存储:数组中相邻的数值直接在内存地址上相连,大幅提升了 CPU L1/L2 高速缓存的预取效率。
- 固定步长寻址(Strides):NumPy 通过形状(
shape)与步长(strides)元数据控制多维数组在单一扁平内存块上的投影。多维切片或轴置换(transpose)操作只需要修改步长与形状元数据,不需要拷贝任何底层数据字节。 - 向量化与 SIMD 加速:底层由高度优化的 C 与 Fortran 编写,运算时直接调用现代 CPU 的单指令多数据流(SIMD)指令集(如 AVX2、NEON),实现单时钟周期并行计算多个数值。
1.2 向量化计算与广播机制(Broadcasting)
NumPy 彻底消除了 Python 原生耗时的 for 循环,将所有逐元素数学操作下沉到预编译的 C 算子(ufunc)中执行。当参与计算的两个数组维度或形状不一致时,NumPy 触发广播机制:
- 从各数组形状的最末尾维度(尾部对齐)开始往前比对两者的长度。
- 两个维度在以下任一条件下兼容:长度相等,或者其中某一方的长度为
1。 - 长度为 1 的维度在计算中会被虚拟扩展为对齐维度的长度,且全程不会实际复制任何内存数据,仅通过设置步长为 0 重复读取同一地址完成计算。
1.3 核心代码实操:数组创建、向量化运算与掩码过滤
以下展示 NumPy 在数值计算中最核心的操作范式:包括类型受控的矩阵创建、向量化批量算术、以及基于布尔掩码的高效过滤。
import numpy as np

# 1. 创建二维同构数组 (指定 64位浮点型)
arr_a = np.array([[10.0, 20.0, 30.0],
                  [40.0, 50.0, 60.0]], dtype=np.float64)

# 2. 向量化逐元素操作(无需 for 循环)
# 全体元素直接进行标量加法与非线性数学变换
scaled_arr = arr_a * 1.5 + 5.0
log_arr = np.log(arr_a)

# 3. 广播机制运算:(2, 3) 数组与 (1, 3) 数组相加
bias_vector = np.array([[1.0, 2.0, 3.0]])  # shape: (1, 3)
broadcast_result = arr_a + bias_vector     # shape 自动对齐为 (2, 3)

# 4. 布尔掩码索引与条件过滤 (Boolean Indexing)
mask = arr_a > 25.0
filtered_values = arr_a[mask]  # 提取所有大于 25.0 的元素

print("原始数组形状:", arr_a.shape, "数据类型:", arr_a.dtype)
print("广播计算结果:\n", broadcast_result)
print("大于25的过滤结果:", filtered_values)NumPy 的切片操作(例如
sub_arr = arr[0:2, :])默认返回的是原数组在同一内存块上的视图(View),而不是拷贝副本。如果对 sub_arr 的数值进行赋值修改,原数组 arr 的内容会被同步修改。如果需要脱离原数组进行独立修改,必须显式调用 arr[0:2, :].copy()。
二、Pandas 核心用途与业务分析流水线
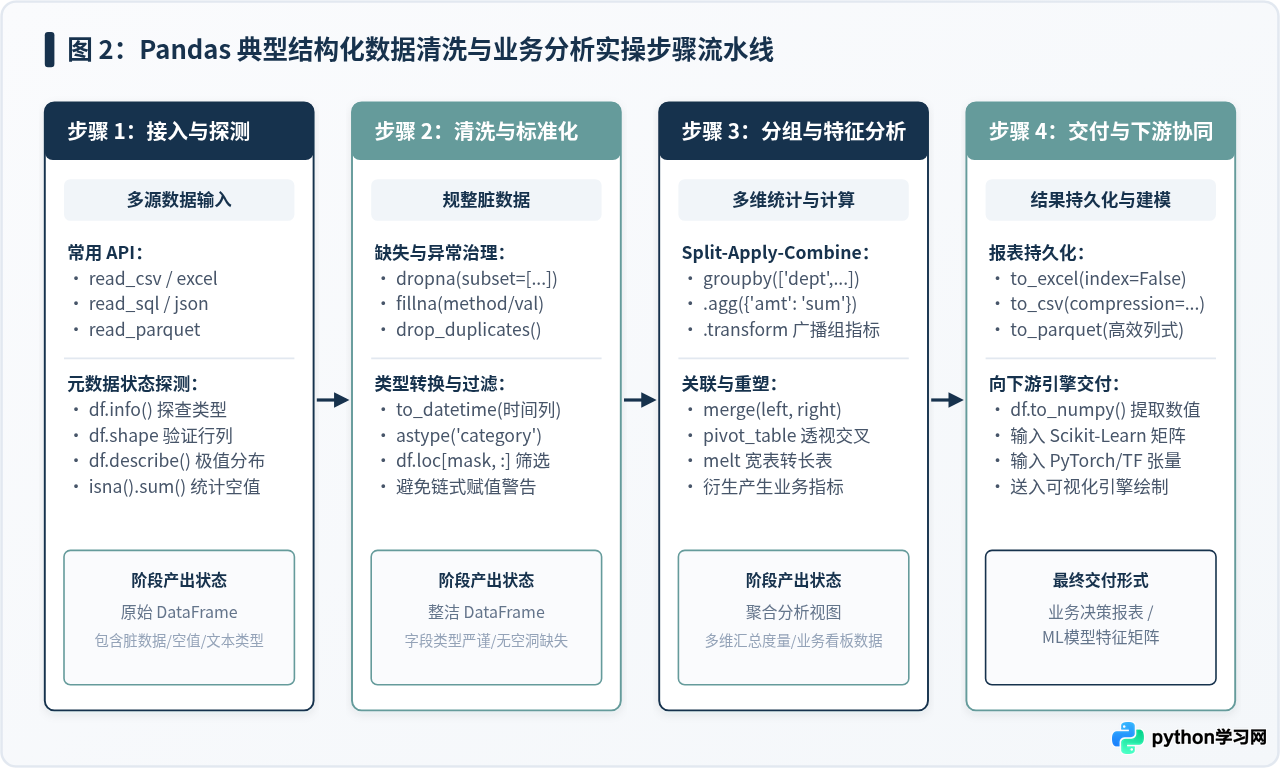
NumPy 虽然在同构数值计算上性能拔群,但现实中的数据分析往往面临复杂的业务上下文:数据包含日期、员工姓名、订单编号、销售金额、枚举分类等多种类型;同时可能存在字段缺失(空值)、需要按不同维度交叉汇总,并经常发生行列名错位的表格运算。Pandas 正是为解决这一系列现实业务挑战而设计的结构化数据处理工具。
2.1 核心数据结构:Series 与 DataFrame
Pandas 的核心抽象基于两个主要对象:
- Series(一维带标签序列):由一组同类型数据以及与之绑定的一维索引(
Index)标签组成。可以将其理解为“带有行标签的定长有序字典”或“增强版的 1D ndarray”。 - DataFrame(二维异构业务表格):由多个共用同一行索引的 Series 水平拼接而成的二维表格。DataFrame 的最大特征在于“同列同构、异列异构”——即每一列自身是一个类型统一的 Series,而不同列之间可以拥有不同的数据类型(如数字、字符串、布尔型、时间戳)。
2.2 核心用途:自动化对齐、缺失值治理与多维聚合
与 NumPy 仅依赖下标物理位置不同,Pandas 具备基于索引标签的自动化数据对齐机制。当两个包含不同行名的 Series 相加时,Pandas 会自动匹配行标签相同的项目完成运算,对于不匹配的行自动赋予空值标记(NaN),避免了由于行次序变动导致的人为计算错位。
2.3 核心代码实操:销售数据清洗、分组统计与透视
下面演示一段完整的 Pandas 业务数据分析脚本,涵盖从原始字典构建表格、处理缺失值与类型规范、再到多字段分组聚合(groupby)的完整逻辑。
import pandas as pd
import numpy as np

# 1. 模拟业务原始数据(包含缺失值与混合类型)
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105", "A106"],
    "region": ["华东", "华北", "华东", "华南", "华北", "华东"],
    "sales": [1200.0, np.nan, 2300.0, 850.0, 1950.0, 3100.0],
    "quantity": [2, 1, 4, 1, 3, 5],
    "order_date": ["2026-03-01", "2026-03-02", "2026-03-02", "2026-03-03", "2026-03-04", "2026-03-05"]
}

df = pd.DataFrame(raw_data)

# 2. 转换时间字段格式,规范数据类型
df["order_date"] = pd.to_datetime(df["order_date"])

# 3. 缺失值处理:使用区域中位数填补 sales 列空缺
region_median = df.groupby("region")["sales"].transform("median")
df["sales"] = df["sales"].fillna(region_median)

# 4. 计算衍生业务指标:客单价
df["unit_price"] = (df["sales"] / df["quantity"]).round(2)

# 5. 多维分组聚合分析(Split-Apply-Combine)
summary = df.groupby("region").agg(
    order_count=("order_id", "count"),
    total_sales=("sales", "sum"),
    avg_price=("unit_price", "mean")
).reset_index()

print("清洗后数据样本:\n", df[["order_id", "region", "sales", "unit_price"]])
print("\n各区域聚合统计汇总:\n", summary)初学者常写出
df[df['sales'] > 1000]['sales'] = 999 这样的链式索引赋值代码。Pandas 无法确认第一个切片操作返回的是视图还是副本,因而会抛出 SettingWithCopyWarning 警告并可能导致修改失败。正确的做法是始终使用 .loc 显式指定行索引条件与目标列:df.loc[df['sales'] > 1000, 'sales'] = 999。
三、NumPy 与 Pandas 的底层关系与协同架构
许多初学者常将两者视为并列竞争关系,但从系统设计上看,Pandas 本质上是 NumPy 在业务语义维度的高阶封装。
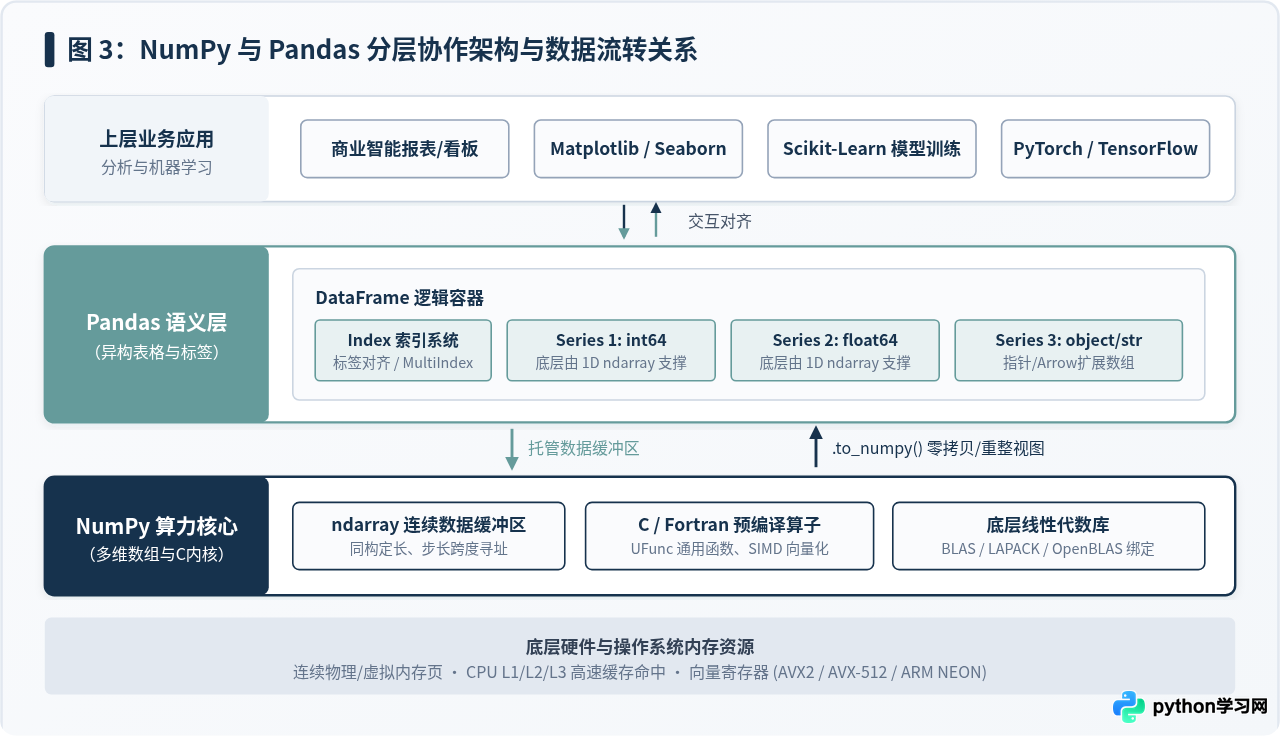
3.1 底层内存托管与 BlockManager 机制
在 Pandas 的内部实现中(尤其是经典的 2.0 之前的内部架构),每个 DataFrame 的各个同类型数据列被统一交给 BlockManager 管理。相同数据类型(例如所有的 float64 列)在底层常常合并保存在一个 2D 的 NumPy ndarray 数据块中。
当我们在 Pandas 中调用数学运算(例如计算平均值 df['sales'].mean() 或相关系数矩阵 df.corr())时,Pandas 剥离掉索引外壳,直接将底层的一维或二维 ndarray 缓冲区交由 NumPy 的 C 语言算子计算,运算完毕后再将结果重新封装为带有索引标签的 Series 或 DataFrame 返回。
3.2 数据在两者间的转换范式:.to_numpy() 与 .values
在将 Pandas 清洗好的特征矩阵输送给机器学习模型(如 Scikit-Learn、XGBoost)或科学求解库时,通常需要将 DataFrame 降维为纯数组:
- 优先使用
df.to_numpy():这是 Pandas 官方推荐的显式 API。它支持显式指定目标dtype(例如df.to_numpy(dtype=np.float32)),并在底层尽量以零拷贝形式共享缓冲区;若各列类型不同,则会按照类型安全级别自动向上兼容转换(Upcasting)。 - 避免滥用历史属性
df.values:.values的行为在不同类型混合时不够稳定,可能在无意中引发意外的隐式类型降级(例如整型列混入一个浮点列时全部被强转为object),增加调试难度。
import pandas as pd
import numpy as np

# 1. 业务端利用 Pandas 快速构建表格与特征衍生
feature_df = pd.DataFrame({
    "feature_1": [1.2, 3.4, 2.8, 5.1],
    "feature_2": [10.0, 15.0, 12.0, 20.0],
    "target": [0, 1, 0, 1]
})

# 2. 导出纯数值矩阵给 NumPy 算法使用
# 提取特征矩阵 X 与 目标向量 y
X_features = feature_df[["feature_1", "feature_2"]].to_numpy(dtype=np.float64)
y_labels = feature_df["target"].to_numpy(dtype=np.int32)

# 3. 使用 NumPy 算子进行零拷贝标准化与协方差运算
X_mean = np.mean(X_features, axis=0)
X_std = np.std(X_features, axis=0)
X_normalized = (X_features - X_mean) / X_std

print("X 数组类型:", type(X_normalized), "内存连续性:", X_normalized.flags['C_CONTIGUOUS'])
print("标准化后的纯数组数据:\n", X_normalized)四、技术选型决策与实践避坑指南
针对具体的工程与业务场景,究竟应该选择 NumPy 还是 Pandas,可以依据数据形态和处理核心诉求做出清晰界定。
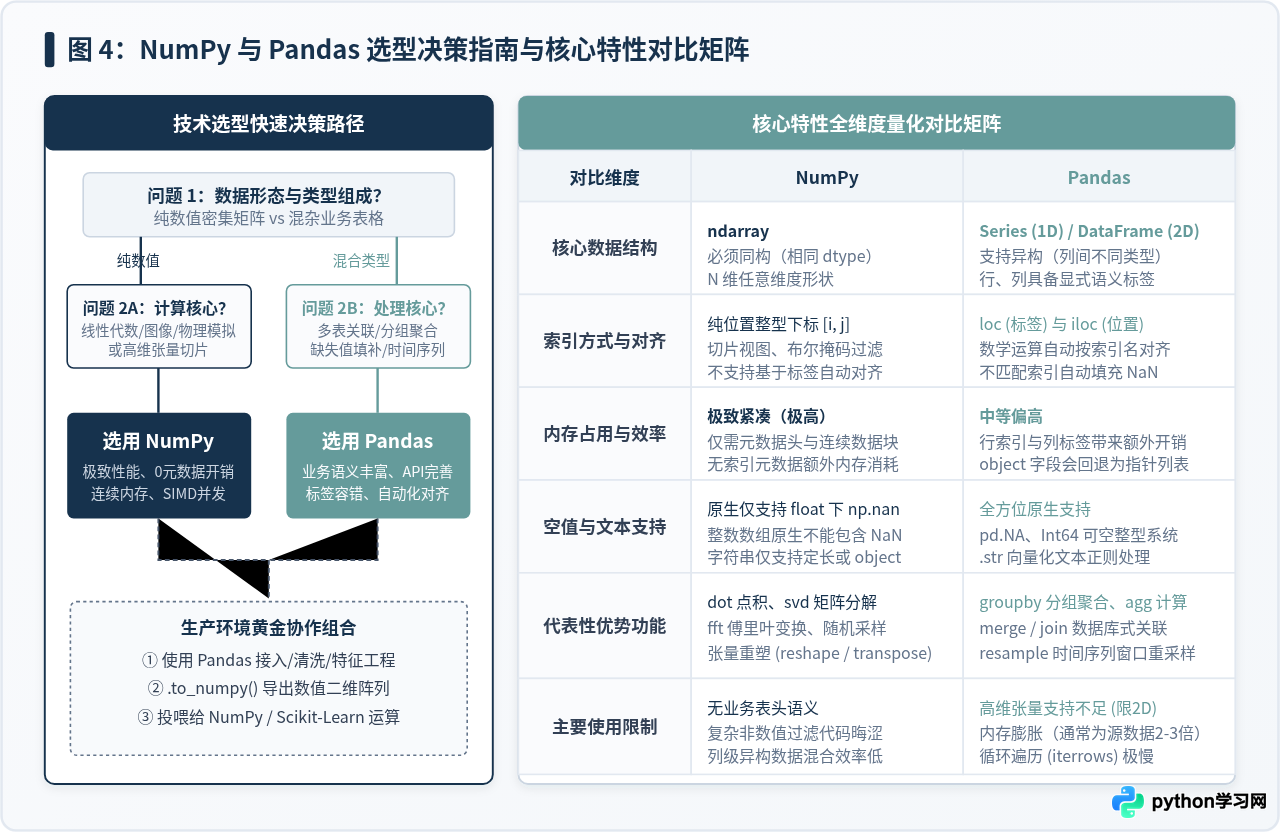
4.1 场景选型决策依据
| 应用场景与业务诉求 | 首选推荐工具 | 底层原因与工程收益 |
|---|---|---|
| 数字图像处理、信号处理、物理仿真、微分方程求解 | NumPy | 数据形态天然为多维张量且类型高度单一(如 uint8、float32),需要利用高阶切片与 BLAS/LAPACK 极致性能。 |
| 商业报表统计、用户行为宽表分析、财务报表聚合 | Pandas | 涉及日期、ID、金额等多种异构类型字段,高度依赖行列索引自动对齐、Group-By 分组与缺失值清洗。 |
| 机器学习、深度学习特征工程全生命周期 | Pandas + NumPy 协作 | 上游利用 Pandas 的完备生态做数据导入、过滤、关联衍生;下游在送入模型前使用 .to_numpy() 导出稠密矩阵。 |
| 亿级同构数值矩阵的大规模线性代数求解 | NumPy | Pandas 额外的索引元数据会带来数十兆至百兆不等的额外内存消耗,在内存敏感的纯数学场景下应退回裸 ndarray。 |
4.2 高频避坑与性能优化建议
- 严禁在数据分析中对 DataFrame 循环遍历(
iterrows/itertuples):Python 原生for循环会使每行的提取都经历一次复杂的 Series 对象装箱与类型推断,导致处理效率暴跌百倍以上。必须使用向量化操作(如列运算)、.apply(),或直接导出底层 NumPy 数组进行向量化计算。 - 注意文本字段对内存的侵蚀:在读取大型 CSV 时,默认的
object类型列本质上存储的是 Python 字符串对象指针列表,不仅占用大量内存还会阻断 SIMD 优化。对于基数较小的枚举字符串(如“省份”、“性别”、“订单状态”),应及时使用.astype('category')转换为分类类型。 - 警惕隐式类型向上提升(Upcasting):在一个原本是
int64的 NumPy 数组中如果插入或运算产生了非数值,由于原生 ndarray 不支持整数空值,整个数组将被迫强制转换为float64(引入np.nan),甚至退化为object,导致后续矩阵算子失效。在需要严谨空值整数场景时,优先采用 Pandas 提供的可空整型Int64。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









