

Python异步编程与多线程怎么选:CPU与IO任务边界
深入解析Python多线程与asyncio异步编程的本质区别。从CPython的GIL机制出发,清晰界定CPU密集型与IO密集型任务边界,提供切实可行的架构选型推导流程、完整代码示例与工程避坑指南。
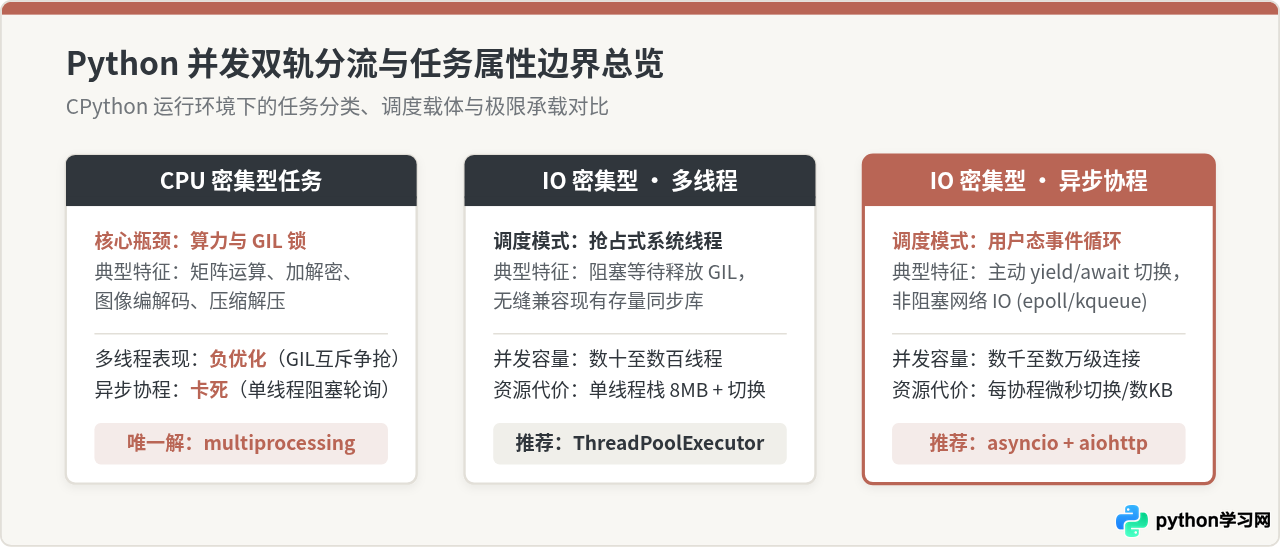
核心结论:在 Python 中选择异步编程(asyncio)还是多线程(threading),核心决策依据在于任务性质是否受制于 CPU 算力、并发连接的规模量级以及第三方库生态是否支持非阻塞协程。因 CPython 全局解释器锁(GIL)的存在,两者均无法在单进程内实现多核并行计算,CPU 密集型任务必须转向多进程(multiprocessing);对于 IO 密集型任务,当并发连接规模突破千级别且均为网络 IO 时,首选内存与切换开销极低的 asyncio;而在面对数百级并发、传统本地磁盘文件读写或存量同步阻塞驱动时,多线程依然是改造代价最低、心智负担最小的实用方案。
一、任务本质:CPU 密集型与 IO 密集型的分水岭
在讨论 Python 的技术选型前,必须首先厘清任务本身的资源消耗模式。许多性能调优之所以收效甚微,往往是因为把 CPU 密集型任务套进了并发工具中,或者在单线程事件循环中执行了重度计算。
CPU 密集型(Compute-Bound)任务的核心特征是 CPU 占用率常年逼近 100%,执行时间受限于处理器的运算速度与主频。典型场景包括密码哈希碰撞、音视频编解码、机器学习特征矩阵变换、大 JSON/XML 的递归反序列化以及高精度物理仿真。
IO 密集型(IO-Bound)任务的特征是 CPU 绝大部分时间处于空闲或微小占用状态,执行瓶颈在于等待外部设备或网络响应(即“读写挂起”)。典型场景包括高频 HTTP 爬虫、微服务间 RPC 调用、Redis/MySQL 查询网络往返以及本地磁盘文件的读写传输。
GIL 对两类任务的截然不同影响
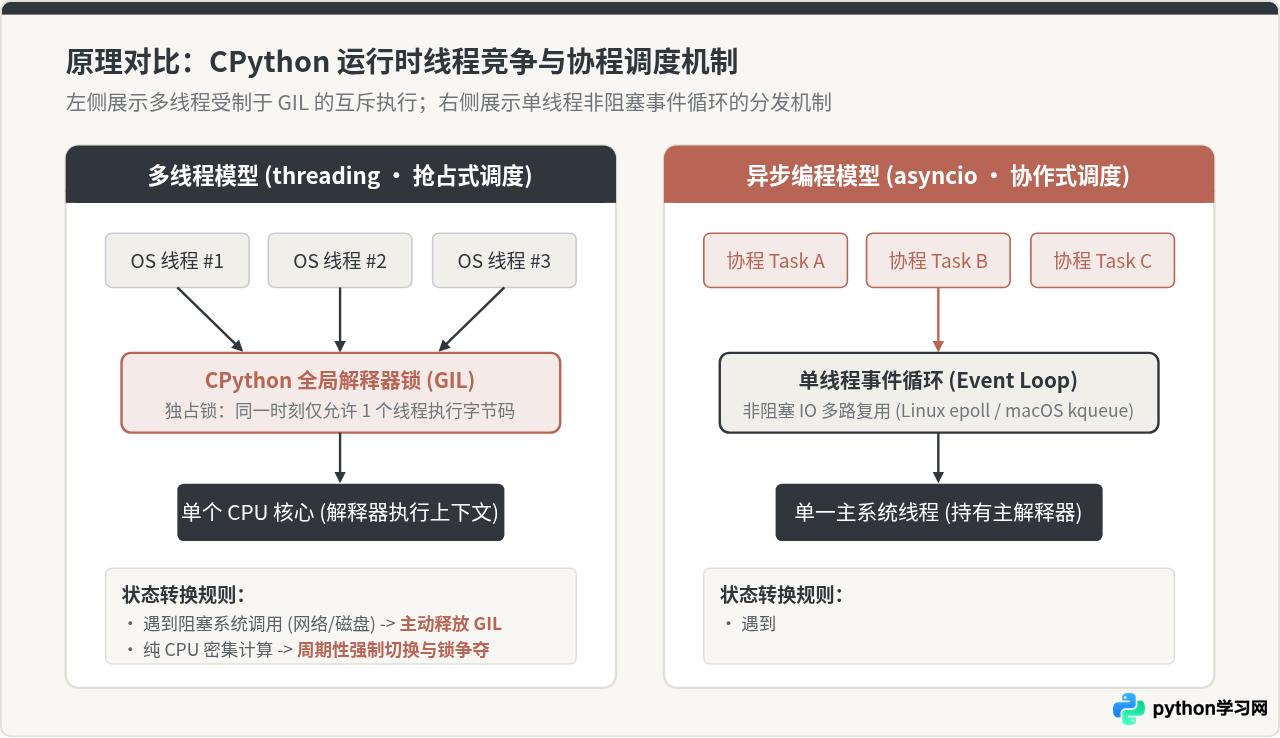
CPython(官方标准的 Python 实现)内置了全局解释器锁(Global Interpreter Lock,简称 GIL)。GIL 的存在使得任何时刻只有一个系统线程能够执行 Python 字节码。这意味着:
- 在 CPU 密集任务中:即使操作系统为你分配了 16 核 CPU,你启动了 16 个
threading.Thread,这 16 个线程也必须排队轮流抢占那把唯一的 GIL 锁。由于每个线程都处于饥饿计算状态,频繁的线程上下文切换和 GIL 互斥唤醒不仅无法利用多核,反而会造成严重的上下文切换开销,导致“多线程耗时反而显著大于单线程”。 - 在 IO 密集任务中:当一个线程调用底层的系统阻塞操作(例如
socket.recv()或标准库的阻塞 IO)时,Python 会在进入系统调用前主动释放 GIL;当网络数据到达后再重新获取 GIL 继续执行。因此,多线程在处理等待时间漫长的 IO 操作时,能够有效掩盖网络延迟。
实测验证:CPU 密集计算的三种方案对比
为了直观说明算力边界,我们使用一个简单的质数计数任务(属于纯计算密集型)来对比单线程、多线程与多进程的实际耗时。执行环境为 Python 3.11,8 核 Apple M 系列芯片:
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def count_primes(n: int) -> int:
    """纯 CPU 密集计算:统计区间内的质数数量"""
    count = 0
    for num in range(2, n):
        is_prime = True
        for i in range(2, int(num ** 0.5) + 1):
            if num % i == 0:
                is_prime = False
                break
        if is_prime:
            count += 1
    return count

def run_benchmarks():
    tasks = [100000] * 8  # 8 个独立的重度计算任务

    # 1. 单线程顺序执行
    start = time.perf_counter()
    res1 = [count_primes(t) for t in tasks]
    t_single = time.perf_counter() - start

    # 2. 多线程执行(8 个工作线程)
    start = time.perf_counter()
    with ThreadPoolExecutor(max_workers=8) as pool:
        res2 = list(pool.map(count_primes, tasks))
    t_thread = time.perf_counter() - start

    # 3. 多进程执行(8 个工作进程)
    start = time.perf_counter()
    with ProcessPoolExecutor(max_workers=8) as pool:
        res3 = list(pool.map(count_primes, tasks))
    t_process = time.perf_counter() - start

    print(f"单线程耗时: {t_single:.2f} 秒")
    print(f"多线程耗时: {t_thread:.2f} 秒 (受限于 GIL)")
    print(f"多进程耗时: {t_process:.2f} 秒 (利用多核 CPU)")

if __name__ == '__main__':
run_benchmarks()多线程耗时: 3.68 秒 (受限于 GIL,多线程比单线程更慢!)
多进程耗时: 0.65 秒 (实现真正的 5.2 倍并行加速)
实验结论:在 CPU 密集任务中,多线程不仅无法提速,反因多线程反复争夺 GIL 导致总耗时增加了约 7.6%;而多进程因为拥有各自独立的 Python 解释器和独立的 GIL,直接调动了多核计算资源。因此,面对 CPU 密集任务,必须直接排除多线程和异步编程,选用 ProcessPoolExecutor 或将算法改写为 C/Rust 扩展(如 NumPy、Cython)。
二、执行模型差异:协作式事件循环 vs 抢占式系统线程
当任务类型被确认为 IO 密集型 后,多线程与异步编程才真正进入选择赛道。两者的根本差异,在于任务切换的控制权归属与资源代价。
1. 抢占式调度(多线程)
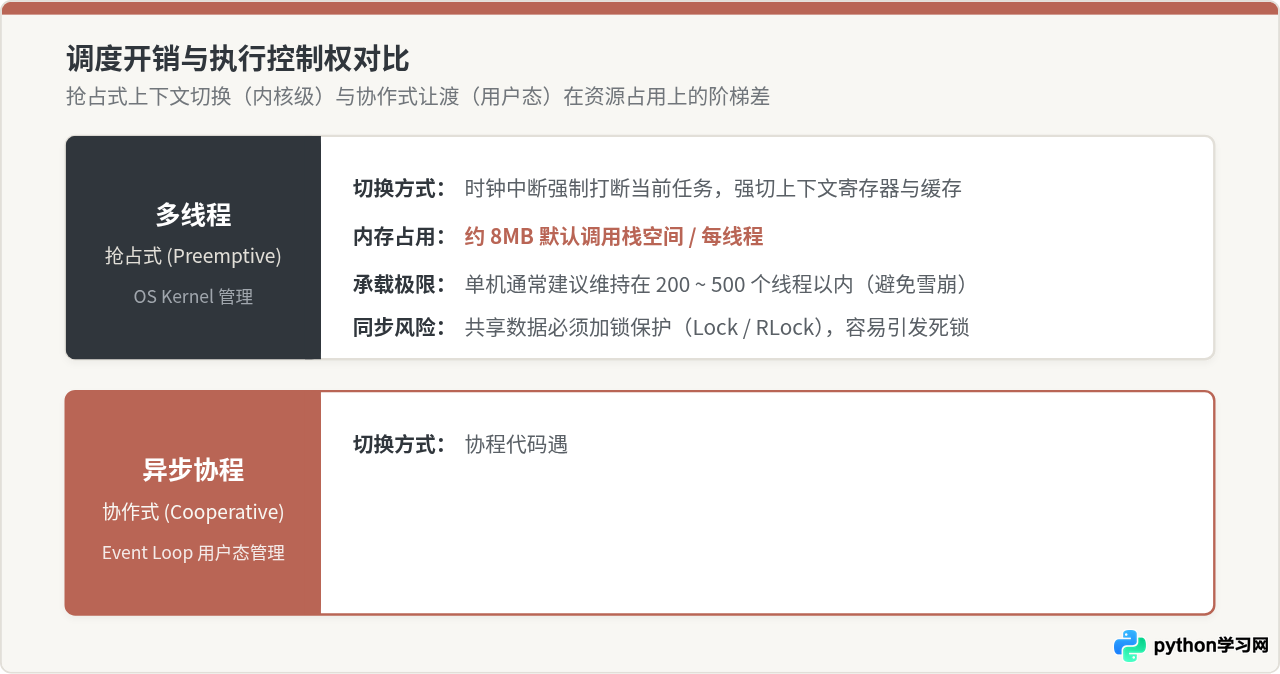
Python 的 threading.Thread 映射的是操作系统原生内核级线程(POSIX Threads 或 Windows Threads)。内核调度器会给每个线程分配时间片:
- 切换时机不由代码决定:操作系统的调度器随时可能中断当前代码的执行,强行切换到另一个线程(抢占)。
- 高昂的系统开销:每个线程默认需要占用数 MB 的栈内存(在 64 位 Linux/macOS 下通常为 8MB 虚拟内存),每次切换都伴随内核态到用户态的转换以及 CPU 寄存器上下文的刷新。
- 数据安全风险:由于指令可能在任意两行字节码之间被切断,对共享变量的读写必须依赖互斥锁(
threading.Lock),否则必然引发难以复现的竞态条件(Race Condition)。
2. 协作式调度(asyncio 异步协程)
asyncio 运行在一个单系统线程内,所有并发任务都被抽象为协程对象,由事件循环(Event Loop)集中分发:
- 切换由代码主动让出:协程只有在显式执行带有
await关键字的非阻塞 IO 表达式时,才会主动将控制权交还给事件循环。在两个await之间的所有代码,执行都是严格原子性的,不存在被强行中断的风险。 - 微小的资源消耗:一个协程本质上是一个轻量级的生成器对象,内存开销通常仅有几百字节到几 KB。单台普通服务器可以毫不费力地驻留 10 万个并发协程,但绝对无法创建 10 万个系统线程。
- “一人卡死,全家停滞”的致命限制:协作式调度的命脉在于“大家都要主动让出”。如果某个协程在没有
await的情况下执行了长达 5 秒的重度计算,或者调用了time.sleep(5)这样的阻塞函数,整个事件循环将彻底被冻结 5 秒,期间其他数万个任务全部陷入等待。
三、实战对比与混合架构:IO 密集型任务场景演练
在工程实践中,网络请求爬取是验证 IO 并发模型的黄金案例。假设我们需要并发抓取 500 个 HTTP 目标接口,每个接口网络往返耗时约 200ms。下面分别采用 ThreadPoolExecutor 与 asyncio 实现,并对比工程差异。
方案 A:多线程线程池实现(标准实用流)
多线程方案最大的优势在于心智模型极其自然。你可以继续使用 Python 开发者最为熟稔的同步式 requests 或 urllib 库,无需对底层调用做任何“传染性”的 async 改写:
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
import urllib.request

def fetch_url(url: str, timeout: float = 5.0) -> int:
    """普通的阻塞式网络请求函数"""
    req = urllib.request.Request(
        url,
        headers={'User-Agent': 'Mozilla/5.0 Python-Threading-Runner'}
    )
    with urllib.request.urlopen(req, timeout=timeout) as response:
        content = response.read()
        return len(content)

def run_multithread_io():
    urls = ["https://httpbin.org/delay/0.2"] * 100
    results = []

    start = time.perf_counter()
    # 创建包含 20 个工作线程的线程池
    with ThreadPoolExecutor(max_workers=20) as executor:
        future_map = {executor.submit(fetch_url, u): u for u in urls}
        for future in as_completed(future_map):
            try:
                size = future.result()
                results.append(size)
            except Exception as e:
                print(f"请求失败: {e}")

    total_time = time.perf_counter() - start
    print(f"多线程抓取 100 个接口总耗时: {total_time:.2f} 秒")

if __name__ == '__main__':
    run_multithread_io()
方案 B:asyncio 原生协程实现(高并发吞吐流)
如果将任务规模从 100 扩大到 2000 个,使用 2000 个操作系统线程会迅速拖垮机器内存与内核调度器。此时必须使用全链路非阻塞的 asyncio 方案(以现代化异步库 httpx 为例):
import asyncio
import time
import httpx

async def fetch_async(client: httpx.AsyncClient, url: str) -> int:
    """非阻塞协程函数,注意必须 await 每一个异步 IO"""
    response = await client.get(url, timeout=5.0)
    return len(response.content)

async def run_asyncio_io():
    urls = ["https://httpbin.org/delay/0.2"] * 1000

    start = time.perf_counter()
    # 通过信号量限制并发度,避免瞬间打满本地 socket 或打崩目标服务
    sem = asyncio.Semaphore(100)

    async def sem_fetch(client, url):
        async with sem:
            return await fetch_async(client, url)

    # 复用连接池
    limits = httpx.Limits(max_keepalive_connections=100, max_connections=200)
    async with httpx.AsyncClient(limits=limits) as client:
        tasks = [asyncio.create_task(sem_fetch(client, url)) for url in urls]
        # 并发聚合等待所有结果返回
        results = await asyncio.gather(*tasks, return_exceptions=True)

    success_count = sum(1 for r in results if isinstance(r, int))
    total_time = time.perf_counter() - start
    print(f"asyncio 抓取 1000 个接口成功数: {success_count}, 耗时: {total_time:.2f} 秒")

if __name__ == '__main__':
asyncio.run(run_asyncio_io())asyncio.Semaphore 设立并发上限。如果不加控制地瞬间触发数千个网络请求,很容易触发操作系统的 Too many open files(文件描述符耗尽)或者被对方防火墙判定为 DDoS 攻击直接封禁 IP。
关键桥梁:当异步代码遭遇同步阻塞第三方库
许多开发者在转型 asyncio 时最常遇到的痛苦场景是:核心链路已经是异步了,但必须使用一个老旧的 SDK、传统数据库驱动(如旧版 cx_Oracle)或者调用本地磁盘同步压缩算法。如果直接在 async 函数中调用它们,就会冻结整个事件循环。
标准解决方案是使用 loop.run_in_executor() 或 Python 3.9+ 引入的 asyncio.to_thread(),将同步阻塞任务动态派发到专属线程池中执行,并在协程中非阻塞等待:
import asyncio
import time

def legacy_blocking_io(filepath: str) -> str:
    """无法改造的同步第三方库调用或原生重度文件 IO"""
    time.sleep(1.0)  # 模拟阻塞耗时
    return f"读取 {filepath} 完成"

async def async_main():
    print("开始调度...")
    # asyncio.to_thread 会在后台独立的 ThreadPoolExecutor 中执行该函数
    # 主事件循环不会被卡死,可以继续响应其他并发协程
    result = await asyncio.to_thread(legacy_blocking_io, "data_report.csv")
    print(f"收到结果: {result}")

if __name__ == '__main__':
    asyncio.run(async_main())
四、选型判定流程与边界指南
面对具体的工程需求,如何迅速而笃定地完成架构技术选型?可以通过以下标准化的决策流程图逐步推导定位:
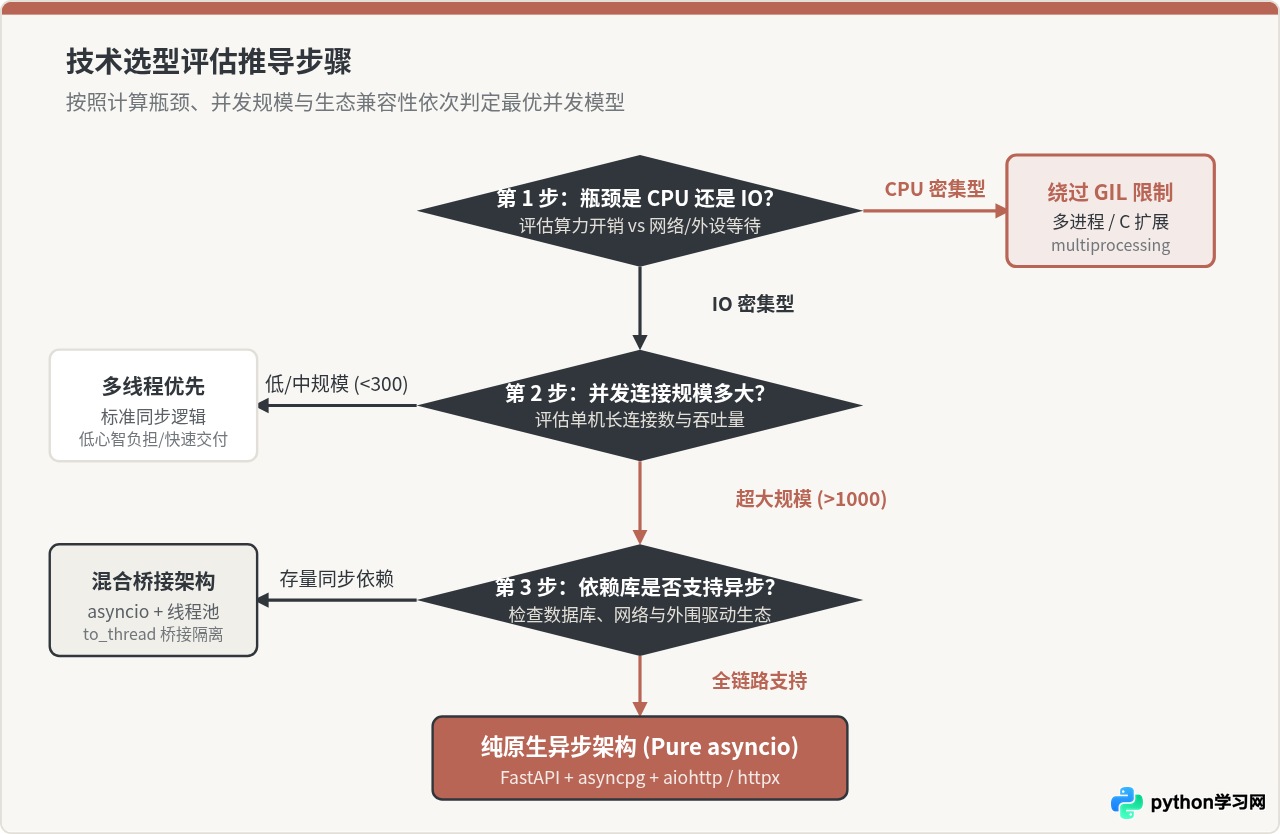
五、总结:工程选型全景矩阵与常见误区
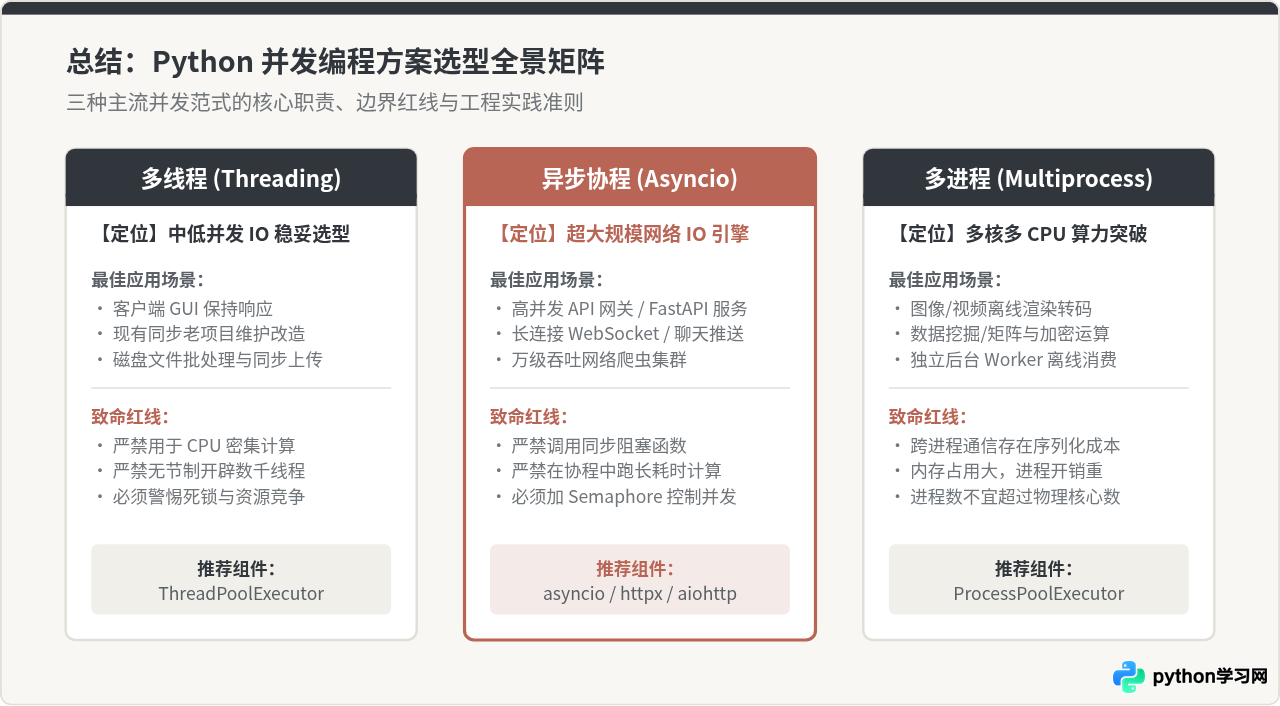
为了让不同场景下的选型条件一目了然,下表汇总了多线程、异步编程以及多进程的核心技术指标与工程边界:
| 对比维度 | 多线程 (threading) | 异步编程 (asyncio) | 多进程 (multiprocessing) |
|---|---|---|---|
| 适用任务属性 | 网络/外设 IO 等待(中低并发) | 海量网络 IO、高并发 Web 连接 | CPU 密集型纯算力计算任务 |
| GIL 影响 | IO 阻塞时自动释放,计算时互斥 | 单线程运行,本质与 GIL 无直接冲突 | 每个进程拥有独立 GIL,完全多核并行 |
| 单机并发承载 | 数百(约 200~500 线程) | 数万至数十万(10,000+ 协程) | 通常等于或略小于 CPU 物理核心数 |
| 单任务内存成本 | 较高(系统线程栈 ~8MB 虚拟内存) | 极低(单协程 ~几百字节至几 KB) | 高(独立进程复制内存,数十至数百 MB) |
| 代码改造难度 | 极低,完全兼容同步代码与存量库 | 较高,具备“传染性”,全链路需 async | 中等,需处理进程间通信(IPC)与序列化 |
| 最致命工程陷阱 | 共享资源未加锁引发脏写与死锁 | 在 async 函数中调用同步阻塞函数卡死循环 | 跨进程对象无法被 pickle 序列化;内存爆炸 |
不可不知的三大工程误区
- 误区一:“只要上异步,吞吐量就一定比多线程高”
事实恰恰相反。在并发量只有几十到一两百的普通业务场景下,多线程与异步协程的响应时间几乎没有肉眼可见的差距。而在协程中处理大量繁琐的数据组装、JSON 序列化等纯 Python 计算时,协程上下文调度的解释器开销有时甚至微弱逊色于原生多线程。异步的真正威力只在“成千上万个连接同时等待 IO”时才会爆发式展现。 - 误区二:“把代码前加上 async def,它就自动变成非阻塞了”
将普通函数声明为async def只意味着该函数返回一个协程对象,并不代表内部所有操作都会被魔法般地变成异步。如果在函数体内直接使用了open('file.txt')、requests.get()或time.sleep(),它们依然会以同步方式霸占 CPU,从而让整个事件循环陷入假死。 - 误区三:“多线程可以完全替代多进程”
只要底层运行的是官方 CPython,在多核 CPU 机器上跑多线程,就永远逃不开单核执行字节码的宿命。多线程只能并发“等 IO”,不能并行“算数据”。需要榨干 CPU 核心时,多进程依然是无可替代的坚实底座。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









