

Python中后置单下划线(var_)的作用是什么
深入解析Python中后置单下划线(var_)的作用与设计意图,结合PEP 8官方命名规范、四大典型实战场景、五种下划线对比矩阵与落地最佳实践,帮助开发者彻底掌握关键字冲突规避方法。
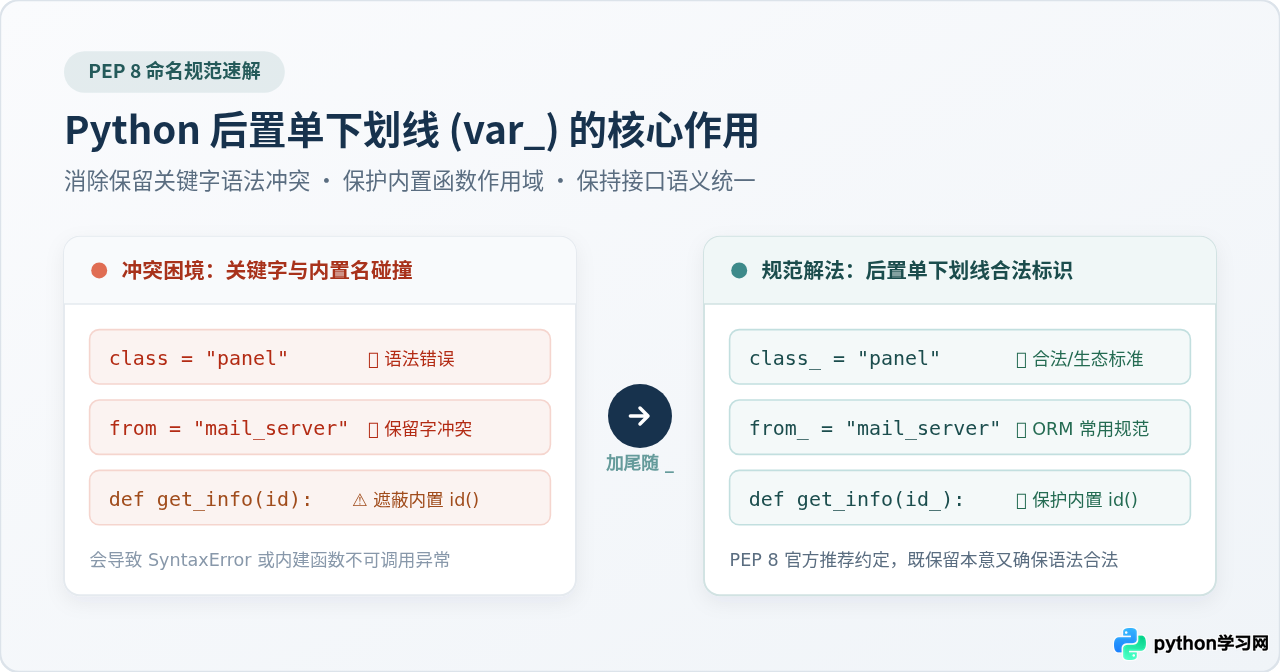
在 Python 编程中,在变量或形参名称后添加一个单下划线(例如 var_)是一种官方约定的命名规范,其核心作用是避免与 Python 保留关键字(Keywords)或内置作用域标识符(Built-in Names)发生命名冲突。当开发者在程序设计中必须使用某个与语言语法保留字(如 class、from、def、in)完全重合的业务名词作为变量、函数参数或对象属性时,直接书写会导致解释器抛出 SyntaxError。此时,依据 Python 官方代码风格指南(PEP 8)的规约,在名称尾部追加单下划线(如 class_、from_、id_),既能精准保留该变量的本意,又能获得一个合法的 Python 标识符。
single_trailing_underscore_:used by convention to avoid conflicts with Python keyword(按惯例用于避免与 Python 关键字发生命名冲突)。例如 tkinter.Toplevel(master, class_='ClassName')。
一、为什么 Python 需要后置单下划线?
在编写业务逻辑或封装通用库时,我们经常会遇到两类命名层面的现实困境:
1. 语法层面的硬性限制:保留关键字冲突
Python 解释器在语法解析阶段会对保留关键字(如 class、def、return、from、import、pass、lambda 等)进行特殊的词法识别。关键字不能作为普通标识符被赋值或作为函数形参声明。例如执行以下代码:
# 示例:直接使用关键字作为参数或变量将触发语法解析错误
def render_tag(name, class):
    return f"<{name} class='{class}'></{name}>"
# 运行输出:SyntaxError: invalid syntax
解释器在解析到 class 时,会将其误认为类的定义语法开始,进而直接报错中断。同理,当你想记录一条邮件的发送来源并将其命名为 from = "service@example.com" 时,同样无法通过编译。
2. 作用域层面的软性隐患:内置函数遮蔽 (Shadowing)
除了关键字,Python 内置命名空间(builtins)中预置了大量极其常用的函数和类型,例如 id()、type()、format()、input()、filter()、list()、dir() 等。与关键字不同,直接给同名变量赋值在语法上是允许的,但这会产生危险的作用域遮蔽效应:
# 示例:形参遮蔽全局内置函数
def process_user(id, name):
    # 此时局部变量 id 是一个整数,覆盖了内置函数 id()
    print(f"User: {name}, ID: {id}")
    # 如果在此函数内部试图获取对象的内存地址:
    addr = id(name)  # 抛出 TypeError: 'int' object is not callable
为了在保持原有业务意图的前提下优雅化解上述矛盾,PEP 8 正式引入了“后置单下划线”这一轻量且统一的标准。
二、工程开发中的四大典型使用场景
后置单下划线并非个人随性添加的补丁,而是贯穿 Python 主流开源生态的通用设计语言。以下四种场景在实际工程中极为常见:
1. Web 页面解析与前端属性映射(class_)
在 HTML/CSS 标准中,class 是使用频率最高的标签属性。然而在 Python 中,class 是定义面向对象类的关键字。以著名网页解析库 BeautifulSoup 和表单库 WTForms 为例,它们统一使用 class_ 来接收 HTML 类名:
from bs4 import BeautifulSoup

html_doc = '<div class="content active"><span class="author">Alice</span></div>'
soup = BeautifulSoup(html_doc, 'html.parser')

# 正确做法:使用 class_ 避开 Python 的 class 关键字
content_div = soup.find('div', class_='content active')
print(content_div.text)  # 输出: Alice
2. 关系型数据库 ORM 查询与字段映射(from_、in_)
SQL 语言中充斥着 FROM、IN、ORDER 等关键字。在流行 ORM 框架(如 SQLAlchemy 或 Peewee)中,当数据库表字段恰好名为 from,或者构建条件过滤操作时,均大量依赖后置单下划线:
from sqlalchemy import Column, Integer, String, select
from sqlalchemy.orm import declarative_base

Base = declarative_base()

class MessageLog(Base):
    __tablename__ = 'message_logs'
    id_ = Column('id', Integer, primary_key=True)
    # 映射名为 from 的数据列
    from_ = Column('from', String(64))
    content = Column('content', String(256))

# 查询语句中规避关键字并构建精确语法
stmt = select(MessageLog).where(MessageLog.from_ == 'gateway_server')
3. 通用底层形参命名与作用域保护(id_、type_)
编写底层数据访问层(DAO)或接口校验器时,数据库主键通常统称为 ID,数据种类通常统称为 Type。为了避免遮蔽 Python 内置的 id() 和 type() 函数,官方标准库与严谨的工业级代码均采用 id_ 与 type_:
def fetch_entity_by_id(id_: int, type_: str = "default"):
    # id_ 和 type_ 既准确传递了参数含义,又完全保留了内置函数可用性
    current_type = type(id_)  # 内建 type() 依然可以正常调用
    print(f"Fetching entity with ID: {id_}, ParamType: {current_type}")
    return {"id": id_, "type": type_}
4. 跨系统数据交换与保留字序列化(async_、pass_)
在通过 Pydantic、Protobuf 或 Marshmallow 对接第三方 JSON API 时,如果远程服务返回了 {"async": true, "def": "v1"} 等字段,在 Python 模型中必须使用后置单下划线定义属性,并配置字段别名:
from pydantic import BaseModel, Field

class TaskConfig(BaseModel):
    task_name: str
    # Python 中 async 是保留关键字,因此属性名声明为 async_
    async_: bool = Field(..., alias="async")

config = TaskConfig(**{"task_name": "backup", "async": True})
print(config.async_)  # 输出: True
print(config.model_dump(by_alias=True))  # 输出: {'task_name': 'backup', 'async': True}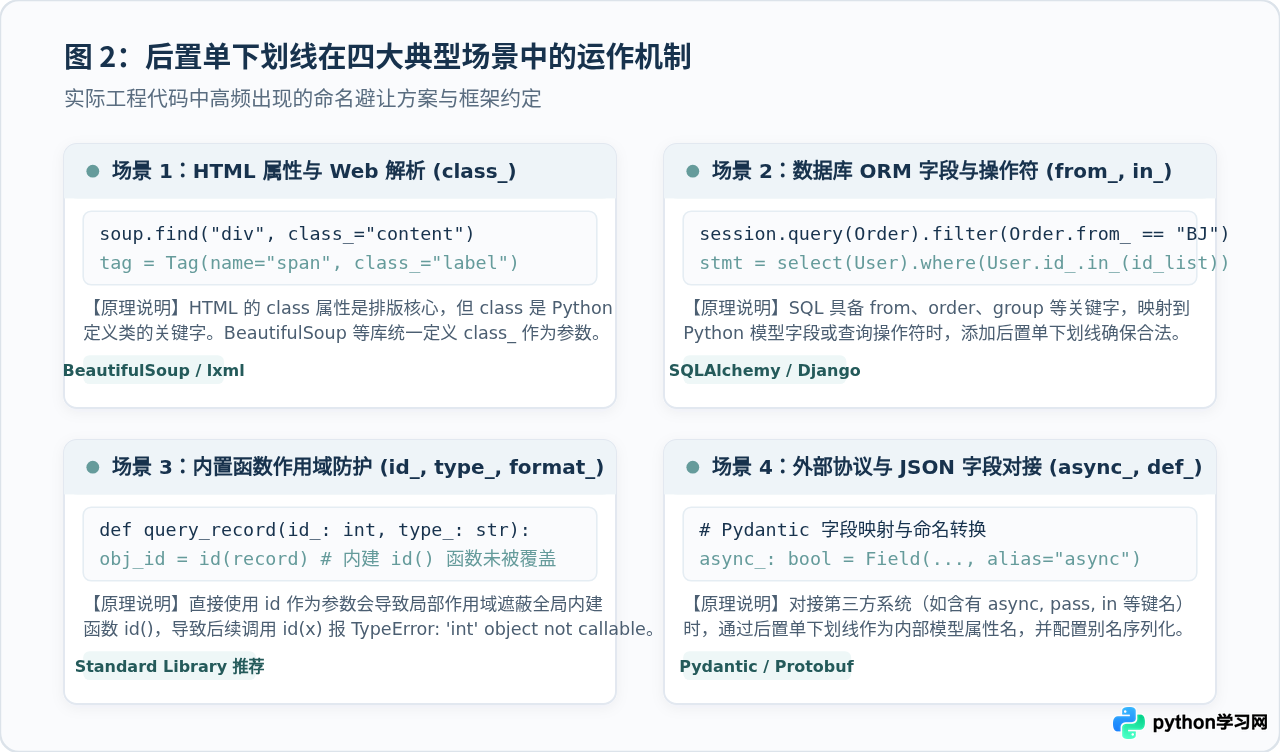
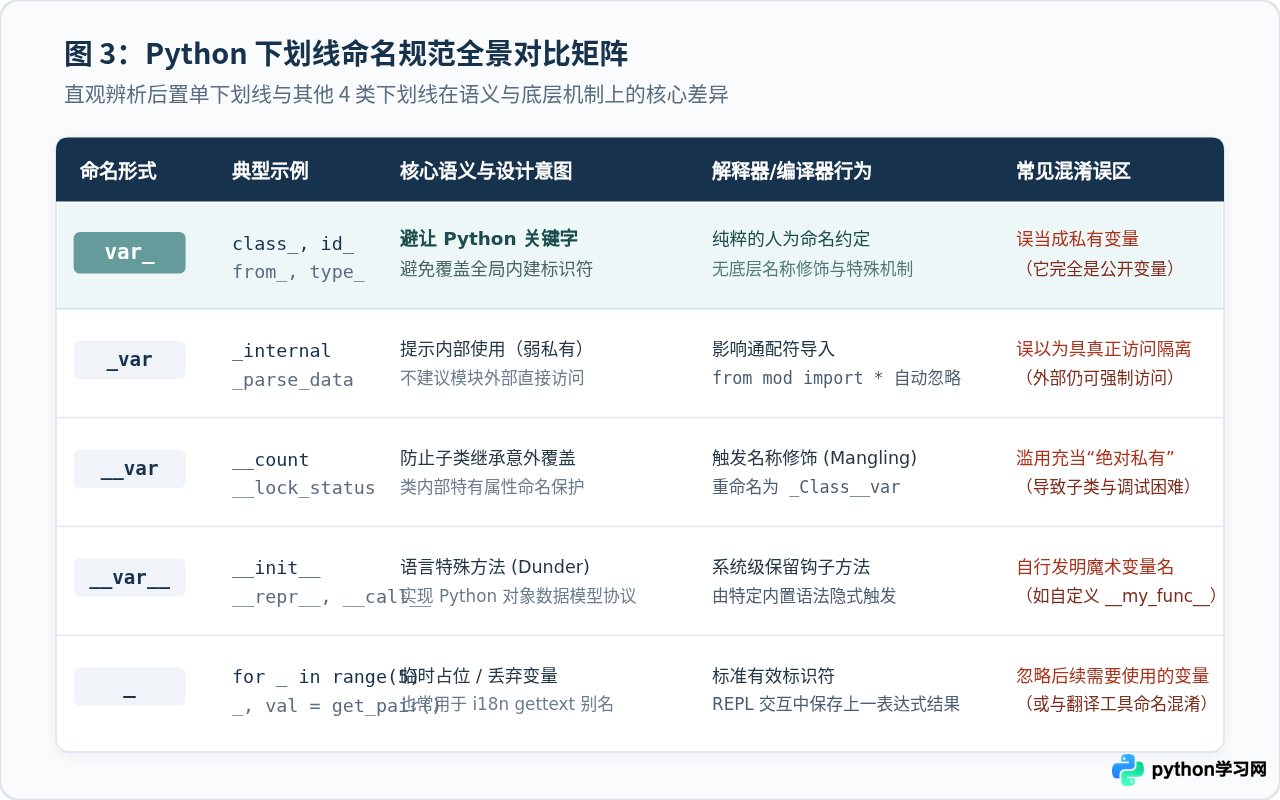
三、核心辨析:Python 各种下划线命名规范全景对比
Python 语言中下划线的用法十分丰富,初学者极易将后置单下划线(var_)与前置单下划线(_var)或双前置下划线(__var)混淆。必须明确:后置单下划线完全没有“私有化”或“隐藏”的含义,它是一个纯粹公开、普通的合法标识符。
| 形式 | 典型命名 | PEP 8 语义定义 | 解释器行为与影响 | 典型使用场景 |
|---|---|---|---|---|
后置单下划线var_ |
class_from_id_ |
避让 Python 关键字与内置命名空间冲突 | 普通标识符,解释器不作任何修改,无任何私有属性 | Web 属性参数、ORM 字段、规避内置函数遮蔽 |
前置单下划线_var |
_internal_cache_helper_func |
弱“内部使用”约定提示(供开发者阅读) | from module import * 时默认不会导入该名称;类外部仍可正常访问 |
模块内部辅助函数、类的非公有方法 |
双前置下划线__var |
__private_data__lock |
防止子类继承时命名冲突(避免被子类意外重写) | 触发名称修饰(Name Mangling),在类字典中重命名为 _ClassName__var |
复杂的继承层次体系、基础框架防覆盖属性 |
双前后下划线__var__ |
__init____repr__ |
语言级保留的特殊方法与对象模型协议(Dunder) | 由 Python 解释器内部预定义,在执行特定语法(如加法、迭代)时自动隐式调用 | 重载运算符、自定义上下文管理器、元类编程 |
单个独立下划线_ |
for _ in range(5)_, val = func() |
临时占位符 / 丢弃变量 / 国际化别名 | 在普通代码中为常规变量名;在交互式 REPL 终端中自动保存上一表达式求值结果 | 循环解构丢弃无用值、多语言翻译 _("Hello") |
四、实践建议与常见反模式(注意事项)
在实际编码过程中,合理使用后置单下划线有助于提升代码的可维护性,但切忌盲目依赖或走入误区:
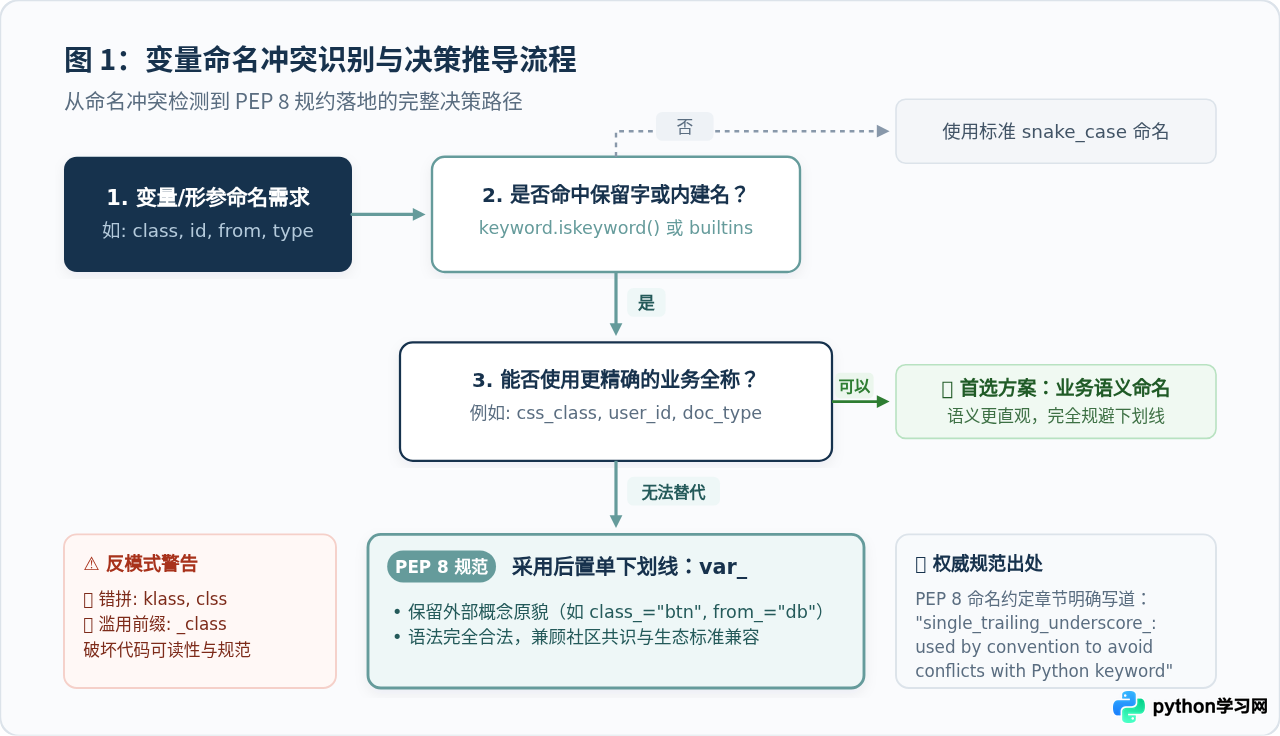
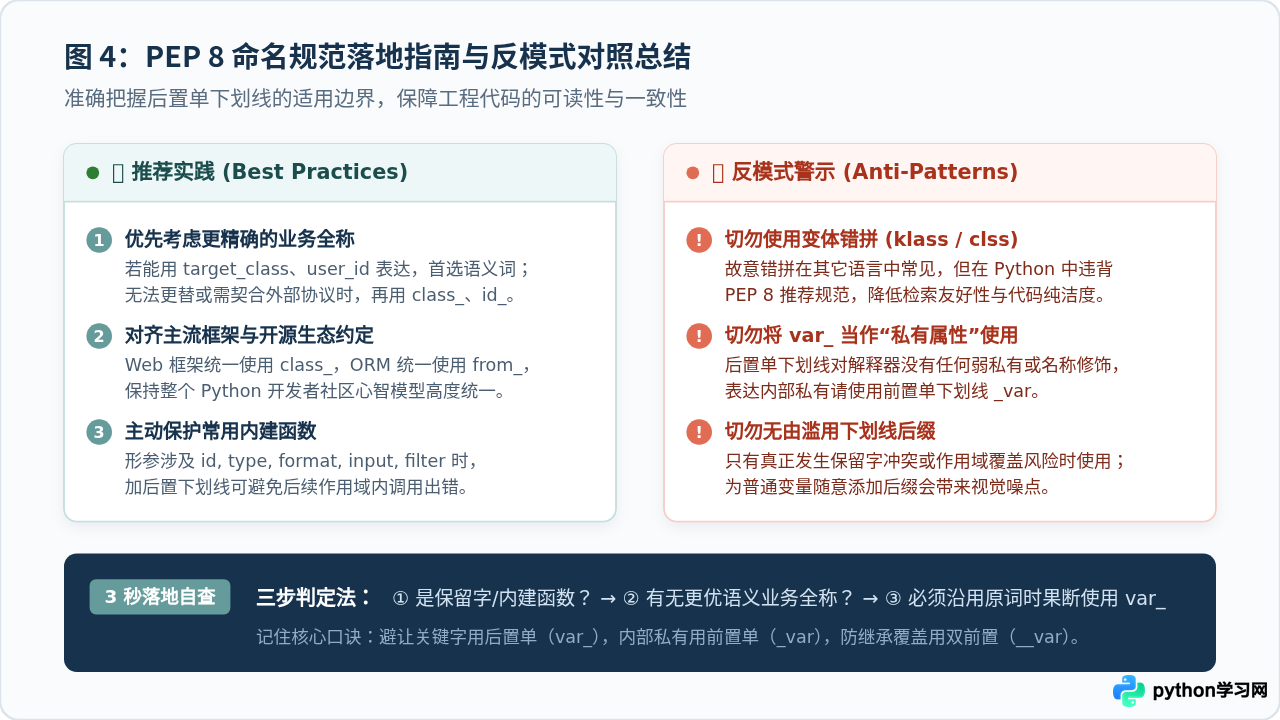
1. 最佳决策:优先评估是否有更明确的业务全称
遇到冲突时,并不是只有“添加后置下划线”这一条路。在很多业务场景下,使用更精准的上下文描述性名词往往是比 var_ 更好的选择:
- 表示用户身份标识时,使用
user_id比id_更具可读性。 - 表示页面样式类名时,在自研业务代码中直接命名为
css_class,语义比class_更具体。 - 表示文件数据格式时,使用
file_format代替format_。
只有当所处上下文要求变量名必须与该关键字完全对应(例如封装第三方标准库、通用参数解析器,或者该概念本身就是纯粹的 class / from),才果断使用 var_。
2. 警惕反模式:杜绝生造变体拼写(如 klass、clss)
class 拼写为 klass 或 clss、把 from 简写为 frm 来避开保留字。但在 Python 社区中,这种做法被明确视为反模式。PEP 8 官方之所以设立
class_ 规则,就是为了彻底终结“千人千拼”的混乱现象。使用标准的后置单下划线不仅保持了英语词汇的原本拼写,还能让全局搜索、自动化静态类型分析和代码重构工具准确识别。
3. 严禁误区:切勿用后置单下划线表达“私有化”
有些从其他编程语言转过来的开发者,习惯将类的私有成员写成 name_ 或 age_。在 Python 中,这种写法不仅完全无法阻挡外部访问,还会严重误导其他阅读代码的 Python 开发者,让人误以为 name 或 age 是 Python 的关键字。在 Python 中,约定内部使用的属性必须使用前置单下划线(_name)。
五、总结与三步自查清单
后置单下划线(var_)是 Python 语言哲学中“优雅、明确、实用”的典型体现。它通过一条极简的命名规则,在不破坏语法解析器严谨性的前提下,解决了自然语言词汇与编程语言保留字的重叠冲突。
在日常开发中,建议牢记以下三步判定法:
- 第一步(查冲突):检查预想的名字是否属于 Python 关键字(通过
keyword.iskeyword())或核心内建函数(如id、type)。 - 第二步(想语义):判断是否存在表达更完整、业务更具体的替代词(如
css_class、user_id、target_type)。若有,直接使用业务全称。 - 第三步(立规范):若概念本身必须与原词一致(如适配外部协议、通用形参映射),果断且规范地添加后置单下划线(如
class_、from_、id_),切勿使用klass等变体拼写。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









