

做数据科学必须装Anaconda吗?Python与Anaconda适用场景分析
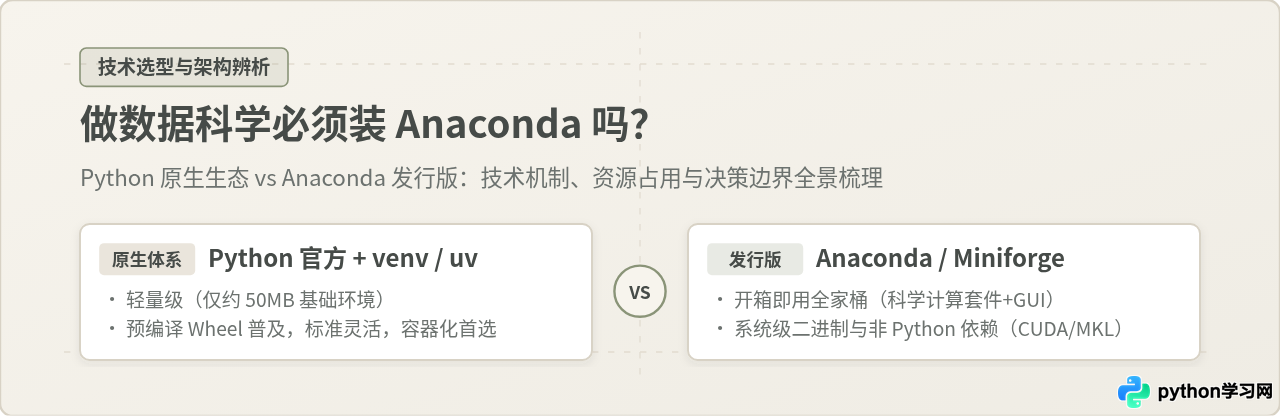
做数据科学是否必须安装Anaconda?深入解析官方原生Python与Anaconda在包管理机制、系统二进制依赖、资源占用及商用授权等方面的本质区别,并提供轻量化现代搭建实操步骤与清晰的场景选型指南。
一、辨析“必须装 Anaconda”的历史成因与认知偏差
在很多初学者教程、高校网课或求职面经中,“做数据分析第一步必须下载 Anaconda”几乎成了一条定律。这种说法的流传并非空穴来风,但它的合理性有严格的时间窗口与技术背景。要理性选型,首先需要分清该结论在何时成立,以及在现代生态中哪里发生了改变。
1. 为什么“必须装 Anaconda”在早期是合理的?
时间退回到 2015 年前后,Python 的核心科学计算库(如 NumPy、SciPy、Pandas、Scikit-learn)并不是纯 Python 代码,其内部包含大量需要高度优化的高性能 C、C++ 以及 Fortran 核心数学库。当时官方 PyPI 仓库主要分发源码包(sdist),在 Windows 或 macOS 上通过 pip install numpy 安装时,系统会在本地调用编译器。绝大多数初学者的电脑上并未预装 GCC 或 Fortran 编译器,安装过程频繁抛出令人费解的底层编译报错。
Anaconda 创始人 Travis Oliphant(也是 NumPy 的核心作者之一)精准解决了这个痛点:Anaconda 在官方安装包中直接集成了已经针对主流 CPU 架构编译完成的高性能数学库(如 Intel MKL)、配套编译器运行时,并预装了 Jupyter Notebook 和图形化导航界面(Anaconda Navigator)。在当时,它确实是保证初学者“装完即用”的唯一可靠方案。
2. 为什么在现代 Python 生态中该说法不再成立?
随着 Python 打包规范的演进,wheel(二进制轮子,后缀为 .whl)和 manylinux 标准成为了事实上的工业分发基石。如今,PyPI 上的核心计算库均直接提供针对主流操作系统与芯片架构(x86_64、Apple Silicon ARM64)的预编译二进制 Wheel。初学者即使在最干净的官方 Python 环境中执行安装,也是直接下载现成的二进制解压部署,不再触发本地编译流程。
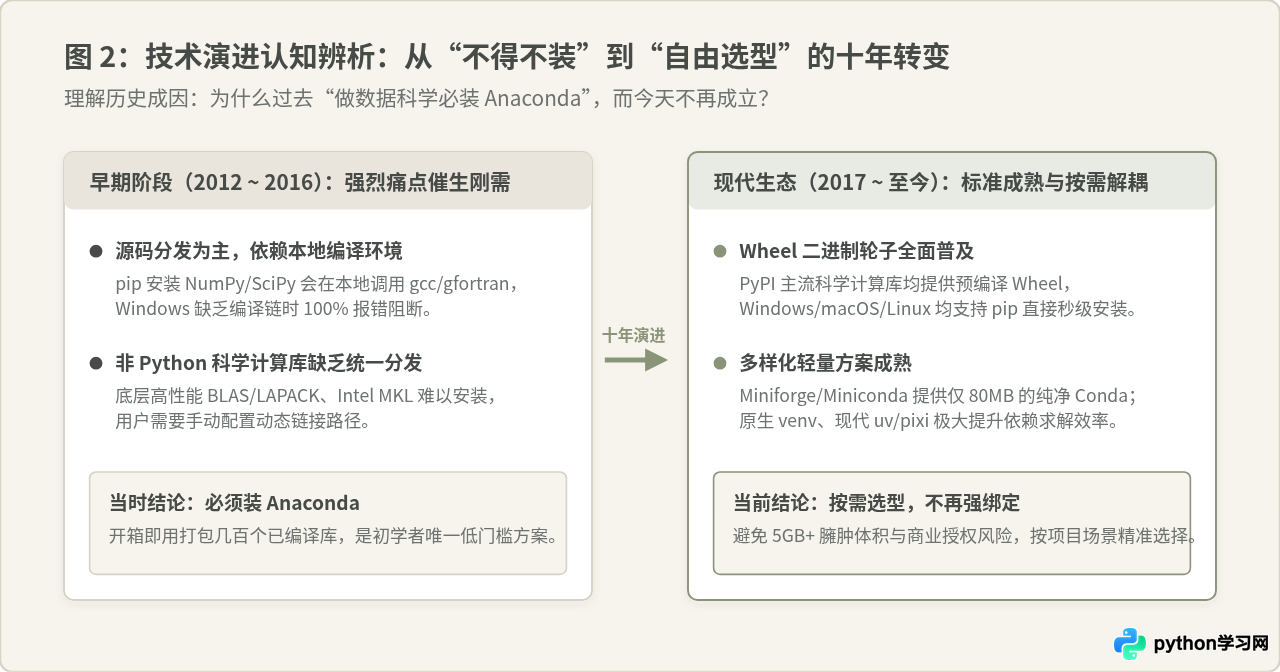
除了 Wheel 的普及,软件工程对轻量化、容器化(Docker)以及商业合规的要求,也让原版 Anaconda 的固有缺陷逐渐放大:
- 体积膨胀与环境污染:全量 Anaconda 完整安装包解压后通常占用 5GB 到 8GB 以上磁盘空间,预装数百个普通分析中从未用过的第三方库,极大拖慢环境扫描与备份速度;
- 依赖解析缓慢:经典的
conda在环境库增多后,SAT 求解器解析依赖版本冲突可能耗费数十分钟甚至锁死(虽然已引入libmamba改善,但基础开销依然存在); - 商业许可合规风险:Anaconda 公司更新了商业条款,在员工人数超过 200 人的商业组织中,访问 Anaconda 默认通道(
repo.anaconda.com)需要购买商业授权许可证,违规使用存在潜在法律与合规审计风险。
二、底层机制对比:官方 Python (pip) 与 Anaconda (conda)
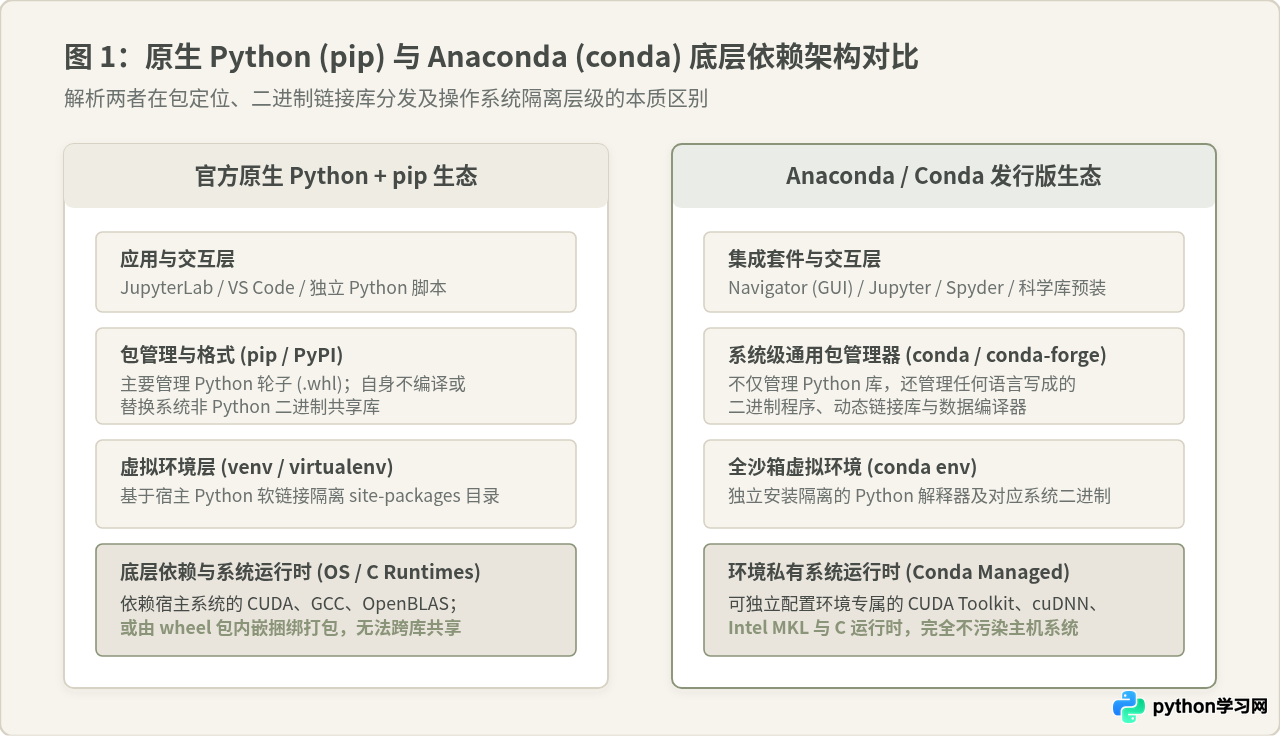
许多初次接触环境管理的开发者容易混淆 Python、pip、Anaconda 和 conda 的层次关系。明确它们在系统层级上的职责,有助于准确评估其适用边界。
1. 包管理范围的区别:Python 包 vs 系统二进制
pip 是 Python 语言层面的包管理器:它主要管理发布在 PyPI 上的 Python 轮子与源码。pip 不负责为你安装外部非 Python 软件。例如,当你在做深度学习需要特定版本的 CUDA 运行时或编译 C++ 扩展所用的动态库时,pip 无法代替你配置系统的显卡驱动底层组件。
conda 是跨语言、跨平台的系统级通用包管理器:在 conda 的视角下,Python 解释器本身也只是一个可以被安装和卸载的普通二进制包。conda 能够跨越语言边界,将 Python 运行时、R 语言、Intel MKL 数学库、Graphviz 绘图引擎、乃至特定版本的 CUDA Toolkit 打包在一个隔离的沙箱中分发。
2. 虚拟环境隔离机制的区别
Python 自带的 venv 模块通过软链接或拷贝宿主系统的 Python 可执行文件,为每个工程建立独立的 site-packages 目录,轻巧快速,基础环境开销几乎只有几十 KB 到几 MB。但 venv 无法在一个环境中切换或隔离不同主版本的 Python(例如当前系统安装的是 Python 3.11,venv 就只能创建 3.11 的虚拟环境)。
而 conda env 可以在同一台机器上随心所欲创建 python=3.9、python=3.10 或 python=3.12 的全套沙箱,每个环境不仅隔离 Python 库,还拥有独立的动态库搜索路径(LD_LIBRARY_PATH / DLLs 目录)。
三、实操演练:无需 Anaconda 搭建现代轻量化数据科学环境
如果你希望拥有一个启动飞快、占用极低(仅数百兆)、完全掌控的现代化数据科学环境,完全可以基于官方原生 Python 和轻量虚拟环境完成。
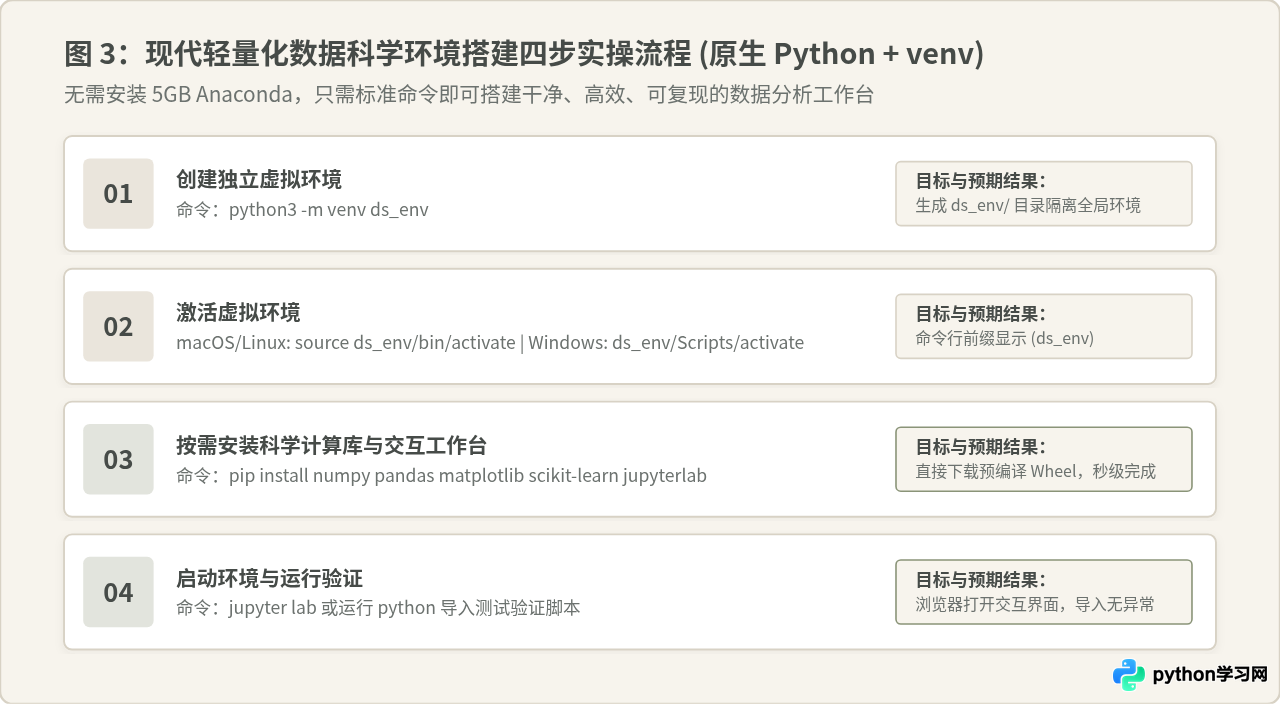
步骤 1:创建干净的工作目录与独立虚拟环境
在终端中进入项目存放路径,调用 Python 自带的 venv 模块初始化名为 ds_env 的独立虚拟环境:
# 1. 创建并进入专属分析项目目录
mkdir my_data_project && cd my_data_project

# 2. 调用标准库 venv 建立独立沙箱
python3 -m venv ds_env
该命令执行完毕后,当前目录下会生成一个 ds_env 文件夹。你可以检查该目录结构以确认环境已成功生成。
步骤 2:激活虚拟环境
执行对应系统的激活脚本。激活后,终端提示符前会自动出现 (ds_env) 标识,指示当前所有包操作均已锁定在此沙箱内:
source ds_env/bin/activate.\ds_env\Scripts\Activate.ps1步骤 3:按需安装核心科学计算与交互式套件
在激活的虚拟环境中,根据项目实际需要安装科学计算基础三件套与 JupyterLab 交互界面:
# 建议先升级 pip,以确保支持最新的 Wheel 标签解析
pip install --upgrade pip

# 精准按需安装数据科学核心库与 JupyterLab
pip install numpy pandas matplotlib scikit-learn jupyterlab步骤 4:验证环境并启动交互工作台
通过一行单行命令验证库的导入与版本输出,确认底层加速链接正常:
python -c "import numpy as np, pandas as pd; print(f'NumPy: {np.__version__}, Pandas: {pd.__version__}')"验证通过后,直接在当前目录启动 JupyterLab:
jupyter lab
系统默认浏览器会自动打开 http://localhost:8888/lab,呈现一个与 Anaconda 完全相同、甚至界面更纯粹敏捷的数据分析工作台。
(ds_env) 环境后再执行 jupyter lab,JupyterLab 就会默认绑定当前虚拟环境作为主内核。
四、两大生态适用场景与技术选型指南
既然 Anaconda 不是唯一的答案,那么什么时候该坚持用它,什么时候又该果断转向原生 Python 或轻量替代方案?我们可以从目标人群、依赖特征与商业合规三个维度做出判断。
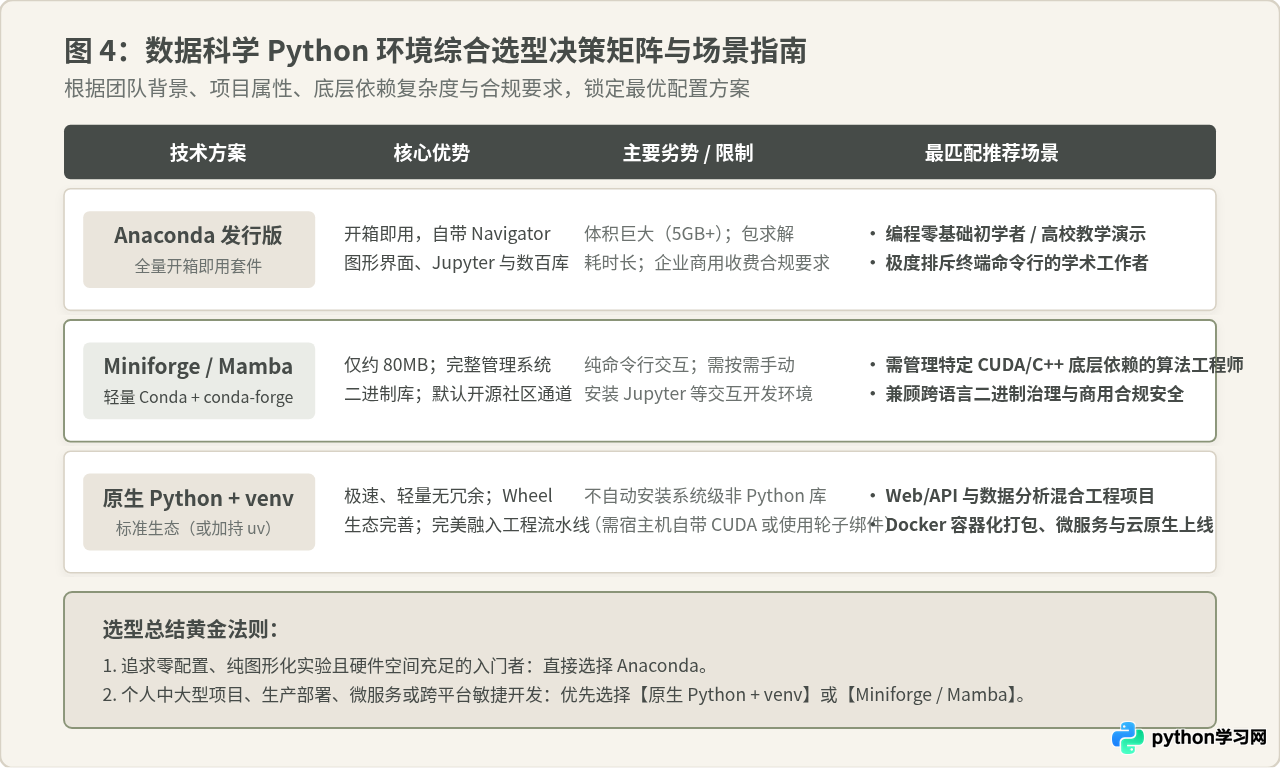
| 对比维度 | 官方原生 Python + venv | Miniforge / Miniconda | 全量 Anaconda 发行版 |
|---|---|---|---|
| 初始磁盘占用 | 约 50MB ~ 100MB | 约 80MB ~ 200MB | 5GB ~ 8GB+ |
| 底层管理能力 | 仅管理 Python 依赖,依赖宿主系统底层库 | 可管理独立 Python 版本及非 Python 二进制 (CUDA/C) | 全量管理非 Python 二进制及科学套件 |
| 图形化操作界面 | 无(推荐配合 VS Code 或浏览器 Jupyter) | 无(纯命令行,简洁高效) | 自带 Anaconda Navigator 图形化启动器 |
| 企业商用授权合规 | 完全开源自由(PSF 许可证) | 完全开源自由(conda-forge 社区通道) | 企业员工超 200 人需购买商业订阅 |
| CI/CD 与容器部署 | 原生适配,镜像极小,启动极快 | 适合需要特定编译依赖的容器化任务 | 体积过于庞大,通常不推荐用于生产部署 |
1. 仍然推荐使用全量 Anaconda 的场景
- 计算机与编程零基础的初学者:如果不熟悉终端命令行操作、对
PATH环境变量没有概念,Anaconda Navigator 提供的鼠标点击式操作能够最大程度避免被环境配置挫败兴趣; - 高校多媒体机房与短期培训:机房统一镜像安装后,无需每名学员逐个通过网络下载依赖,断网环境下也能保证开箱即用;
- 科研学术工作流中重度依赖 Spyder 等集成界面的研究人员:习惯于类似 MATLAB 变量查看器界面的学者,Anaconda 提供了统一的捆绑桌面集成。
2. 推荐使用官方原生 Python + venv / uv 的场景
- Web 开发、数据工程与数据科学混合项目:需要编写 FastAPI、Django 接口,或者使用 Celery 进行异步计算的项目,原生 Python 环境生态最干净、冲突最少;
- Docker 镜像构建与线上微服务部署:以精简的
python:3.11-slim为基础镜像,配合pip install -r requirements.txt,打包出的镜像仅有两三百兆,拉取与伸缩极快; - 追求纯粹、注重开发机磁盘空间与启动响应的工程师:无需忍受庞大无关组件的困扰。
3. 推荐使用 Miniforge / Miniconda 的“中间平衡”场景
如果你确实需要 conda 管理跨语言底层库的能力(例如管理特定版本的 CUDA Toolkit、OpenCV 底层编译库、R 语言混编环境,或者需要同时测试 Python 3.8 到 3.12 多个运行时),但又讨厌 Anaconda 臃肿的 5GB 体积与商业授权风险,那么 Miniforge 是目前业界最为推崇的现代标准方案:
- 体积仅约 80MB,默认接入完全开源免费的
conda-forge社区镜像通道,规避企业商业授权风险; - 内置高速依赖求解器(
mamba),彻底解决过去 conda 依赖解析耗费数十分钟的卡顿问题; - 对 Apple Silicon(M 系列芯片)及 Linux aarch64 架构提供极佳的原生编译支持。
五、关于环境选型的两个常见疑问
1. 可以在同一台电脑上同时安装原生 Python 和 Anaconda 吗?
可以同时安装,但强烈建议谨慎管理系统的 PATH 环境变量。许多初学者遇到“明明 pip 安装成功了,写代码时却提示 ModuleNotFoundError”的现象,通常就是因为系统 PATH 中原生 Python 与 Anaconda 的执行路径发生重叠,导致当前运行的解释器与执行安装的 pip 属于不同的环境。如果两者并存,建议不要勾选“将 Anaconda 添加到系统环境变量”,而是通过 Anaconda 专用的启动快捷方式或独立虚拟环境来调用。
2. 之前用 Anaconda 写的 .ipynb 笔记本,换成原生 Python 还能运行吗?
完全可以。Jupyter Notebook 的 .ipynb 文件本质上只是标准的 JSON 格式文本,记录了代码单元格与富文本输出,与你使用的是 Anaconda 还是原生 Python 的 JupyterLab 毫无关系。只要你在原生环境中通过 pip 补齐了该 Notebook 所导入的第三方库(如 pandas, seaborn),运行逻辑与结果不会有任何偏差。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









