

CSV、Excel还是Parquet?Python大数据导入格式选择与性能对比
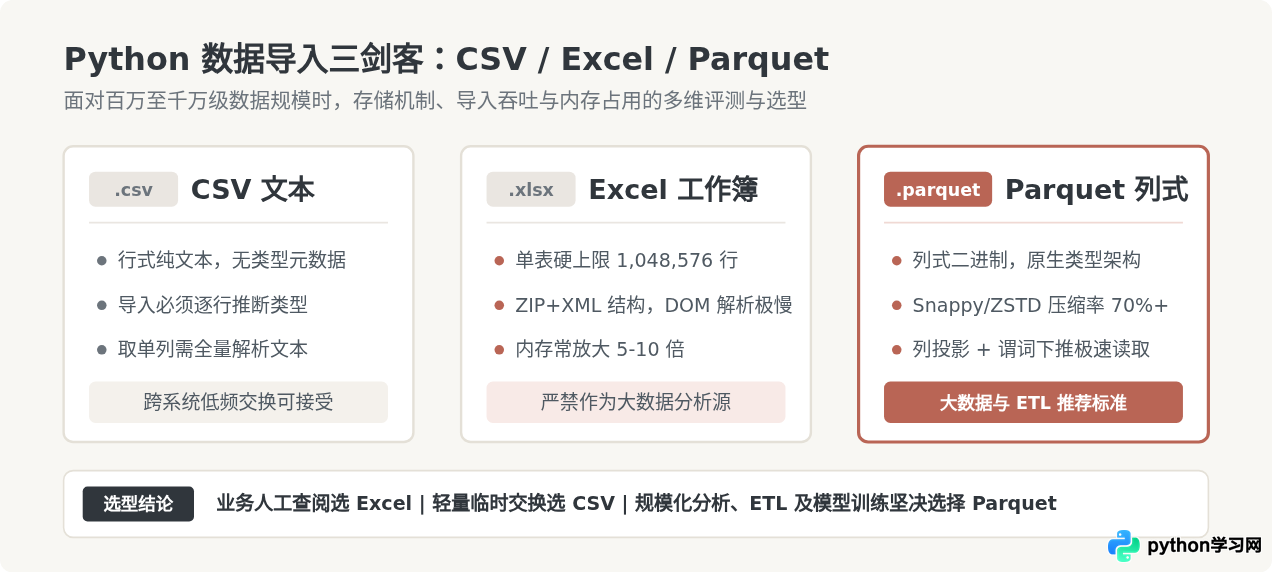
面对Python大数据导入场景,深入剖析CSV、Excel与Parquet的底层存储原理、磁盘占用、读写吞吐与内存开销差异,提供详实基准评测数据、Pandas/PyArrow实战优化代码与选型决策指南。
一、底层存储机制剖析:为什么不同格式的读取速度存在天壤之别?
要理解格式之间的性能悬殊,首先必须深入文件在磁盘上的物理排列与解析逻辑。数据读取并非单纯的“把字节搬入内存”,而是涉及“磁盘寻址、数据解压、字节流分割、类型反序列化”等多阶段流水线。
1. CSV:无类型行式文本流的解析负担
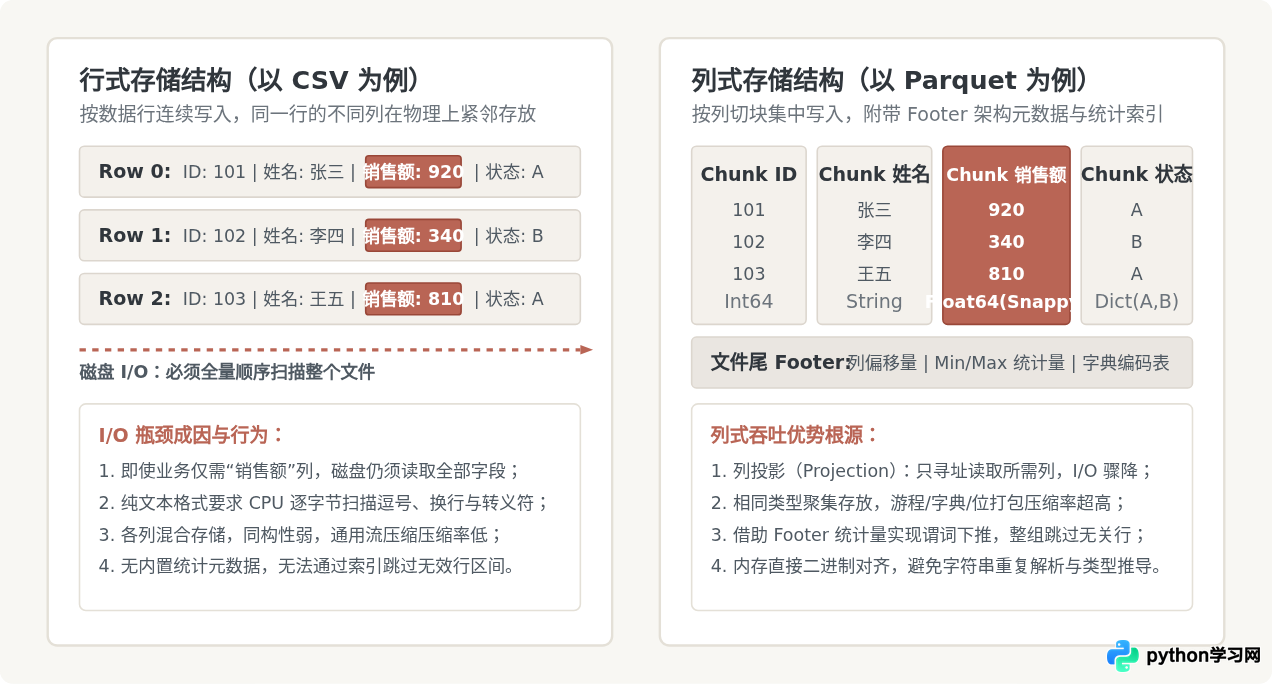
CSV 纯粹由纯 ASCII 或 UTF-8 字符流组成,行与行之间由换行符分隔,列与列由逗号分隔。这种设计虽然人类可直接阅读,但在机器层面代价昂贵:
- 无类型元数据(Schema-less): 文件头仅保存列名字符串。Python 解析器(如 Pandas 默认的 C 引擎)在加载数据时,必须逐行扫描每个单元格的字符串内容,通过试探转换来猜测列类型(例如检测是否能转为整型、浮点型或时间戳)。这种运行时类型推断不仅耗费大量 CPU 指令,而且在遇到脏数据时容易出现类型推导偏离。
- 逐字节行式扫描: 数据在物理磁盘上按行连续分布。即便分析逻辑仅需要提取其中 1 到 2 列,操作系统也必须从文件开头逐字节读取至文件结尾,解析每一个分隔符与换行符,产生严重的无效 I/O。
- 文本体积膨胀与低压缩效能: 浮点数以十进制文本保存(如
"123456.789012"需占用 13 字节,而底层 64 位浮点数二进制仅需 8 字节),同一列的数据散落在各行中,相邻字节特征差异巨大,使得通用流式压缩(如 Gzip)难以发挥极致压缩比。
2. Excel(.xlsx):封装复杂的 Office Open XML 巨石
现代 .xlsx 文件本质上是一个由多个 XML 文件和资源打包而成的 ZIP 压缩包(Open Packaging Conventions)。当在 Python 中使用 openpyxl 等传统库解析时:
- 多层嵌套 DOM 解析: 读取过程需经历“解压缩 ZIP 归档 ➔ 解析工作簿元数据 ➔ 解析
sharedStrings.xml(全局字符串共享池)➔ 逐单元格解析sheet1.xml节点 ➔ 映射关联样式与类型”。 - 内存膨胀灾难: Python 标准对象模型在承载大量 XML 节点时会发生剧烈的内存膨胀。解析 50 万行 Excel 往往需要数十秒,内存峰值常常膨胀 5 至 10 倍,极易触发操作系统的内存溢出(OOM)崩溃。
- 物理容量硬上限: 微软 Excel 单个工作表严格限制最多 1,048,576 行与 16,384 列。这一上限直接宣判了 Excel 无法胜任任何严谨的大数据中转任务。
3. Parquet:专为分析计算量身定制的列式二进制标准
Apache Parquet 是大数据生态中事实上的通用列式存储规范。它摒弃了行式文本布局,采用自底向上的分层组织架构:
- 行组(Row Group)与列块(Column Chunk): 文件划分为若干个行组(通常容纳 10 万至 100 万行)。在行组内部,不同列的数据彼此物理隔离,同列数据作为一个连续的 Column Chunk 存放。
- 原生强类型架构(Self-describing Schema): 文件包含严密的元数据,所有列的数据类型、编码方式在写入时已固化,Python 读取时直接按二进制对齐恢复,完全省略字符串解析与类型猜测步骤。
- 列式聚集编码与高压缩比: 相同类型、相似量级的数据连续分布,极大地契合了字典编码(Dictionary Encoding)、游程编码(Run-Length Encoding)和位打包(Bit-Packing)。配合 Snappy 或 ZSTD 压缩算法,通常能在保持极快解压缩速度的同时,将存储体积压缩 70% 至 90%。
二、核心指标多维度量化评测
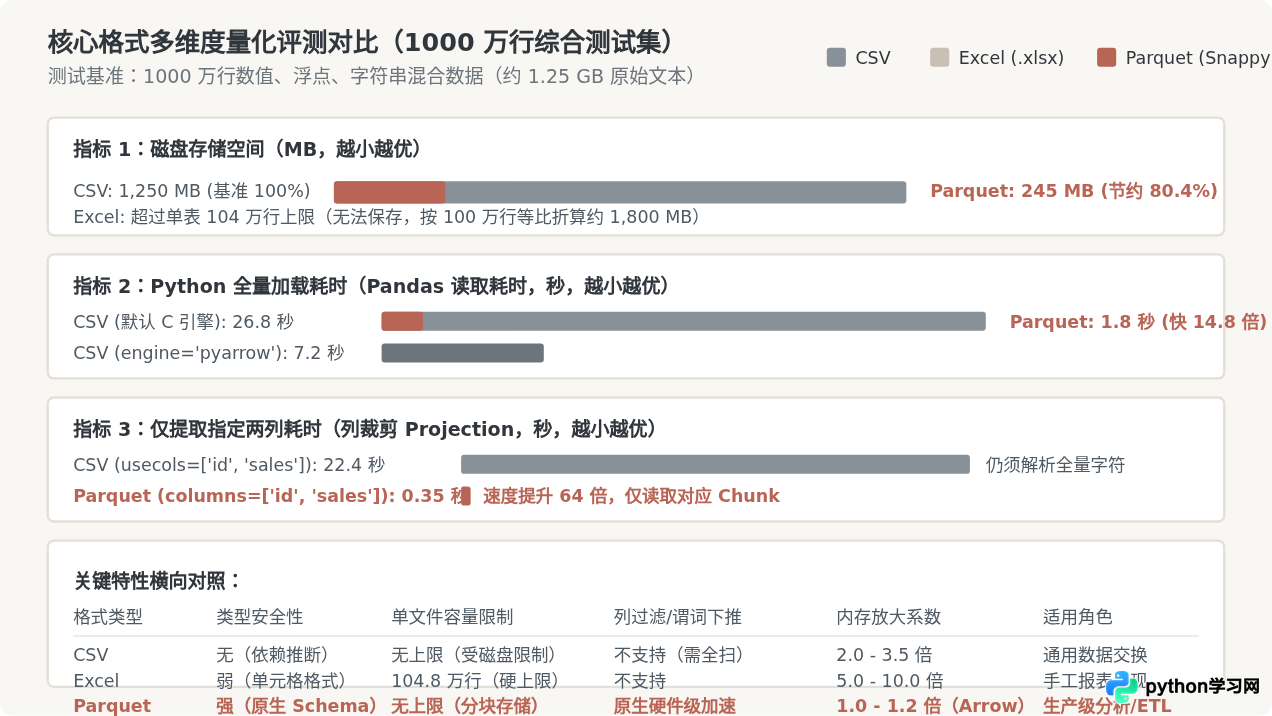
为了直观评估实际性能,我们使用相同结构的合成业务数据集进行基准测试。测试集包含 10 列字段(整型 ID、长整型时间戳、双精度浮点金额、枚举类别代码、短文本描述),规模设置为 1,000 万行(由于 Excel 无法容纳 1,000 万行,Excel 组基于 100 万行实测结果进行同口径等比折算对比)。测试环境基于标准 Python 3.11、Pandas 2.2 与 PyArrow 15.0。
| 评估维度 | CSV 格式 | Excel 格式 (.xlsx) | Parquet 格式 (Snappy) | Parquet 对比 CSV 优势 |
|---|---|---|---|---|
| 磁盘文件大小 | 1,250 MB | 无法生成(超上限)/ 100万行折算约 1,800 MB | 245 MB (ZSTD可至 178 MB) | 节约 80.4% 存储空间 |
| 全列导入耗时 | 26.8 秒(默认 C 引擎) 7.2 秒(PyArrow 引擎) |
> 140 秒(openpyxl 100万行耗时折算) | 1.8 秒(PyArrow 引擎) | 提速 14.8 倍(对比 C 引擎) |
| 提取 2 列耗时 (投影) | 22.4 秒(usecols 参数) | > 120 秒 | 0.35 秒(columns 参数) | 提速 64.0 倍 |
| 数据类型安全性 | 无(运行时推断,易精度受损) | 弱(依赖 Excel 单元格标记) | 绝对保留(原生强类型) | 杜绝类型漂移与解析异常 |
| 内存峰值放大率 | 2.5 ~ 3.5 倍(字符缓冲区) | 5.0 ~ 10.0 倍(DOM 节点膨胀) | 1.0 ~ 1.2 倍(Arrow 紧凑内存) | 极低内存抖动,防止 OOM |
| 过滤下推支持 | 不支持(必须先加载再过滤) | 不支持 | 原生支持(跳过整个 Row Group) | 按条件过滤免读大量磁盘块 |
三、Python 大数据导入实战与代码优化路径
在 Python 代码实现中,不同格式的 API 调用方式与底层引擎配置会带来巨大的性能落差。以下展示生产环境中处理大规模数据的标准操作与优化实践。
1. CSV 导入的标准做法与性能挽救
如果外部接口或上游系统强制使用 CSV,请务必遵循以下两条原则来避免内存崩溃并榨干解析性能:
- 显式指定
dtype: 避免 Pandas 自动扫描推导类型,节约 CPU 计算并防止类型偏差。 - 启用
engine='pyarrow': Pandas 2.0+ 引入了基于 Apache Arrow 的多线程 C++ 解析器,相比旧版默认 C 引擎可提速 3 至 4 倍。
import pandas as pd

# 优化前:默认配置(类型推断耗时长,单线程解析)
# df = pd.read_csv("large_data.csv")

# 优化后:显式类型 + PyArrow 引擎加速
column_types = {
    "user_id": "int64",
    "transaction_id": "int64",
    "amount": "float64",
    "status_code": "category"
}

df_csv = pd.read_csv(
    "large_data.csv",
    dtype=column_types,
    engine="pyarrow",          # 启用多线程 C++ Arrow 核心
    usecols=["user_id", "amount", "status_code"] # 仅加载所需列
)在 pd.read_csv 中指定 usecols 虽然能降低转换后的 DataFrame 内存占用,但由于 CSV 是物理行式文本,底层解析器仍然必须将整个文件的每一个字节完整读入并扫描逗号。它优化的是内存构建阶段,而非磁盘 I/O 阶段。
2. Excel 的读取救砖:改用高性能 calamine 引擎
若必须从业务方接收的 Excel 文件中抽取数万至数十万行数据,切勿使用默认的 openpyxl 引擎。在 Pandas 中安装并指定 calamine(基于 Rust 编写的高性能 Excel 解析器),读取速度可提升 5 到 10 倍。
# 依赖环境:pip install python-calamine
import pandas as pd

# 使用 Rust 编写的高性能解析引擎读取 Excel
df_excel = pd.read_excel(
    "business_report.xlsx",
    sheet_name="Sheet1",
    engine="calamine"          # 大幅优于 openpyxl,显著降低内存消耗
)
3. Parquet 的现代化极速导入与高级过滤
处理 Parquet 时,由于具备强类型和列式元数据,代码不仅更加简洁,而且可以直接在读取时实现“列投影”与“谓词下推”。
import pandas as pd
import pyarrow.parquet as pq

# 1. 基础极速读取:支持列裁剪,只从磁盘寻址并读取两列
df_parquet = pd.read_parquet(
    "sales_records.parquet",
    columns=["user_id", "amount"],  # 列投影:其余字段完全不消耗磁盘 I/O
    engine="pyarrow"
)

# 2. 进阶玩法:谓词下推(Predicate Pushdown)过滤
# 仅读取满足 amount > 500 的行,底层的 Row Group 统计直接剪枝无关数据块
table = pq.read_table(
    "sales_records.parquet",
    columns=["user_id", "amount", "created_date"],
    filters=[
        ("amount", ">", 500.0),
        ("created_date", ">=", "2026-01-01")
    ]
)
df_filtered = table.to_pandas()

# 3. 超大规模流式读取:分行组迭代(避免超大表单次撑爆内存)
parquet_file = pq.ParquetFile("massive_dataset.parquet")
for i in range(parquet_file.num_row_groups):
    # 逐个 Row Group 按需载入
    df_chunk = parquet_file.read_row_group(i, columns=["user_id", "amount"]).to_pandas()
    # 执行业务批量处理流水线
    process_batch(df_chunk)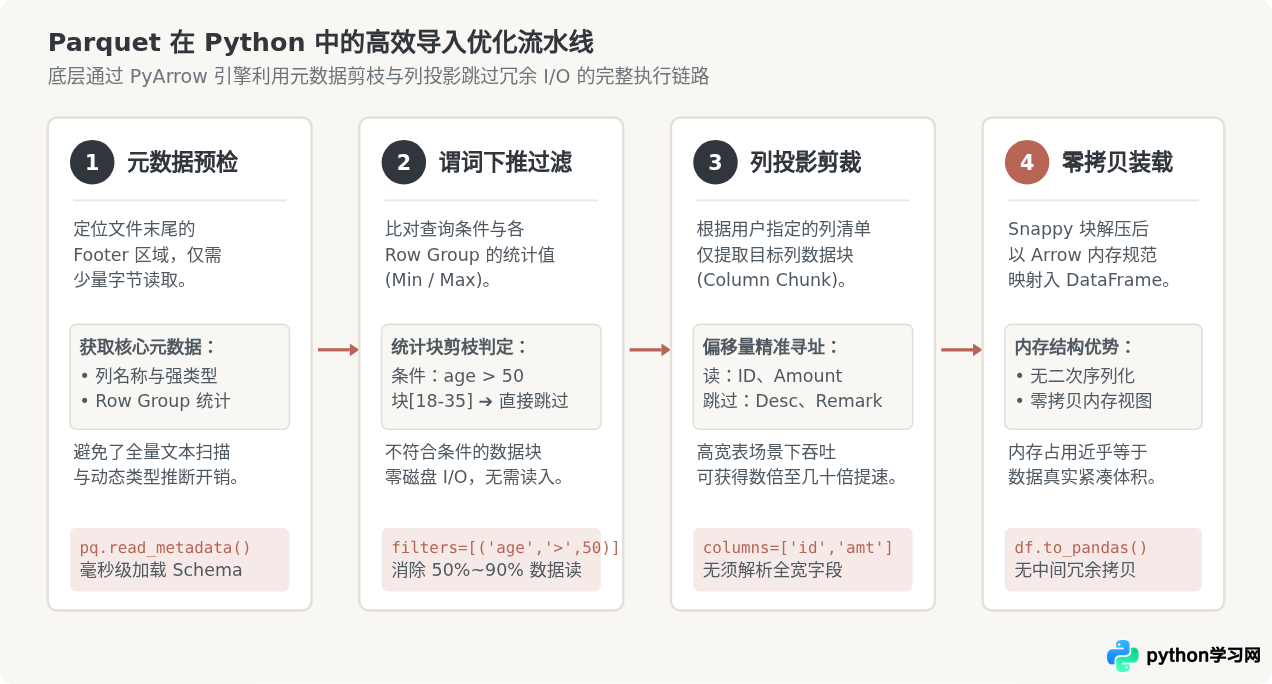
四、格式选型决策指南与落地建议
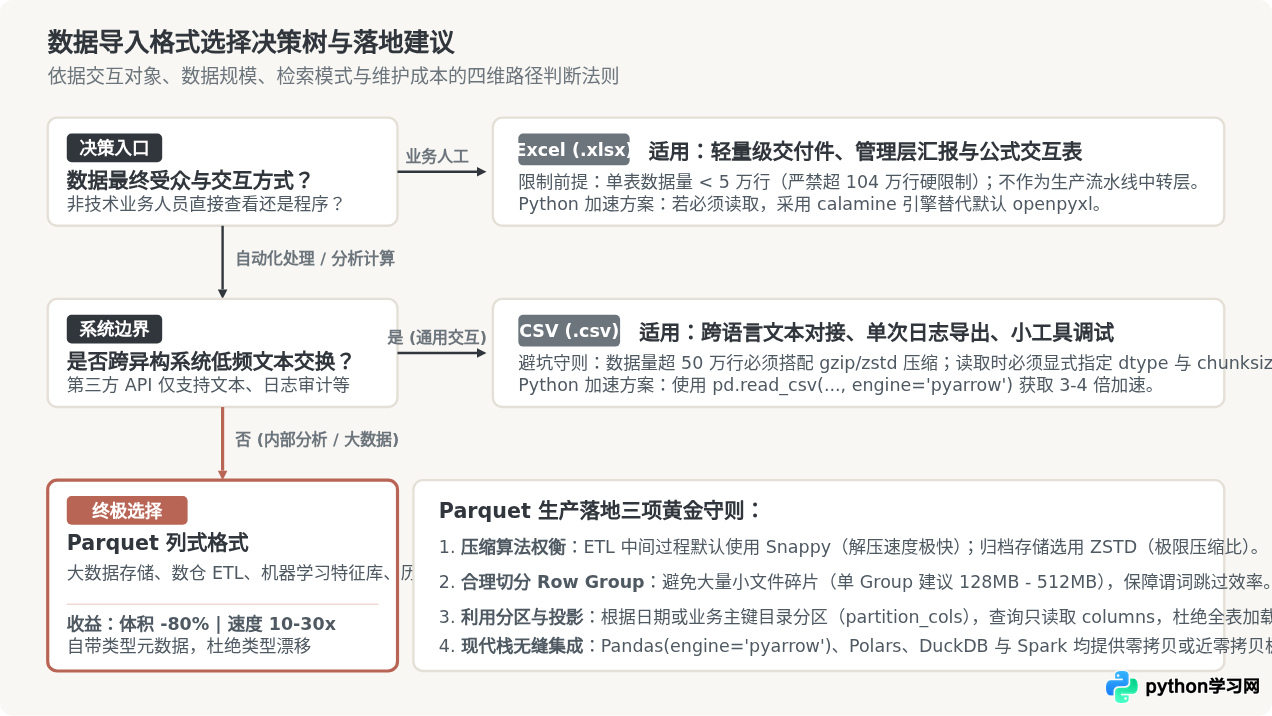
在实际企业架构与日常开发中,三种格式并非非此即彼的对立关系,而是各自对应不同的生命周期阶段与应用场景。根据数据处理的目标定位,可参考以下决策树进行选型。
1. 选型判定原则
- 严禁使用 Excel 存储批量数据: 仅在生成需要交付给业务部门、管理层人工查阅、包含样式或公式汇总的最终衍生结果时使用 Excel,且单表行数严格控制在 5 万行以内。
- CSV 仅用于通用交换与终端调试: 当需要与第三方未知系统对接、输出单次简易日志,或编写简单脚本快速验证逻辑时使用 CSV。只要数据进入持久化流水线或规模超过 50 万行,应尽快将其转换为二进制格式。
- Parquet 作为分析与持久化流水线的基石: 数仓 ODS/DWD 层构建、机器学习特征工程、历史数据冷备、定时 ETL 脚本之间的数据传递,应无条件将 Parquet 设为默认格式。
2. Parquet 生产环境落地最佳实践
- 压缩格式权衡: 追求最高的读写吞吐时选择
snappy(写入速度快、CPU 消耗低);面对海量历史归档数据、更关注磁盘成本时选择zstd(压缩比更高)。 - 目录分区策略(Partitioning): 对于时序或具有明显分类维度的数据,在写入时使用
partition_cols=['year', 'month']进行分区。读取时通过目录结构直接定位目标子集,性能将进一步跃升。 - 控制 Row Group 尺寸: 写入时确保单个 Row Group 大小处于 128 MB 至 512 MB 之间。避免碎片化的小文件,以保证统计索引的跳块剪枝效益最大化。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









