

2026年Python高性能计算框架对比:Numba、Cython与现代替代方案
深度解析2026年Python高性能计算与加速框架格局:系统对比Numba即时编译、Cython提前编译以及现代Rust(PyO3)、Mojo等新一代替代方案,剖析技术架构、编译调用管线、内存安全、分发成本及选型决策树。
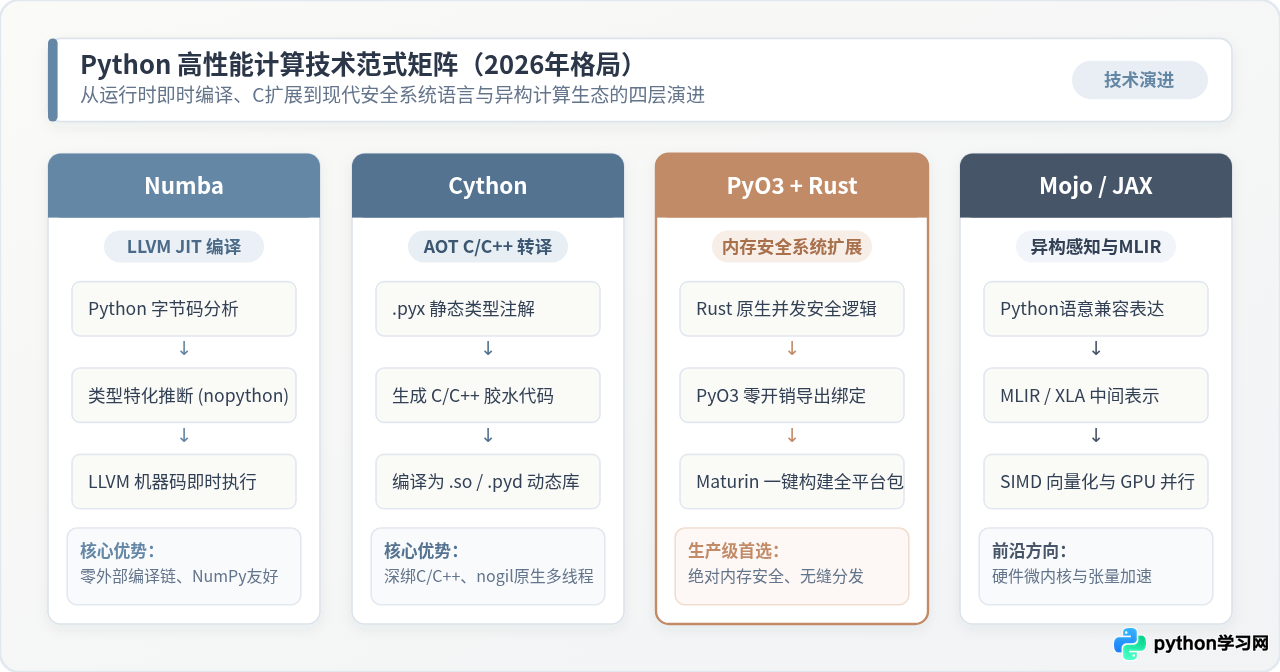
一、性能瓶颈根源:Python 为什么需要外部加速框架?
Python 在科研计算、数据科学与后端应用中广受青睐,但原生 CPython 解释器在 CPU 密集型任务中的执行耗时常常成为系统瓶颈。理解性能滞后的根源,是合理选用加速方案的前提条件:
- 动态类型装箱与拆箱(Boxing Overhead):在 Python 中,哪怕是最基础的整型或浮点型运算,底层均表示为一个具备引用计数、类型指针和属性字典的堆对象(
PyObject)。每次循环累加,解释器都需要经历解引用、类型校验与新对象分配,无法直接映射为 CPU 原生算术寄存器指令。 - 字节码解释执行与虚函数分派:CPython 采用巨大的主循环(Eval Loop)逐条分派字节码指令。分支预测失效、指令缓存未命中以及高度动态的方法查找,使得简单内层循环的指令周期数成倍增加。
- 全局解释器锁(GIL)与线程限制:尽管从 Python 3.13 起正式引入了自由线程构建(Free-threaded CPython,无 GIL 模式),但在执行纯 Python 字节码时,单线程数值吞吐量并不会因为去除 GIL 而凭空提升,且引用计数的原子操作反而可能引入局部开销。要真正释放现代多核 CPU 的向量化指令集(如 AVX-512、ARM Neon),必须脱离解释器执行环境。
二、Numba 深度解析:针对数值循环的 JIT 即时编译利器
Numba 由 Anaconda 团队主导维护,其核心设计目标是“以最低的代码侵入成本,加速 NumPy 数组计算”。
1. 工作机制与编译流程
Numba 是典型的 JIT(Just-In-Time)编译器。当函数首次被执行时,Numba 的字节码分析器捕获传入参数的实际数据类型(如 float64[:, :]),将 Python 抽象语法树转换为类型特化的静态控制流图,进而发射 LLVM 中间表示(LLVM IR)。LLVM 优化器会执行死代码消除、循环展开与自动 SIMD 向量化,最终生成宿主机架构的原生机器指令。
import numpy as np
from numba import njit, prange

# 核心数值计算:蒙特卡洛多维热传导仿真核心循环
@njit(parallel=True, fastmath=True, nogil=True)
def simulate_heat_transfer(grid: np.ndarray, iterations: int) -> np.ndarray:
    rows, cols = grid.shape
    current = grid.copy()
    next_grid = np.zeros_like(grid)

    for it in range(iterations):
        # prange 触发 OpenMP 风格的多线程并行切分
        for i in prange(1, rows - 1):
            for j in range(1, cols - 1):
                next_grid[i, j] = 0.25 * (
                    current[i - 1, j] +
                    current[i + 1, j] +
                    current[i, j - 1] +
                    current[i, j + 1]
                )
        # 双缓冲状态交换
        current, next_grid = next_grid, current

    return current
2. 适用边界与工程限制
- 严格依赖
nopython模式:只有在代码完全摆脱 Python 解释器对象(无字典、无动态反射、无非数值类)时,Numba 才能发挥接近 C 语言的性能。若被迫退化为object模式,不仅没有加速,反而增加 JIT 开销。 - 冷启动编译延迟(JIT Overhead):函数首次执行需要数百毫秒至数秒进行类型推导与 LLVM 编译。在命令行交互工具、微服务冷启动或高频短生命周期容器中,该延迟尤为明显。
- 二进制分发困难:Numba 代码本质仍是 Python 脚本,无法脱离本地 Numba 运行时及 LLVM 依赖单独打包分发,不适合开发底层公共库。
三、Cython 深度解析:连接 C/C++ 生态的传统工业支柱
Cython 是 Python 高性能领域的“元老级”工具,广泛应用于 NumPy、SciPy、Pandas、scikit-learn 等基础科学库。它既是一门静态类型超集语言,也是一套将 Python 代码编译为 C/C++ 共享动态库的 AOT 工具链。
1. 工作机制与代码形态
Cython 的核心思想是类型擦除与静态化绑定。在 Cython 3.0+ 时代,开发者既可以使用传统的 .pyx 专有语法,也可以直接使用符合 PEP 484 的纯 Python 类型注解编写代码。Cython 编译器将源码转译为包含海量 CPython C-API 调用的 .c 文件,再由宿主系统的 GCC 或 Clang 编译为 .so(Linux/macOS)或 .pyd(Windows)。
# heat_cython.pyx
# cython: boundscheck=False, wraparound=False, cdivision=True
cimport cython
from cython.parallel import prange
import numpy as np
cimport numpy as cnp

def simulate_cython(double[:, :] grid, int iterations):
    cdef int rows = grid.shape[0]
    cdef int cols = grid.shape[1]
    cdef int it, i, j

    # 分配连续 C 内存,脱离 Python 堆
    cdef double[:, :] current = grid.copy()
    cdef double[:, :] next_grid = np.zeros((rows, cols), dtype=np.float64)
    cdef double[:, :] temp

    # 彻底释放全局解释器锁,利用 OpenMP 并行
    with nogil:
        for it in range(iterations):
            for i in prange(1, rows - 1):
                for j in range(1, cols - 1):
                    next_grid[i, j] = 0.25 * (
                        current[i - 1, j] +
                        current[i + 1, j] +
                        current[i, j - 1] +
                        current[i, j + 1]
                    )
            # 指针级数组引用交换
            temp = current
            current = next_grid
            next_grid = temp

    return np.asarray(current)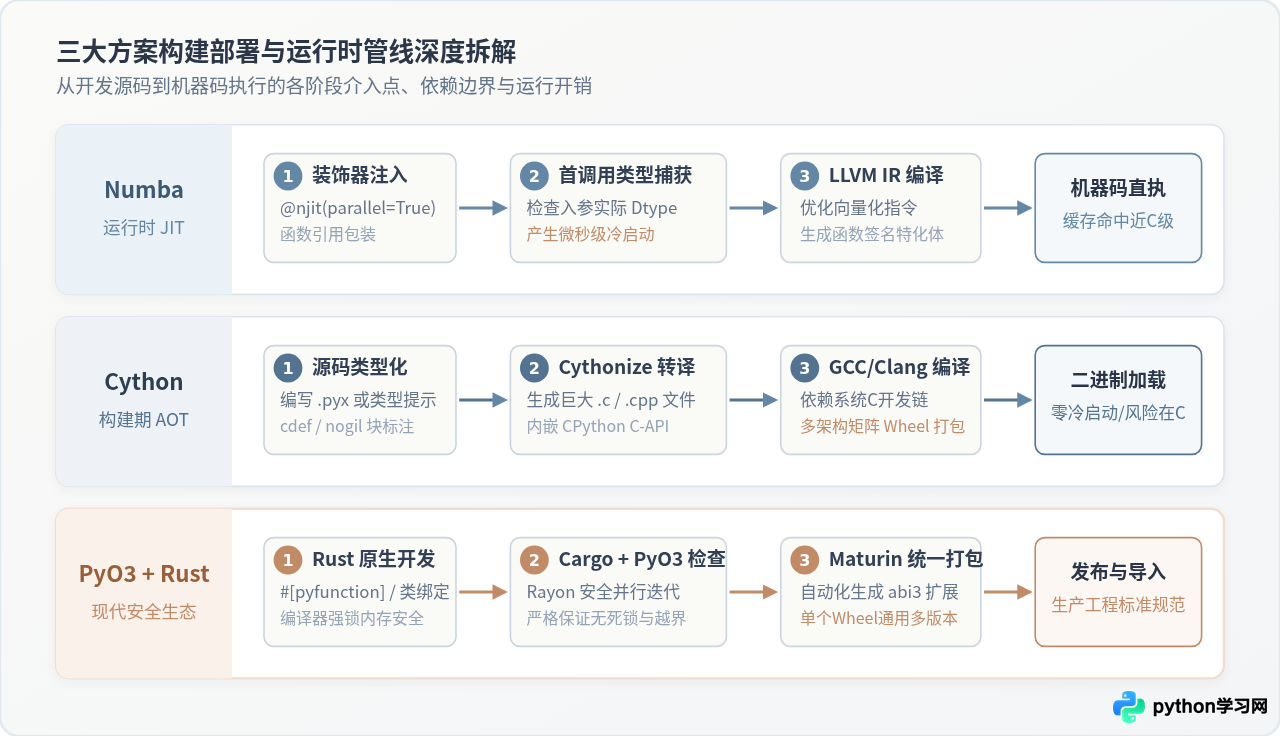
2. 工程实践中的痛点
- 致命的内存安全风险:为了追求极致速度,Cython 代码通常显式关闭边界检查(
boundscheck=False)与负索引回绕(wraparound=False)。一旦出现指针越界或生命周期误用,程序将直接发生 Segmentation Fault(段错误)导致整个 Python 进程崩溃,调试极其艰苦。 - 极高的构建与维护复杂度:每个目标系统(Linux glibc 版本、macOS ARM/x86、Windows MSVC)都需要完整的 C 编译套件与针对 Python 多版本(3.10、3.11、3.12、3.13)构建多架构矩阵 Wheel,CI 耗时长且易出现环境不一致。
四、现代替代方案崛起:为什么工程界正在转向 Rust (PyO3) 与 Mojo?
随着软件工程对内存安全性与跨平台分发体验要求的提高,以 PyO3(Rust)和 Mojo 为代表的现代方案正在迅速重塑生态格局。
1. Rust + PyO3:生产级 Python 扩展的新基石
在 2026 年,诸如 Polars(高性能 DataFrame)、Ruff(极速 Linter)、Pydantic Core、Cryptography 等顶尖库均已全面采用 Rust 作为核心加速层。PyO3 配合专用的打包工具 Maturin,带来了前所未有的工程优势:
- 编译期强制保障的内存安全:借助 Rust 的所有权(Ownership)与生命周期系统,开发者在编写高并发、无锁或多线程数据密集型代码时,完全无需担心段错误、悬空指针或数据竞争。
- 零成本抽象与现代化生态:可以无缝利用 Rust 庞大的 crates.io 生态(例如极速并行库
rayon、零拷贝反序列化serde、SIMD 数值库ndarray)。 - 一键式跨平台分发(Stable ABI3):利用 CPython 的受限 API(
abi3),开发者编译一次动态库,即可兼容 Python 3.8+ 至当前任意新版本,极大削减 CI/CD 负担与 Wheel 包体积。
// src/lib.rs - 使用 PyO3 与 Rayon 实现安全的多线程数值运算
use pyo3::prelude::*;
use pyo3::exceptions::PyValueError;
use rayon::prelude::*;

#[pyfunction]
fn parallel_vector_dot(a: Vec<f64>, b: Vec<f64>) -> PyResult<f64> {
    if a.len() != b.len() {
        return Err(PyValueError::new_err("向量长度不一致"));
    }

    // 自动在线程池中并行分块执行 SIMD 向量化点积,无 GIL 阻碍,100% 内存安全
    let sum: f64 = a
        .par_iter()
        .zip(b.par_iter())
        .map(|(x, y)| x * y)
        .sum();

    Ok(sum)
}

#[pymodule]
fn fast_math(_py: Python, m: &PyModule) -> PyResult<()> {
    m.add_function(wrap_pyfunction!(parallel_vector_dot, m)?)?;
    Ok(())
}
2. Mojo:面向 AI 与异构计算的 Python 现代超集
由 LLVM 和 Swift 之父 Chris Lattner 创办的 Modular 团队研发的 Mojo,旨在从语言层面彻底解决“双重语言问题”(即 Python 负责顶层黏合、C++/CUDA 负责底层高性能)。
- 语法与心智模型统一:Mojo 语法高度兼容 Python,开发者可以使用熟悉的动态交互语法(
def),在需要极限性能的关键热点则使用带强静态类型、显式所有权声明(fn、struct)的高性能原语。 - 基于 MLIR 的全栈硬件支持:Mojo 底层深度集成多级中间表示(MLIR),原生支持跨 CPU、GPU、TPU 等异构计算单元的代码生成,内置强大的 SIMD 向量化及分块平铺(Tiling)原语,特别适合自研算子与微内核优化。
3. JAX:函数式张量与自动编译流派
对于纯数学计算与机器学习领域,Google 开发的 JAX 提供了另一种不脱离 Python 语法的加速范式。通过 jax.jit 调用 XLA 编译器,支持自动向量化(vmap)和设备卸载,在保持纯函数式无副作用代码结构的前提下,将 NumPy 风格操作直接编译至 GPU/TPU 高效执行。
五、多维度综合对比矩阵
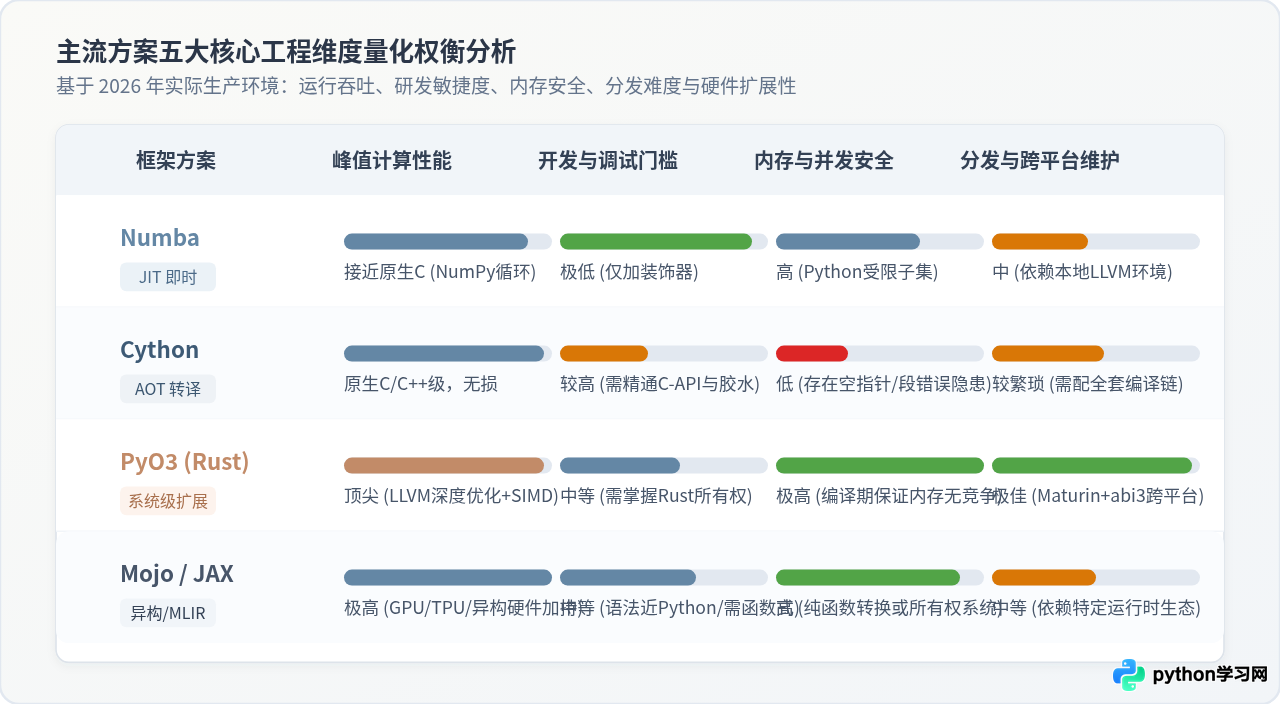
为了从系统工程视角量化选型考量,下表汇总了主流方案在 2026 年技术条件下的各核心指标表现:
| 对比维度 | Numba | Cython (3.0+) | PyO3 + Rust | Mojo |
|---|---|---|---|---|
| 编译范式 | 运行时 JIT (LLVM) | 构建期 AOT (转译为 C/C++) | 构建期 AOT (Rustc 编译) | AOT / JIT (MLIR 基础设施) |
| 开发侵入性 | 极低(仅需添加函数装饰器) | 中/高(需修改文件扩展名或类型声明) | 中等(需掌握 Rust 语言) | 低至中(近 Python 语法,学习曲线平缓) |
| 峰值加速比 | 10x - 80x (NumPy密集循环) | 20x - 120x (深度静态化优化) | 20x - 120x (SIMD + 深度内联) | 30x - 150x+ (异构加速与向量化) |
| 内存与并发安全 | 高(受限 Python 沙箱) | 低(存在裸指针越界与段错误风险) | 极高(编译期借用检查器强制防呆) | 极高(显式所有权与生命周期) |
| 打包与分发难度 | 中(需要本地动态环境) | 高(需构建多平台 OS/Python 矩阵 Wheel) | 极佳(Maturin + abi3 单 Wheel 通用) | 演进中(依赖 Modular 专有工具链) |
| 典型最佳应用场景 | 数据分析、科学计算原型快速迭代 | 遗留 C/C++ 复杂系统绑定与胶水接入 | 生产级高并发服务、关键基础库重构 | AI 算子自研、异构计算与硬件微内核 |
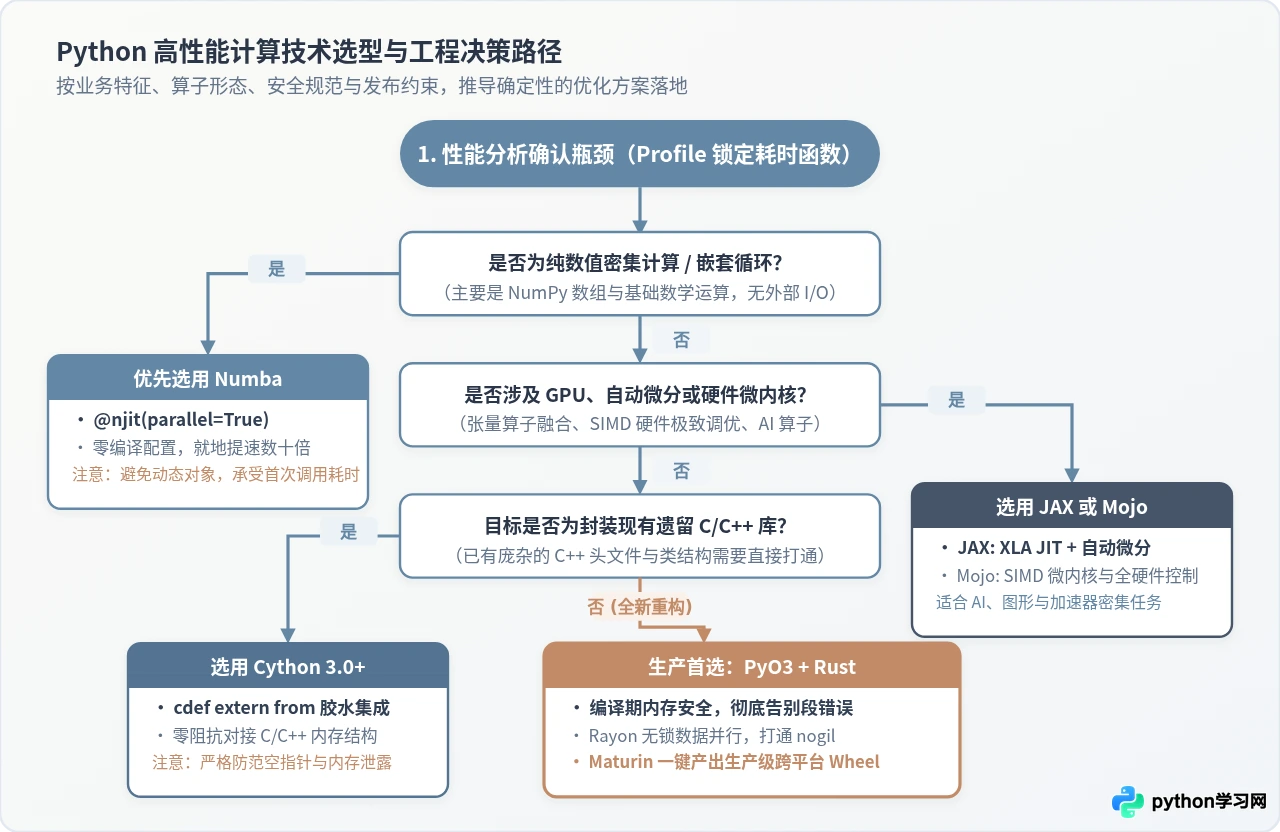
六、工程落地:性能优化排查与实施四步法
盲目引入加速框架往往会导致项目复杂度急剧膨胀,反而带来难以调试的负面效果。在实际落地加速改造时,建议遵循以下标准执行流程:
-
第一步:严谨的性能剖析(Profiling First)
不要凭直觉推测性能瓶颈。先使用现代采样分析工具(如scalene、py-spy或cProfile)定位系统热点。确认耗时究竟源自CPU密集型循环、GIL争用还是I/O等待。仅对占总耗时 80% 以上的关键热点函数实施重构。 -
第二步:消除数据跨界拷贝(Zero-Copy Boundary)
跨语言交互的最大隐形杀手是数据序列化与重复内存分配。无论是 Numba、Cython 还是 PyO3,都要优先使用标准 Buffer 协议(NumPy 内存视图、Arrow 格式或 PyCapsule),确保底层数据共享同一块物理内存。 -
第三步:明确并发与线程解绑策略(Releasing GIL)
如果需要在多核 CPU 上实现真并行,必须确保在进入紧凑计算前彻底释放 GIL。例如在 Numba 中使用nogil=True,在 Cython 中包裹with nogil:,在 PyO3 中调用py.allow_threads(...)。 -
第四步:建立自动化基准测试与 CI 防护网(Continuous Benchmarking)
引入pytest-benchmark或codspeed,在持续集成中对优化模块设立性能回归底线,确保后续迭代不会由于不经意的类型退化导致性能骤降。
七、高频疑难与避坑指南
常见原因包括:函数内部调用了不受支持的 Python 内置类型(例如将 Python 字典嵌套在循环中、使用了带有闭包属性的第三方对象)。Numba 无法将其映射至 LLVM 原生标量类型。解决办法是:保持计算函数极简,仅接收连续 NumPy 数组与基本标量数据,外部业务逻辑与状态机留在纯 Python 层。
在调试阶段,务必移除
boundscheck=False 和 wraparound=False,开启 Cython 的异常捕获和越界检查。若必须使用裸 C 指针,确保其生命周期受父级 Python 对象的正确引用保护。若经常受段错误困扰,应当果断评估将该模块迁移至 PyO3/Rust,借助编译器消除此类隐患。
答案是依然至关重要。Free-threaded CPython 解决的是多线程并发执行 Python 字节码的锁竞争问题,并未改变单线程解释字节码的动态开销。纯 Python 循环的指令级效率依然远落后于编译型代码。此外,Rust 原生支持的
Send 与 Sync 线程安全特性,在无 GIL 时代能完美避免底层多线程数据竞态,工程价值更加突出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









