

机器学习实验中怎么正确管理Python随机种子以确保可复现性
深入解析Python机器学习与深度学习实验中随机种子的多层次管理方法,涵盖环境散列、NumPy、PyTorch、DataLoader多进程Worker以及cuDNN底层硬件算子的确定性锁定,提供开箱即用的统一种子管理方案与对比分析。
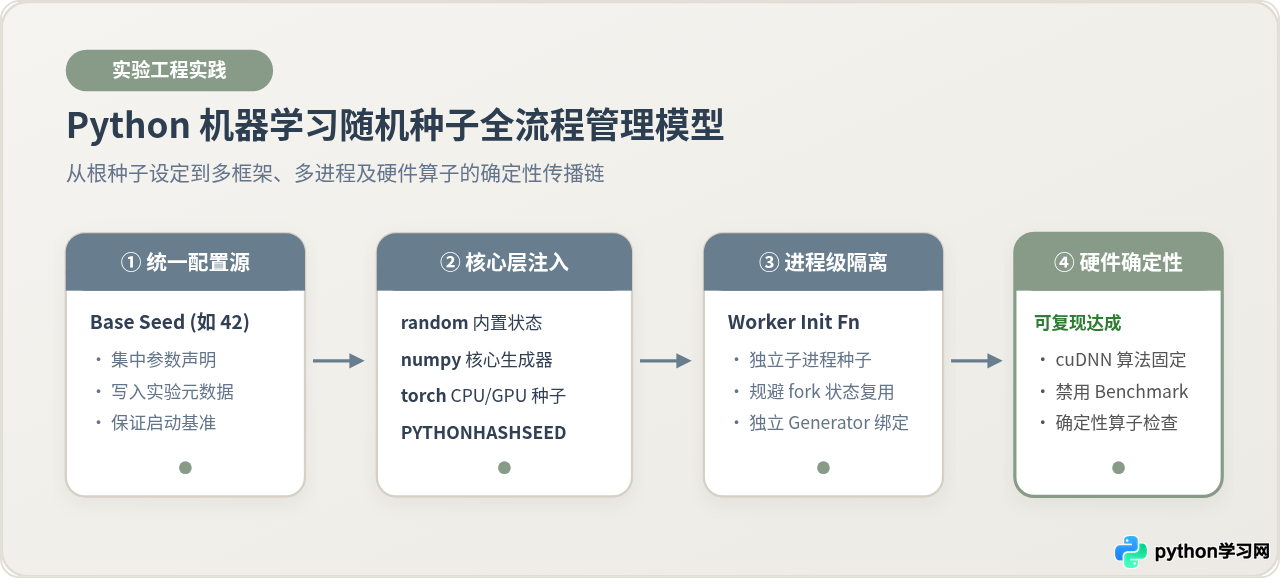
random.seed(42),但随后便会发现两次独立运行的模型权重、损失下降轨迹甚至最终评估指标依然存在显著漂移。这是因为机器学习流水线的随机性并非单一全局状态,而是分布在 Python 运行环境、科学计算库(NumPy)、深度学习框架(PyTorch/TensorFlow)、数据并行加载多进程(DataLoader Workers)以及底层硬件加速库(CUDA/cuDNN)等多个层次中。要实现真正的实验可复现性,必须在整个执行链路上建立统一的种子管理规范并显式锁定确定性计算。本文将逐层剖析这些随机源,提供标准化的工程实施方案,并深入对比全局种子与独立生成器的架构差异。
一、为什么一行 random.seed 无法复现结果:多层次随机源剖析
计算机中的伪随机数生成器(PRNG,Pseudo-Random Number Generator)本质上是一个确定的数学递推状态机。给定相同的初始状态(即随机种子),PRNG 将以确定的顺序生成后续的数值序列。然而,现代机器学习实验并不是单线程或单一库的封闭过程。当一次实验启动时,多个相互解耦的库和底层硬件并发推进各自的 PRNG 状态,只要其中任何一个环节未被纳管,整个实验就会失去确定性。
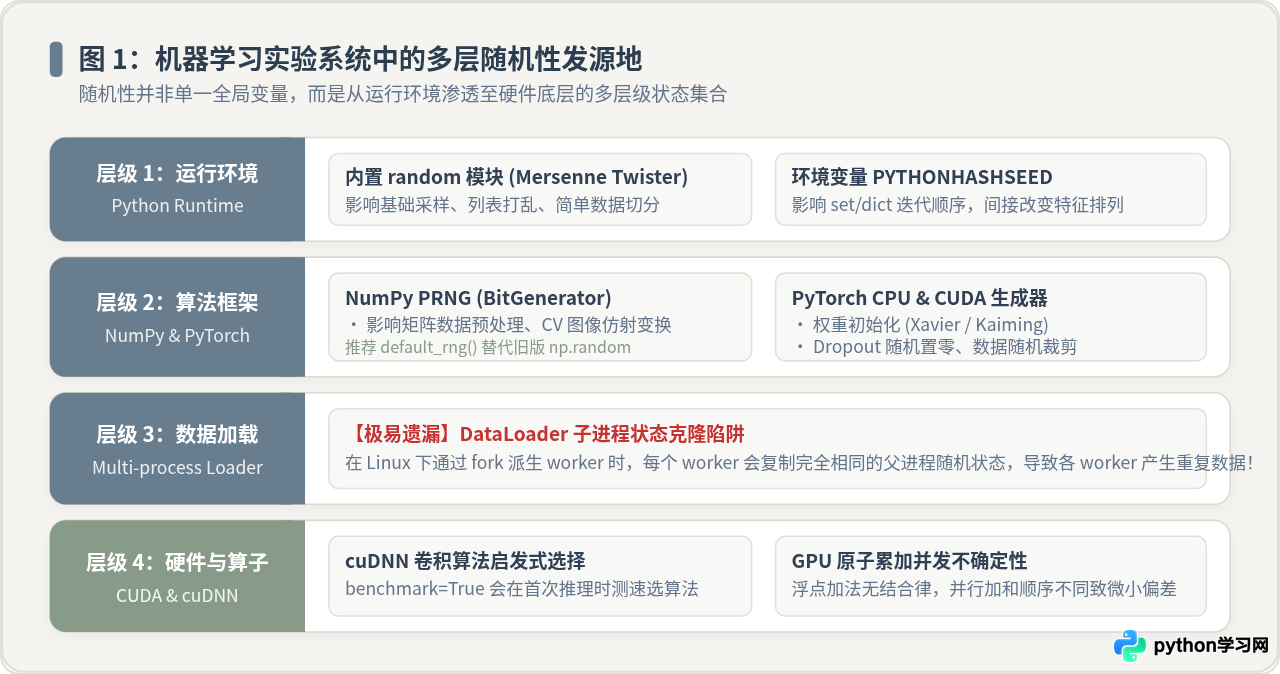
具体而言,一个完整的 Python 机器学习工作流包含以下 5 个维度的随机性来源:
- 1. Python 标准库与环境哈希:标准库的
random模块基于 Mersenne Twister 算法,管理基础的抽样与切分;而环境变量PYTHONHASHSEED则控制字符串与对象的哈希加盐。如果该变量未固定,字典(dict)与集合(set)的底层桶哈希序列在每次进程启动时均不同,导致按键遍历时特征或样本顺序发生改变。 - 2. 核心科学计算库(NumPy):NumPy 拥有独立的伪随机数引擎(历史上为 MT19937,现代版本为 PCG64)。它控制着大部分特征工程、随机数据扰动、矩阵混洗(shuffle)和交叉验证划分。
- 3. 深度学习框架(如 PyTorch / TensorFlow):框架内部维护着 CPU 与 GPU 的多套独立生成器。模型权重初始化(如 Kaiming 正态分布、Xavier 均匀分布)、Dropout 神经元丢弃掩码、随机张量生成均直接受其支配。对于多 GPU 场景,每个 GPU 设备还持有各自的 CUDA 生成器。
- 4. 数据加载多进程派生(DataLoader Workers):PyTorch 的
DataLoader在设置num_workers > 0时,会通过操作系统的fork或spawn机制派生子进程。在默认情况下,子进程会全盘复制父进程在 fork 时刻的 NumPy 随机状态,导致所有 worker 产生完全相同的数据增强变换,造成严重数据倾斜且难以复现。 - 5. GPU 底层加速库与并行规约(cuDNN / CUDA):cuDNN 库在执行卷积等密集算子时,为了极致吞吐,默认会采用启发式基准测试(Benchmark)在多个候选实现中动态竞速,不同实现甚至同一个实现中的浮点原子累加(atomicAdd)因为多线程竞争先后的微小变化,都会破坏浮点数计算结果的一致性。
二、标准实施方案:构建生产级 seed_everything 函数
为了在实验启动阶段将所有已知的确定性控制项一次性锁死,业界通常将这些操作封装为一个全局初始化函数 seed_everything。该函数必须在所有数据预处理、模型定义或张量操作之前被调用。
以下是支持 PyTorch、NumPy、Python 原生环境以及 CUDA/cuDNN 的完整实施函数:
import os
import random
import numpy as np
import torch

def seed_everything(seed: int = 42, deterministic: bool = True):
    # 1. 固化 Python 内置环境与哈希加盐
    os.environ['PYTHONHASHSEED'] = str(seed)
    random.seed(seed)

    # 2. 固化 NumPy 随机数生成器
    np.random.seed(seed)

    # 3. 固化 PyTorch CPU 与所有 CUDA GPU 设备种子
    torch.manual_seed(seed)
    if torch.cuda.is_available():
        torch.cuda.manual_seed(seed)
        torch.cuda.manual_seed_all(seed)  # 针对多卡数据并行

    # 4. 固化 cuDNN 后端算法与确定性规则
    if deterministic:
        # 禁用动态算法基准调优,确保同一卷积算子每次选择固定算法
        torch.backends.cudnn.benchmark = False
        # 强制 cuDNN 使用确定性卷积实现
        torch.backends.cudnn.deterministic = True

        # PyTorch 1.8+ 推荐:开启全算子确定性检查
        # 如遇无确定性实现的算子将直接抛出 RuntimeError,杜绝静默随机
        try:
            torch.use_deterministic_algorithms(True)
            # CUDA 10.2+ 必须配置环境变量以确保 cuBLAS 确定性
            os.environ['CUBLAS_WORKSPACE_CONFIG'] = ':4096:8'
        except AttributeError:
            pass
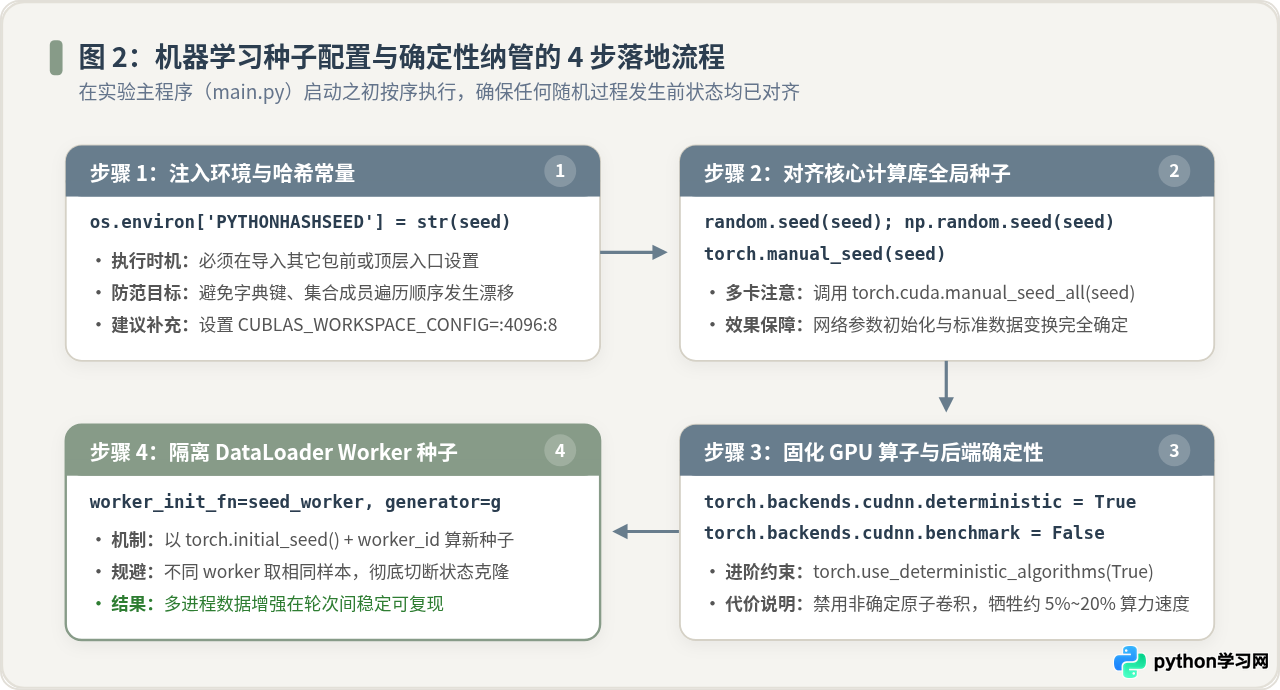
os.environ['PYTHONHASHSEED'] = str(seed) 必须在 Python 解释器启动的极早期执行。如果在脚本中执行该赋值语句时,解释器内部的某些哈希表已经完成构建,其效果可能无法回溯到全局。更彻底的工程做法是在启动脚本的 Bash 命令行中预先导出该变量:
export PYTHONHASHSEED=42 && python train.py。
三、极易忽视的死角:DataLoader 多进程中的种子克隆
即便调用了上述 seed_everything,如果在构造 DataLoader 时指定了 num_workers > 0,依然会出现严重的随机性泄漏。这是因为操作系统采用 fork 创建子进程时,各个 worker 进程完好无损地继承了父进程当前的 NumPy PRNG 内部状态。
如果数据集中包含了基于 NumPy 或 OpenCV 的随机几何变换(例如随机水平翻转、随机旋转),由于所有 worker 进程持有的随机生成器处于同一状态,worker 0、worker 1、worker 2 在加载不同图像时,会生成完全相同的随机旋转角度与增强参数。更严重的是,当进入下一个 Epoch 时,子进程被重新创建或重置,再次从相同状态开始递增,导致各 Epoch 间的数据增强完全重复。
解决该问题的工业标准做法由两部分组成:
- 使用
worker_init_fn在每个子进程启动时,利用torch.initial_seed()与该进程独有的worker_id派生独立的子种子。 - 为
DataLoader显式绑定一个主进程专用的torch.Generator,锁定批次采样的洗牌顺序。
import torch
from torch.utils.data import DataLoader

def seed_worker(worker_id: int):
    # 基于 PyTorch 分配给当前 worker 的基准种子计算独立种子
    worker_seed = torch.initial_seed() % 2**32
    np.random.seed(worker_seed)
    random.seed(worker_seed)

# 创建与主线程绑定的确定性生成器
g = torch.Generator()
g.manual_seed(42)

train_loader = DataLoader(
    dataset=train_dataset,
    batch_size=64,
    shuffle=True,
    num_workers=4,
    worker_init_fn=seed_worker,  # 消除子进程 PRNG 状态克隆
    generator=g                 # 锁定 DataLoader 内部 shuffle 序列
)
通过这种配置,4 个 worker 进程在启动时分别获取彼此完全不同、但在两次实验运行中完全一致的种子序列,从根本上保证了多进程数据流水线的独立性与确定性。
四、关键机制对比:全局隐式种子 vs 独立生成器显式状态隔离
在实际代码工程中,存在两种不同的随机数管理范式。很多实验之所以难以复现,其根源并非忘记调用 seed(),而是采用了全局隐式共享的状态管理机制。为了说明为什么差异至关重要,我们在相同的实验模块下对两种机制展开对比:
| 对比维度 | 模式 A:全局隐式种子(Legacy Global State) | 模式 B:独立生成器隔离(Isolated Generator / SeedSequence) |
|---|---|---|
| 代码调用形态 | np.random.seed(42)torch.manual_seed(42) |
rng = np.random.default_rng(SeedSequence(42))g = torch.Generator(device='cuda').manual_seed(42) |
| 状态作用范围 | 全局命名空间共享单个 PRNG 递推状态 | 状态封装在对象实例内部,局部生命周期 |
| 抗污染能力 | 极低。下游任何模块或调试打印只要调用一次 np.random.choice,后续所有采样序列全线错位。 |
极高。模型初始化、数据增强、验证抽样各持独立对象,互不干扰,完全免疫外部调用污染。 |
| 多线程/并发安全 | 非线程安全。多线程抢占执行时产生竞态条件(Race Condition),无法复现。 | 天然线程隔离。可安全地派生无碰撞的独立子种子序列(Spawn Streams)。 |
| 局部实验对照能力 | 调整数据增强参数可能意外改变初始权重的抽样序列,导致控制变量实验失效。 | 数据模块改动完全不影响模型权重的初始化序列,保证严格的因果归因。 |
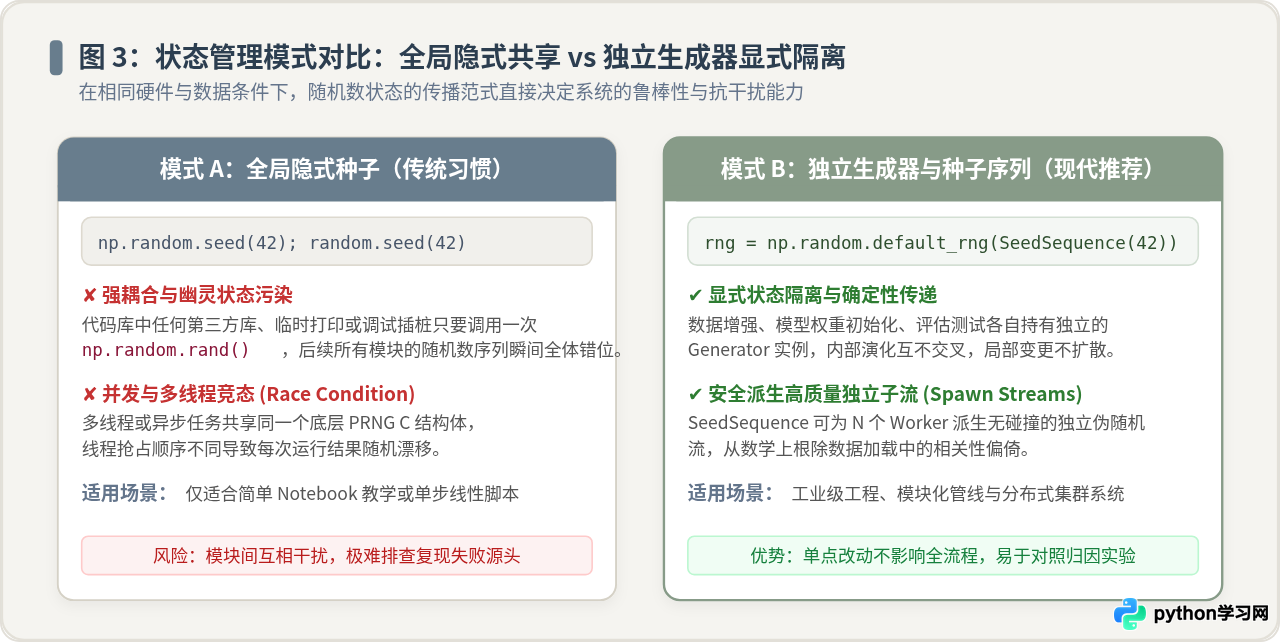
在现代数据科学库的设计演进中(如 NumPy 1.17+ 引入的 default_rng),核心思想正是全面摒弃隐式全局状态,转为依赖显式传递的 Generator 实例。在大型模块化实验框架中,强烈建议将 Generator 作为显式依赖注入到数据加载器、模型初始化器以及评价采样模块中。
五、分布式多卡训练(DDP)中的种子分配规则
当实验从单机单卡扩展到分布式数据并行(Distributed Data Parallel, DDP)场景时,如果对每张卡直接传入相同的基准种子,会导致所有 GPU rank 在每一个训练步中抽取出完全相同的样本批次,或者在图像增强中生成完全相同的噪声与几何扭曲。这不仅浪费了并行算力,还会导致梯度估计产生巨大偏倚。
正确的分布式种子管理原则是:基础种子保证实验宏观对齐,局部种子引入 Rank 偏移量。具体落地规则如下:
import os
import torch
import torch.distributed as dist
from torch.utils.data.distributed import DistributedSampler

def setup_ddp_seed(base_seed: int = 42):
    rank = dist.get_rank()
    # 为不同进程分配确定的非重叠种子
    rank_seed = base_seed + rank

    seed_everything(seed=rank_seed, deterministic=True)
    return rank_seed

# 在使用 DistributedSampler 时,必须在每个 Epoch 开始前同步轮次
sampler = DistributedSampler(train_dataset, seed=42, shuffle=True)
for epoch in range(total_epochs):
    # 关键步骤:通知采样器当前轮次,确保不同轮次数据洗牌不同,但两次实验完全复现
    sampler.set_epoch(epoch)
    for batch in train_loader:
        train_step(batch)
DistributedSampler.set_epoch(epoch) 内部会将 seed + epoch 作为当轮洗牌的 PRNG 状态输入。若遗漏该调用,整个训练过程中每个 Epoch 喂入模型的数据顺序将毫无变化,严重损害模型的泛化收敛。
六、可复现性的物理边界与端到端排查闭环
在工程实践中,必须对“可复现性”保持理性的认知边界:软件代码层面的完全确定性,并不等同于跨任何硬件与驱动版本的绝对比特级一致。
以下客观限制需要纳入实验预期与环境固化清单中:
- 跨 GPU 架构的差异:例如在 NVIDIA Ampere 架构(如 A100)与 Ada Lovelace 架构(如 RTX 4090)之间,浮点张量核心(Tensor Core)的指令调度、FMAD 与 TF32 截断规则存在微小硬件差异。即便是相同代码与完全相同的种子,其输出张量也可能在第 6 位小数后产生微幅漂移。
- 无确定性实现的特定算子:如
torch.Tensor.scatter_add_、index_add_或某些 CTC Loss 实现,在 GPU 上因采用非阻塞的原子加操作,浮点数加法并不满足结合律(即(a + b) + c != a + (b + c)),执行顺序的微秒级差异会导致数值漂移。开启torch.use_deterministic_algorithms(True)会在触发此类算子时主动抛错,提醒工程师采用替代实现。 - 性能折损与权衡:开启
cudnn.benchmark = False与cudnn.deterministic = True,通常会带来 5% 到 20% 的训练吞吐下降。在探索性训练阶段可适当放宽 cuDNN 确定性,但在最终基准对比、打榜或复现关键消融实验时,务必强制开启。
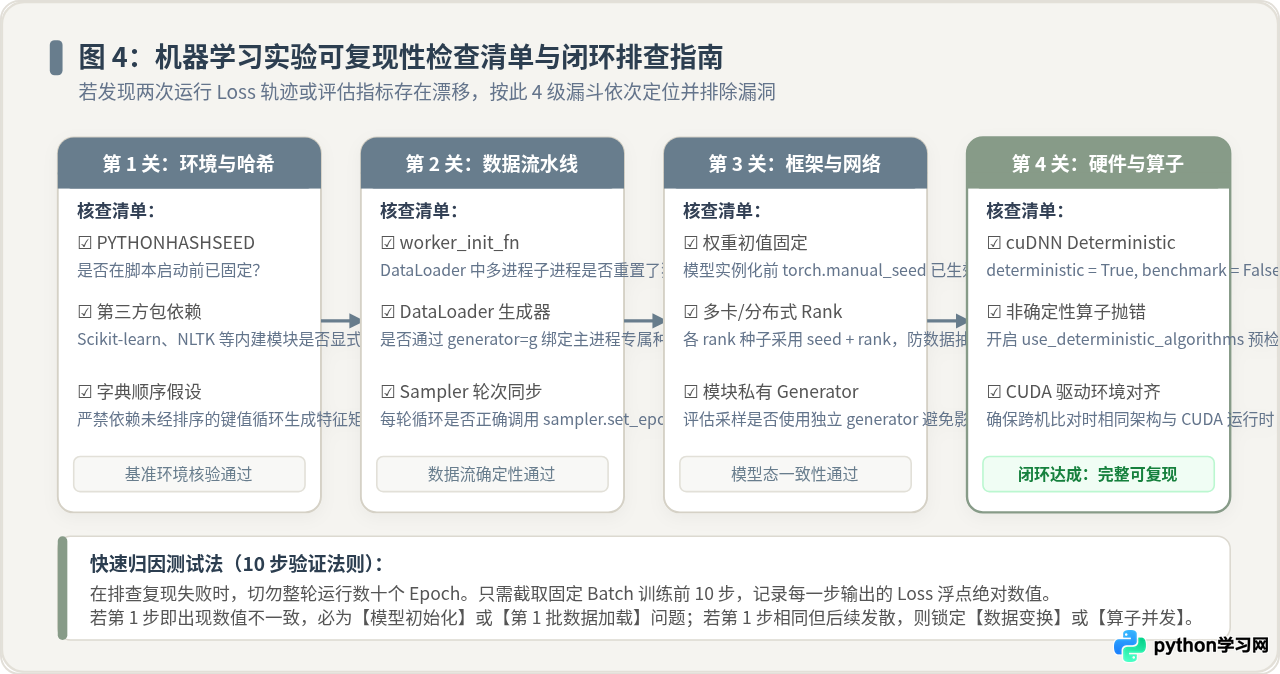
实验交付前可复现性核查表(Checklist)
- [ ] 入口环境:启动脚本前已设置
export PYTHONHASHSEED=42与CUBLAS_WORKSPACE_CONFIG=:4096:8。 - [ ] 框架状态:已集中执行
seed_everything,覆盖random、numpy、torch、torch.cuda。 - [ ] 后端引擎:已将
torch.backends.cudnn.benchmark置为False,cudnn.deterministic置为True。 - [ ] 多进程数据流:
DataLoader中已配置worker_init_fn=seed_worker,并传入独立的generator。 - [ ] 分布式同步:训练循环中已按轮次显式调用
sampler.set_epoch(epoch),各 Rank 种子具备唯一性偏移。 - [ ] 环境冻结:通过 Conda 导出了包含准确 CUDA runtime 与驱动版本的
environment.yml锁定文件。
遵循以上四级控制漏斗与标准化操作流程,即可彻底消除 Python 机器学习实验中由隐式状态、多进程派生和硬件调度带来的伪随机波动,为科学严谨的算法探索提供坚不可摧的复现基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









