

Python内置函数与标准库模块有什么区别

在编写Python代码时,像 len()、print()、range() 这类函数无需任何前置声明即可直接调用;而处理数学计算、操作系统路径或JSON数据时,必须先写下 import math、import os 或 import json。表面上看,这仅仅是“要不要写 import”的语法习惯差异,但背后实际上体现了Python在命名空间设计、内存加载策略、执行效率以及工程架构上的多层考量。
核心答案:加载机制与命名空间隔离
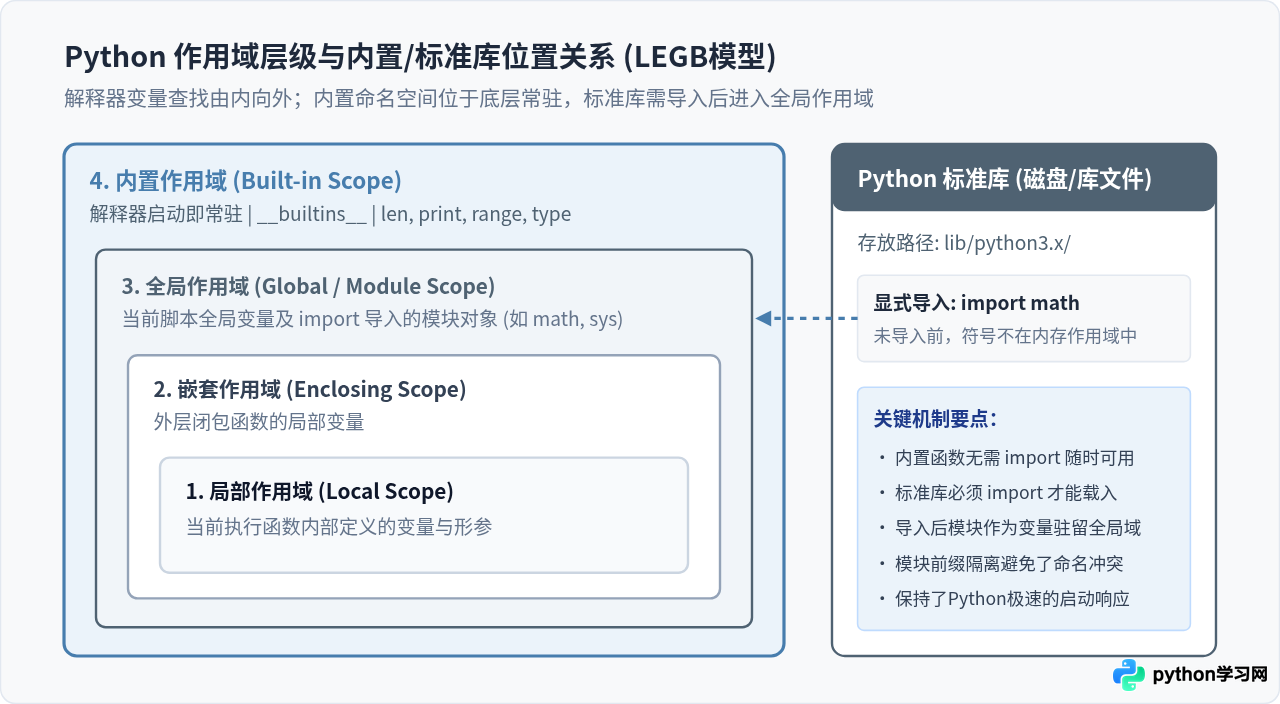
一句话总结两者的本质区别:内置函数(Built-in Functions)是Python语言运行环境的基础底座,解释器启动时便自动常驻在内置命名空间中;而标准库模块(Standard Library Modules)是随官方发行版打包分发的专业工具集,遵循按需加载原则,必须显式导入才能进入当前作用域。
具体来看,这一核心差异体现在以下几个关键维度:
- 使用成本:内置函数零语法成本,直接全局可用;标准库模块必须通过
import或from ... import ...引入。 - 命名空间归属:内置函数位于LEGB作用域最底层的
__builtins__中;标准库模块以独立模块对象(Module Object)形式存在,模块内的函数封装在自身属性中,有效避免命名污染。 - 内存与启动开销:内置函数随进程初始化瞬时就绪,数量精简(约70余个);标准库包含数百个模块、数千个函数与类,按需导入能保证Python解释器极快的冷启动速度与轻量的内存占用。
深入底层:调用执行与解析流程的差异
为了理解为什么执行 len(items) 比执行 math.sqrt(x) 少一步导入,我们需要观察解释器在执行这两种调用时的底层处理链条。
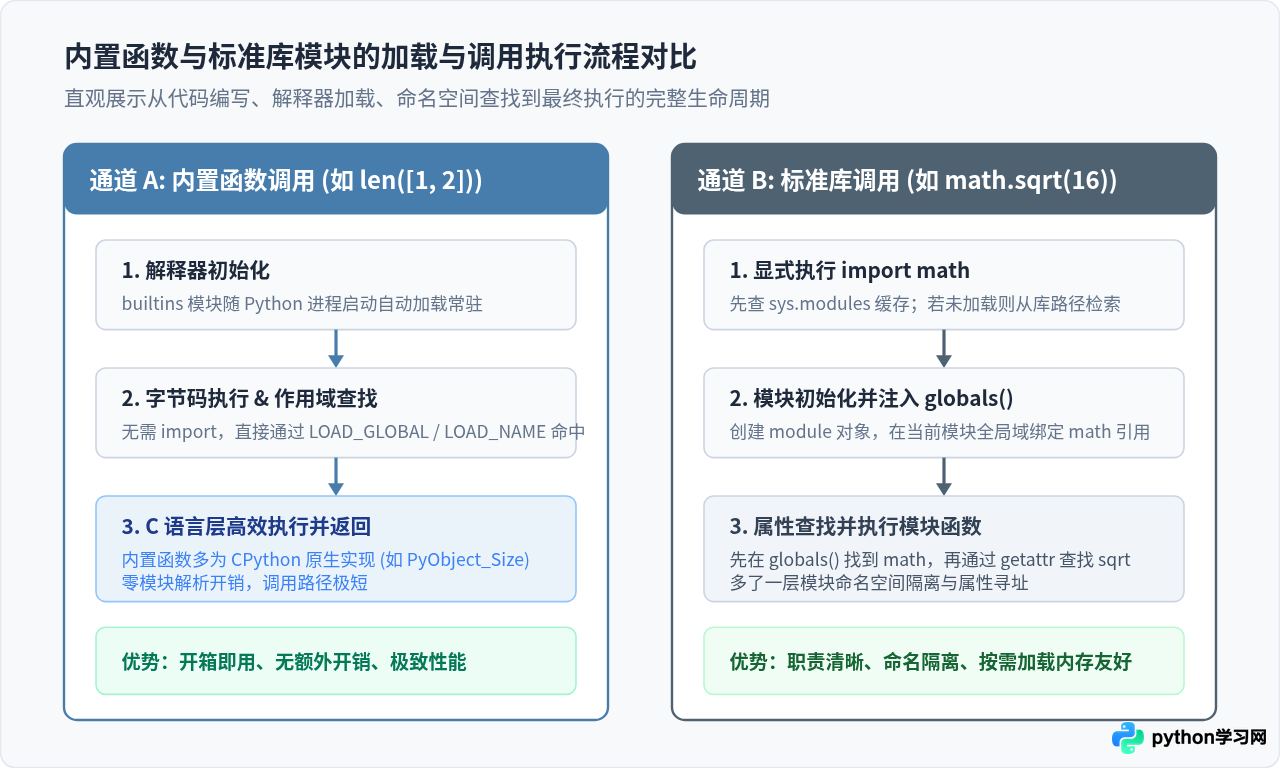
1. 内置函数的执行路径
在CPython底层实现中,内置函数绝大多数直接用C语言编写,并被注册到 builtins 字典中。当代码中调用 len([1, 2, 3]) 时:
- 解释器生成
LOAD_GLOBAL或LOAD_NAME字节码指令; - 先在当前模块的
globals()字典查找是否存在名为len的自定义变量; - 若未找到,直接顺着作用域链回退到
builtins字典并命中原生len; - 直接调用底层 C 函数
builtin_len,耗时仅几纳秒至几十纳秒级别。
2. 标准库模块的执行路径
调用标准库函数则经历了一个从磁盘加载到对象属性寻址的完整过程:
- 执行
import math时,Python首先检查sys.modules缓存,确认该模块是否此前已被加载; - 若未缓存,模块导入器(Importer)会在标准库安装目录中查找对应的
math.py或平台编译的动态扩展库(如math.cpython-*.so); - 完成编译与初始化后,在当前模块的
globals()字典中创建一个名为math的模块对象引用; - 执行
math.sqrt(16)时,先在全局变量中取出math,再通过getattr获取sqrt函数指针,最终执行运算。
设计哲学:为什么不把所有标准库都设为内置?
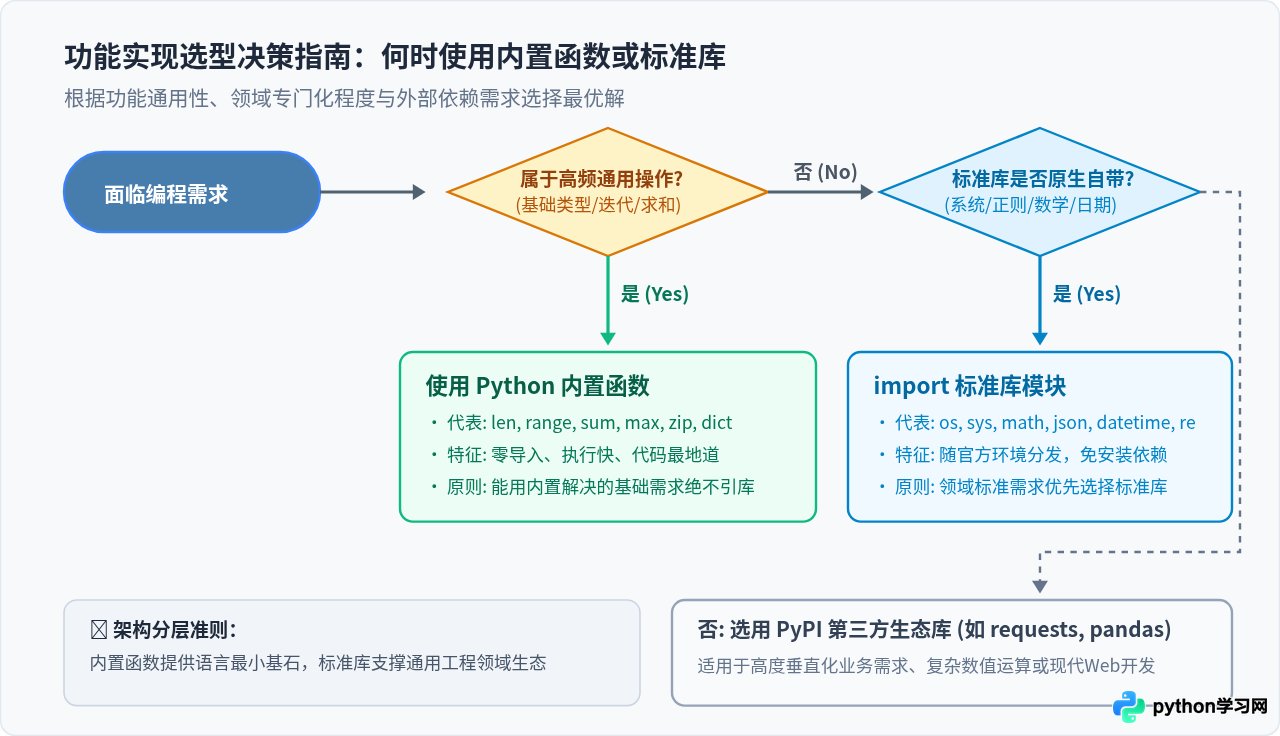
初学者常常会产生一个疑问:既然内置函数用起来最方便,为什么Python官方不把 math.sin()、os.listdir()、json.dumps() 都做成内置函数?
这涉及到软件设计中的三大核心权衡:
1. 命名空间污染(Namespace Pollution)
如果将所有常用工具直接放入内置空间,Python全局作用域将被数千个保留名称挤满。开发者声明任何一个常见变量(如 sin、path、file、dump、time)都会不可避免地与内置名称产生冲突或造成阴影遮蔽(Shadowing)。通过模块前缀(例如 os.path、math.sin)进行分组,构筑了清晰的领域上下文,极大增强了大型项目的可维护性。
2. 解释器启动时间与内存脚印
Python被广泛用于命令行小工具、脚本自动化以及微服务环境。如果解释器在每次冷启动时都加载网络协议库(http、urllib)、加密套件(ssl、hashlib)以及复杂的编解码器,启动耗时和常驻内存将成倍攀升。按需导入保证了一个空Python解释器的启动只需几毫秒。
3. 职责边界与正交性
内置函数的目标是提供语言运行的最小完备操作集合,例如类型转换(int, str)、对象协议查询(len, iter, repr)、集合聚合(sum, max, all)。而专业领域的算法、系统抽象、通信协议则交由专门的模块自治。
常见易混淆函数与对应标准库对比
在实际开发中,有些内置函数与标准库模块功能名称相近,容易让初学者产生疑惑。理解它们的边界有助于写出更规范、健壮的代码。
| 功能场景 | 内置函数做法 | 标准库对应模块与做法 | 适用场景与核心区别 |
|---|---|---|---|
| 求绝对值 | abs(x) |
math.fabs(x) |
abs() 支持整型、浮点及复数;math.fabs() 始终返回浮点数,且不支持复数。 |
| 序列求和 | sum(iterable) |
math.fsum(iterable) |
日常计算优先用 sum();若涉及大量高精度浮点累加,math.fsum() 使用追踪算法避免精度漂移。 |
| 打开与读写文件 | open(filepath, 'r') |
os.open() / pathlib.Path |
open() 返回高层文件对象;os.open() 返回底层整型文件描述符(fd),多用于操作系统级控制。 |
| 退出当前程序 | exit() / quit() |
sys.exit() |
exit() 属于专为交互式REPL设计的解释器助手;生产脚本与工程项目中必须使用 sys.exit()。 |
| 结构打印 | print(data) |
pprint.pprint(data) |
print() 简单直接输出;pprint 模块提供层级缩进与格式化,适合排查复杂嵌套字典。 |
如何查看内置函数与标准库清单
无需记忆全部清单,Python提供了直接在交互式命令行中探查两者的内置接口:
查看所有内置函数与内置异常
# 打印当前Python版本下所有内置标识符
import builtins
print(dir(builtins))

# 过滤出所有纯函数(排除大写开头的异常类和特殊双下划线属性)
builtin_funcs = [name for name in dir(builtins) if name.islower() and not name.startswith("_")]
print(f"内置函数数量: {len(builtin_funcs)}")
print(builtin_funcs[:15])  # 打印前15个
查看系统自带的标准库模块列表
在 Python 3.10 及以上版本中,标准库内置了 sys.stdlib_list 接口,可以直接枚举当前安装的全部官方标准模块:
import sys

# 获取官方标准库模块名称集合
std_modules = sys.stdlib_list()
print(f"标准库模块总数: {len(std_modules)}")

# 快速判断某个模块是否属于标准库
print("math 属于标准库:", "math" in std_modules)
print("requests 属于标准库:", "requests" in std_modules)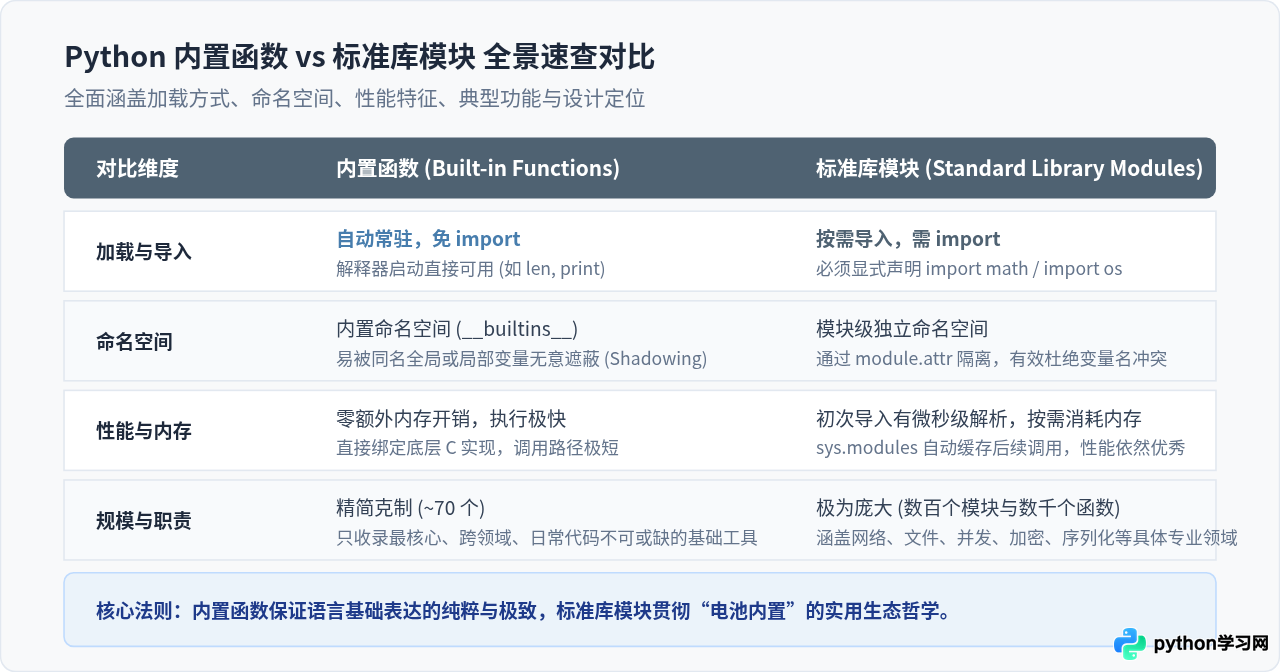
日常开发中的避坑与最佳实践
在理解了两者的机制后,以下三条工程实践能帮助写出更稳健的Python代码:
1. 严禁自定义变量覆盖内置函数名
避免使用 list = [1, 2]、dict = {"a": 1}、max = 100 或 id = "user_1" 等作为变量名。这样做会导致在当前作用域内同名的内置函数失效,后续若调用 list() 或 max() 会直接触发 TypeError。
2. 慎用通配符导入 from module import *
使用 import math 或 from math import sqrt,而不要使用 from math import *。通配符导入会将模块内的所有公开符号一次性倾倒到当前全局作用域,既破坏了命名空间隔离,又可能意外覆盖现有的内置函数或全局变量。
3. 优先榨干标准库,再引入第三方包
Python官方素有“电池内置”(Batteries Included)的美誉。面对常规任务(如日期处理用 datetime、文件系统遍历用 pathlib、数据缓存用 functools.lru_cache、轻量测试用 unittest),优先评估标准库能否满足需求,可以显著降低项目的依赖复杂度和运维成本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









