

单片机运行Python卡慢怎么办?MicroPython内存优化与执行效率提升
针对单片机运行MicroPython出现的卡顿、掉帧与内存耗尽问题,系统梳理内存碎片治理、垃圾回收调优、预分配缓冲区以及Native与Viper机器码加速等核心优化手段。
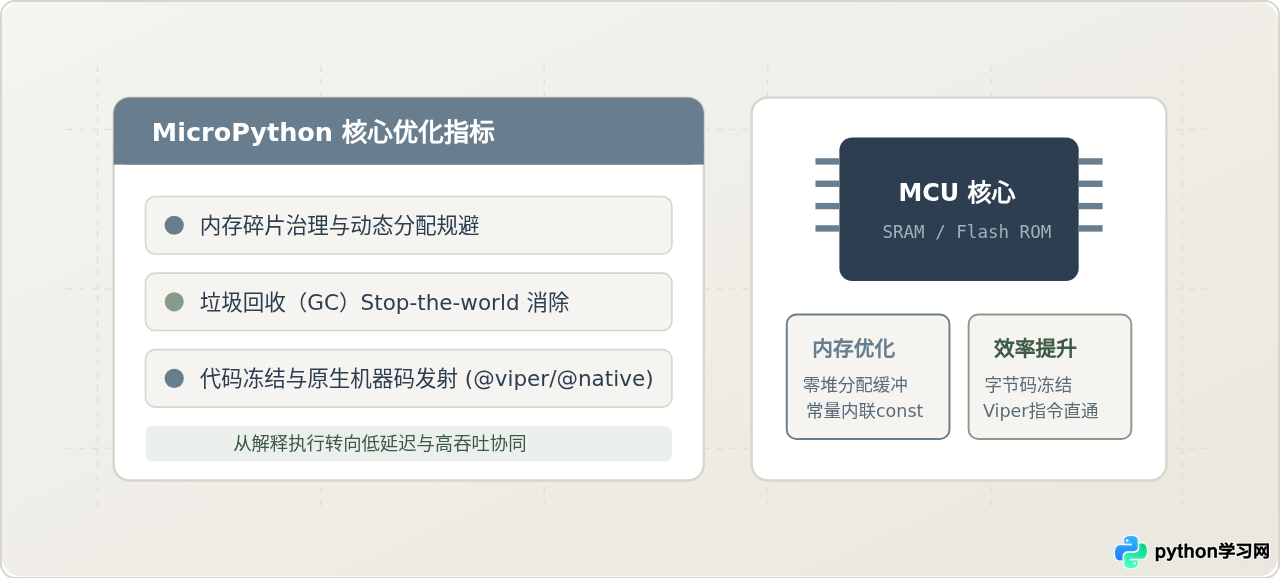
单片机运行 MicroPython 出现周期性卡顿、偶发死机或循环执行缓慢,最根本的原因并非微控制器芯片的主频不足,而主要受制于两项底层机制:一是微控制器极有限的 SRAM 空间中由小对象频繁分配带来的内存碎片与垃圾回收(GC)暂停;二是 Python 虚拟机在 RAM 中解析字节码、动态查找对象字典所带来的解释开销。解决这一问题的路径非常明确:一是通过连续缓冲区就地复用与常量内联,切断运行时的动态堆分配,消除 GC 的停顿干扰;二是利用模块预编译/冻结固件与原生机器码发射器,越过虚拟机调度瓶颈,发挥单片机的真实计算潜能。
一、定位瓶颈:是算力不足还是内存抖动?
在着手修改代码前,必须准确区分系统当前遇到的瓶颈类型。很多开发者误以为是主循环逻辑复杂导致跑不快,盲目超频 CPU,结果依然卡顿,原因在于没有找准真正的瓶颈来源。
在 MicroPython 环境中,程序卡慢通常表现为两种完全不同的形态:
- 突发周期性卡顿(GC 停顿):程序平时运行速度尚可,但每隔几秒或几十秒就会出现一次数十至数百毫秒的无响应,网络包丢包或传感器采样丢失。这种现象 90% 以上由自动垃圾回收触发时的全局扫描(Stop-The-World)引起。
- 持续性吞吐量低下(解释器开销):波形发生、软件模拟通信协议(如软 SPI、单总线)或数学滤波算法等计算任务耗时过长,无法在预定周期内完成。这是由于解释器逐条读取字节码并动态分派引起的固有开销。
为了精确定位,MicroPython 提供了内置诊断接口:
import gc
import micropython

# 1. 测量可用内存与已分配内存(字节数)
gc.collect()
free_start = gc.mem_free()
alloc_start = gc.mem_alloc()
print("基线可用 RAM:", free_start, "字节; 已分配:", alloc_start, "字节")

# 2. 观察目标代码片段在运行过程中的内存吞吐
# 如果每次循环 free 内存都在持续递减,说明存在隐式堆内存分配
for _ in range(10):
    # 放置待测试的关键逻辑
    pass

print("循环后可用 RAM:", gc.mem_free())

# 3. 打印堆内存分配图(输出内存块使用分布与碎片情况)
micropython.mem_info(1)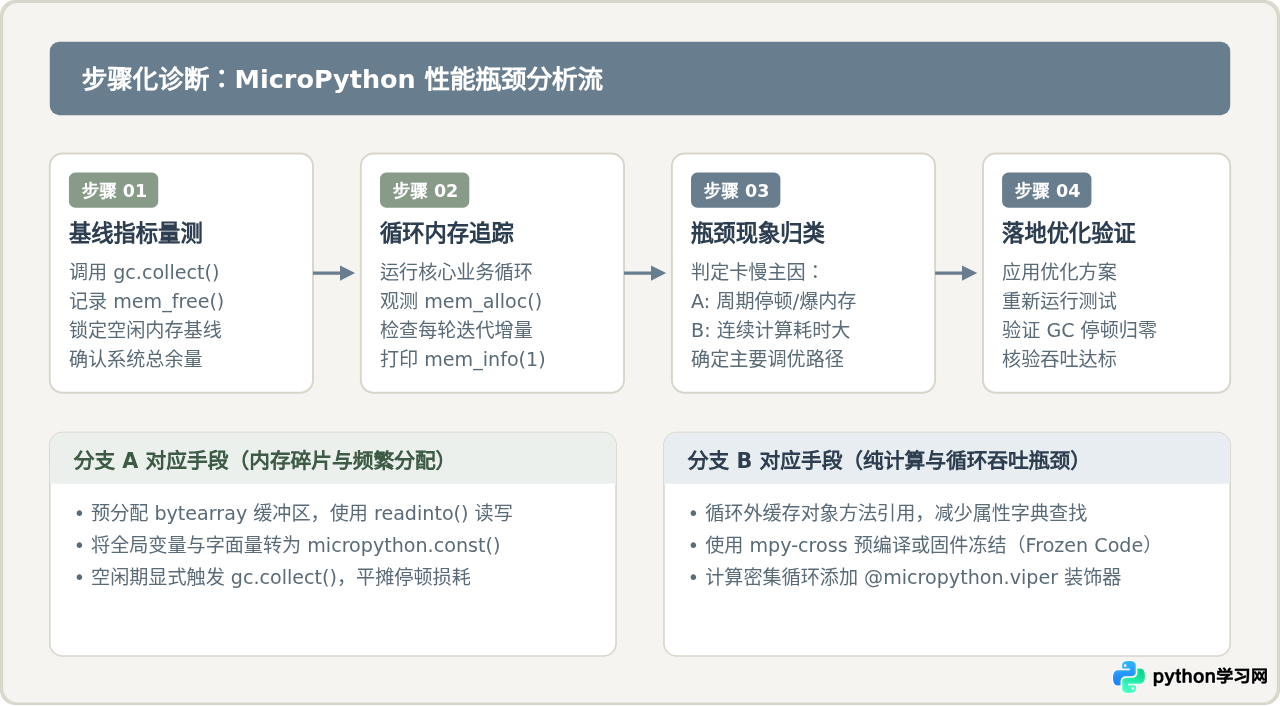
二、内存优化:切断运行时的动态堆分配
单片机的 SRAM 通常极其有限(例如 ESP8266 仅有约 40KB 可用堆,ESP32 虽大但也需为 WiFi/BLE 协议栈预留)。当程序持续申请微小的临时对象时,会迅速在内存池中制造大量孔洞(碎片)。即便总可用内存还显示有数万字节,当需要分配一个较大的连续块(如 1KB 网络包缓冲区)时,系统依然会抛出 MemoryError。
1. 动态拼接 vs 预分配连续缓冲区(关键差异剖析)
在传感器数据采集、串口解析与网络通信中,最常见的陷阱是在循环体内不断使用加号拼接字节串或列表。为了清楚说明这一操作的严重后果,我们对比两种在完全相同业务场景下的处理方式:
| 对比维度 | 做法 A:动态临时拼接(反模式) | 做法 B:预分配连续缓冲区复用(推荐) |
|---|---|---|
| 实现代码特征 | raw += uart.read(1) 或 buf = buf + chunk |
buf = bytearray(64) 并在循环中 uart.readinto(buf) |
| 堆内存行为 | 每次连接操作都会在堆上新开辟内存,并弃置旧字符串 | 启动时一次性占用 64 字节,整个生命周期中零新增分配 |
| 内存碎片影响 | 不断制造 10~50 字节孤立内存碎片,快速填满堆空间 | 完全不产生新的内存空洞,堆状态保持平稳 |
| GC 触发频率 | 极高,频繁进入全局扫描,引发数十毫秒周期停顿 | 几乎不触发与该流程相关的 GC,避免实时任务抖动 |
| 长期运行稳定性 | 易偶发 MemoryError: memory allocation failed |
系统可连续平稳运行数月无内存泄漏表现 |
为什么做法 B 的差异如此重要?在标准 Python 中,由操作系统提供虚拟内存支持,短暂的对象频繁创建会被成熟的内存池掩盖;但在单片机裸机或 RTOS 上,MicroPython 使用标记-清除(Mark-Sweep)垃圾回收器,没有内存重排(Compaction)机制。一旦碎片产生,碎片之间的空隙就无法合并。因此,在循环体内杜绝任何临时对象的隐式创建是确保实时性与稳定性的基石。
# 做法 A(不推荐):高频循环产生海量垃圾与碎片
def bad_read_loop(uart):
    data = b""
    while uart.any():
        data += uart.read(1)  # 每次拼接均在堆中创建全新 bytes 对象
    return data

# 做法 B(推荐):预先分配固定 bytearray,通过切片或 readinto 复用
RECV_BUF = bytearray(128)

def good_read_loop(uart):
    # 直接原地填入预先分配好的内存,无任何堆分配
    num_bytes = uart.readinto(RECV_BUF)
    if num_bytes > 0:
        # 使用 memoryview 避免切片拷贝
        view = memoryview(RECV_BUF)[:num_bytes]
        process_payload(view)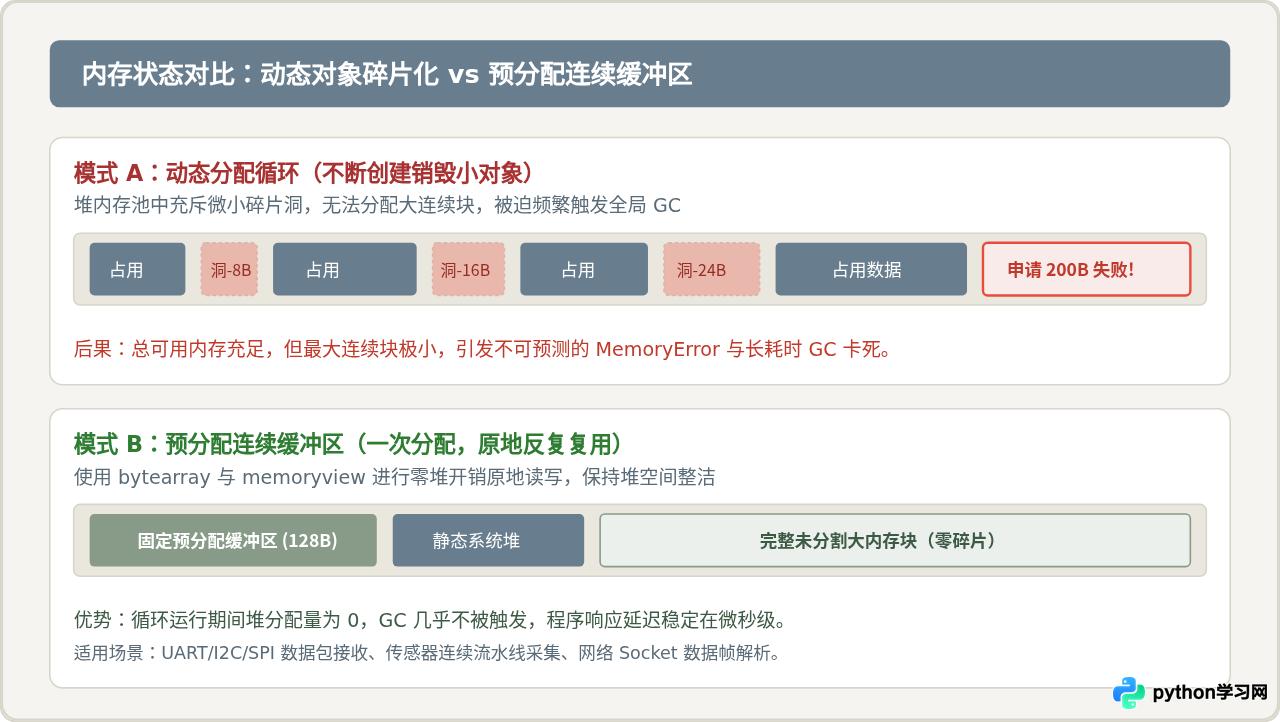
2. 使用 micropython.const() 折叠常量
在常规 Python 中,所有全局变量在被访问时都会在模块全局字典中执行一次名称查找(Hash 匹配),不仅消耗指令周期,还会占用内存存储键值对。MicroPython 引入了 micropython.const() 特性:
from micropython import const

# 声明为常量:编译器在将 .py 编译为字节码时,会将使用到的地方直接替换为数值字面量
_REG_DATA = const(0x3B)
_SCALE_FACTOR = const(100)

def read_sensor(i2c, addr):
    # 字节码中直接加载立即数 0x3B,不再产生全局字典查找开销,且该变量名不占用运行时 RAM
i2c.writeto(addr, bytes([_REG_DATA]))_NAME = const(1)),该标识符在编译后将直接从字典中被剔除,无法被外部模块导入,从而节省出最大的全局命名空间内存。3. 手动干预垃圾回收周期
默认情况下,MicroPython 仅在尝试分配内存却找不到合适空间时,才会挂起当前正在执行的代码进行 GC。为了避免这种停顿发生在关键任务中,推荐在逻辑间隙主动调用:
import gc

# 方案 1:在每一次完整事务(如发完一个 MQTT 报文、完成一次屏幕刷新)之后主动触发
gc.collect()

# 方案 2:配置自动回收阈值(仅部分固件版本支持特定调优)
# 每次只在空闲时间回收,可大幅削减单次扫描持续的时间
三、执行效率提升:从字节码解释到机器指令
解决内存抖动保证了系统“不卡死”,接下来是提升关键逻辑的“运行速度”。MicroPython 提供了多层渐进式加速途径,从优化查找开销直到直接生成底层机器码。
1. 局部变量缓存方法引用
在 Python 虚拟机中,obj.method() 需要在每轮迭代中先从对象属性表中查找 method,再执行绑定调用。对于数千次以上的高频循环,将方法先赋值给局部变量能带来 20%~30% 的稳定提速:
# 优化前:每次循环都要查找 pin 对象的 value 属性
def toggle_slow(pin, count):
    for _ in range(count):
        pin.value(1)
        pin.value(0)

# 优化后:利用局部变量缓存函数指针
def toggle_fast(pin, count):
    val = pin.value  # 缓存方法引用到局部符号表
    for _ in range(count):
        val(1)
        val(0)
2. 固件冻结模块(Frozen Bytecode / Frozen Modules)
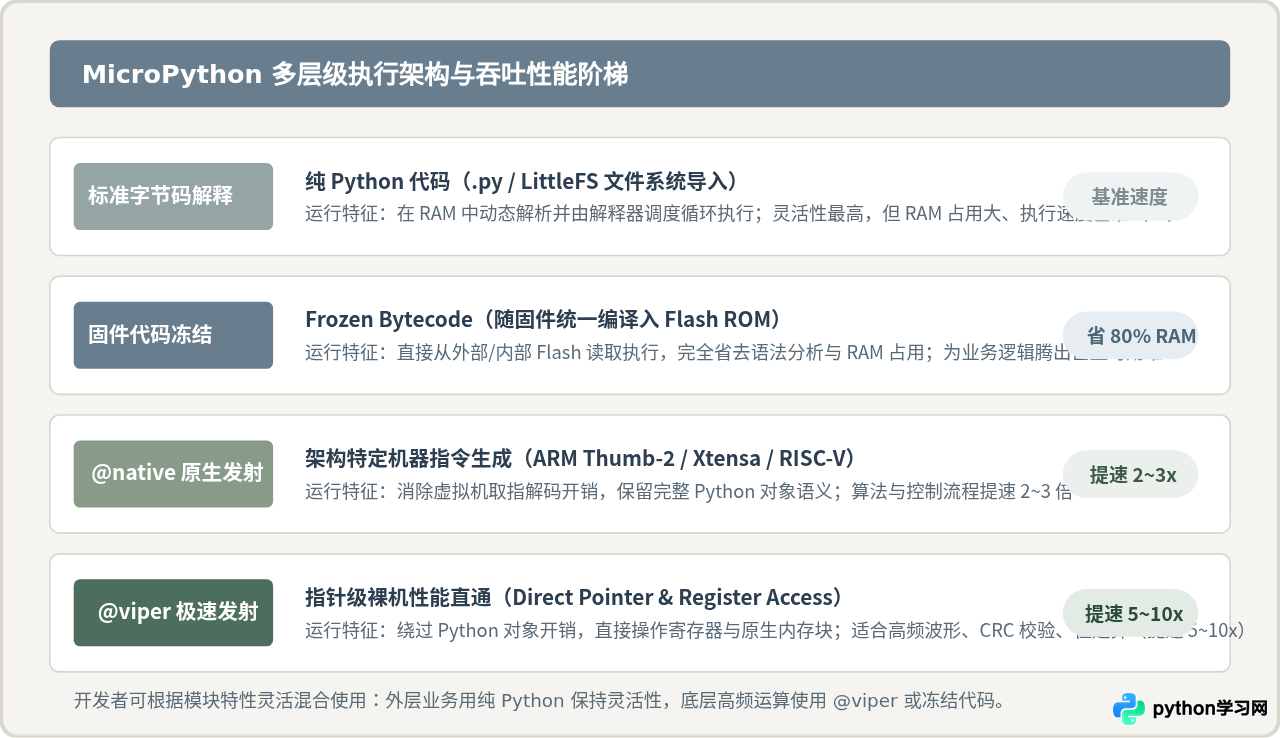
通常情况下,我们通过文件系统(LittleFS / FAT)将 main.py 或依赖库上传到 Flash 中。单片机开机导入模块时,必须把整份脚本读取到 RAM 中进行解析并生成字节码,极其浪费宝贵的内存。
- mpy-cross 预编译:使用官方工具
mpy-cross script.py将代码提前转为.mpy二进制字节码。设备导入时免去词法与语法分析,加载速度显著加快。 - 固件冻结(最高级优化):将 Python 脚本放置在 MicroPython 源码树的
ports/<chip>/modules/目录下,随固件一同编译。编译后的字节码将直接烧录进 Flash ROM 中。在单片机运行时,Python 虚拟机直接在 Flash 芯片上就地执行字节码,完全不占用任何 SRAM 空间,为大型项目腾出 50% 以上的宝贵内存。
3. 原生代码发射器:@micropython.native 与 @micropython.viper
对于算法滤波、CRC 校验、图形渲染等纯计算场景,可以使用装饰器让 MicroPython 的内置编译器直接生成对应 MCU 架构(ARM Cortex-M、Xtensa 或 RISC-V)的原生汇编指令:
# 1. @micropython.native:标准原生发射器
# 几乎兼容所有标准 Python 语法,将函数编译为机器码,提速约 2~3 倍
@micropython.native
def calc_checksum_native(data: bytes) -> int:
    crc = 0
    for b in data:
        crc = (crc + b) & 0xFFFF
    return crc

# 2. @micropython.viper:极速 Viper 发射器
# 绕过 Python 对象模型,支持类型标注与直接裸内存指针访问,提速可达 5~10 倍(接近纯 C 语言)
@micropython.viper
def fast_filter_viper(buf: ptr8, length: int) -> int:
    acc = 0
    for i in range(length):
        val = int(buf[i])
        acc += val
return acc // length@micropython.viper 时,参数与返回值建议显式声明类型(int, ptr8, ptr16, ptr32 等)。函数体内不支持复杂的动态 Python 特性(如动态创建字典、任意异常捕获等),它是专为紧凑型数学计算和内存块操作量身定制的高性能模式。
四、中断服务程序(ISR)中的效率陷阱
如果单片机在处理外部引脚中断(GPIO IRQ)或定时器中断(Timer IRQ)时发生严重卡顿甚至死锁,通常是因为触碰了中断机制的硬性红线:硬件中断服务函数内严禁分配堆内存。
一旦在 ISR 中无意创建了临时变量、拼接了字符串或生成了新的异常对象,MicroPython 运行时会立即崩溃或报错:MemoryError: memory allocation not permitted in ISR。
应对中断卡顿与报错的标准操作步骤:
- 预分配紧急异常缓冲区:在程序入口尽早执行
micropython.alloc_emergency_exception_buf(100)。当 ISR 内部发生意外错误时,系统可以在不申请堆内存的前提下完整输出 Traceback 回溯,避免调试盲区。 - 使用
micropython.schedule()解耦操作:中断处理应尽可能短小(只做标志置位或计数),复杂的数据解析与网络发送通过schedule延后投递到主线程安全执行。
import micropython
from machine import Pin

# 1. 预先开辟紧急异常缓冲区(100 字节即可)
micropython.alloc_emergency_exception_buf(100)

def deferred_heavy_job(arg):
    # 此函数在主循环上下文安全运行,允许使用堆内存和复杂逻辑
    print("安全处理中断数据:", arg)

def pin_isr_callback(pin):
    # 硬中断环境:严禁申请任何新内存
    # 仅将事件安排进 MicroPython 任务队列
    micropython.schedule(deferred_heavy_job, pin.value())

btn = Pin(0, Pin.IN, Pin.PULL_UP)
btn.irq(trigger=Pin.IRQ_FALLING, handler=pin_isr_callback)
五、性能调优决策树与自查清单
在面对具体的项目卡慢时,不必盲目尝试所有手段。可以根据系统具体的症状,遵循下面的决策图谱针对性实施优化:
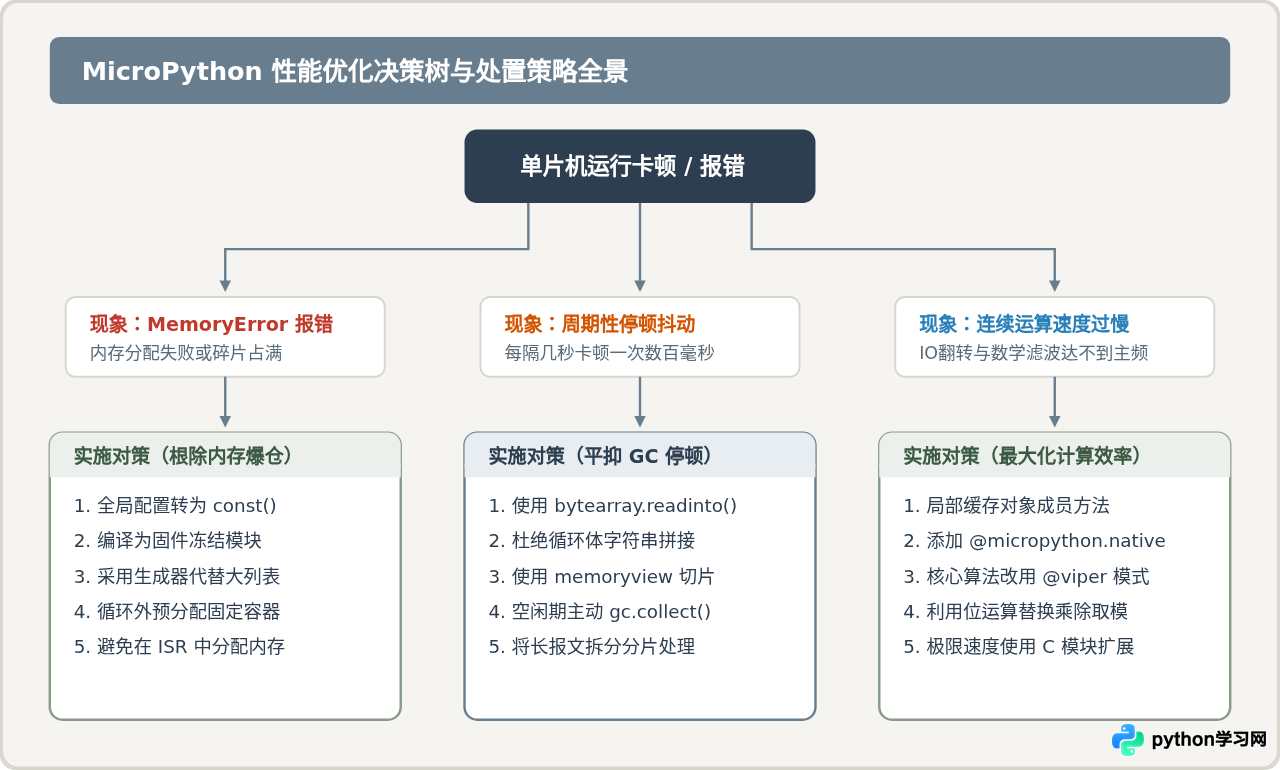
优化单片机上的 Python 程序并不意味着要放弃 Python 语言的简洁与灵活性。核心关键在于**建立对嵌入式资源约束的边界意识**:在初始化与业务架构阶段,尽情利用 Python 敏捷的高层表达;在进入高频循环、中断通信与数学运算的关键路径时,果断采用就地缓冲区复用、常量折叠与机器码发射器。掌握了这两层能力的配合,MicroPython 便能在有限的硬件资源上实现兼顾高开发效率与工业级稳定运行的预期效果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









