

Python数据库连接池配置与高并发优化
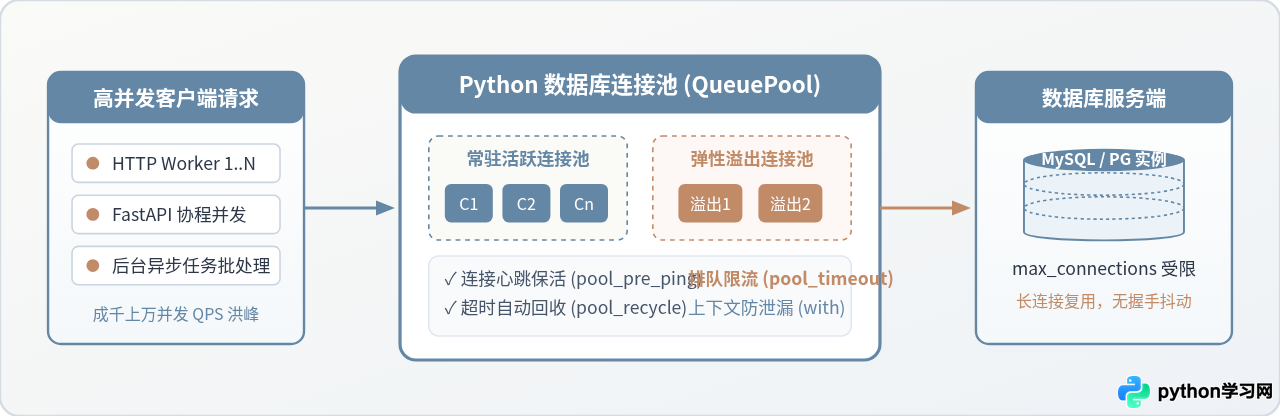
深入解析Python数据库连接池的核心机制、SQLAlchemy QueuePool与异步asyncpg的关键参数配置、多进程与异步并发模型适配、连接泄漏根治与高并发容量计算优化方案。
QueuePool 与异步 asyncpg 为代表,详解连接池的核心参数、生命周期防护、多进程与异步模型下的容量计算以及生产高并发优化策略。
一、高并发场景下为什么必须使用连接池
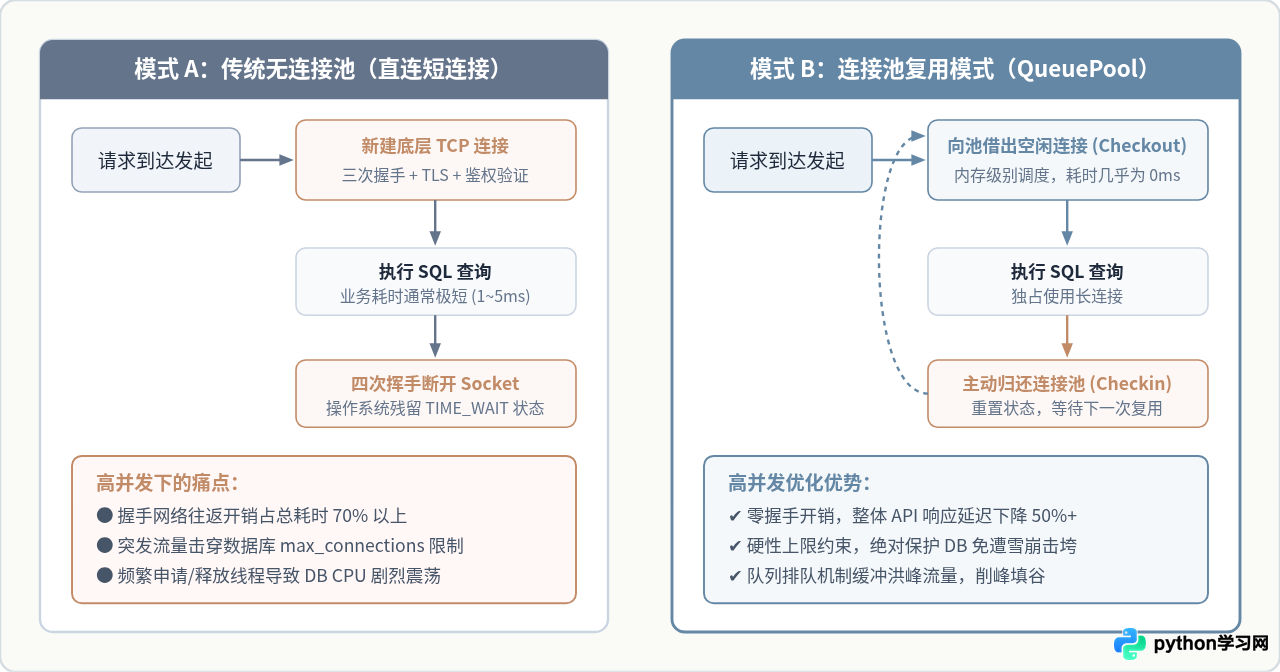
在没有连接池的直连架构中,客户端每执行一次业务请求,通常都会伴随一次完整的数据库连接创建与销毁。一个典型的关系型数据库(如 MySQL 或 PostgreSQL)连接生命周期包含客户端发起 TCP 三次握手、传输层 TLS 协商(若开启加密)、服务端密码鉴权、字符集协商以及会话环境初始化。
在单机低并发时,这数十毫秒的网络与计算耗时可能不易察觉;但在几百乃至上万 QPS 的高并发冲击下,这种“随用随连、用完即断”的模式会迅速引发灾难性后果:
- 网络与系统资源枯竭:短连接频繁关闭导致操作系统内核产生海量
TIME_WAIT状态的 Socket,最终耗尽临时本地端口号(Ephemeral Ports),抛出Cannot assign requested address错误。 - 数据库端内存与线程崩塌:MySQL 为每个连接分配专门的线程缓冲区(如
sort_buffer_size、read_buffer_size),PostgreSQL 更是采用单进程模型,每个连接对应一个后端操作系统进程,消耗数兆至数十兆物理内存。突发并发会瞬间触及max_connections阈值,抛出著名的Too many connections错误并导致数据库假死。 - 延迟剧烈抖动:在网络稍微波动或高负载时,握手和鉴权阶段极易因排队而发生超时,导致 API 响应时间出现严重的长尾延迟(P99 飙升)。
连接池的本质是一个带状态的并发缓冲限流器。它在服务启动或首次借用时初始化一定数量的长连接,请求到来时直接从池中借出(Checkout)已有连接,查询完毕后立即将连接归还(Checkin)至池中,全流程完全在应用层内存中完成流转,避免了昂贵的底层网络和鉴权开销。
二、SQLAlchemy 连接池核心参数详解与配置规范
SQLAlchemy 是 Python 生态中应用最为广泛的 ORM 与数据库抽象层,其默认使用的连接池实现是 QueuePool(基于内部线程安全队列的连接池)。在高并发生产环境中,合理设置 create_engine 的连接池参数是保障系统吞吐量与可用性的第一步。
1. 关键参数及其行为特征
-
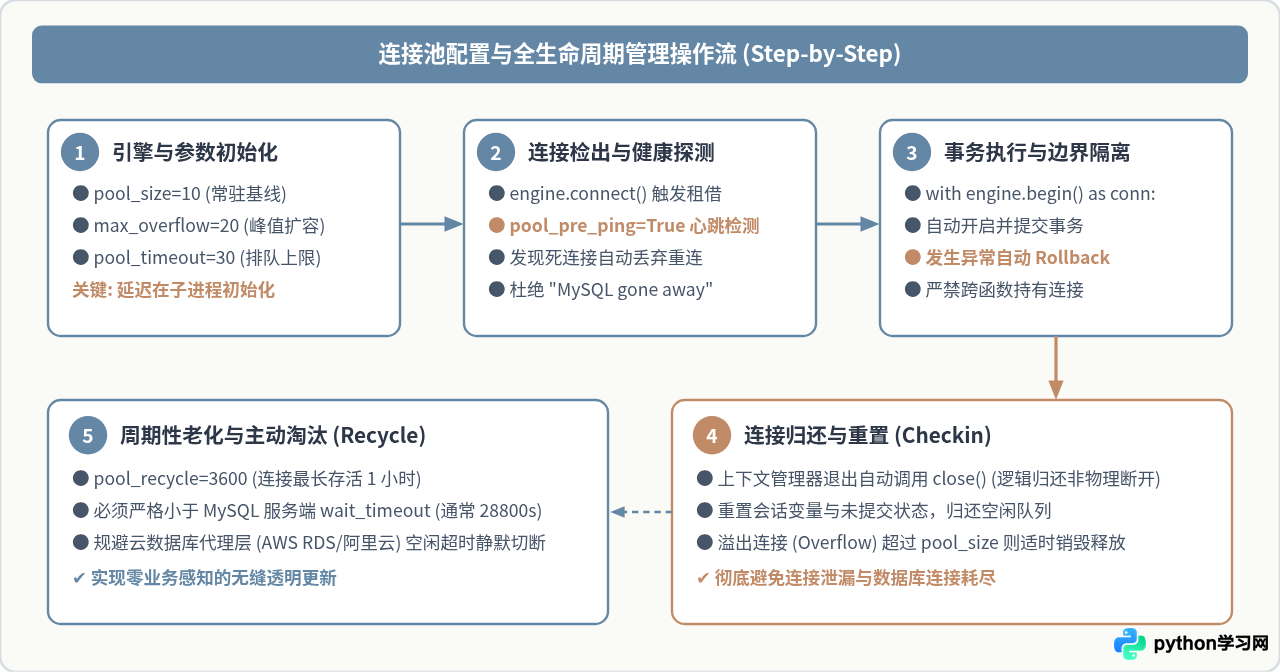
pool_size(默认通常为 5):常驻连接池大小。连接池始终保持维护的基础连接数量上限。即使系统处于空闲时段,已建立的这些连接也会保存在池中等待复用。 -
max_overflow(默认通常为 10):突发溢出连接数上限。当并发请求数超过pool_size且所有常驻连接均被借出时,连接池允许临时额外创建的连接数量。这部分连接在使用完毕并归还后,如果池中连接已满,会被连接池主动断开释放,起到“削峰”的作用。系统能够支持的最大并发连接物理上限为pool_size + max_overflow。 -
pool_timeout(默认 30 秒):借出等待超时时间。当池内可用连接与溢出连接均已耗尽时,新的借出请求将在队列中阻塞等待其他线程归还连接。如果在指定秒数内仍未获取到连接,连接池将抛出sqlalchemy.exc.TimeoutError: QueuePool limit of size X overflow Y reached。在高并发在线接口中,30 秒往往过长,建议调低至 3~5 秒以实现快速失败并触发降级。 -
pool_recycle(默认 -1 即不主动淘汰):连接存活最长时间(秒)。连接在池中存活达到该时长后,下一次检出时将被透明断开并重新建立连接。MySQL 服务端默认存在wait_timeout(通常为 8 小时),如果一个连接空闲超过该时间,MySQL 会单方面断开 TCP 连接,此时客户端若直接发送 SQL 会遭遇报错。设置pool_recycle=1800或3600可以确保客户端先于服务端淘汰旧连接。 -
pool_pre_ping(默认 False):悲观连接探测(心跳保活)。设置为True后,连接池每次将连接借给调用方之前,都会先发出一条极其轻量的探测语句(如SELECT 1)。如果探测失败,连接池会静默丢弃该断开连接并重新创建一个健康的连接返回给业务。这一配置是消除MySQL server has gone away异常最可靠的武器。
2. 生产级配置代码范例
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker

# 构建生产环境高可用数据库引擎
DATABASE_URI = "mysql+pymysql://app_user:Secr3t_P@ss@10.0.1.20:3306/production_db?charset=utf8mb4"

engine = create_engine(
    DATABASE_URI,
    # 1. 连接池容量配置
    pool_size=15,              # 常驻连接数
    max_overflow=25,           # 允许突发溢出的弹性连接数(总并发峰值上限 40)
    # 2. 超时与容错配置
    pool_timeout=5,            # 排队借连接超时时间限制为 5 秒,避免级联雪崩
    pool_recycle=1800,         # 30分钟主动回收连接,小于云数据库或代理的空闲超时
    pool_pre_ping=True,        # 每次借出前进行健康嗅探,自动剔除断开连接
    # 3. 底层驱动层网络超时防护
    connect_args={
        "connect_timeout": 3,  # TCP 建立连接超时
        "read_timeout": 10,    # 单次读取超时,防慢查询挂死连接
        "write_timeout": 10
    }
)

# 会话工厂配置
SessionLocal = sessionmaker(autocommit=False, autoflush=False, bind=engine)pool_pre_ping=True 会在每次借出连接时增加一次网络往返(RTT)。在局域网低延迟(<0.5ms)环境下,这个开销微乎其微;但如果数据库与应用跨机房或存在网络抖动,且业务 QPS 极高,需评估网络往返带来的累加耗时。
三、连接池生命周期与获取释放流程规范
配置好参数后,如果业务代码在使用连接时没有遵循严格的生命周期范式,极易导致“连接泄漏(Connection Leak)”。所谓连接泄漏,即业务代码借出连接后,由于异常抛出、逻辑分支提前退出或未显式调用关闭,导致连接未能归还连接池。随着请求累积,连接池内可用连接归零,整个系统将陷入无法响应的僵死状态。
标准安全操作范式
在 Python 中,必须始终通过上下文管理器(Context Manager)来管理连接与会话的生命周期。with 语句能够在代码块正常结束或中途发生任何未捕获异常时,自动触发 __exit__ 逻辑,确保底层连接安全归还池中。
from sqlalchemy import text
from contextlib import contextmanager

# 范式 1:直接使用 Engine 获取裸连接执行高性能原生 SQL
def fetch_user_profile(user_id: int):
    # engine.connect() 返回一个 Connection 对象,with 块退出时自动调用 close() 归还池中
    with engine.connect() as conn:
        stmt = text("SELECT id, username, email FROM users WHERE id = :uid")
        result = conn.execute(stmt, {"uid": user_id}).fetchone()
        if result is None:
            return None
        return dict(result._mapping)

# 范式 2:使用 Session 执行业务事务
@contextmanager
def get_db_session():
    session = SessionLocal()
    try:
        yield session
        session.commit()       # 正常完成提交
    except Exception:
        session.rollback()     # 出现异常立即回滚,防止残留事务状态污染下一个复用者
        raise
    finally:
        session.close()        # 确保 Session 关闭并向连接池归还底层连接
四、多进程 Web 架构下的连接池倍增陷阱与并发容量计算
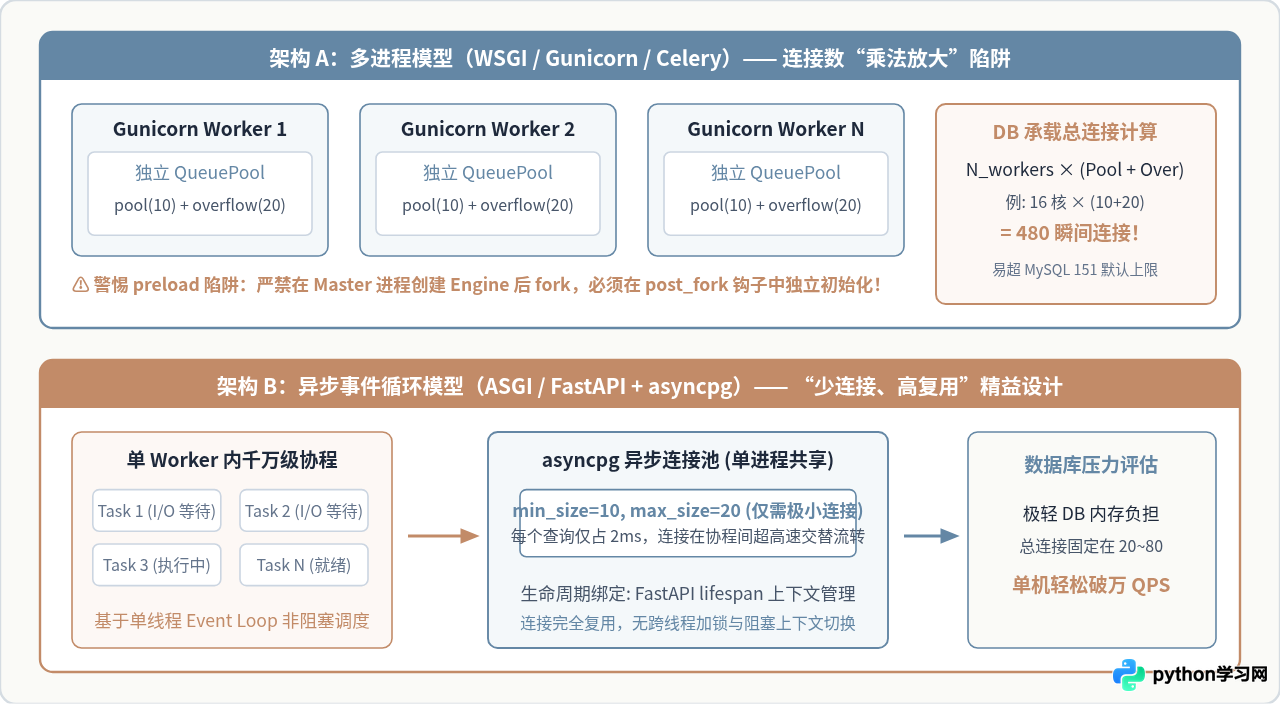
在主流的 Python Web 部署方案中,通常使用 Gunicorn 或 uWSGI 作为应用服务器,启动多个 Worker 进程(例如 gunicorn -w 8 -b 0.0.0.0:8000 app:wsgi_app)。很多开发者容易忽视一个根本事实:Python 的内存模型决定了每个独立进程都会拥有自己完全隔离的连接池实例!
1. 连接数乘法放大公式与数据库容量规划
如果在代码中配置了 pool_size = 20, max_overflow = 10,并且部署了 16 个 Gunicorn Worker 进程,那么该应用集群在峰值负载下向数据库发起的最大连接数计算如下:
最大潜在连接数 = Worker 进程数 × (pool_size + max_overflow)
               = 16 × (20 + 10) = 480 个连接
如果后端 MySQL 的 max_connections 设置为默认的 151,那么系统一遇到流量高峰就会瞬间打满数据库连接,引发全局拒绝服务。因此,配置连接池时必须从数据库承载力倒推每个 Worker 的池大小:
单个 Worker 允许的连接池基线 = (DB max_connections × 安全系数 0.7) ÷ (应用节点数 × 单节点 Worker 进程数)2. Gunicorn 的 preload 跨进程 Socket 污染致命隐患
当使用 Gunicorn 并开启 --preload 选项时,Gunicorn 会在 Master 进程中预先导入应用代码。如果在应用全局作用域直接执行了 engine = create_engine(...) 并且在 Master 阶段就触发了第一次数据库交互(例如读取全局配置),操作系统后续 fork() 生成子进程时,会将同一个打开的 Socket 文件描述符复制到所有 Worker 中。
这会导致多个子进程向同一个 TCP 连接并发读写,出现不同请求间的数据串话、认证错乱或 Packets out of order 崩溃。
规避方案:若开启预加载,必须在 Gunicorn 的 post_fork 钩子中执行 engine.dispose(close=False),以丢弃继承自父进程的无效连接池,让各 Worker 进程在自身空间内全新初始化连接:
# gunicorn_conf.py
bind = "0.0.0.0:8000"
workers = 8
preload_app = True

def post_fork(server, worker):
    # 子进程 fork 完成后,重置 SQLAlchemy 连接池,防止跨进程共享 socket
    from myapp.database import engine
    engine.dispose(close=False)
    server.log.info(f"Worker {worker.pid} 连接池重置完成")
五、异步高并发场景下的连接池优化(FastAPI + asyncpg)
在采用异步框架(如 FastAPI、Starlette、Tornado)构建的高吞吐服务中,底层的执行模型转变为非阻塞的单线程事件循环(Event Loop)。由于异步协程不会挂起整个操作系统线程,每个数据库操作在等待网络返回时都会主动让出 CPU,因此异步连接池的运作逻辑与同步连接池有显著不同。
在异步场景中,PostgreSQL + asyncpg 是性能首选的黄金组合。与同步池需要大量连接来弥补线程阻塞不同,异步连接池由于连接复用频率极高,单进程仅需维持 10~20 个连接就能轻松支撑数千 QPS。
FastAPI + asyncpg 生产级集成实现
import asyncpg
from contextlib import asynccontextmanager
from fastapi import FastAPI, Request, HTTPException

# 使用 lifespan 绑定连接池与 FastAPI 应用的生命周期
@asynccontextmanager
async def lifespan(app: FastAPI):
    # 应用启动时创建全局共享的异步连接池
    app.state.db_pool = await asyncpg.create_pool(
        dsn="postgresql://pg_user:SecurePass123@10.0.1.30:5432/order_service",
        min_size=10,                      # 初始保活空闲连接
        max_size=25,                      # 单 Worker 进程上限 25(已足够支撑超高并发)
        max_queries=50000,                # 单连接累计执行 5 万次查询后自动重建,防止内存碎片
        max_inactive_connection_lifetime=300.0, # 空闲 5 分钟自动释放
        command_timeout=5.0,              # 单 SQL 超时 5 秒
        timeout=3.0                       # 从池中获取连接超时 3 秒
    )
    yield
    # 应用关闭时优雅释放所有底层数据库连接
    await app.state.db_pool.close()

app = FastAPI(title="订单高并发处理服务", lifespan=lifespan)

# 依赖注入安全租借连接
async def get_db_connection(request: Request):
    pool: asyncpg.Pool = request.app.state.db_pool
    # acquire() 获取连接,离开 async with 自动归还
    async with pool.acquire() as connection:
        yield connection

# 高并发接口示例
@app.get("/api/v1/orders/{order_id}")
async def get_order_detail(order_id: str, conn: asyncpg.Connection = None):
    # 通过依赖注入或显式从 request.app.state.db_pool 借用
    pool: asyncpg.Pool = app.state.db_pool
    async with pool.acquire() as connection:
        row = await connection.fetchrow(
            "SELECT id, total_amount, status, created_at FROM orders WHERE id = $1",
            order_id
        )
        if not row:
            raise HTTPException(status_code=404, detail="订单不存在")
        return dict(row)
六、高并发环境下的容量估算与排障速查
许多团队在高并发优化时存在一个误区:“连接池越大越好”。然而,数据库系统的并发处理能力由 CPU 核心数和磁盘 I/O 能力严格制约。过大的连接池不仅不能提升性能,反而会因为数百个并发事务争夺锁、CPU 剧烈进行上下文切换(Context Switch)以及磁盘队列拥堵,导致整个数据库 QPS 呈断崖式下跌。
1. 利特尔法则(Little's Law)在连接池容量规划中的应用
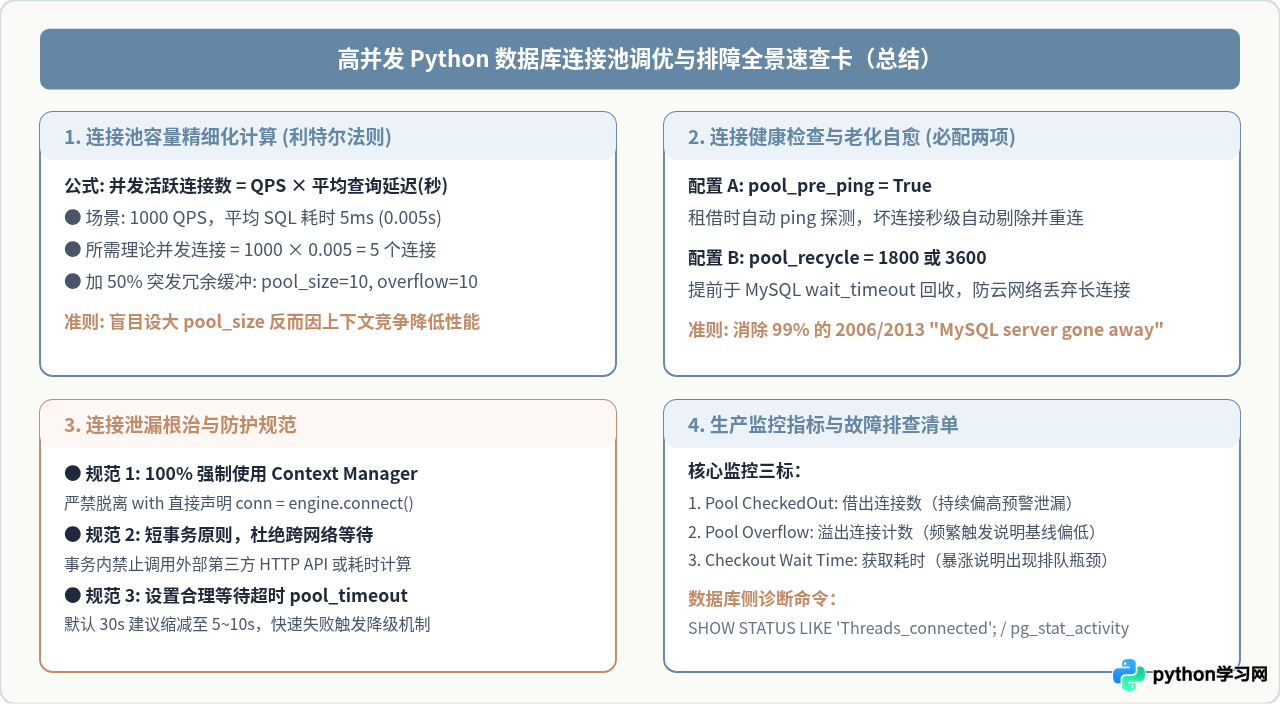
排队理论中的利特尔法则指出:一个系统中平均并发处理的请求数等于请求到达率乘以单请求平均处理时间。映射到数据库连接池计算:
理论基线连接数 = 业务峰值 QPS × 单次查询平均耗时(秒)假设业务接口目标峰值为 2000 QPS,经慢查询优化后,单次 SQL 平均执行耗时为 5ms(即 0.005 秒):
理论基线连接数 = 2000 × 0.005 = 10 个活跃连接考虑到流量分布不均与偶尔的慢查询抖动,通常在此基础上增加 50%~100% 的冗余缓冲。因此,将集群总体并发连接数设为 15~20 即可满足 2000 QPS 的吞吐需求,而不需要盲目配置成上百个连接。
2. 常见业务场景下的连接池配置参考矩阵
| 业务场景类型 | 推荐 pool_size | 推荐 max_overflow | pool_timeout | 核心调优关注点 |
|---|---|---|---|---|
| 低延迟在线 Web API (FastAPI/Flask) | 10 ~ 15 | 10 ~ 15 | 3 ~ 5 秒 | 必须配置 pool_pre_ping=True;超时快速失败并降级,防前端排队雪崩。 |
| 后台异步任务批处理 (Celery/RQ) | 2 ~ 5 | 0 ~ 5 | 30 秒 | Worker 数量较多,每个任务持有连接较久,池大小需严格受限,防止打满 DB。 |
| 数据报表与离线导出 | 3 ~ 5 | 2 | 60 秒 | SQL 耗时长,严禁与在线 API 共享同一个连接池和数据库实例,务必采用只读从库连接池。 |
| 单进程高并发微服务 (asyncpg) | 15 ~ 25 | 无需 (固定上限) | 3 秒 | 连接在协程间极速轮转,重点监控数据库服务端 CPU,避免无谓放大连接池。 |
3. 核心监控指标与故障自愈排查路径
在高并发系统上线后,应当接入 Prometheus 或应用日志对连接池状态进行实时度量:
- 借出连接数(Checked Out):如果在平峰期该数值持续接近
pool_size + max_overflow且不回落,高度表明存在连接泄漏或未提交的长事务,需立即排查代码中是否遗漏了with或finally关闭分支。 - 溢出利用率(Overflow Count):如果溢出连接常态化处于高位,说明当前基线
pool_size设置过小,频繁触发临时连接的建立与销毁,应适度调大常驻基线。 - 借出等待耗时(Checkout Latency):借出连接的等待时间发生毛刺,往往是数据库慢查询阻塞了工作线程归还,应优先排查数据库慢查询日志(Slow Query Log)建立索引,而非单纯扩大连接池。
通过理解连接池的工作原理,根据并发模型精细化配置参数,严格以“短事务+上下文管理器”管理连接生命周期,并结合容量法则合理设定阈值,即可彻底消除连接风暴与资源泄漏,为 Python 高并发后端服务筑起坚实可靠的数据库访问基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









