

Python time与datetime模块获取时间戳对比
深入对比Python中time与datetime模块获取时间戳的底层机制、执行性能、时区处理与精度差异,并提供工程实践避坑指南与选型决策。
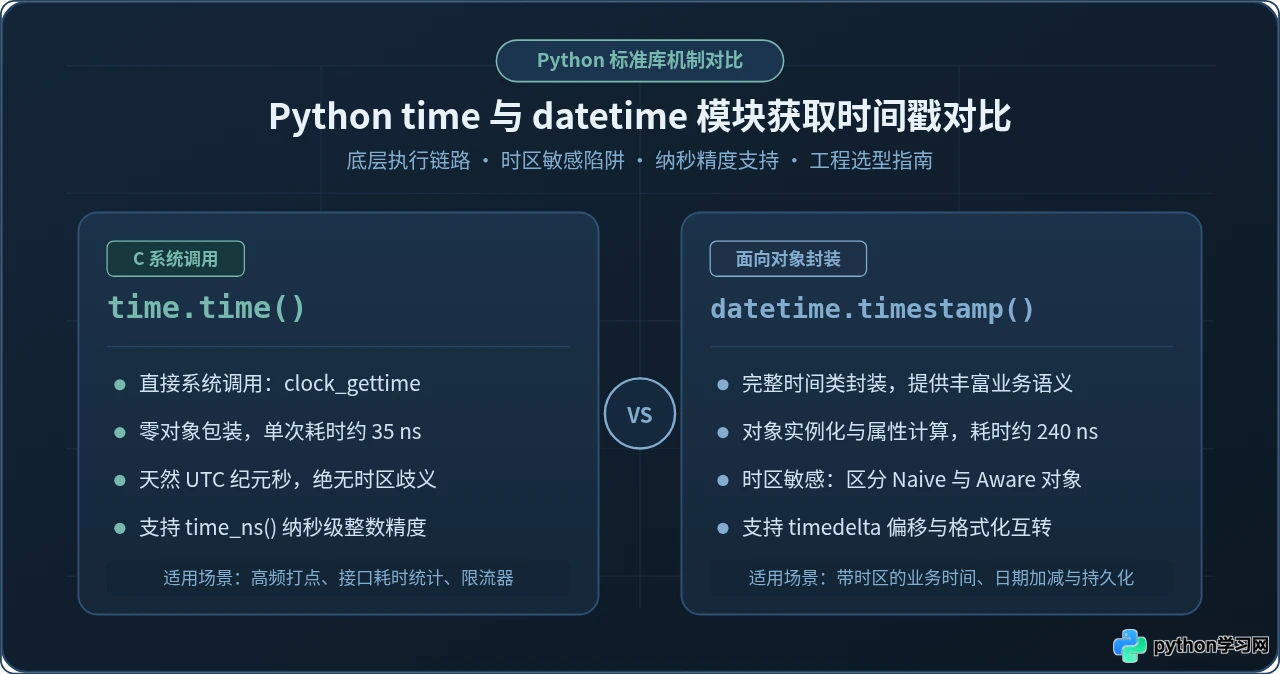
time 与 datetime 均提供了获取时间戳的能力,但两者的定位、底层设计与时区处理方式截然不同:若仅需获取当前时间戳或高频打点,time.time() 和 time.time_ns() 是性能最高、最纯粹且绝无时区歧义的选择;若涉及复杂的业务日期计算或明确的跨时区处理,应使用 datetime.now(timezone.utc).timestamp(),并严格警惕 datetime.utcnow().timestamp() 这一经典的时区偏差陷阱。
一、基本用法:获取时间戳的两种途径
在 Unix 系统和网络协议中,时间戳通常以秒(浮点数)或毫秒/纳秒(整数)的形式传递。在开始深入原理前,我们先看两者的典型写法。
1. time 模块的调用方式
time 是 Python 的内置 C 语言扩展模块,其提供的 time.time() 直接映射操作系统的系统调用:
import time

# 1. 获取浮点型秒级时间戳(包含微秒小数部分)
ts_float = time.time()
print(f"time.time(): {ts_float} (类型: {type(ts_float).__name__})")

# 2. Python 3.7+ 提供的纳秒级整数时间戳(避免浮点数精度损耗)
ts_ns = time.time_ns()
print(f"time.time_ns(): {ts_ns} (类型: {type(ts_ns).__name__})")
示例输出:
time.time(): 1761934053.481234 (类型: float)
time.time_ns(): 1761934053481234120 (类型: int)
2. datetime 模块的调用方式
datetime 模块是面向对象的日期时间库。从 Python 3.3 开始,datetime 对象新增了 timestamp() 方法:
from datetime import datetime, timezone

# 1. 方式 A:基于本地时区获取当前时间戳(隐式依赖系统本地时区)
dt_local = datetime.now()
ts_local = dt_local.timestamp()
print(f"datetime.now().timestamp(): {ts_local}")

# 2. 方式 B:显式指定 UTC 时区(生产环境强烈推荐)
dt_utc = datetime.now(timezone.utc)
ts_utc = dt_utc.timestamp()
print(f"datetime.now(timezone.utc).timestamp(): {ts_utc}")
示例输出:
datetime.now().timestamp(): 1761934053.481234
datetime.now(timezone.utc).timestamp(): 1761934053.481234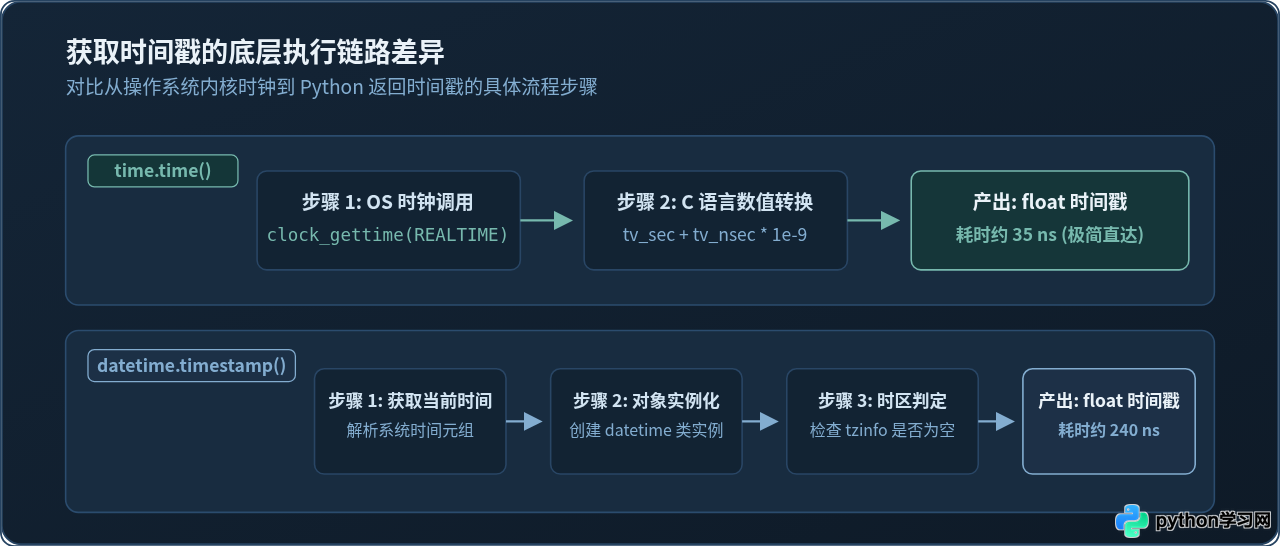
二、核心机制剖析:四大关键维度对比
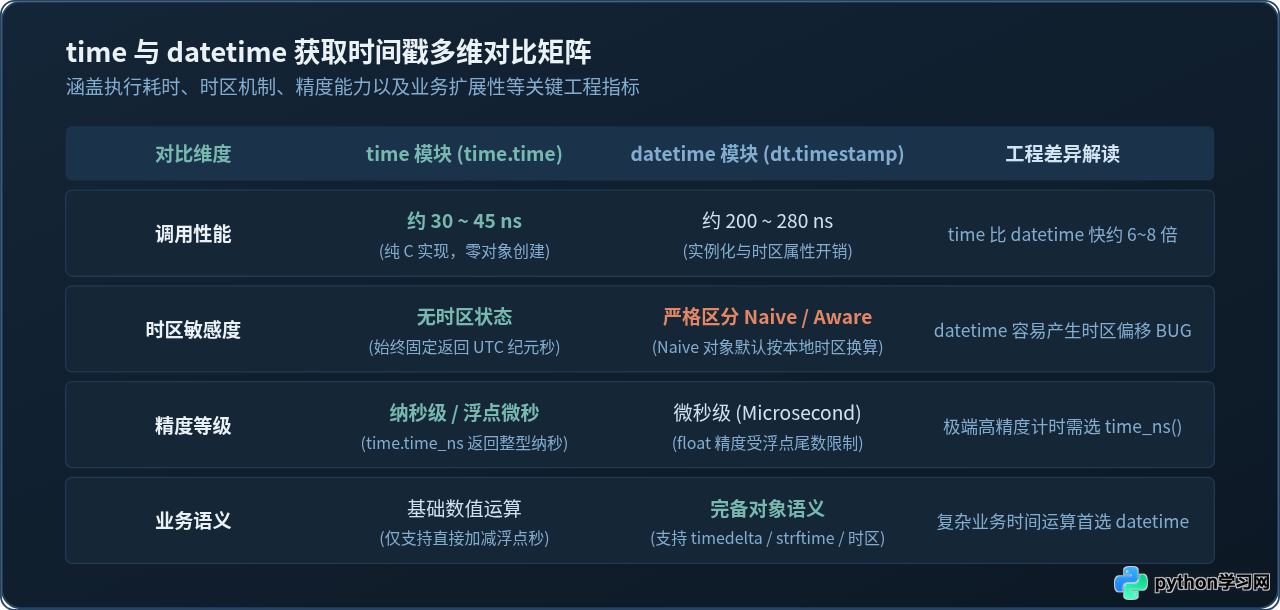
表面上看,time.time() 与 datetime.now().timestamp() 返回的数值完全一致,但在实际工程环境中,两者在执行机制、耗时、时区解析与精度层面存在本质差异。
1. 底层调用链路与执行开销
从调用步骤来看(如图 1 所示):
-
time.time() 的单步直达:底层直接调用 POSIX C 库的
clock_gettime(CLOCK_REALTIME)函数,提取秒数与纳秒数后,直接组装成 Python 的float返回。由于不涉及复杂的类封装和属性解析,单次调用耗时通常仅需 30 ~ 45 纳秒。 -
datetime 的多步封装:
datetime.now()必须先通过底层接口获取系统时间结构体,并在 Python 堆上分配一个完整的datetime实例(包含年、月、日、时、分、秒、微秒及时区指针属性)。随后调用.timestamp()时,又需要检查该实例的时区状态,再执行纪元秒换算。单次调用耗时约在 200 ~ 280 纳秒,耗时约为time.time()的 6 至 8 倍。
2. 精度与数据类型
Python 中的 float 类型遵循 IEEE 754 双精度浮点标准(53 位有效二进制位),在表示当前已达到 17 亿以上的时间戳时,其精度极限大约能稳定保留到微秒($10^{-6}$ 秒)级别。
在金融交易撮合、分布式链路追踪等对纳秒精度有刚性需求的场景中,浮点数存在尾数舍入风险。time.time_ns() 直接返回整型(int),在 Python 内部使用无长度限制的大整数表示,能够无损保留纳秒精度;而 datetime 类内部的最大精度定义仅为微秒(datetime.resolution = timedelta(microseconds=1)),原生无法表达纳秒。
三、避坑重点:Naive 时区与 utcnow 的致命陷阱
在处理时间戳时,最危险也最容易导致线上事故的误区莫过于对 datetime 时区属性(Naive 与 Aware)的混淆。
ts = datetime.utcnow().timestamp() # 危险!严重错误!
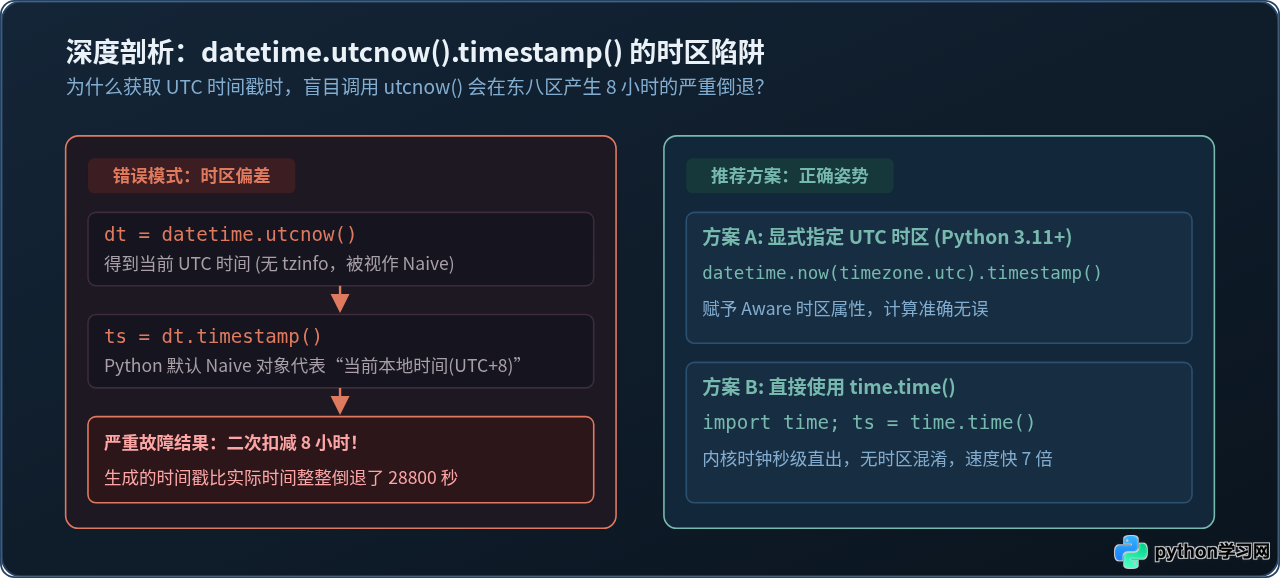
为什么 datetime.utcnow().timestamp() 会产生 8 小时偏差?
为了搞清楚这个故障,必须理解 .timestamp() 方法的内部规则:
-
时区感知对象 (Aware):若
dt.tzinfo不为空(例如datetime.now(timezone.utc)),Python 清楚知道该对象的偏移量,能准确计算其距离 1970-01-01 UTC 的秒数。 -
简单对象 (Naive):若
dt.tzinfo为空,.timestamp()会强制假设该对象表达的是“操作系统的本地时区时间”。
假设当前北京时间是 2026-11-01 16:00:00(UTC+8 时区):
- 调用
datetime.utcnow()会得到datetime(2026, 11, 1, 8, 0, 0),但它的tzinfo为None。 - 紧接着调用
.timestamp(),Python 误以为你给的“8 点”是本地北京时间(UTC+8),于是自动减去 8 小时的时区偏移去换算 UTC,计算出 00:00:00 的时间戳! - 最终产出的时间戳比当前真实时间整整慢了 8 小时(28800 秒)。如果该时间戳用于 JWT 鉴权或数据入库,会导致所有令牌立刻失效或数据排序紊乱。
datetime.utcnow() 极易引发上述混淆,Python 官方自 Python 3.12 起已正式将 datetime.utcnow() 标记为 Deprecated(弃用)。统一推荐改用 datetime.now(timezone.utc)。
四、工程选型指南:场景化决策与实践建议
了解了底层差异与潜在风险后,我们可以在日常架构与业务代码编写中建立清晰的选型标准。
| 需求场景 | 推荐方案 | 核心原因与考量 |
|---|---|---|
| 高并发接口打点、中间件耗时统计 | time.time() / time.perf_counter() |
执行耗时仅数十纳秒,直接系统调用,GC 与对象创建开销为零。 |
| 高精度度量、链路追踪 TraceID 生成 | time.time_ns() |
避免双精度浮点数尾数舍入,提供纳秒级整型精度。 |
| Redis 缓存键 TTL、Token 绝对过期时间计算 | time.time() + 3600 |
秒级纯数值运算直观清晰,执行速度快,无时区解析成本。 |
| 需要进行自然日/月业务偏移的时间戳计算 | (datetime.now(timezone.utc) + timedelta(days=3)).timestamp() |
结合 timedelta 表达清晰语义,避免手动换算 86400 秒带来的跨夏令时等潜在边缘问题。 |
| 解析第三方外部时间字符串转为时间戳 | datetime.strptime(...).replace(tzinfo=...).timestamp() |
利用 datetime 强大的解析与时区补全能力,确保入库时间戳准确。 |
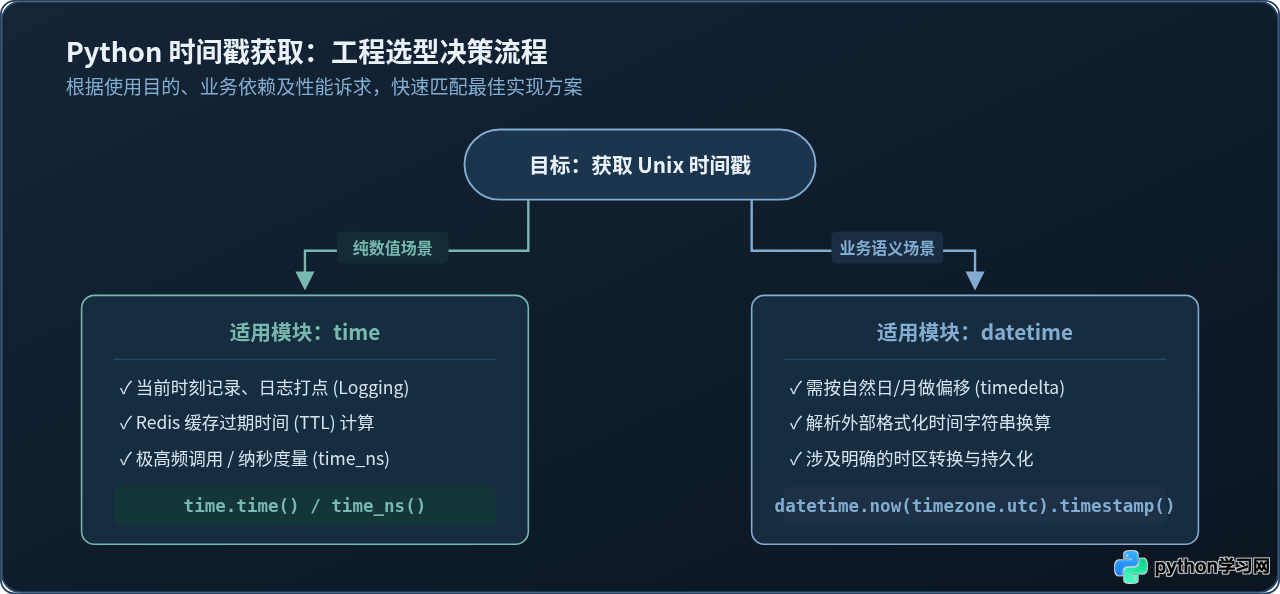
五、总结
在 Python 中获取时间戳时,选择 time 还是 datetime 并非随意二选一,而是取决于你的应用重点:
- 只关心“现在是哪个绝对时刻”:选择
time.time()或time.time_ns()。它是最干净的数值形式,与时区完全解耦,性能最高,开销最小。 - 需要处理“人类可读的日期规则与业务属性”:选择
datetime。务必确保时区属性完整(使用timezone.utc或zoneinfo),坚决杜绝在无时区标识的 Naive 对象上随意调用.timestamp()。
掌握这一边界划分,即可在保证系统高性能的同时,彻底规避线上可能出现的“8 小时时区幽灵”故障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









