

只会基础Python语法能找工作吗?企业招聘的真实门槛
只会基础Python语法无法获得企业技术岗位。本文深入剖析企业招聘对Python工程能力的真实门槛,拆解语法到岗位的四层能力架构,并提供清晰可行的进阶补齐方案。
核心结论:只会基础 Python 语法无法直接找到全职的技术开发或数据岗位。 在企业招聘的视角中,语法掌握仅相当于识字,而企业付费购买的是“利用完整技术栈与工具链解决业务问题、产出符合工程规范的可用软件”的能力。本文将直接拆解企业招聘的真实门槛,剖析从语法到可就业之间的核心差距,并给出具体的技能补齐实施步骤。
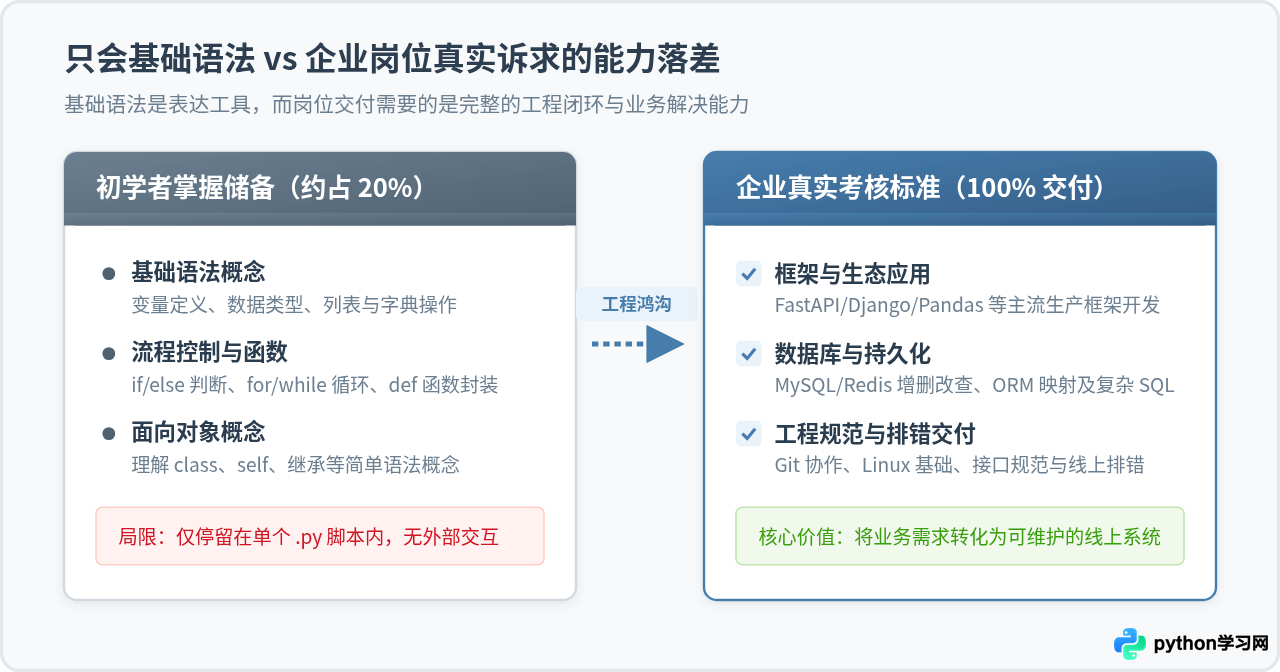 图 1:初学阶段掌握的语言要素与企业招聘全流程交付要求的现实差距
一、为什么“会写基础语法”不等于“具备工作能力”
许多初学者学完了变量、条件分支、循环结构、函数定义与简单的类封装,完成了几十道控制台输入输出的习题,就认为自己已经“掌握了 Python”,但在投递简历时往往石沉大海,或者在技术初筛环节立刻被淘汰。
这种认知脱节的根源在于:基础语法只是单机环境下的指令表达,而企业开发面对的是复杂的分布式工程环境。 企业招聘不是选拔“语法背诵者”,而是考核求职者能否独立完成一个业务功能的开发、调试、上线与维护。下表呈现了两种视角的本质差异:
| 对比维度 | 初学者眼中的“会Python” | 企业用人标准的“能做开发” |
|---|---|---|
| 数据存取 | 定义局部变量、列表、字典,或读写本地 .txt / .json 文件 |
使用 SQL 对 MySQL/PostgreSQL 进行表设计、关联查询与事务控制;使用 Redis 缓存热点数据 |
| 业务交互 | 依赖终端 print() 输出与 input() 命令行交互 |
遵循 HTTP/RESTful 规范,编写前后端分离的 API 接口,并提供结构化的 JSON 响应与状态码 |
| 异常与稳定性 | 程序出现报错直接终止在控制台,仅在简单逻辑处写 try...except Exception |
全局异常捕获、分级日志记录(Logger)、参数校验边界、业务错误码体系 |
| 协作与交付 | 单文件 main.py 脚本,本地单机运行,无版本控制 |
Git 多人分支协作、Linux 服务器环境运行、Docker 容器化打包、编写自动化测试 |
二、企业招聘考核的四层能力架构
企业在面试初中级 Python 工程师时,考察的是一个由下至上、层层依赖的能力结构。基础语法只位于最底层,权重通常不足 20%,真正决定录用与否的是更上层的工程化支持与业务交付能力。
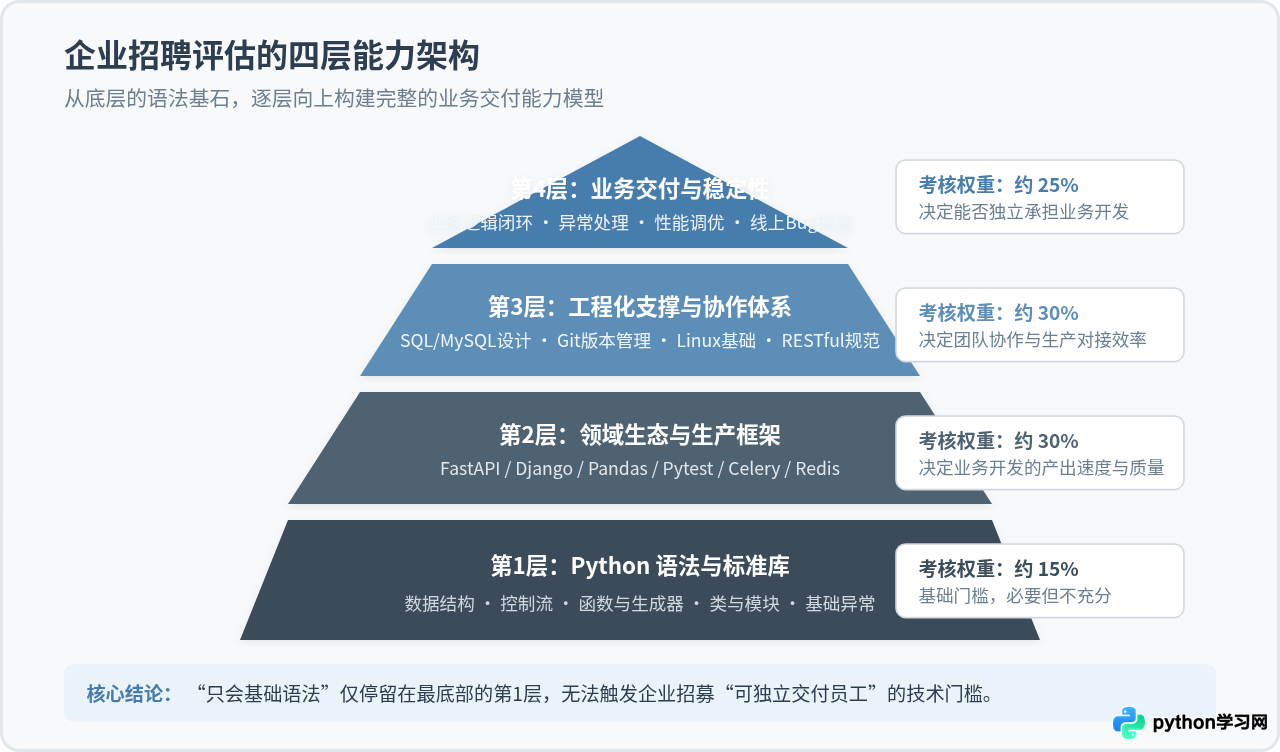 图 2:企业招聘考核的四层能力金字塔与各项权重分配
1. 第一层:Python 语法与核心机制(基底)
这一层是编码的基本功。企业不会单独考查 for 循环怎么写,而是关注语言特性的底层理解,例如:深浅拷贝区别、生成器(yield)与迭代器原理、装饰器的闭包机制与实际用途、GIL(全局解释器锁)对多线程并发的影响等。只会语法表面规则,在深入的技术交流中很容易露出破绽。
2. 第二层:领域生态与生产框架(工具层)
现代商业项目极少从零手写底层代码,全部基于成熟的框架生态搭建。求职者必须熟练掌握所投递岗位对应的主流框架。例如开发 Web 服务必须熟练掌握 FastAPI 或 Django,做数据清洗必须精通 Pandas 的向量化计算。没有框架实操经验,就无法融入现有的开发管线。
3. 第三层:工程化支撑与协作体系(规范层)
企业开发是团队协作。求职者必须具备以下“工程基建”技能:
- 版本控制(Git):熟练使用分支管理(branch)、合并冲突解决、规范的 commit 提交日志。
- 数据库系统:关系型数据库(MySQL/PostgreSQL)的规范化建表、索引原理、多表关联(JOIN)以及 ORM 性能调优,拒绝纯内存存储。
- 操作系统与环境:能熟练在 Linux 终端下查看日志、配置 Python 虚拟环境(venv/poetry)、管理进程(systemd/supervisor)。
4. 第四层:业务交付与稳定性保障(价值层)
这是决定薪资与录用的核心层。企业需要员工把产品经理的需求拆解为数据库表设计和接口逻辑,并能妥善处理异常情况。例如高并发下的重复提交、网络抖动的超时重试、线上 Bug 的日志回溯等。这一层能力通常体现在高质量的实战项目经验中。
三、主流 Python 岗位真实招聘门槛对比
Python 是一门通用型语言,不同就业方向对技术栈的侧重点差异极大。“只会基础语法”不仅找不到开发岗,甚至也达不到技术类转岗的要求。以下是目前市场上主流 Python 岗位的具体准入门槛:
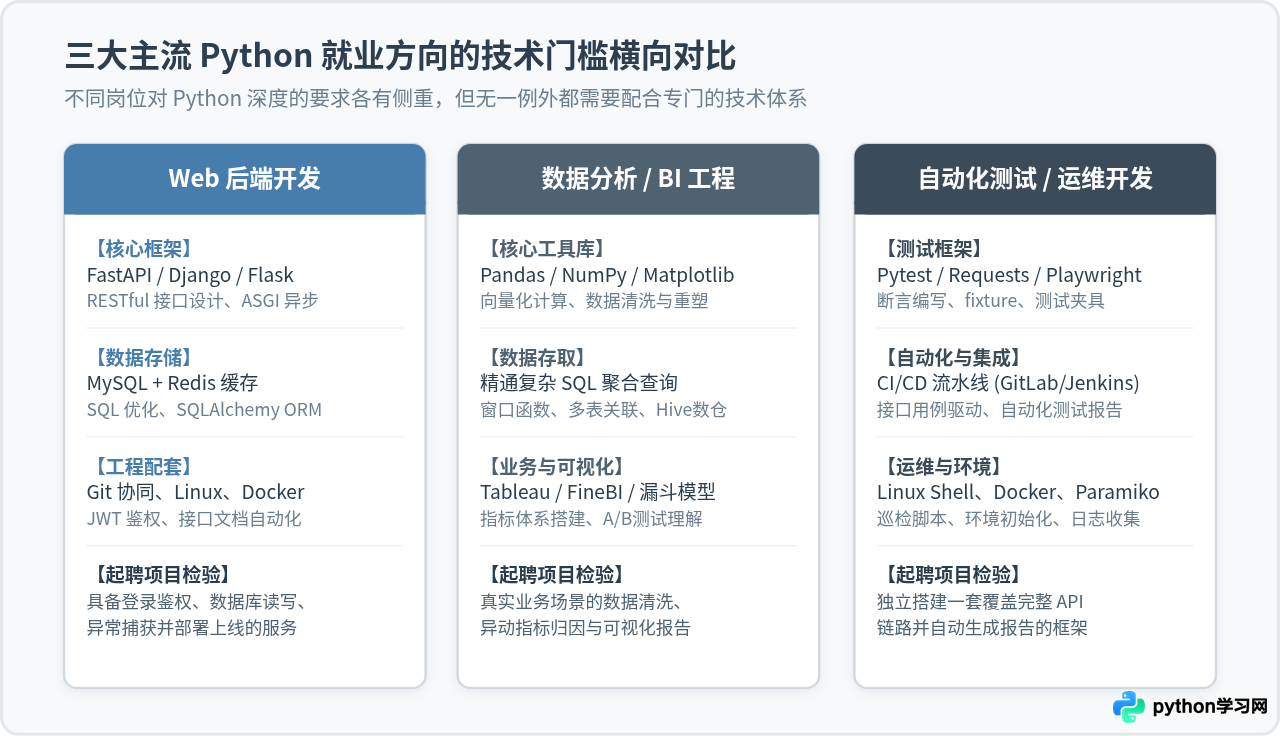 图 3:三大主流 Python 就业方向的技术门槛与起聘项目形态横向对比
1. Web 后端开发方向
岗位定位:负责企业系统、开放平台或小程序服务端的业务接口开发。
真实招聘门槛:
- 精通至少一个主流 Web 框架:现代异步框架推荐 FastAPI,传统全功能框架推荐 Django。掌握请求生命周期、依赖注入与中间件。
- 熟练掌握 MySQL 数据库设计与 SQL 优化,掌握基于 SQLAlchemy 或 Django ORM 的数据模型定义、多对多关联与事务操作。
- 掌握 Redis 在 Session 缓存、高频数据暂存或限流场景的应用。
- 具备编写自动化接口测试(Pytest)与遵循 RESTful 规范输出 OpenAPI 文档的能力。
2. 数据分析与 BI 工程方向
岗位定位:为业务运营、市场营销或产品决策提供量化数据支撑与可视化报表。
真实招聘门槛:
- 精通 SQL:数据分析师 70% 的日常工作是提取和整理数据,必须精通窗口函数(ROW_NUMBER, RANK)、复杂多表关联与分组聚合。
- 熟练使用
pandas和numpy完成缺失值清洗、异常值处理、时间序列重塑(pivot/melt)。 - 掌握业务指标拆解能力,能够基于真实业务场景搭建流失预测、留存分析或转化漏斗模型。
- 纯“语法小白”常误以为会用 matplotlib 画折线图就是数据分析,实际上企业更看重 SQL 功底与业务敏感度。
3. 自动化测试与运维开发方向
岗位定位:编写自动化测试脚本保障质量,或编写自动化运维工具提高系统运维效率。
真实招聘门槛:
- 精通
pytest框架,掌握 fixture 夹具、参数化测试、断言机制及 Allure 测试报告生成。 - 掌握接口测试工具库
requests或 UI 自动化工具(Playwright / Selenium)。 - 掌握 Linux 系统管理、Shell 脚本编写,以及 Jenkins / GitLab CI 持续集成流程对接。
四、从“掌握语法”到“达到初级门槛”的四阶段实施路径
如果当前仅掌握了语法,应当停止反复刷基础语法教程,转向系统性的工程能力建设。按照以下四个阶段执行,逐步完成工程化能力的升级:
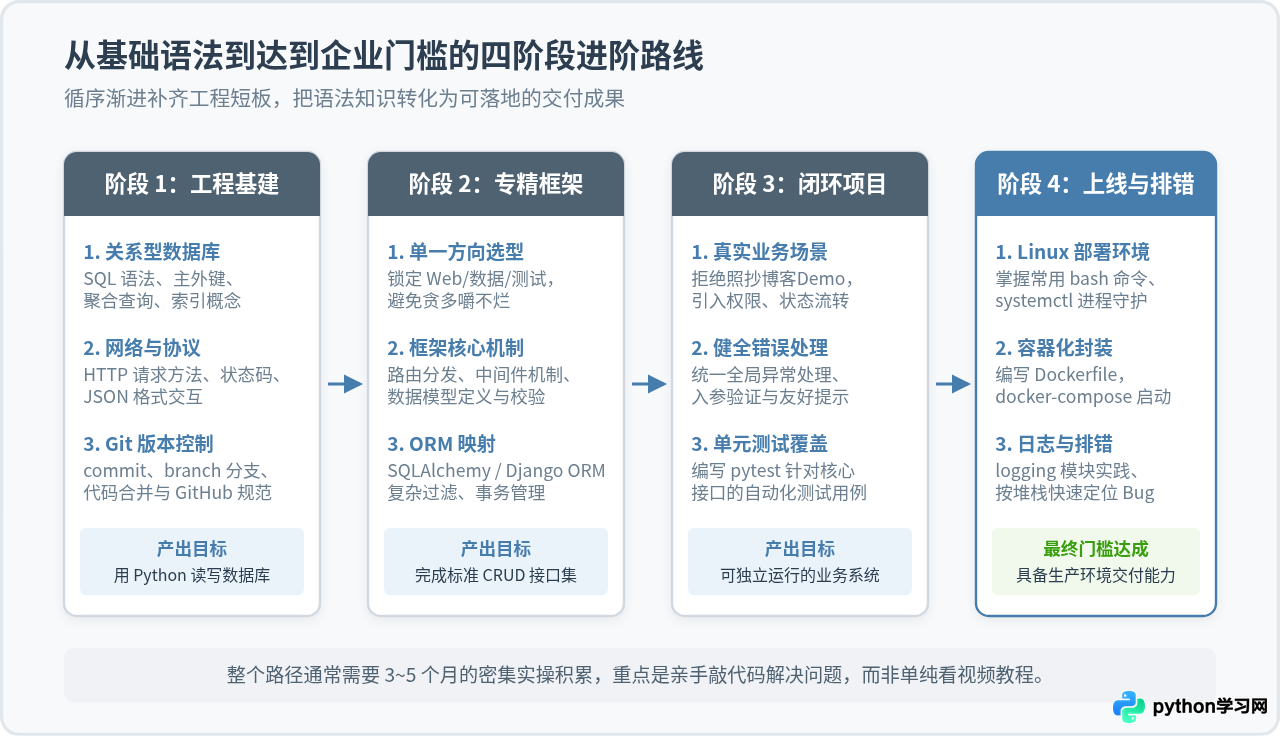 图 4:从基础语法跨越至符合企业起聘标准的四阶段进阶路线图
阶段一:补齐通用工程基础设施(周期:3-4周)
在这个阶段,目标是彻底告别“单文件控制台程序”,建立外部系统交互能力:
- 系统学习 SQL 与关系型数据库:安装本地 MySQL 或 SQLite,掌握建表约束、主外键设计,编写包含子查询和关联查询的 SQL 语句。
- 理解 HTTP 与网络通信:掌握 GET、POST、PUT、DELETE 语义,理解 HTTP 请求头(Header)、状态码(200、400、401、403、500)与 JSON 报文格式。
- 将代码纳入 Git 管理:注册 GitHub,学会使用命令行完成
git init、git add、git commit、git push,理解分支(branch)与拉取请求(PR)的协作流程。
阶段二:单点深入一个主流框架生态(周期:4-6周)
严禁“今天看 Django,明天看 Flask,后天看爬虫”。选择一个与目标岗位直接契合的路线,深入其最佳实践。以 Web 开发为例,学习 FastAPI 并掌握规范的项目工程目录组织:
# 典型的规范工程结构(非单文件脚本)
my_project/
├── app/
│   ├── api/             # 路由接口定义
│   │   └── v1/
│   │       ├── endpoints/
│   │       │   └── users.py
│   ├── core/            # 全局配置、密钥、安全验证
│   │   └── config.py
│   ├── crud/            # 数据库增删改查具体逻辑
│   │   └── crud_user.py
│   ├── models/          # SQLAlchemy ORM 数据库映射模型
│   │   └── user.py
│   ├── schemas/         # Pydantic 数据输入输出验证契约
│   │   └── user.py
│   └── main.py          # 应用入口与生命周期挂载
├── tests/               # Pytest 自动化测试目录
│   └── test_users.py
├── requirements.txt     # 项目依赖声明
├── Dockerfile           # 生产部署镜像构建配置
└── README.md            # 项目说明与接口文档运行指引
以下为一个符合生产规范的最小路由实现范例,展示了入参校验、ORM 会话注入与异常抛出机制:
# app/api/v1/endpoints/users.py 示例
from fastapi import APIRouter, Depends, HTTPException, status
from sqlalchemy.orm import Session
from app.schemas.user import UserCreate, UserResponse
from app.crud.crud_user import create_user, get_user_by_email
from app.core.database import get_db

router = APIRouter()

@router.post("/", response_model=UserResponse, status_code=status.HTTP_201_CREATED)
def register_user(user_in: UserCreate, db: Session = Depends(get_db)):
    # 1. 业务逻辑防重校验
    existing_user = get_user_by_email(db, email=user_in.email)
    if existing_user:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="该邮箱已注册,无法重复创建"
        )
    # 2. 调用数据持久化操作
    created_obj = create_user(db, user_obj=user_in)
    return created_obj
阶段三:打造具备业务闭环的独立项目(周期:4-5周)
简历上的项目是面试官考察的重点。必须坚决杜绝“学生成绩管理系统控制台版”、“10行代码爬取豆瓣排行榜”等同质化玩具项目。起聘项目应具备以下要素:
- 真实的业务场景:如企业资产审批流程、轻量级任务工单系统、带有鉴权和流控的 API 网关服务等。
- 完整的安全与鉴权:实现基于 JWT(JSON Web Token)的用户登录认证与角色权限控制(RBAC)。
- 健壮的异常与日志:捕获各类边界异常,记录清晰的错误堆栈至日志文件,而不是直接暴露内部错误。
- 单元测试保证质量:使用
pytest针对核心业务逻辑编写测试用例,覆盖率至少达到核心接口。
阶段四:掌握上线部署与运维排错基本功(周期:2周)
能把项目部署到真实服务器上,是击败 80% 初级求职者的关键优势:
- 购买一台轻量级 Linux 云服务器,练习通过 SSH 远程连接与基础命令(
ls, cd, ps, top, grep, journalctl)。 - 编写
Dockerfile,将 Python 应用及其依赖打包为容器镜像,保证运行环境一致性。 - 使用
docker compose统一编排 Python Web 服务与 MySQL 数据库,实现一键启动。
五、求职准备度自查清单与常见认知误区
在正式投递简历前,求职者可以通过下图的自查清单进行客观评估,判断自己是否真正具备了初级技术岗位的起聘资格:
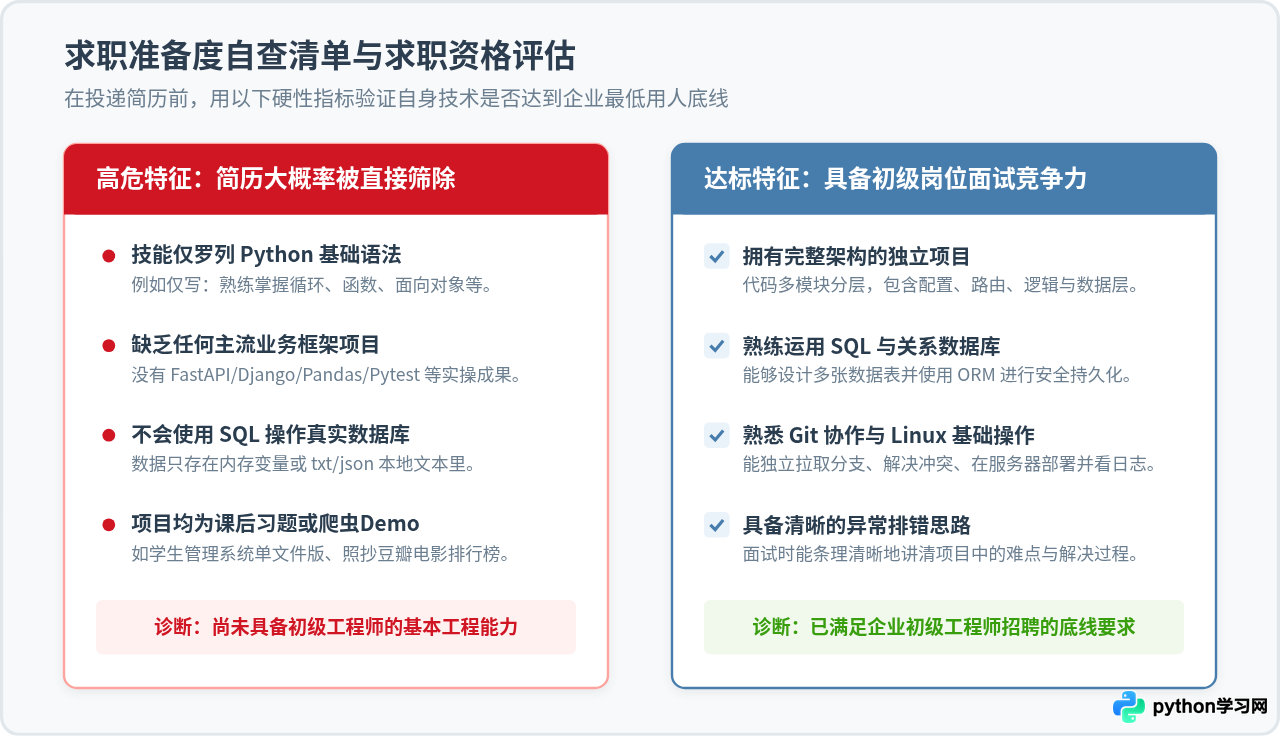 图 5:求职资格达标特征与高危淘汰特征对照自查清单
误区 1:狂刷算法题却无法实现具体业务。 很多初学者大量刷 LeetCode 简单题,却连用 Python 连接 MySQL 插入一条记录都不会。对于初级工程岗位,企业更看重“能否立马着手写业务接口”,算法仅在头部大厂作为辅助筛选题。
误区 2:零工程基础盲目追求“AI大模型/算法工程师”。 目前真正的算法岗位绝大部分要求名校计算机或数学硕士以上学历,并有学术论文或竞赛成绩背书。普通求职者零基础学习所谓“机器学习/深度学习”,由于缺乏底层的数学推导与工程底座,在招聘市场上几乎没有竞争力。
误区 3:简历项目写满“网络爬虫”,忽视法律边界与工程深度。 单纯的静态网页爬虫技术含量极低,且伴随合规与法律风险。相比简单的爬虫,企业更希望看到你如何构建可靠的后端服务或进行严密的数据清洗建模。
认识到“只会语法不能找工作”并不是否定过去的学习,而是明确下一阶段的努力方向。语言只是表达思想的语法糖,真正的价值永远体现在数据设计、框架运用、工程规范和解决具体业务问题的能力上。选定一个清晰的垂直方向,严格按照工程标准完成一个具备数据库持久化、接口安全校验和自动化测试的闭环项目,你才能真正跨过企业招聘的起聘门槛。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









