

Python通配符匹配文件名时怎么处理大小写敏感
详细讲解在Python中使用通配符匹配文件名时如何正确处理大小写敏感问题,分析跨平台底层机制差异,并提供Pathlib case_sensitive参数、字符集通配扩展、fnmatchcase与正则表达式四种实用解决方案。
glob.glob()、pathlib.Path.glob() 或 fnmatch 匹配文件名时,其默认的大小写敏感行为并不受 Python 自身统一管控,而是直接受宿主操作系统与底层文件系统驱动影响。在 Linux 上默认严格区分大小写,而在 Windows 和默认 macOS 上则忽略大小写。要摆脱这种跨环境运行的不一致性,主要可以通过四种技术路径解决:Python 3.12+ 原生的 case_sensitive 参数、零依赖全版本通用的字符集通配括号扩展法(如 *.[pP][nN][gG])、基于 os.scandir() 与 fnmatchcase 的流式过滤,以及正则表达式编译匹配。
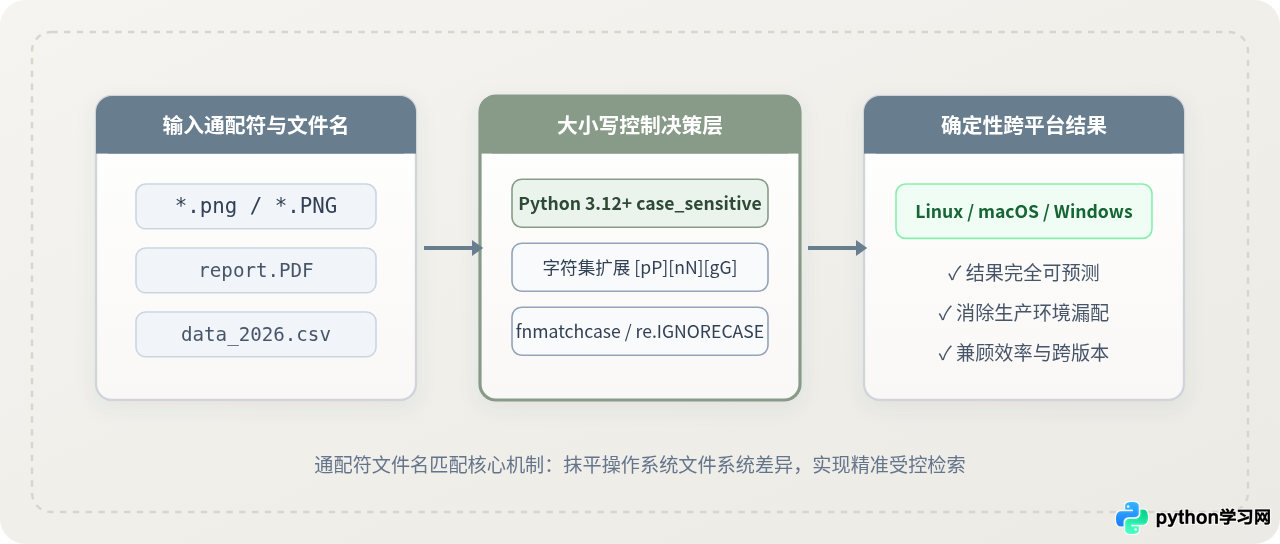
一、为什么默认通配符行为在不同系统上不一致
不少开发者在本地开发环境(通常为 macOS 或 Windows)编写代码,使用类似 glob.glob("*.jpg") 的语句顺利读取所有图片。然而,当程序打包部署至基于 Linux 内核的生产服务器或 Docker 容器时,却经常发生大写后缀(例如 IMG_001.JPG、banner.PNG)全部丢失的突发故障。
出现这种现象的根源在于:Python 标准库中的通配符匹配模块在设计时默认遵循了宿主操作系统的文件命名规则。
- Linux 环境(ext4 / xfs 等文件系统):底层文件系统对文件名大小写严格敏感。
logo.png与LOGO.PNG在磁盘目录中对应两个互不相同的独立 inode 记录。Python 调用底层目录接口时,严格按字面逐字节比对。 - Windows 环境(NTFS / FAT32 文件系统):系统层面大小写保留(Case-Preserving)但检索时不敏感(Case-Insensitive)。在匹配通配符时,系统驱动会自动放行不同大小写的名字。
- macOS 环境(默认 APFS / HFS+ 文件系统):虽然底层为 UNIX/POSIX 规范,但默认格式化为“大小写不敏感”,匹配表现更贴近 Windows。
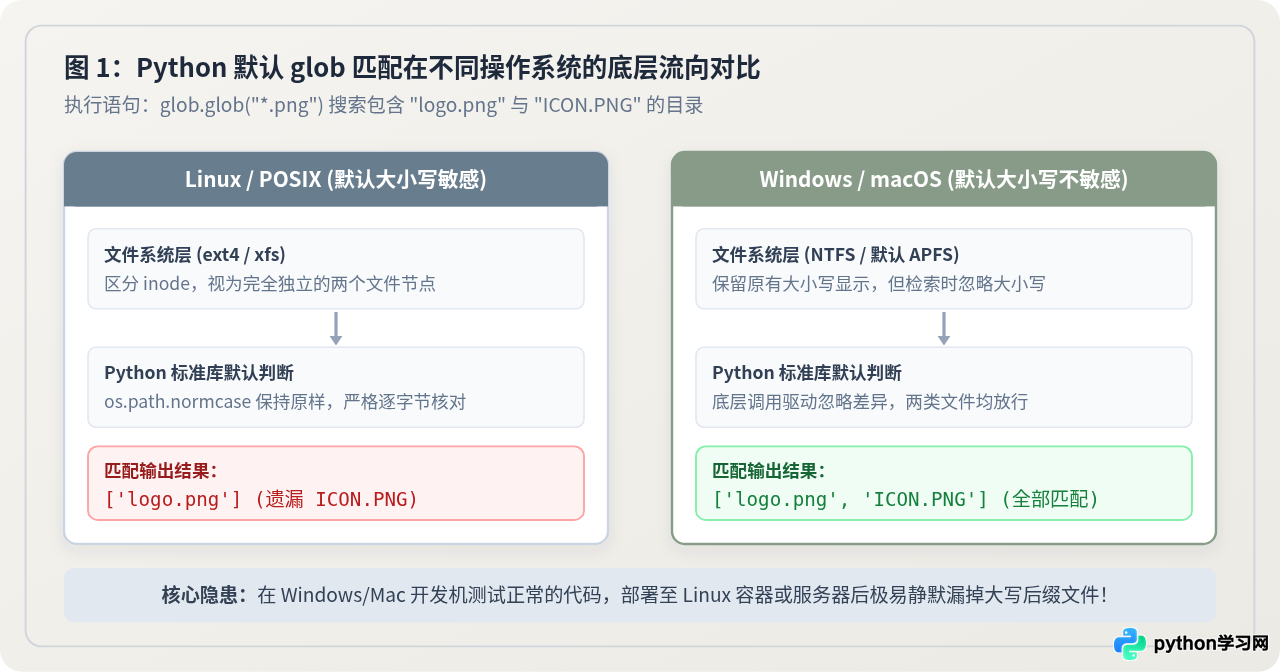
注意:跨平台部署的代码隐患
如果业务逻辑需要确保跨平台表现绝对一致,绝不能寄希望于操作系统的默认行为,必须在 Python 业务代码中显式指定大小写匹配规则。
二、方案一:字符集通配括号扩展(全版本通用)
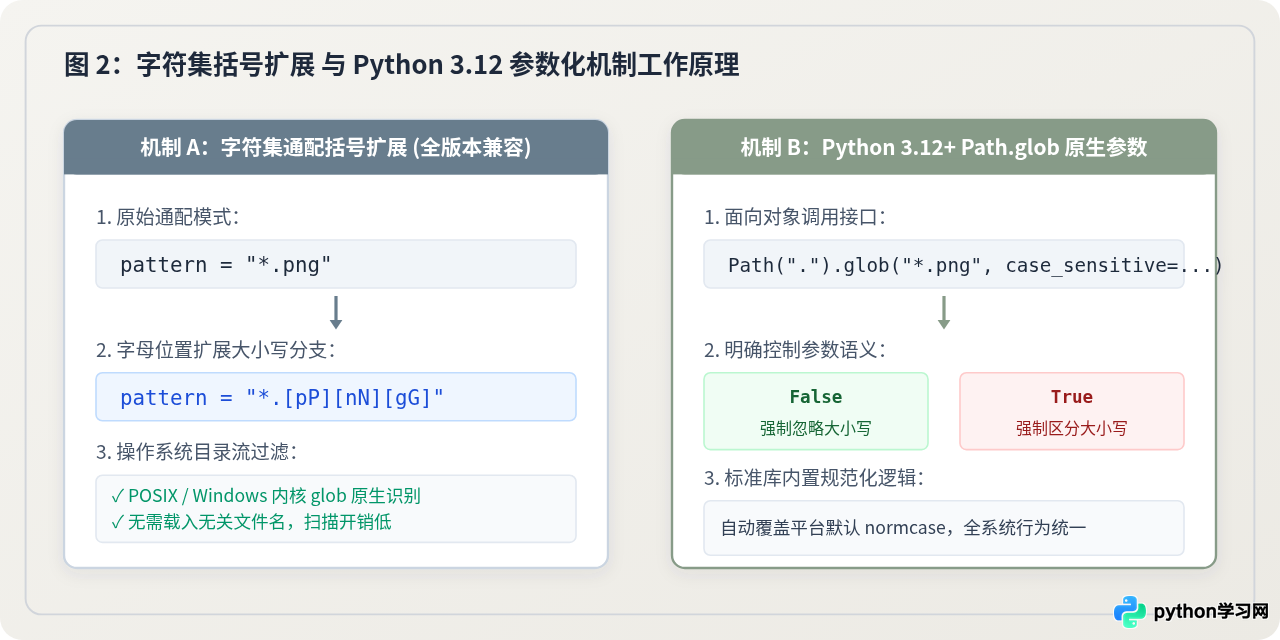
如果你的项目运行在 Python 3.11 及更早版本,或者正在使用传统的 glob.glob(),最直接、性能最高且无需额外依赖的手段是利用 Shell 通配符规范内置的字符集语法 [...]。
在通配符标准中,方括号 [aA] 表示匹配该位置上的任意一个字符。如果将后缀 .png 改写为 .[pP][nN][gG],无论是 Linux、macOS 还是 Windows,底层文件系统接口都能在目录扫描阶段直接过滤出所有大小写组合,而无需先将整个目录成千上万个文件读入 Python 内存再做后置判断。
import glob

# 静态指定方式:匹配常见扩展名的大小写形态
matched_files = glob.glob("/data/images/*.[pP][nN][gG]")
print(matched_files)
# 示例输出:['/data/images/avatar.PNG', '/data/images/logo.png', '/data/images/icon.Png']
为了避免手工书写括号表达式过于繁琐或容易漏写,可以编写一个轻量级的模式转换函数,将普通通配符字符串自动转换为大小写不敏感模式:
import glob

def make_case_insensitive_pattern(pattern: str) -> str:
    result = []
    in_bracket = False
    for char in pattern:
        if char == '[':
            in_bracket = True
            result.append(char)
        elif char == ']':
            in_bracket = False
            result.append(char)
        elif not in_bracket and char.isalpha():
            result.append(f"[{char.lower()}{char.upper()}]")
        else:
            result.append(char)
    return "".join(result)

# 自动化处理示例
raw_pattern = "*.jpg"
expanded_pattern = make_case_insensitive_pattern(raw_pattern)
print("转换后的通配符:", expanded_pattern)
# 示例输出:转换后的通配符: *.[jJ][pP][gG]

files = glob.glob(expanded_pattern)
三、方案二:Python 3.12+ 的官方标准解法(Path.glob 参数)
从 Python 3.12 版本开始,官方在 pathlib.Path.glob()、Path.rglob() 以及 Path.match() 方法中正式新增了名为 case_sensitive 的关键参数。这是 Python 标准库首次为通配符文件名匹配提供显式的大小写开关。
case_sensitive=True:强制开启大小写敏感。即便在 Windows 或 macOS 这种不敏感系统上,也会严格按照大小写区分进行精准匹配。case_sensitive=False:强制忽略大小写。在 Linux 等 POSIX 环境下,同样能够完整匹配到.png、.PNG、.Png等所有变体。case_sensitive=None(默认值):继续沿用底层操作系统的默认机制。
from pathlib import Path

target_dir = Path("/data/documents")

# 1. 强制忽略大小写检索(跨平台行为统一)
pdf_files = list(target_dir.glob("*.pdf", case_sensitive=False))
print("忽略大小写匹配:", [f.name for f in pdf_files])
# 示例输出:忽略大小写匹配: ['annual_report.PDF', 'invoice.pdf', 'Summary.Pdf']

# 2. 强制要求大小写严格一致
strict_pdf = list(target_dir.glob("*.pdf", case_sensitive=True))
print("严格大小写匹配:", [f.name for f in strict_pdf])
# 示例输出:严格大小写匹配: ['invoice.pdf']
版本演进建议
如果开发项目已经全面迁移到 Python 3.12 或更高版本,推荐优先采用面向对象的 Path.glob(..., case_sensitive=False),代码表达清晰、语义明确且完全摆脱底层环境干扰。
四、方案三:内存遍历结合 fnmatch 与 fnmatchcase
在需要结合文件属性(如文件大小、修改时间)做复合过滤,或者需要在 Python 3.12 以下版本精准控制大小写时,标准库的 fnmatch 模块是另一利器。
需要格外理清 fnmatch.fnmatch() 与 fnmatch.fnmatchcase() 这两个函数的本质区别:
fnmatch.fnmatch(name, pattern):内部会先通过os.path.normcase规范化大小写,因此它依然依附于操作系统的规则(Windows 上忽略大小写,Linux 上区分大小写)。fnmatch.fnmatchcase(name, pattern):在所有操作系统上都绝对保持大小写敏感。它不会执行任何自动归一化处理。
基于这个特性,如果我们想在任何系统上都实现严格忽略大小写,只需在调用前将文件名与通配符全部转换为小写;如果想要严格区分大小写,则直接使用 fnmatchcase:
import os
import fnmatch

def match_files_in_dir(directory: str, pattern: str, case_sensitive: bool = False):
    matched = []

    # 预处理比对模式
    target_pattern = pattern if case_sensitive else pattern.lower()

    with os.scandir(directory) as entries:
        for entry in entries:
            if not entry.is_file():
                continue

            file_name = entry.name
            compare_name = file_name if case_sensitive else file_name.lower()

            # fnmatchcase 在全平台上行为完全一致
            if fnmatch.fnmatchcase(compare_name, target_pattern):
                matched.append(entry.path)

    return matched

# 实际调用测试
results = match_files_in_dir("/var/log", "*.log", case_sensitive=False)
print(f"匹配到日志文件数量: {len(results)}")
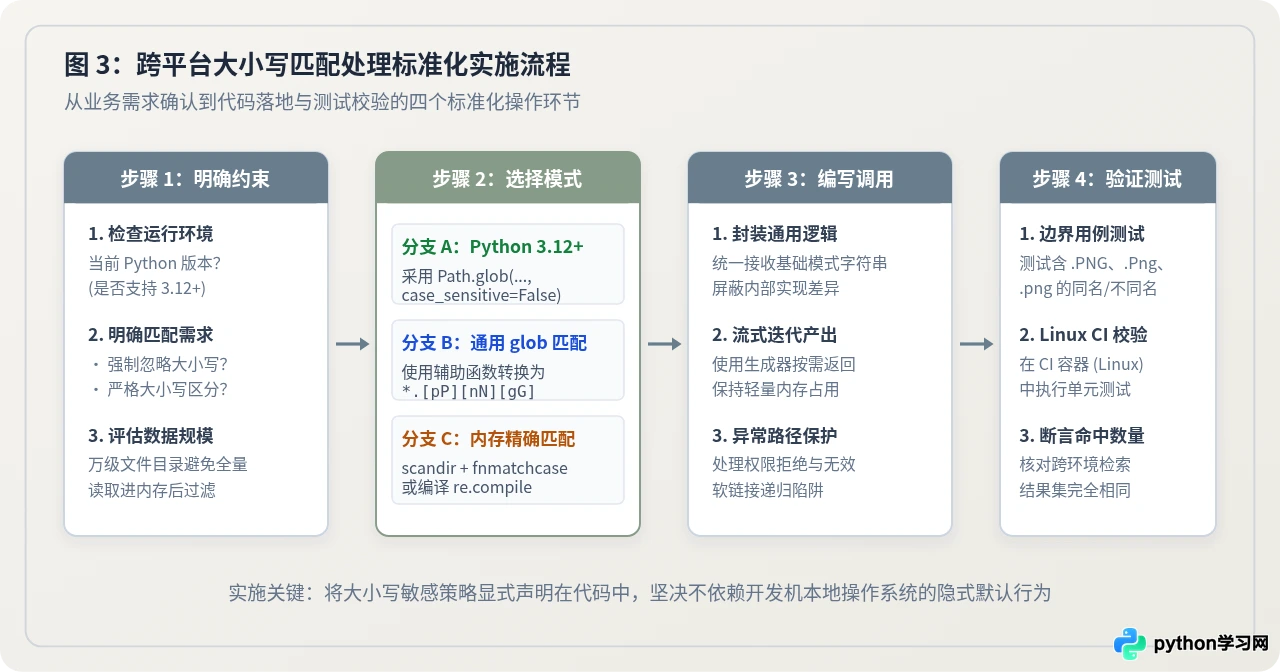
五、方案四:通配符转正则表达式(应对复杂业务规则)
当通配符匹配逻辑需要与更加复杂的文件名校验混合使用(例如同时要求匹配多种后缀、排除特定前缀等),可以将通配符转换为正则表达式,并借助 re.IGNORECASE 标志进行编译匹配。
Python 标准库提供了 fnmatch.translate(pattern),它可以将 Shell 风格的通配符字符串直接翻译成标准的正则表达式字符串:
import os
import re
import fnmatch

def find_files_regex_glob(directory: str, glob_pattern: str, ignore_case: bool = True):
    # 1. 将通配符转换为正则表达式
    regex_pattern = fnmatch.translate(glob_pattern)

    # 2. 编译正则表达式并设置标志位
    flags = re.IGNORECASE if ignore_case else 0
    compiled_regex = re.compile(regex_pattern, flags)

    # 3. 遍历目标目录进行过滤
    matches = []
    for root, _, files in os.walk(directory):
        for file in files:
            if compiled_regex.match(file):
                matches.append(os.path.join(root, file))
    return matches

# 执行检索
found_items = find_files_regex_glob("/workspace/assets", "img_*.png", ignore_case=True)
print("正则通配检索结果:", found_items)
在批量处理超大目录树时,预先使用 re.compile() 完成正则编译能够有效避免单步重复解析的开销,在灵活性与执行性能之间取得良好平衡。
六、技术方案对比与选型决策
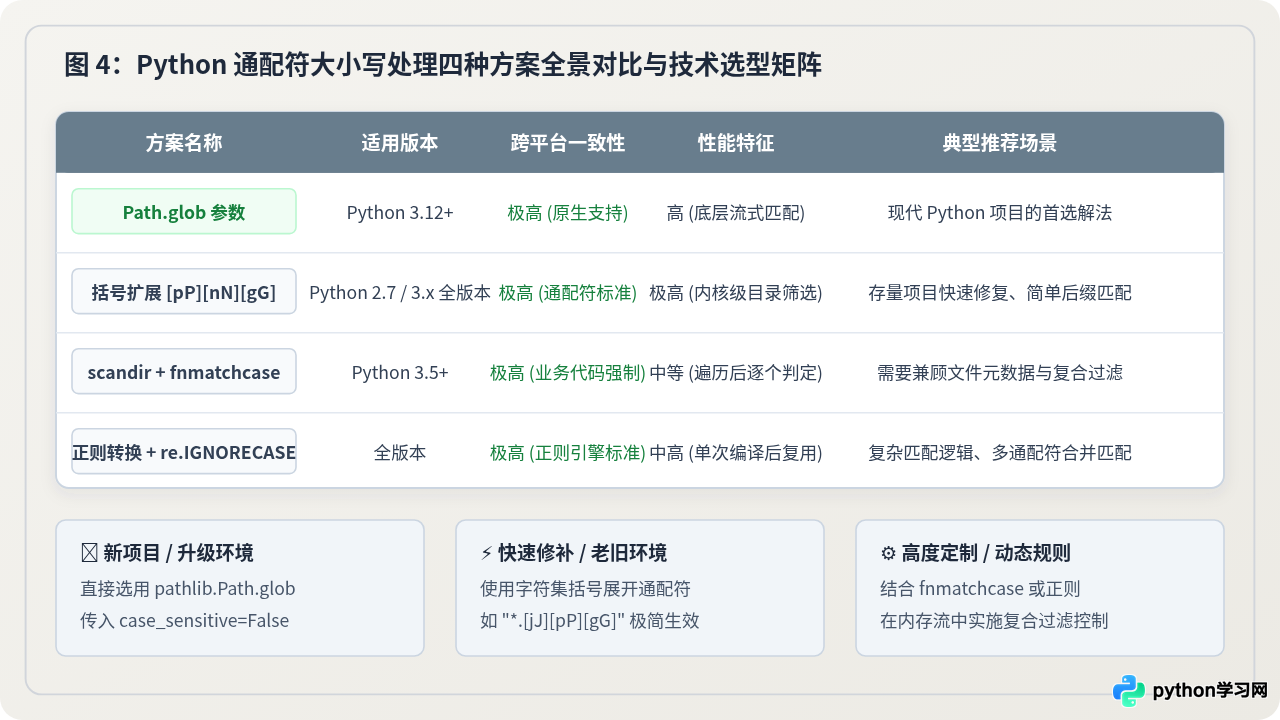
在实际项目架构中,应该根据运行的 Python 环境、目录文件规模以及代码重构成本,选择针对性的解决策略。下表汇总了四种处理方案的核心维度差异:
| 方案分类 | 依赖版本 | 跨平台表现 | 扫描性能 | 主要优势与限制 |
|---|---|---|---|---|
| Path.glob(case_sensitive) | Python 3.12+ | 绝对统一 | 极高(流式过滤) | 官方原生参数,语义最清晰;仅受限于旧版本 Python 无法使用。 |
| 字符集括号扩展 [pP][nN][gG] | 全版本通用 | 绝对统一 | 极高(OS 内核检索) | 零依赖、无需修改扫描方式;对复杂长通配符需要辅助函数生成。 |
| scandir + fnmatchcase | Python 3.5+ | 绝对统一 | 高(按需流式) | 便于融合元数据判断;需自行遍历目录项并调用函数比对。 |
| fnmatch.translate + 正则 | 全版本通用 | 绝对统一 | 中高(单次编译) | 支持多规则扩展;在大规模简单匹配场景下略显重量级。 |
七、常见注意事项与避坑总结
-
谨防开发机测试假象:在 macOS 或 Windows 上进行单元测试时,由于文件系统本就忽略大小写,未做大小写保护的代码往往也能顺利通过测试。务必在 CI/CD 流程中加入 Linux 容器测试环节,或主动准备混合大小写(如
.PNG与.png共存)的测试用例。 -
避免全量载入内存:当目标目录包含数万个文件时,避免使用
os.listdir()将全部文件名构造成庞大列表再通过列表推导式匹配,应优先采用os.scandir()或Path.glob()生成器流式处理,防止造成内存峰值激增。 -
字符集方括号冲突:在使用字符集扩展法(
make_case_insensitive_pattern)时,如果原始文件名中本身包含合法方括号(如image_[1].png),需要注意转义,防止被误判为通配符集合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









