

Python通配符匹配特殊字符为何失效

glob、pathlib.Path.glob() 或 fnmatch 匹配文件名时,如果目标路径包含方括号([ ])、星号(*)、问号(?)或特定平台的反斜杠,匹配操作往往会静默返回空列表。失效的根源在于:通配符引擎并非进行字面量文本匹配,而是将通配符模式底层翻译为正则表达式;在转译规则中,方括号被视作正则字符集合(Character Class),星号与问号被视作量词。要使特殊字符回归字面量含义,核心方案是借助 glob.escape() 进行结构化转义,或在复杂场景下使用原生正则引擎。
一、核心机制:通配符如何被 Python 解释与转换
许多开发者初次遇到通配符失效时,常误以为是操作系统文件权限问题或 Python 路径截断缺陷。实际上,这是 Python 通配符模块内部的设计机制所决定的。
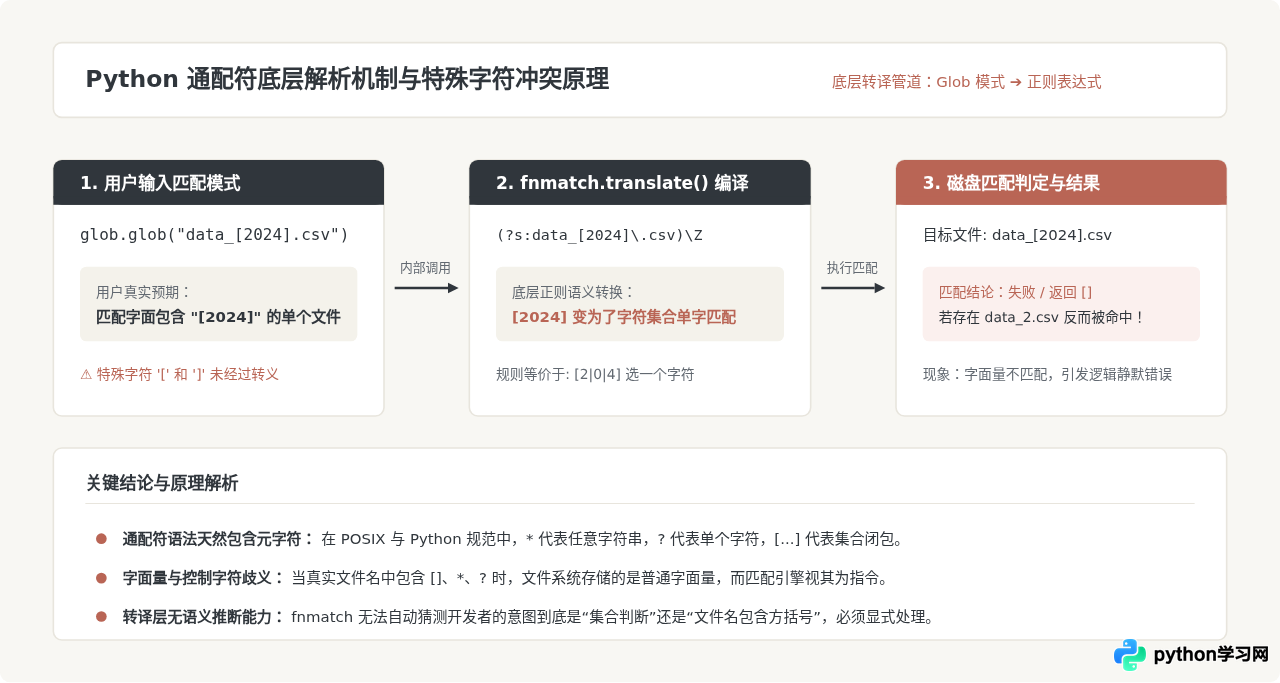
在 Python 标准库中,无论是文件系统层级的 glob.glob()、面向对象的 pathlib.Path.glob(),还是单纯匹配字符串的 fnmatch.fnmatch(),底层均依赖 fnmatch 模块进行模式解析。fnmatch 的工作机制非常明确:它并不直接扫描文件,而是通过 fnmatch.translate() 将类似 Shell 的通配模式翻译为标准的正则表达式字符串,再交由 Python 的 re 模块编译执行。
我们可以通过一段简单的交互代码,直接观察这一转换过程:
import fnmatch

# 观察常规通配符的正则翻译
print(fnmatch.translate("*.txt"))
# 输出示例: (?s:.*\\.txt)\\Z

# 观察包含特殊字符 [2023] 的文件名翻译
print(fnmatch.translate("data_[2023].csv"))
# 输出示例: (?s:data_[2023]\\.csv)\\Z请仔细观察第二行的输出结果:(?s:data_[2023]\\.csv)\\Z。在正则表达式语法中,[2023] 并不表示匹配字面量字符串 "[2023]",而是定义了一个字符集合(Character Set)。该集合表示匹配数字 2、0、3 中的任意单一字符。换言之,该正则只能匹配 data_2.csv、data_0.csv 或 data_3.csv,而当磁盘上真实存在的文件名为 data_[2023].csv 时,正则引擎判定字符不匹配,最终导致 glob 无法找到任何目标。
二、三种最常见的特殊字符失效典型场景与现象
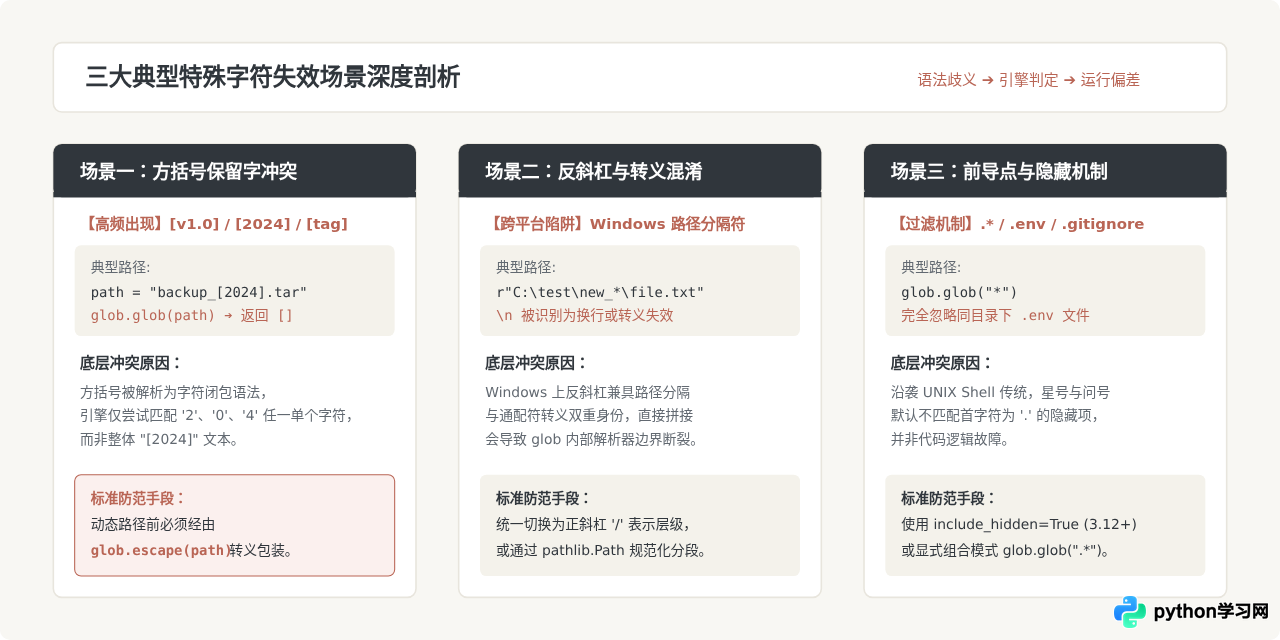
在实际开发与自动化运维中,通配符匹配失效主要集中在以下三个典型场景。理解这些场景的表现,有助于在排查时快速定位故障点。
场景 1:路径与文件名中的方括号([ ])
这是最普遍、最容易被忽视的失效场景。常见于带有版本号、分类标签、日期标签或备份标记的文件命名,例如 report_[v1.0].docx、logs_[2024-05].log 或 [Archive]/data.zip。
- 失效表现: 直接传入包含方括号的路径调用
glob.glob("logs_[2024-05].log"),明明文件在当前目录客观存在,返回值却始终为空列表[]。 - 更隐蔽的次生问题: 如果目录中恰巧存在一个名为
logs_2.log或logs_0.log的历史遗留文件,该文件会被错误命中并纳入后续处理,造成极其危险的数据覆盖或逻辑偏差。
场景 2:跨平台路径中的反斜杠(\)与转义混乱
在 Windows 环境下,系统原生使用反斜杠 \ 作为目录层级分隔符。而在 POSIX 标准及 Python 正则规范中,反斜杠是唯一的转义字符(Escape Character)。
- 失效表现: 当在 Windows 上直接拼接类似
C:\data\new_folder\*.txt的路径时,\n可能被解析为换行符转义;若试图使用\*来匹配字面量星号,在 POSIX 系统下glob会将反斜杠视为转义,但在 Windows 下glob会先将其规范化为路径分隔符,导致转义逻辑完全混乱。 - 典型代码陷阱:
os.path.join("dir", "*name*.txt")在 Windows 下产生dir\*name*.txt,在部分库函数中传入时引发模式断裂。
场景 3:隐藏文件与前导点(.)
在 Linux 和 macOS 等 Unix-like 系统中,以句点 . 开头的文件(如 .env、.gitignore、.config)属于隐藏文件。
- 失效表现: 执行
glob.glob("*")或Path(".").glob("*")时,所有的隐藏配置文件均不会被列出。这虽然是符合 POSIX 传统的保护机制,但当开发者编写打包脚本期望收集“目录下所有文件”时,往往会导致关键环境配置漏打包。 - Python 3.12 之后的特性变化: 在旧版本中需要单独指定
.*模式;Python 3.12 为glob.glob()新增了include_hidden=True参数,未指定时默认依旧忽略隐藏文件。
三、标准排查与彻底修复的实战四步法
解决特殊字符匹配失效问题,不应依赖“碰运气试错”或手动替换字符串,而应遵循标准化工程排查步骤。
第 1 步:定位并识别输入中的保留字元
在匹配逻辑之前,首先检查输入模式中是否混杂了字面量特殊字符。Python 通配符系统中的保留字符包括:[、]、*、?。如果文件名本身包含这些字符,绝对不能直接作为 pattern 传入。
第 2 步:使用 glob.escape() 进行结构化转义
Python 标准库在 glob 模块中提供了一个专门的函数 glob.escape(pathname)。许多开发者只知道 re.escape(),却不知道 glob.escape() 的存在。
glob.escape() 的转义策略非常精妙:它并不是在字符前加反斜杠(因为这在 Windows 下会产生歧义),而是将特殊字符包装进方括号闭包内。例如:
- 字符
[会被转义为[[](表示仅匹配[这个单一字符的集合); - 字符
]会被转义为[]]; - 字符
*会被转义为[*]; - 字符
?会被转义为[?]。
使用示例与效果对比如下:
import glob

raw_dir = "data/[2024_backup]"
file_pattern = "*.csv"

# 错误做法:直接拼接,导致目录中的 [2024_backup] 变为字符集匹配
bad_pattern = f"{raw_dir}/{file_pattern}"
print(glob.glob(bad_pattern))  # 示例输出: []

# 正确做法:对包含特殊字面量的基础目录使用 glob.escape
escaped_dir = glob.escape(raw_dir)
safe_pattern = f"{escaped_dir}/{file_pattern}"
print(f"转义后的模式: {safe_pattern}")
# 打印: data/[[]2024_backup[]]/*.csv
print(glob.glob(safe_pattern))  # 示例输出: ['data/[2024_backup]/records.csv']
第 3 步:适配 pathlib.Path 的处理姿势
现代 Python 代码广泛采用 pathlib。需要特别注意的是:Path 对象没有内置的 escape 方法。如果你直接调用 path.glob("[2024]*.csv"),依然会触发相同的失效问题。
在 pathlib 中处理特殊字符时,标准做法是将 glob.escape 作用于需要字面量保留的模式字符串部分:
from pathlib import Path
import glob

base_folder = Path("storage")
special_prefix = "[core]"

# 通过 glob.escape 将前缀安全转义后再传入 Path.glob()
safe_subpattern = f"{glob.escape(special_prefix)}*.json"
matched_files = list(base_folder.glob(safe_subpattern))
第 4 步:复杂过滤场景降级至 os.scandir() + 正则
当路径中既有极其复杂的特殊符号组合,又有跨平台一致性要求时,试图把所有字符适配进通配符语法往往吃力不讨好。此时最健壮、性能最高的替代方案是直接列出目录条目,并用精准的正则表达式进行过滤:
import os
import re

def find_files_safely(target_dir, regex_pattern):
    compiled_re = re.compile(regex_pattern)
    matched = []
    with os.scandir(target_dir) as entries:
        for entry in entries:
            if entry.is_file() and compiled_re.match(entry.name):
                matched.append(entry.path)
    return matched

# 精确匹配字面量包含 [2024] 的文件,正则中使用 re.escape 转义
prefix = re.escape("[2024]")
pattern = rf"^{prefix}.*\.csv$"
results = find_files_safely(".", pattern)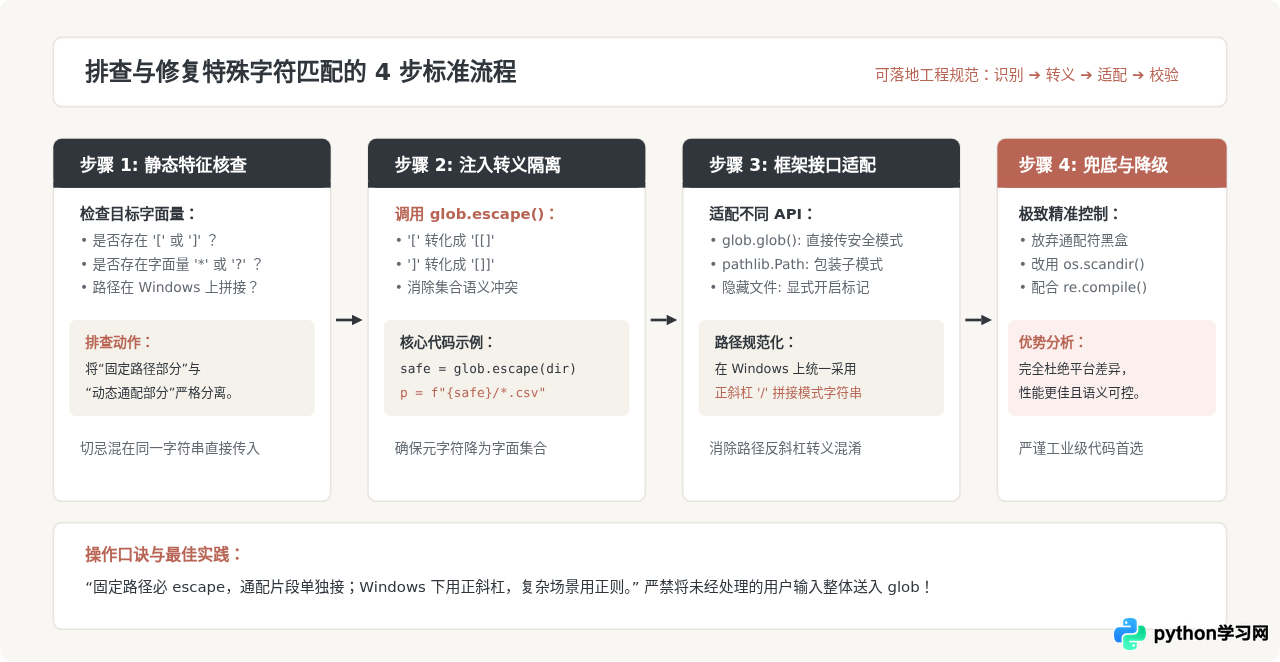
四、最佳实践与方案选型全景对照
在 Python 生态中,完成文件匹配有多种技术路径。面对不同的特殊字符复杂度和系统环境,选择合适的工具可以从根本上规避匹配失效问题。
| 技术方案 | 特殊字符处理方式 | 原生转义 API | 隐藏文件支持 | 适用推荐场景 |
|---|---|---|---|---|
| glob.glob() | 将通配符直接翻译为正则 | glob.escape() |
默认忽略(3.12+ 可开启) | 常规快速脚本、目录已知且通配规则简单的场景。 |
| pathlib.Path.glob() | 面向对象遍历,内部规则同 glob | 无直接方法(需手动 escape 字符串) | 默认忽略 | 现代化工程代码库,强类型路径操作。 |
| fnmatch.fnmatch() | 纯字符串模式匹配,无磁盘 I/O | 无直接转义函数 | 受传入字符串决定 | 已获取文件名列表后的内存级模式过滤。 |
| os.scandir() + re | 完全由正则掌控,语法明确无歧义 | re.escape() |
完全自主可控 | 高并发海量文件扫描、复杂特殊字符及企业级关键任务。 |
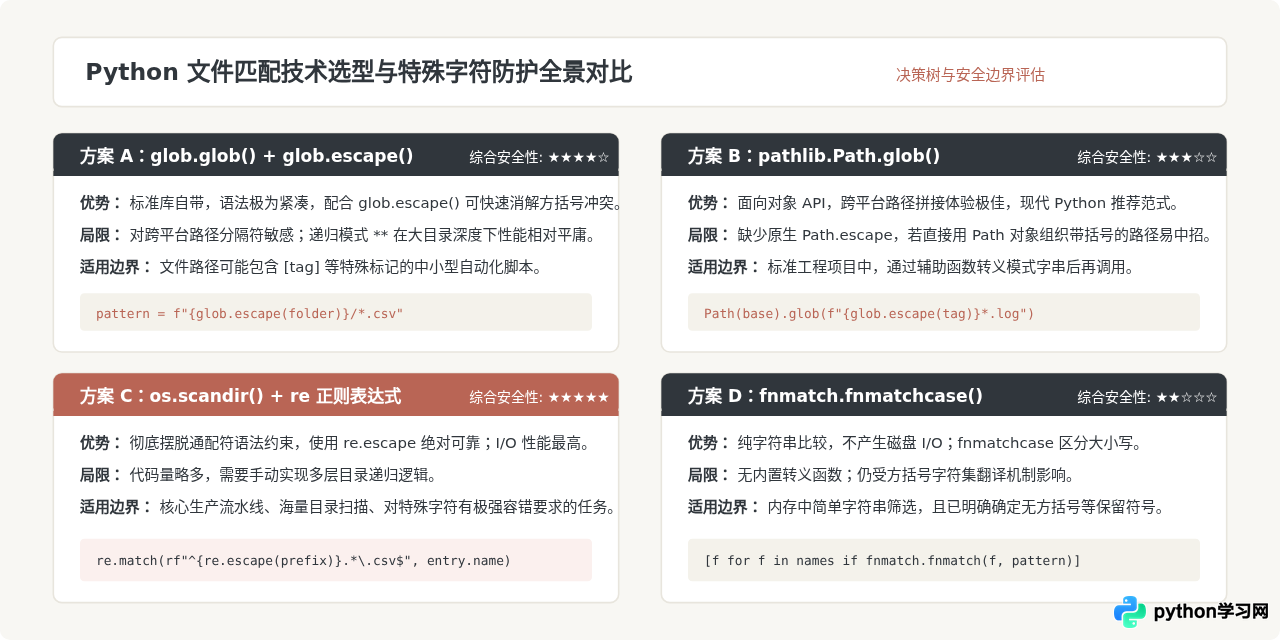
当 Python 通配符匹配出现“明明文件存在却返回空列表”时,请按以下清单逐项自检:
- 查括号: 文件名或目录名中是否存在
[或]?如果存在,必须使用glob.escape()将其包装为[[]和[]]。 - 分路径: 绝对不要对包含
*的完整路径做全局 escape,否则*会被锁死为普通字符导致通配功能丧失。正确的做法是:对“确定路径部分”调用glob.escape(),与“通配符模式”拼接。 - 查斜杠: 在 Windows 平台下编写跨平台代码时,模式字符串内部统一采用正斜杠
/,避免反斜杠在转义与目录分隔之间产生双重解析冲突。 - 核隐藏: 目标文件是否以点
.开头?如果是,检查是否需要显式添加隐藏文件通配规则或配置include_hidden=True。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









