

Python代码注释最佳实践:何时写注释及中文注释规范
深入解析Python代码注释的核心工程实践:系统厘清何时写注释与何时不写,全面掌握PEP 8语法标准、Docstring文档分工,以及中英文混排、盘古之白与标点符号等中文注释规范,提升团队代码可读性与长期维护性。
一、何时写注释与何时不写:划清判断边界
编写注释的第一项修养是克制。许多初学者误以为“注释越多代码越规范”,然而毫无节制的注释往往会带来严重反效果:它不仅增加了阅读时的视觉噪音,还会随着代码演进而迅速脱节,沦为误导维护人员的“注释谎言”。
1. 坚决不写的场景:自解释代码优于注释
如果一段代码可以通过改善变量命名、提取小函数或理顺结构变得清晰明了,那么应该直接重构代码,而不是用注释来为糟糕的代码打补丁。
# ❌ 错误示范:代码本身完全能自解释,注释纯属无意义复述
i = i + 1  # 变量 i 自增 1
users = get_users()  # 获取用户列表

# ❌ 错误示范:用注释解释晦涩的命名,本末倒置
d = 86400  # d 代表一天的秒数

# ✔ 正确做法:重构变量名与结构,让代码自身讲述逻辑(无需任何注释)
SECONDS_PER_DAY = 24 * 60 * 60
active_users = fetch_active_users()
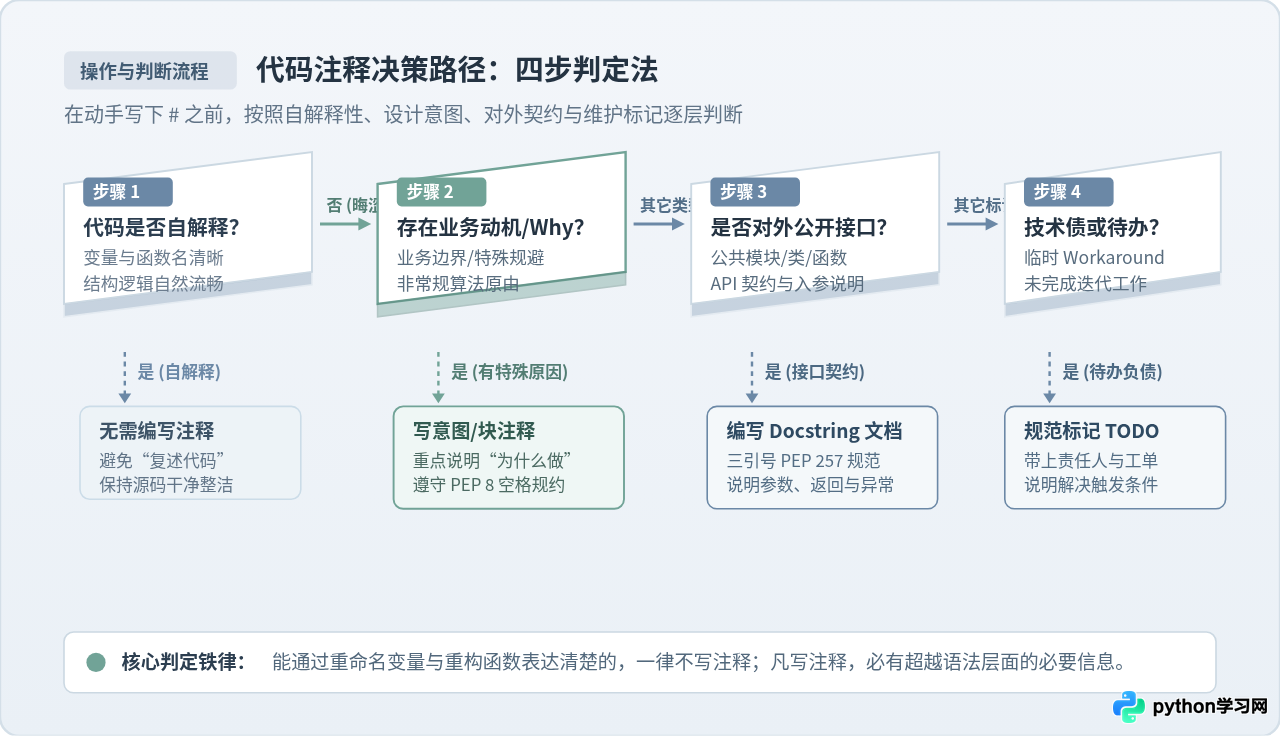
2. 必须编写注释的四大典型场景
只有当代码本身无法完整表达上下文信息时,注释才具有不可替代的价值。以下四类情况应当提供严谨的注释:
- 业务决策与意图解释(Why over What):代码展示了逻辑分支,但无法展示为什么选择这个分支。例如特殊的扣费费率、法定时区结算边界,或者针对特定客户的硬编码逻辑。
- 特殊算法逻辑与非直觉优化:使用了非常规数据结构、位运算技巧或特殊的缓存驱逐策略时,需要说明背后的推导逻辑或性能考量。
- 缺陷绕行(Workaround)与外部依赖适配:由于第三方库的已知 Bug、上游接口的未公开行为或操作系统限制而采取的特殊防御手段,必须写明原因,防止后续维护者因“看似冗余”而误删。
- 技术负债与待办任务(TODO/FIXME):记录尚未完工的功能、临时规避方案或待优化的性能瓶颈,并注明跟踪依据。
二、Python 注释的基础类型与 PEP 8 语法规约
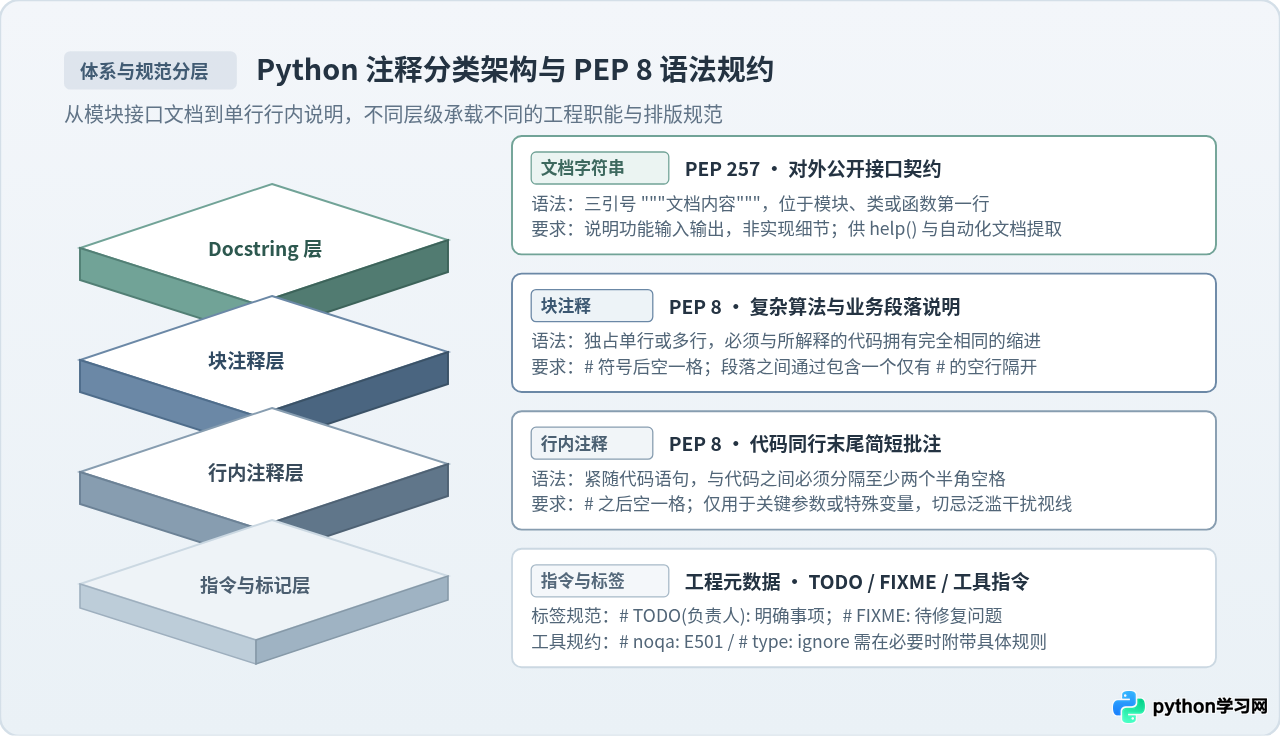
Python 官方代码风格指南 PEP 8 对注释的书写形式有着细致明确的规定。在实际项目中,注释主要分为块注释、行内注释以及文档字符串(Docstring),三者各司其职,不得混淆。
1. 块注释(Block Comments)
块注释通常用于解释紧随其后的整段代码或较为复杂的逻辑分支。PEP 8 规定:
- 块注释必须缩进到与其解释的代码相同的层级。
- 每一行都必须以
#开头,并且#与后续文字之间必须严格保留一个半角空格。 - 如果块注释包含多个段落,段落之间应当使用一个仅包含
#的空行进行分隔,不可直接留完全空白的行。
def process_order_settlement(order):
    # 根据财务对账规则,跨月订单必须按照原始创建日期的汇率结算。
    #
    # 如果结算日当天汇率波动超过 5%,则触发风控阻断,转入人工审核队列,
    # 避免因汇率骤变引发账目亏损。
    if order.is_cross_month:
        exchange_rate = get_historical_rate(order.created_at)
        validate_exchange_rate_fluctuation(exchange_rate)
        execute_settlement(order, exchange_rate)
2. 行内注释(Inline Comments)
行内注释位于代码语句的同一行末尾。行内注释极易导致代码行过长并分散注意力,因此应尽量少用。如果必须使用,PEP 8 明确给出了两条排版底线:
- 代码语句与
#之间必须间隔至少两个半角空格。 #符号与后面的注释文字之间必须有一个半角空格。
# ❌ 错误示范:与代码紧贴,缺乏足够间隔,影响行内阅读
threshold = 0.85# 设置匹配阈值

# ✔ 正确示范:与代码保持至少两个空格,# 后空一格,说明数值来源
threshold = 0.85  # 经过压测确定的最优召回率平衡点,避免误判率过高
3. 文档字符串(Docstrings)与注释的本质区别
许多开发者常把三引号文档字符串与多行注释混为一谈。按照 PEP 257 规范,文档字符串用于描述模块、类、公共函数或方法的外部接口契约(功能概述、参数类型与含义、返回值及可能抛出的异常),它会在运行时被编译器编译进对象的 __doc__ 属性中,供内置 help() 函数或 Sphinx 等工具提取。而以 # 开头的普通注释则是给阅读源码的维护人员看的,用于解释内部实现细节。
三、中文注释专项排版与书写规范
在以中文为母语的开发团队中,中文注释的排版质量直接影响整个代码库的整洁度和阅读舒适度。混杂的标点、中英紧贴的文字以及模糊的术语不仅破坏版面呼吸感,还会增加认知负担。
1. 落实“盘古之白”:中英文与数字间的空格规范
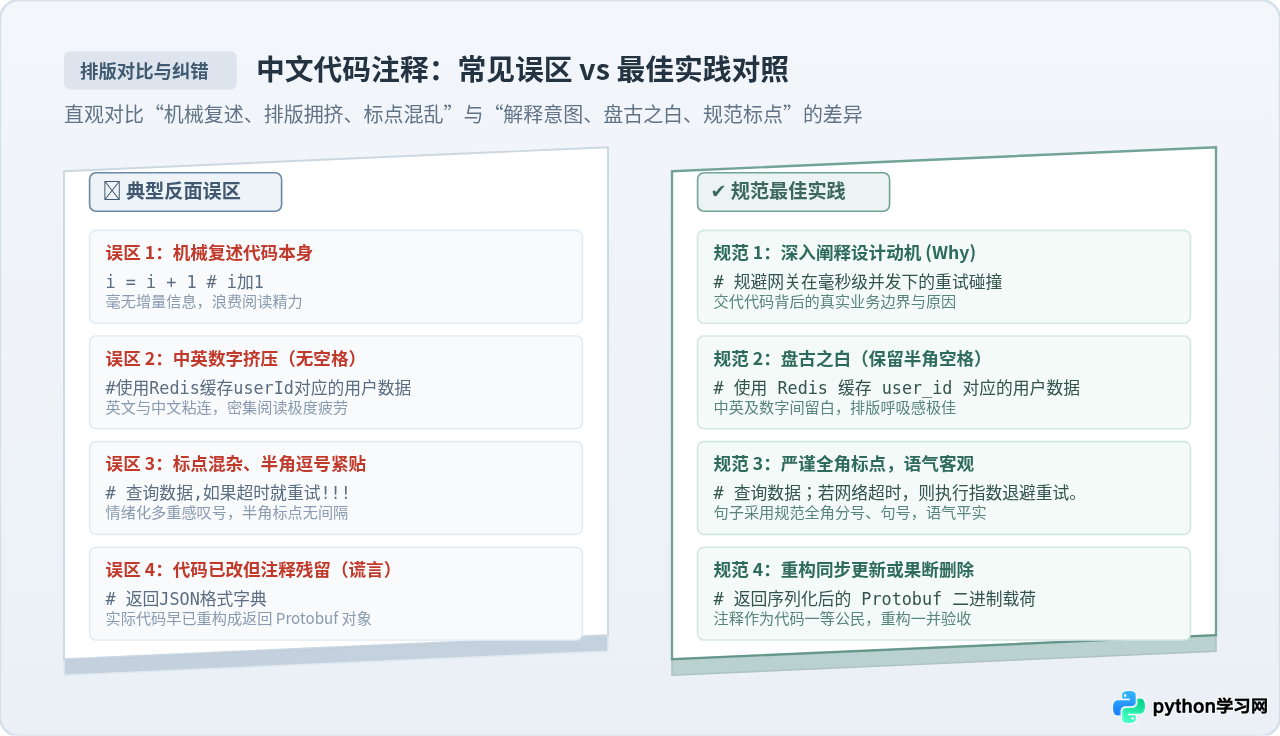
中文全角字符与英文、数字半角字符的字形结构不同。如果在中文与英文、数字之间不留间隙,文字就会在视觉上紧紧粘连,极难辨识。中文排版中公认的“盘古之白”规则要求:在汉字与半角英文字母、数字之间,必须保留一个半角空格。
# ❌ 错误示范:中英文字符、数字紧密粘连,视觉逼仄
#使用Redis对userId进行5分钟缓存,避免并发打垮MySQL数据库

# ✔ 正确示范:落实盘古之白,中英文与数字间留出呼吸感
# 使用 Redis 对 user_id 进行 5 分钟缓存,避免并发流量击穿 MySQL 数据库
需要特别注意的是,代码中的变量名、属性名或函数名如果在注释中出现,应当保持与代码完全一致的大小写或下划线命名(例如 user_id 而不是 userId),并在两侧自然留出空格。
2. 标点符号使用标准:全角为主,杜绝混杂
中文注释的自然语言部分应当严格采用全角标点符号,避免出现半角标点贴在汉字后面造成的紧缩变形:
- 逗号与分号:使用中文全角逗号“,”与分号“;”,严禁使用半角逗号“,”直接跟汉字。
- 句号规则:如果注释是一个完整的长句子,末尾必须带有全角句号“。”;如果注释仅是一个简短的短语或短语词组(如行内补充批注),末尾不加句号。
- 语气客观平实:技术注释要求冷静、客观,避免在注释中使用“!”、“!!”等多重感叹号,更不要在注释中宣泄情绪或写调侃性用语。
3. 专有名词与术语表述
行业通用的技术术语(如 API, Token, Worker, Schema, Payload, Mock 等)应当直接保留英文原称,切忌强行直译为生僻或生硬的中文词汇。同时,必须严格遵守官方专有名词的标准大小写(如 GitHub、MySQL、macOS、PostgreSQL、Python),不得随意拼写为 github、mysql 等。
四、团队工程维护与注释防腐体系
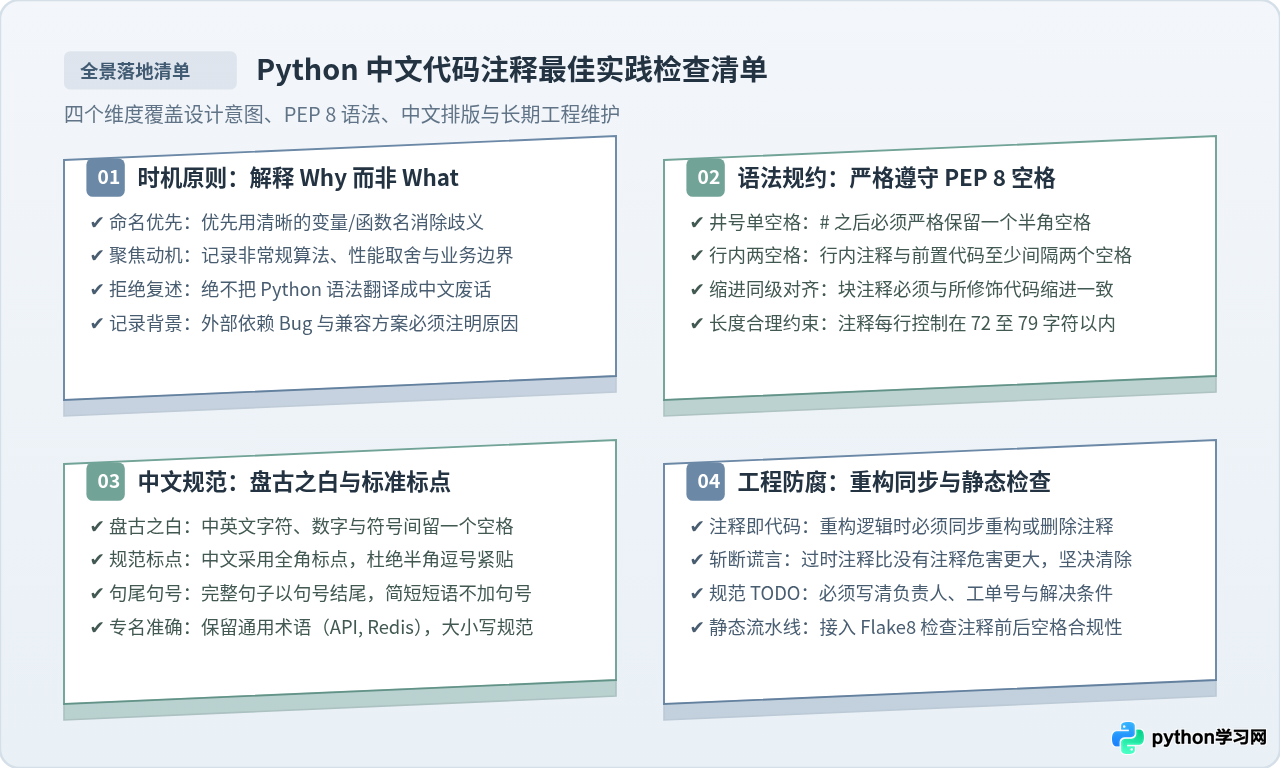
编写出高质量的注释只是第一步,在长期的团队迭代中保持注释的时效性与准确性才是工程落地的关键挑战。未经维护的过时注释比缺少注释更具破坏性。
1. 坚决清除“注释谎言”:重构即同步
在敏捷迭代中,开发者常常只改动了函数体内的逻辑代码,却遗忘了函数上方的注释。随着版本更迭,注释描述的行为与真实代码背道而驰。团队必须建立“注释是代码一等公民”的共识:在 Code Review 阶段,检查注释是否与代码变动完全匹配是必过的检查项。如果某段注释在重构后已经失去意义,应毫不犹豫地将其删除。
2. 规范化 TODO 与 FIXME 标记
随手写下的 # TODO: 待优化 往往沉寂数年无人问津。团队内应当规范技术负债标记的格式,通常必须包含三项要素:责任人、跟踪依据(如 Jira 工单号或 Issue ID)以及明确触发改动的条件:
# ✔ 规范的待办标记:包含责任人、跟踪工单与触发条件
# TODO(zhangsan, #PROJ-1024): 当下游升级至 API v2.0 后,移除此兼容性适配器
3. 引入静态自动化检查
人工记忆规范往往存在疏漏,建议在团队的 CI/CD 流水线中引入静态代码检查工具:
- 利用
flake8检查E262(行内注释缺少空格)、E265(注释 # 后面缺少空格)等规则。 - 利用
pylint检查模块及公共函数的 Docstring 完整性。 - 配合 Git Pre-commit Hook,确保所有入库代码的注释格式在本地提交时即达到工程标准。
五、总结:注释的度量衡
衡量一段代码注释优劣的标准非常简单:当一位新加入项目的成员或半年后的你自己重读这段代码时,是否能够通过代码看懂执行过程,并通过注释立刻理解背后的设计意图与历史取舍。
克制地动笔,先优化命名与结构;必须书写时直奔核心意图,清晰说明 Why;严格遵循 PEP 8 的空格约束,并以舒展大方的盘古之白与规范中文标点排版。让每一行注释都真正成为项目资产,而非历史包袱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









