

怎么通过__getitem__和__len__自定义Python序列类型
本文详细讲解如何在Python中通过实现__len__和__getitem__魔术方法自定义不可变序列类型。包含序列协议底层原理、负索引与切片计算规范、代码示例以及与单方法实现的差异对比。
在 Python 中,让一个自定义类表现得像内置列表(list)或元组(tuple)那样支持下标访问、求长度与循环遍历,核心方法就是实现 __len__ 与 __getitem__ 两个特殊魔术方法。得益于 Python 的“鸭子类型”(Duck Typing)机制,你的类无需继承任何标准基类,只要按规范交付这两个方法,解释器就会将其认定为合法的不可变序列(Immutable Sequence),自动赋予索引查找、切片操作、for 循环迭代、in 包含检测以及 reversed() 逆序处理等全部语言特权。
一、Python 序列协议的运作原理
在 Python 数据模型(Data Model)中,序列协议是由一组约定好的特殊方法构成的非正式接口。要实现一个最小可用的不可变序列类型,必须满足两项核心契约:
__len__(self)契约:必须返回一个非负整数,代表序列中元素的总数。该方法直接响应外部的len(obj)调用。若序列未显式定义__bool__,Python 会在真值测试中调用__len__,当长度大于 0 时判定为真,为 0 时判定为假。__getitem__(self, index)契约:必须能够根据传入的index返回对应的序列项。如果传入的索引超出合法范围,必须抛出标准的IndexError;如果传入的索引类型既不是整数也不是切片对象,必须抛出TypeError。
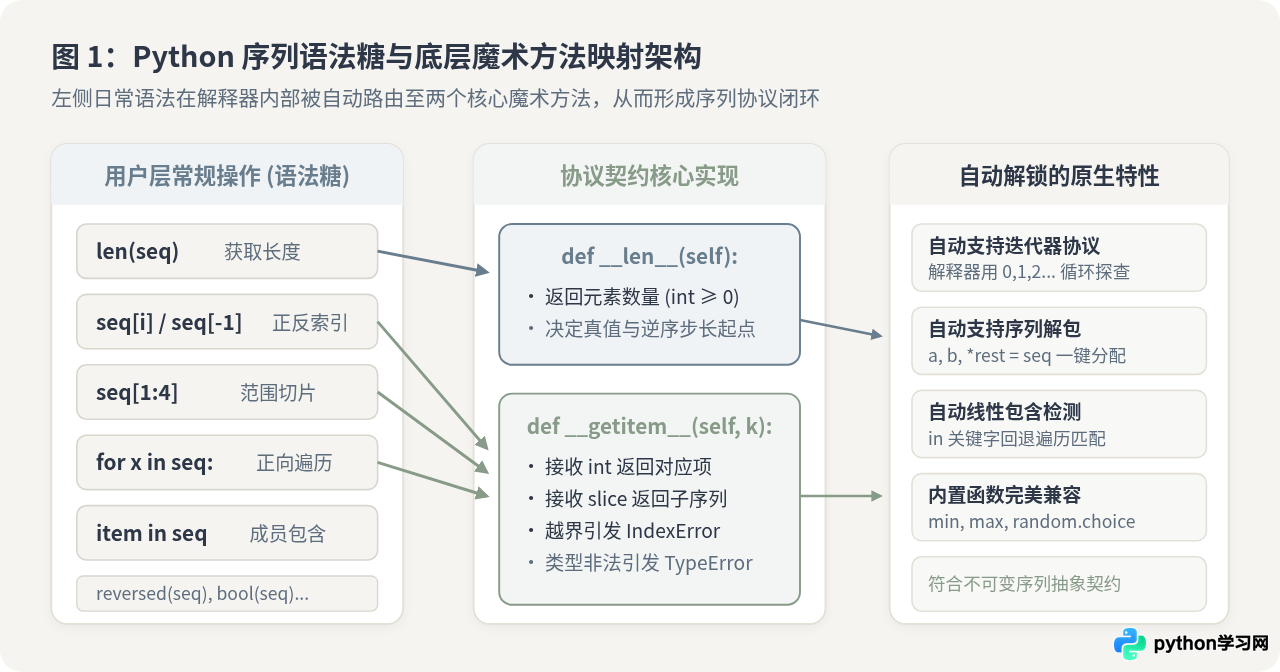
如上图所示,当在代码中使用 for item in seq 遍历一个没有实现 __iter__ 方法的对象时,Python 解释器会自动触发序列回退机制:从整数索引 0 开始,依次调用 __getitem__(0)、__getitem__(1)……直到 __getitem__ 抛出 IndexError,解释器捕获此异常并将其转化为 StopIteration,平稳结束循环。这也是为什么越界时必须抛出 IndexError 而非返回 None 的原因——如果返回 None,for 循环将无法感知终止边界,导致陷入死循环。
二、编写最小可用序列:代理内置容器
最直接的自定义序列方式是在内部持有一个内置列表或元组,并将长度与元素访问请求委托给内部容器。以下是一个保存扑克牌组的不可变序列示例:
import collections

Card = collections.namedtuple('Card', ['rank', 'suit'])

class FrenchDeck:
    ranks = [str(n) for n in range(2, 11)] + list('JQKA')
    suits = ['黑桃', '红心', '梅花', '方块']

    def __init__(self):
        # 在内存中构造扑克牌列表
        self._cards = [Card(rank, suit) for suit in self.suits
                                        for rank in self.ranks]

    def __len__(self):
        # 满足序列协议:返回元素总数
        return len(self._cards)

    def __getitem__(self, position):
        # 委托给内部 list:自动继承负索引与切片能力
        return self._cards[position]
在这个例子中,只需编写两个特殊方法,该类立刻具备了丰富的语言特性:
# 实例化扑克牌序列
deck = FrenchDeck()

# 1. 响应 len()
print(f"牌组总数: {len(deck)}")

# 2. 支持正负索引与切片
print(f"第一张牌: {deck[0]}")
print(f"最后一张: {deck[-1]}")
print(f"前三张牌: {deck[:3]}")

# 3. 支持 for 循环与 random.choice
import random
print(f"随机抽牌: {random.choice(deck)}")
print(f"包含检测: {Card('A', '黑桃') in deck}")
第一张牌: Card(rank='2', suit='黑桃')
最后一张: Card(rank='A', suit='方块')
前三张牌: [Card(rank='2', suit='黑桃'), Card(rank='3', suit='黑桃'), Card(rank='4', suit='黑桃')]
随机抽牌: Card(rank='7', suit='红心')
包含检测: True
三、深层把控:严谨处理负索引、切片与类型校验
当自定义序列并非简单代理已有列表,而是按需动态生成数据(例如惰性数学序列、磁盘分页数据或矩阵结构)时,我们不能直接依赖外部列表的切片机制。此时,必须在 __getitem__ 内部显式解析传入的参数。
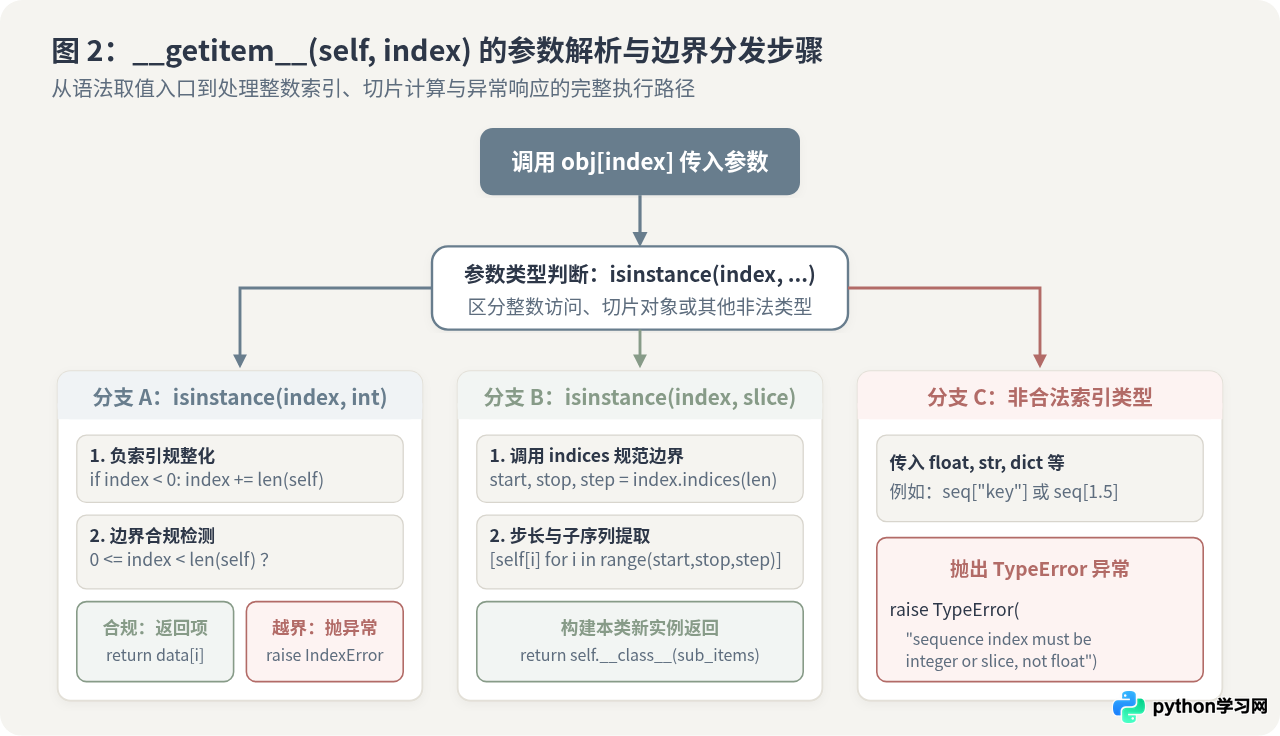
在处理更严谨的自定义序列时,需要遵循以下 3 个关键步骤:
- 区分整数与切片类型:使用
isinstance(index, int)与isinstance(index, slice)进行类型判断。如果传入既非整数也非切片,主动抛出TypeError。 - 整数索引规整与越界检查:如果
index < 0,必须将其转换为非负索引:index += len(self)。若计算后仍小于 0 或大于等于序列总长度,立即抛出IndexError("序列索引越界")。 - 切片对象标准化(
slice.indices()):Python 内置的slice对象提供了一个原生方法slice.indices(len)。它能自动处理负步长、省略的None以及超大边界,计算出完全符合 Python 规范的(start, stop, step)三元组。
以下是一个动态计算等差数列的完整实现,展示了如何在不依赖内置列表切片的情况下完整支撑标准序列操作:
class ArithmeticSequence:
    """无需存储全部数据的只读等差数列自定义序列"""
    def __init__(self, start, step, length):
        if length < 0:
            raise ValueError("序列长度不能为负数")
        self._start = start
        self._step = step
        self._len = length

    def __len__(self):
        return self._len

    def __getitem__(self, index):
        if isinstance(index, int):
            # 1. 负索引规整化
            if index < 0:
                index += self._len
            # 2. 边界合规校验
            if index < 0 or index >= self._len:
                raise IndexError("ArithmeticSequence 索引超出范围")
            # 动态即时计算元素
            return self._start + index * self._step

        elif isinstance(index, slice):
            # 3. 使用 slice.indices 标准化切片区间
            start, stop, step = index.indices(self._len)
            # 按照切片参数动态构造子序列并返回本类实例
            sliced_items = [self[i] for i in range(start, stop, step)]
            return sliced_items

        else:
            raise TypeError(
                f"序列索引必须是整数或切片,不能是 {type(index).__name__}"
            )

    def __repr__(self):
        return f"ArithmeticSequence(start={self._start}, step={self._step}, len={self._len})"
self.__class__(...));若为了通用性与轻量化,也可以像上述代码一样返回 Python 原生列表。切忌直接返回内部未受保护的数据引用。
四、关键差异分析:仅实现 __getitem__ 对比同时实现两者
不少初学者会发现,仅仅实现 __getitem__ 且不定义 __len__ 时,对象依然能够执行下标索引和 for 循环。但在严谨的工程实践中,这两种做法在行为一致性与语义契约上存在本质差异。
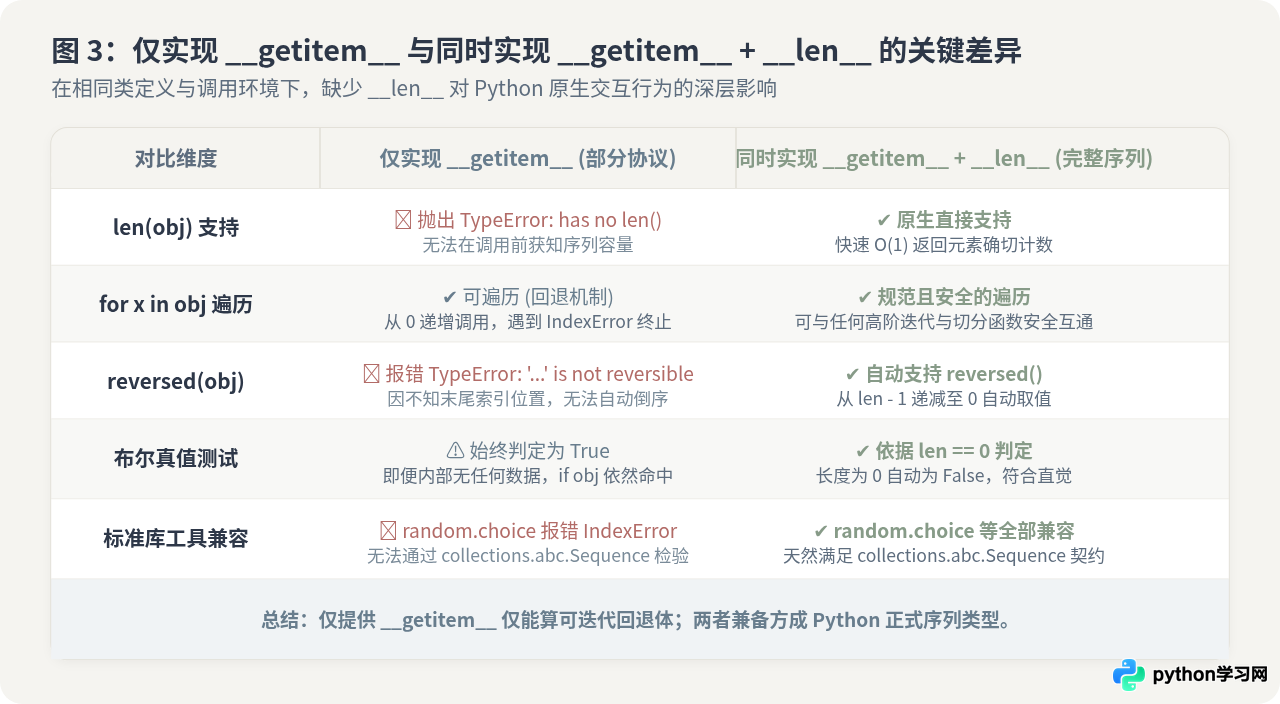
| 特性行为 | 仅实现 __getitem__ |
同时实现 __getitem__ 与 __len__ |
|---|---|---|
| 协议归属 | 仅构成可迭代回退对象(Iterable Fallback) | 正式契合不可变序列协议(Immutable Sequence) |
len(obj) 求长 |
直接崩溃:抛出 TypeError: object has no len() |
原生支持:O(1) 获取当前序列真实大小 |
反向迭代 reversed() |
崩溃:报 TypeError: '...' object is not reversible |
原生支持:解释器从 len - 1 递减逐个取项 |
布尔真值测试 bool(obj) |
恒为 True(即便序列内部没有任何元素) |
依据 len(obj) > 0 判定,空序列正确判定为 False |
| 标准库工具协作 | random.choice(obj) 无法运行,抛出错误 |
与标准库所有序列工具与泛型算法无缝兼容 |
| 抽象基类检测 | 无法被认定为序列结构 | 满足 collections.abc.Sequence 契约要求 |
这种差异之所以关键,是因为缺少 __len__ 会在隐式逻辑中埋下隐患。例如,很多业务代码依赖 if not seq: 来判断序列是否为空;若只实现了 __getitem__,哪怕序列是空的,该条件判断也永远无法成立。因此,定义严谨的序列类型时,必须成对提供 __len__ 与 __getitem__。
五、进阶实践:继承 collections.abc.Sequence
虽然通过鸭子类型我们已经拥有了序列的核心功能,但在生产环境中,更推荐的做法是继承标准库的抽象基类 collections.abc.Sequence。
from collections.abc import Sequence

class ColorPalette(Sequence):
    """继承 Sequence 抽象基类的调色板不可变序列"""
    def __init__(self, colors):
        self._colors = tuple(colors)

    def __len__(self):
        return len(self._colors)

    def __getitem__(self, index):
        return self._colors[index]
继承 Sequence 抽象基类的价值主要体现在两点:
- 接口强制保证:如果忘记编写
__len__或__getitem__,在类实例化时就会直接报错,防止残缺对象流入运行时。 - 免费混入方法(Mixin Methods):抽象基类会自动基于这两个方法提供高度优化的
count()、index()、__contains__()以及__reversed__()方法,无需手动实现即可直接调用。
六、知识梳理与核心要点总结
为便于随时查阅与复用,下方的总结图谱系统性地归纳了自定义序列的四层结构:
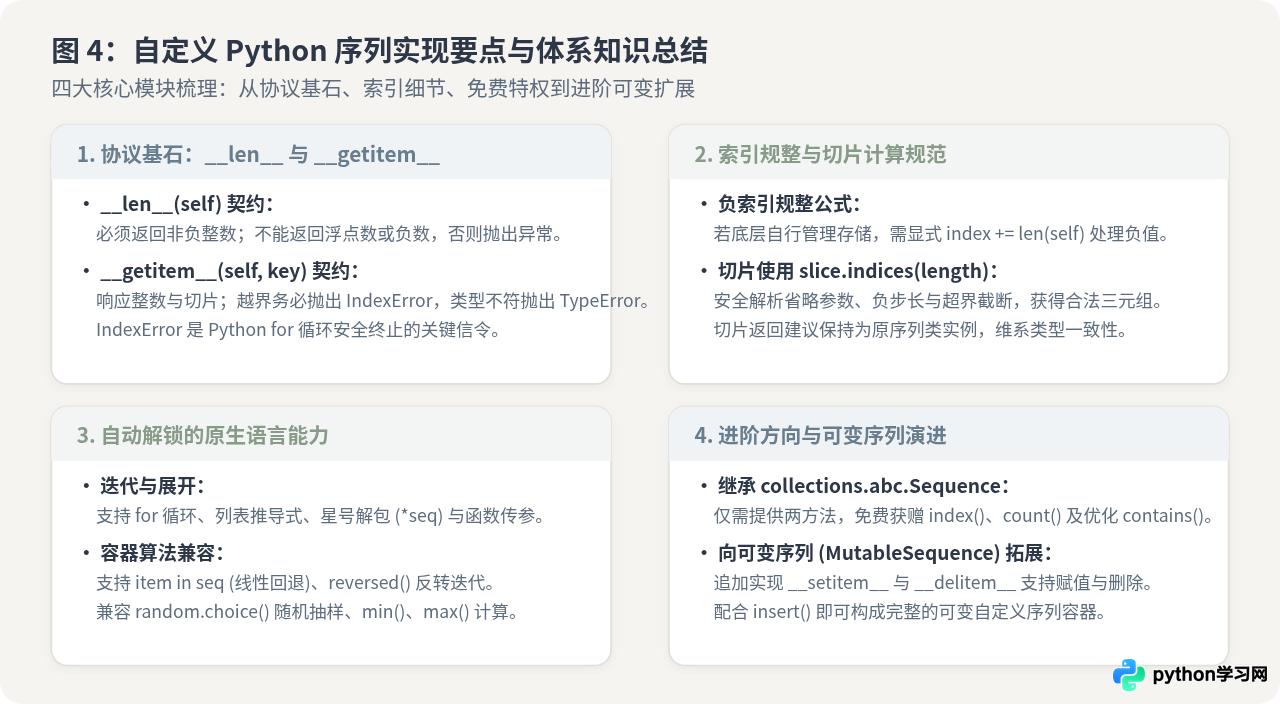
通过本文的讲解与实践,可以得出自定义 Python 序列的清晰路径:
- 确立协议:始终同时实现
__len__与__getitem__,保证对象在取长、索引、切片、反转及真值测试中的一致性。 - 防御边界:索引越界时务必严格抛出
IndexError,这是驱动for循环正常终止的信号基石;切片计算推荐使用slice.indices()。 - 进阶选型:只读序列优先继承
collections.abc.Sequence获得现成的常用算法;如需支持元素修改与删除(可变序列),则进一步补全__setitem__与__delitem__。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









