

Python用csv模块读取文件并转为列表
详细讲解在Python中使用内置csv模块读取CSV文件并转换为列表的方法,涵盖基础读取、表头分离、类型转换、换行符与编码处理等实用操作与常见问题排查。
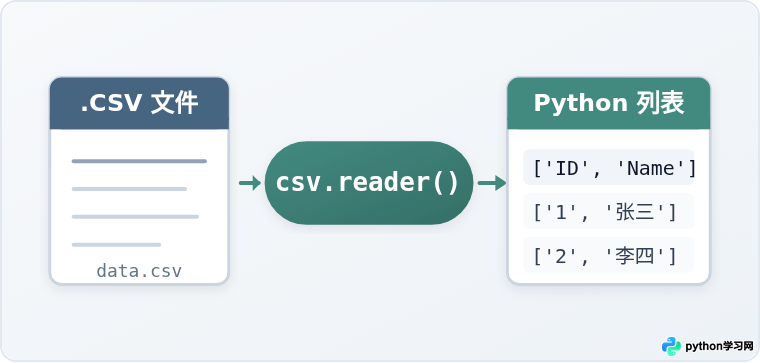
在 Python 中,使用内置的标准库 csv 模块读取 CSV 文件并转为列表,最直接的方法是使用内置函数 open() 打开目标文件,通过 csv.reader() 创建一个可迭代的解析器对象,然后将其作为参数传入内置函数 list() 中。只需两至三行核心代码,就能把磁盘上的纯文本逗号分隔文件完整加载为 Python 内存中的二维嵌套列表(包含由每行字段构成的子列表)。
一、快速实现:核心三步转换法
处理 CSV 文件时无需安装任何第三方库。Python 标准库自带的 csv 模块专门用于解析和生成逗号分隔值数据。以下是最基础、最直观的实现代码:
import csv

# 使用 with 语句保证文件使用完毕后安全关闭
with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    data_list = list(reader)

print(data_list)
假设项目根目录下存在一个名为 data.csv 的文本文件,内容如下:
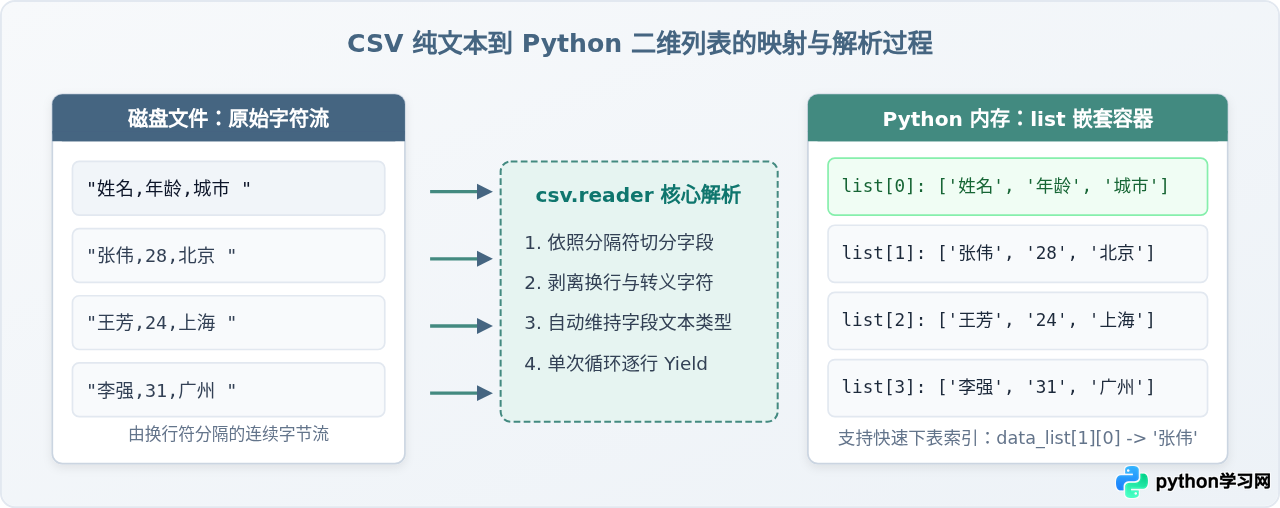
姓名,年龄,城市
张伟,28,北京
王芳,24,上海
李强,31,广州
执行上述 Python 脚本后,终端打印的 data_list 结构如下:
[['姓名', '年龄', '城市'], ['张伟', '28', '北京'], ['王芳', '24', '上海'], ['李强', '31', '广州']]
从输出结果可以看出,外层容器是一个由方括号包裹的标准 Python 列表,其中的每个元素也是一个列表,对应原 CSV 文本中的一行;每行中的单元格字段均被提取为独立的字符串。
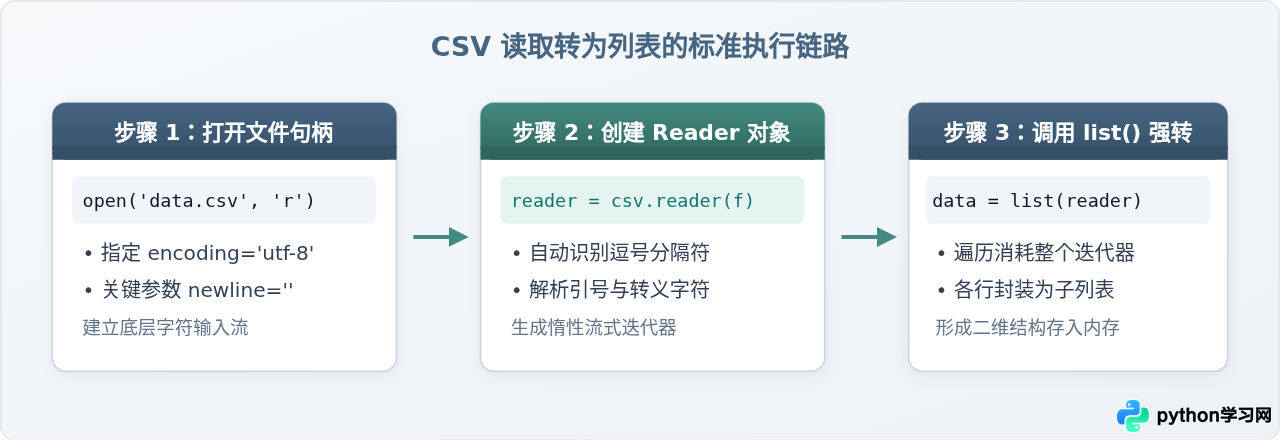
二、深入机制:csv.reader 与 list() 是如何协同工作的
许多初学者在使用 csv.reader() 时容易产生一个误区,认为 csv.reader(f) 返回的就是一个列表。实际上,在 Python 中直接打印 reader,控制台输出通常是类似 <_csv.reader object at 0x...> 的对象信息,并不能直接查看数据内容。
这是因为 csv.reader 在底层被设计为一个迭代器(Iterator)。它的优势在于“按需惰性读取”:当使用 for row in reader: 遍历时,Python 只会在循环推进时才从磁盘加载并解析下一行,而不会一次性把整个庞大的文件全部灌入内存。这保证了在读取数十万行数据时内存占用始终处于极低水平。
而当我们明确需要得到一个完整的列表结构时,调用内置函数 list(reader) 会立即启动对该迭代器的遍历,一直读到文件末尾(EOF),并将每一行解析出的字段列表依次追加到一个新的大列表中。最终得到的对象是一个独立的 list 类型容器,支持通过下标进行切片、索引和二次排序。
三、实用场景:表头与数据分离
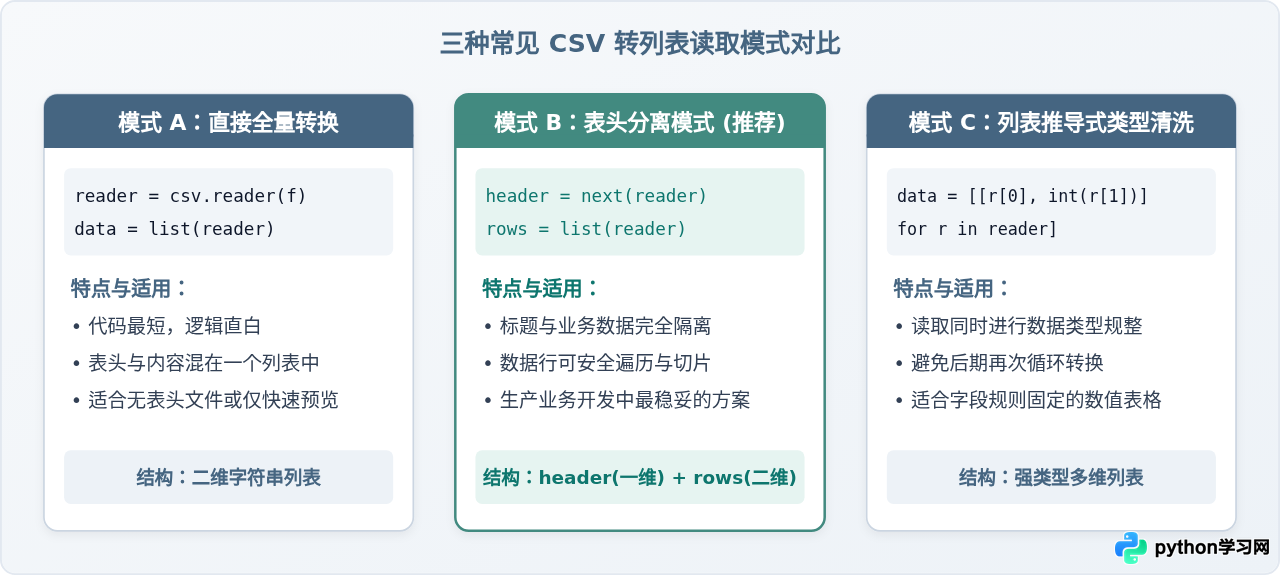
绝大多数 CSV 文件的第一行都是字段标题(如列名)。如果直接调用 list(reader),第一行表头也会被作为普通元素包含在数据列表中。当需要对数据做统计、排序或计算时,表头行会导致类型错误或逻辑混乱。
解决这个问题的最标准做法是利用 Python 迭代器的特性:在调用 list(reader) 之前,先使用 next() 函数将迭代器向前推进一次,把第一行单独提取出来:
import csv

with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)

    # 1. 提取并分离首行表头
    header = next(reader)

    # 2. 剩余行继续转为纯数据列表
    rows = list(reader)

print("表头列表:", header)
print("纯数据列表:", rows)表头列表: ['姓名', '年龄', '城市'] 纯数据列表: [['张伟', '28', '北京'], ['王芳', '24', '上海'], ['李强', '31', '广州']]
因为 reader 会记住当前的迭代游标位置,在执行 next(reader) 后,游标已经指向了第二行。后续紧接着执行 list(reader) 时,只会收集剩下的数据行,从而优雅地实现了表头与正文的分离。
四、关键细节与参数设置
使用 csv 模块读取文件并转为列表看似简单,但在不同操作系统和实际业务文件中,如果不注意以下两项参数设置,极易出现隐蔽的 Bug。
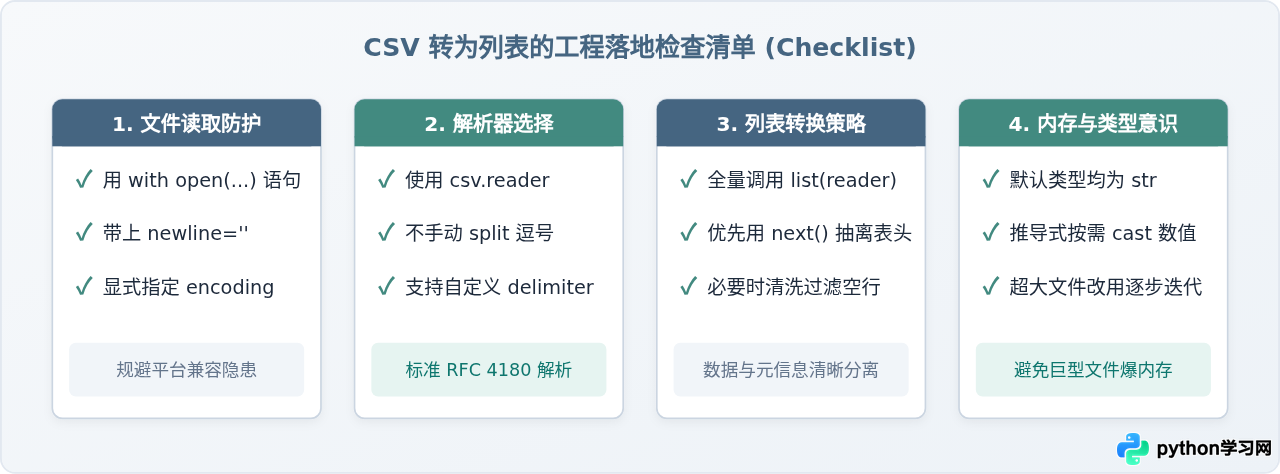
1. 为什么 open() 必须指定 newline=''
在 Python 3 中打开 CSV 文件时,官方文档明确要求传入 newline=''。这是因为不同的操作系统具有不同的换行习惯(Windows 使用
,Linux/macOS 使用
)。
Python 的 open() 默认会开启通用换行转换(Universal Newlines),将
自动转为
。但 csv 模块内部自带严格的换行与引号识别算法。如果不加 newline='',某些包含换行符的多行单元格内容就会被外部 open() 提前分割,导致字段解析错位;在 Windows 系统下读写甚至可能产生偶发空行。因此,始终保持 newline='' 是编写健壮代码的通用法则。
2. 显式指定字符编码 encoding='utf-8'
在未指定编码时,Python 将使用系统的默认编码(Windows 中多为 GBK,而在 Linux/macOS 中为 UTF-8)。当处理包含中文字符的 CSV 文件时,一旦编码不匹配就会直接抛出 UnicodeDecodeError: 'gbk' codec can't decode byte... 异常。推荐在打开文件时显式声明 encoding='utf-8';如果文件是由 Windows 上的 Microsoft Excel 导出的,通常需要指定为 encoding='utf-8-sig'(用于自动剔除文件开头的 UTF-8 BOM 标记)。
五、进阶处理:在转为列表时完成数据类型转换
使用 csv.reader 读取出来的所有单元格数据,在默认情况下全部都是字符串(str)类型。即使 CSV 文件中写的是纯数字 28、99.5,读入后也是 '28' 和 '99.5'。
如果直接使用字符串进行加减计算或排序,会出现例如 '100' < '20' 的字典序逻辑错误。借助 Python 的列表推导式(List Comprehension),我们可以在消耗 reader 迭代器的同时完成数据类型的精准清洗:
import csv

with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.reader(f)
    header = next(reader)  # 跳过表头

    # 在转为列表的同时,将第 2 列(年龄)转为 int 整数
    cleaned_data = [
        [row[0], int(row[1]), row[2]]
        for row in reader
    ]

print("清洗转换后的数据列表:")
print(cleaned_data)清洗转换后的数据列表: [['张伟', 28, '北京'], ['王芳', 24, '上海'], ['李强', 31, '广州']]
可以看到,转换后的子列表中,第二项已经从包含引号的 '28' 变为了纯整数 28,后续可以直接用于数值计算、统计平均值或按年龄大小排序。
六、常见问题排查与注意事项
在实际项目中读取 CSV 文件并转为列表时,可能会遇到以下几类常见边界情况:
| 常见现象 / 报错 | 根本原因 | 针对性解决办法 |
|---|---|---|
| FileNotFoundError | 相对路径解析与当前工作目录不一致,或者文件名拼写有误。 | 使用绝对路径,或通过 os.path.join(os.path.dirname(__file__), 'data.csv') 动态锚定脚本所在路径。 |
| UnicodeDecodeError | 文件实际编码与 open() 中指定的编码不一致(如 GBK 文件按 UTF-8 读取)。 |
尝试切换为 encoding='gbk' 或 encoding='utf-8-sig'。 |
列表中出现空子列表 [] |
CSV 文件末尾存在多余的空白空行,被解析为一个没有字段的空列表。 | 使用推导式过滤空行:[row for row in reader if row]。 |
| 字段中包含逗号被错误切分 | 手动使用 line.split(',') 代替了标准库模块,破坏了引号包围规则。 |
坚决使用 csv.reader(),其遵循 RFC 4180 标准,会自动将 "12,000" 解析为一个完整字段。 |
七、完整参考代码
综合上述讨论,以下是一段包含表头分离、编码保护、空行过滤和异常保护的完整生产级封装函数,可以直接作为日常工作中的模板使用:
import csv
from typing import Tuple, List

def read_csv_to_list(filepath: str, encoding: str = 'utf-8') -> Tuple[List[str], List[List[str]]]:
    """
    读取 CSV 文件并转换为表头列表与数据二维列表。

    :param filepath: CSV 文件的本地绝对路径或相对路径
    :param encoding: 文件编码,默认为 'utf-8',若为 Excel 导出文件可传 'utf-8-sig'
    :return: (header_list, data_rows_list)
    """
    with open(filepath, mode='r', encoding=encoding, newline='') as f:
        reader = csv.reader(f)

        # 尝试分离表头,若为空文件则优雅返回
        try:
            header = next(reader)
        except StopIteration:
            return [], []

        # 转换数据行,并自动剔除末尾可能存在的空白行
        rows = [row for row in reader if row]

    return header, rows

# 使用示例
if __name__ == '__main__':
    headers, records = read_csv_to_list('data.csv')
    print("解析完成:")
    print(f"列信息 ({len(headers)} 列):", headers)
    print(f"总记录数: {len(records)} 行")
print("前两条数据样例:", records[:2])解析完成: 列信息 (3 列): ['姓名', '年龄', '城市'] 总记录数: 3 行 前两条数据样例: [['张伟', '28', '北京'], ['王芳', '24', '上海']]
通过这种结构,文件在 with 代码块退出后会自动释放系统资源,返回的 records 是原生的嵌套 Python 列表,既能直接进行切片和修改,也可以随时接入后续的数据分析或持久化处理流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









