

Python中单下划线和双下划线的含义与用法区别
深入解析Python中单下划线与双下划线的核心差异:从PEP 8弱私有约定、通配符导入控制,到解释器底层名称修饰(Name Mangling)机制与内置魔法方法规范,助你写出地道且健壮的Python代码。
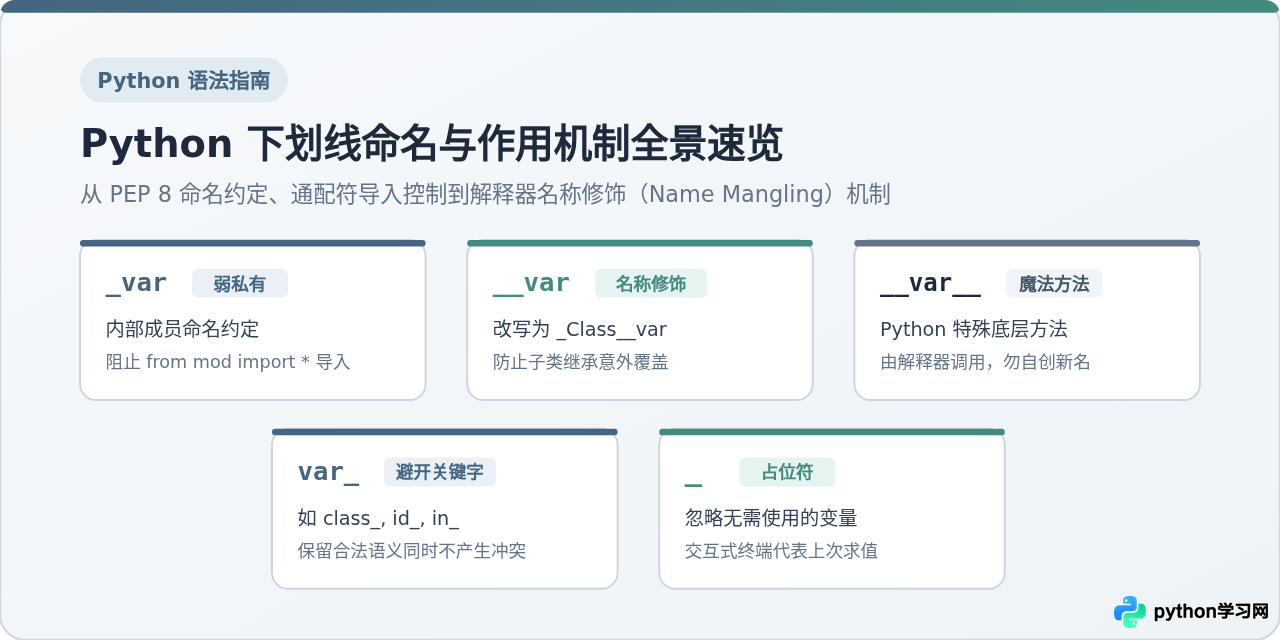
_name)属于弱私有约定,主要作为面向开发者的内部使用提示,并在模块通配符导入(from module import *)时主动被排除,但外部依然可以直接读写;双前导下划线(如 __name)则会触发解释器的名称修饰(Name Mangling)机制,将其自动改写为 _ClassName__name,其核心初衷是防止子类在继承时意外覆盖父类的同名属性,而非作为严格的访问权限控制;而首尾双下划线(如 __init__)保留给系统内置的特殊魔法方法。本文将针对每种下划线的运行原理、边界条件与排查方式展开具体解析。
一、单前导下划线 _var:弱私有约定与模块导入控制
单前导下划线(Single Leading Underscore)是 Python 社区中最常见的一种命名方式。根据 PEP 8 风格指南,以单个下划线开头的变量、函数或方法被视为“非公开接口”(Non-public API)。
1. 命名层面的弱私有约定(Weak Private Indicator)
在类定义中,将属性或方法命名为 self._mode,表示该成员属于内部实现细节。外部调用者或子类开发者应当自觉避免直接依赖它。然而,Python 解释器在类内部并不会对单下划线做任何重命名或拦截处理:外部代码仍然可以通过 obj._mode 自由读取和修改。
class DataService:
    def __init__(self, endpoint):
        self.endpoint = endpoint
        self._cache = {}  # 内部状态:弱私有属性

    def _connect(self):
        # 内部辅助函数,外部不应直接调用
        return "Connected to " + self.endpoint

service = DataService("https://api.example.com")
# 示例输出:虽然下划线提示私有,但外部依旧可直接访问与修改
print(service._connect())  # 示例输出: Connected to https://api.example.com
service._cache["key"] = "val"
print(service._cache)      # 示例输出: {'key': 'val'}
2. 模块层面的通配符导入抑制
单前导下划线在模块层级具有解释器级别的实际行为差异:当其他文件使用 from module_name import * 进行通配符导入时,所有以单下划线开头的顶级变量、函数和类都会被自动过滤,不会进入当前命名空间。
例如,创建模块文件 tool_lib.py:
# tool_lib.py
public_config = "v1.0"
_internal_token = "secret_key"

def calculate(x, y):
    return x + y

def _helper_calc(x):
    return x * 2
在另一个脚本中执行导入操作并排查当前符号表:
# main.py
from tool_lib import *

print(dir())
# 示例输出: ['calculate', 'public_config', ...] (不包含 _internal_token 与 _helper_calc)

# 若直接调用未被导入的私有函数:
try:
    print(_helper_calc(10))
except NameError as e:
print("抛出异常:", e) # 示例输出: 抛出异常: name '_helper_calc' is not definedfrom tool_lib import _helper_calc)或直接 import tool_lib,单下划线的名称依然可以被正常使用。此外,如果模块内部显式定义了 __all__ = [...] 导出列表,通配符导入将完全遵循该列表的定义,而不再依据单下划线进行隐式过滤。
二、双前导下划线 __var:名称修饰与继承防冲突
双前导下划线(Double Leading Underscores)往往被许多初学者误解为类似 Java 或 C++ 中的 private 私有关键字。实际上,Python 设计该语法的核心诉求并非为了“加密”或“强行封锁访问”,而是为了在类的继承体系中实现名称修饰(Name Mangling)。
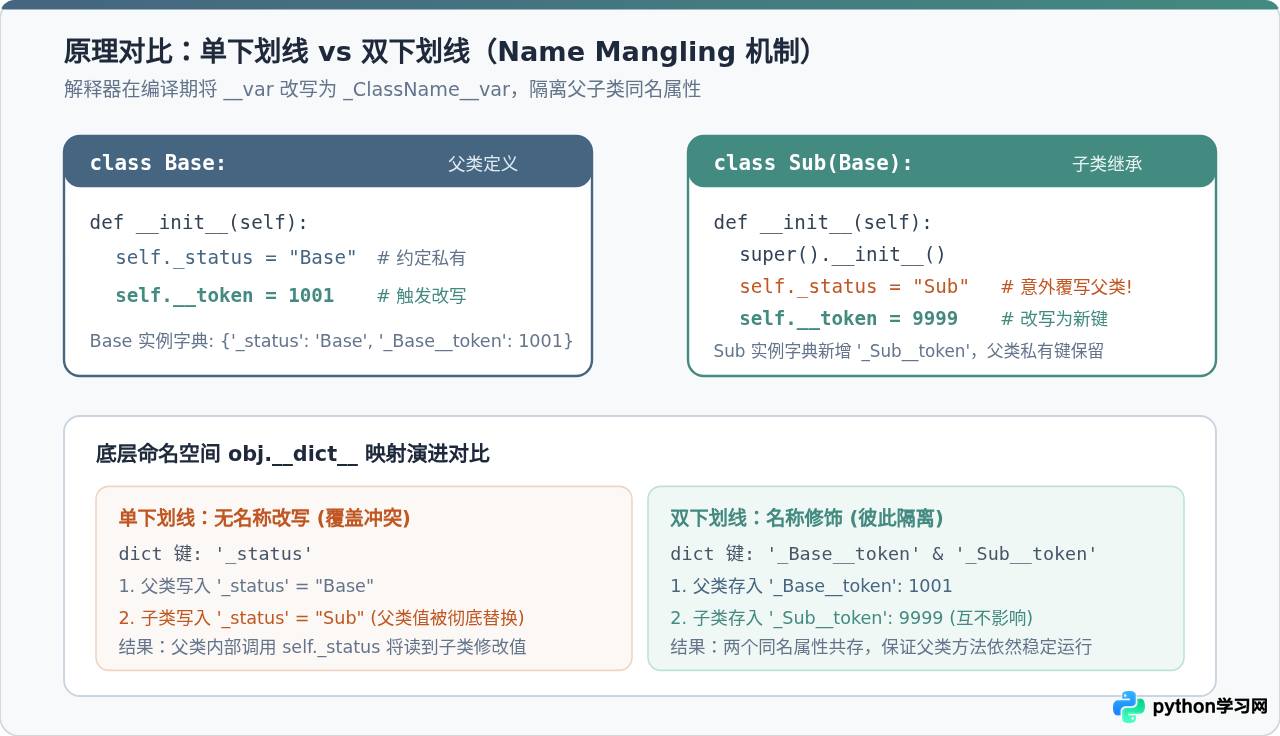
1. 名称修饰(Name Mangling)的底层运作
只要类定义中的标识符以至少两个下划线开头、且至多以一个下划线结尾(例如 __attribute),Python 解释器在编译生成字节码时,会自动将该名称改写为 _类名__attribute。这意味着该属性在底层属性字典(__dict__)中并不是以原始名称保存的。
class Account:
    def __init__(self, owner, balance):
        self.owner = owner
        self.__balance = balance  # 触发 Name Mangling

acc = Account("Alice", 5000)

# 检查实例底层的属性映射字典
print(acc.__dict__)
# 示例输出: {'owner': 'Alice', '_Account__balance': 5000}

# 直接通过原始名称访问会报错
try:
    print(acc.__balance)
except AttributeError as err:
    print("访问失败:", err)  # 示例输出: 访问失败: 'Account' object has no attribute '__balance'

# 通过改写后的真实名称访问依然成功(印证其非严格绝对私有)
print(acc._Account__balance)  # 示例输出: 5000
2. 核心场景:避免子类无意的属性覆盖(Attribute Shadowing)
在复杂的面向对象系统或框架开发中,基类可能需要依赖某些核心内部状态或辅助逻辑。如果使用单下划线 _state,一旦派生子类的编写者恰巧也定义了一个名为 _state 的属性,子类的赋值将直接把基类的同名状态篡改,引发隐蔽的运行时 Bug。而双下划线改写机制恰好隔离了两者的命名空间:
class Worker:
    def __init__(self):
        self.__job_id = "WORKER-001"  # 存为 _Worker__job_id

    def get_worker_id(self):
        return self.__job_id

class SpecialWorker(Worker):
    def __init__(self):
        super().__init__()
        self.__job_id = "SPECIAL-999"  # 存为 _SpecialWorker__job_id

sw = SpecialWorker()
print(sw.get_worker_id())  # 示例输出: WORKER-001 (基类方法依然稳定读取自身属性)
print(sw.__dict__)
# 示例输出: {'_Worker__job_id': 'WORKER-001', '_SpecialWorker__job_id': 'SPECIAL-999'}如上例所示,Worker 和 SpecialWorker 各自持有一个名为 __job_id 的属性,但在实例内部分别对应不同的键,完全避免了冲突。
三、决策路径:如何选择单下划线还是双下划线?
在日常业务开发中,开发者常常面临“到底该用单下划线还是双下划线”的疑问。实际上,过度使用双下划线不仅无法带来真正的安全防护,反而会使代码调试和单元测试变得繁琐。
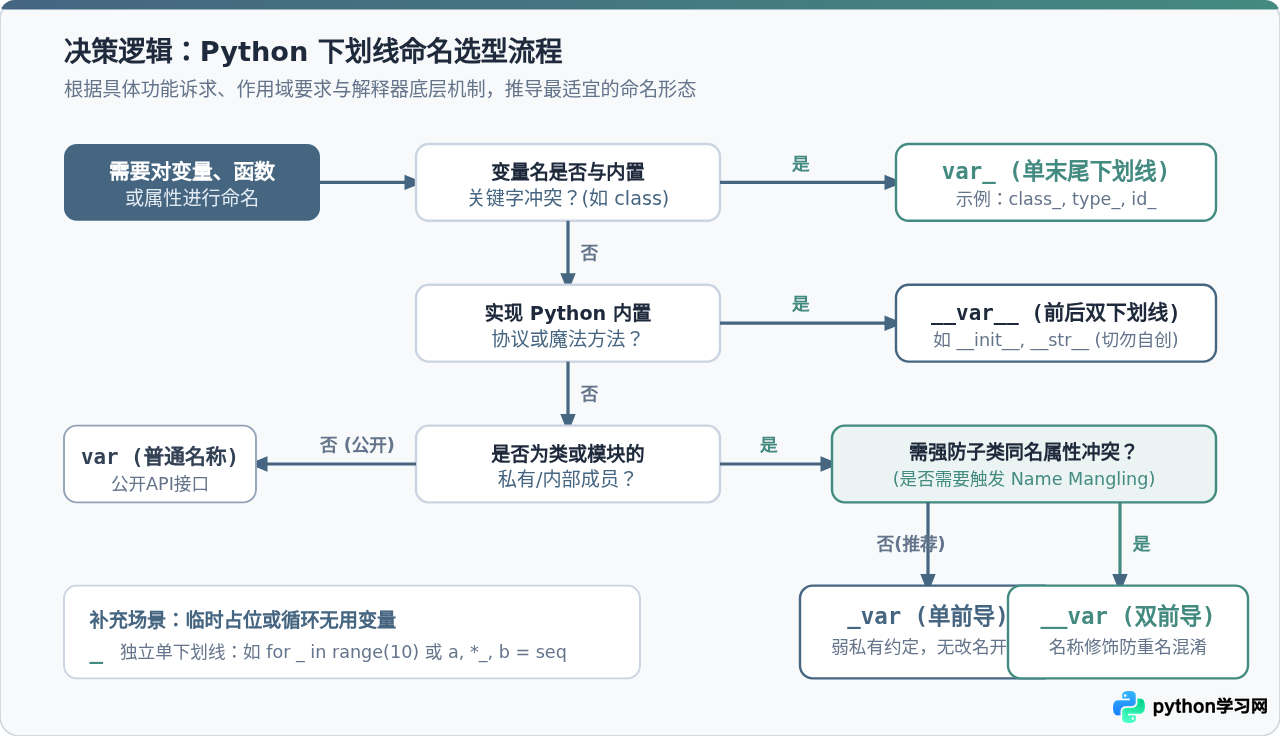
根据 Pythonic 的工程实践原则,选型建议如下:
- 优先使用单前导下划线
_var:绝大多数类内部方法、缓存变量、辅助工具函数,直接使用单下划线足以传达“内部成员,外部请勿直接调用”的规范意图。 - 仅在深层继承体系防冲突时使用双前导下划线
__var:当你在编写公共类库、插件基类或预期会被第三方频繁继承的大型模块时,使用__var可以防止继承者无意中重名踩坑。 - 不要指望
__var提供安全隔离:任何 Python 代码都可以通过obj._Class__var绕过改写访问该属性,Python 秉承“大家都是成年人(We are all consenting adults here)”的设计哲学,安全隔离应依赖外部鉴权或加密机制。
四、首尾双下划线 __var__:Python 语言内置魔法方法
名称以双下划线开头并以双下划线结尾的标识符(通常称为 Dunder Methods,即 Double Underscore)是 Python 语言核心协议专用的保留命名空间。
1. 魔法方法的作用机制
此类方法在底层由 Python 解释器在执行特定操作时自动调用,用于赋予自定义对象类似内置类型的强大能力:
- 对象初始化与销毁:
__init__(初始化实例属性)、__new__(创建实例对象)、__del__(析构器)。 - 字符串表现形式:
__repr__(开发者调试输出)、__str__(用户友好打印输出)。 - 容器协议:
__len__(配合len(obj))、__getitem__(实现下标访问obj[key])。 - 运算符重载:
__add__(实现+)、__eq__(实现==)。 - 上下文管理:
__enter__和__exit__(配合with语句管理资源)。
__my_custom_func__ 这类以双下划线开头和结尾的标识符。Python 官方语言设计组持续在未来的 Python 小版本中引入新的魔法协议。自创新名字极易与未来 Python 版本的新特性发生同名踩踏,破坏代码向后兼容性。
五、补充下划线形态:单末尾下划线 var_ 与独立单下划线 _
除了前述几种常见形式,Python 中还有另外两种高频出现的下划线用法:
1. 单末尾下划线 var_:避开保留关键字冲突
当变量的业务命名恰巧与 Python 内置关键字(如 class, def, type, id, in, list)冲突时,PEP 8 推荐在末尾追加单个下划线,既保证了语义清晰,又满足了语法合法性。
# 在参数中使用 class_ 避免与保留字 class 冲突
def filter_students(name, class_="Grade-1"):
    return {"name": name, "class": class_}

# 在 HTML 渲染辅助类中:
element_attrs = {"class_": "nav-item active", "id_": "btn-submit"}
2. 独立单下划线 _:临时占位与特殊上下文
- 废弃占位符:在循环或序列解构时,表示该位置的值在后续逻辑中无需使用,明确向代码审查者表明忽略意图。
- 交互式解释器(REPL):在 Python 命令行或 IPython 中,
_自动保存上一个表达式的计算输出。 - 国际化多语言(i18n):在
gettext框架中,_普遍作为翻译函数别名,如_("Welcome")。
# 场景 1: 循环计数仅作迭代次数控制
for _ in range(3):
    print("执行批处理...")

# 场景 2: 解构时忽略中间元素
record = ("Alice", 28, "Engineer", "Beijing")
name, *_, city = record
print(name, city)  # 示例输出: Alice Beijing
六、操作与排查:如何验证变量命名背后的行为
在面对未知代码或疑难继承 Bug 时,可以通过以下标准化的排查步骤,系统验证变量命名所引发的实际行为:
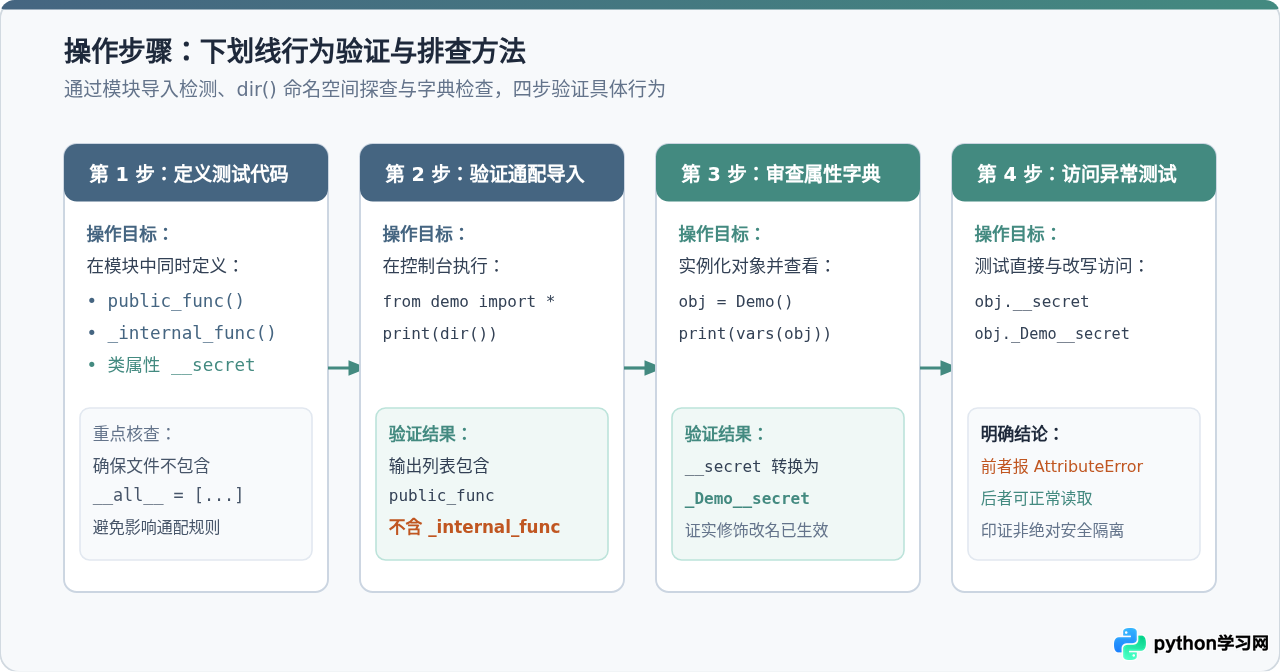
具体操作指引:
- 定义实验样例:在被测模块中同时声明公开属性、单下划线属性与双下划线属性,确保不定义
__all__干扰测试。 - 验证通配符导入行为:在新脚本中使用
from module import *导入后,调用dir()打印本地全局命名空间。预期结果是单下划线标识符被自动忽略,公开标识符正常就绪。 - 审查实例属性字典:实例化对象并执行
vars(obj)或obj.__dict__。预期结果中双下划线属性将以_ClassName__attr形式呈现。 - 测试直接访问与改写访问:尝试通过
obj.__attr访问,确认解释器抛出AttributeError;再通过obj._ClassName__attr访问,确认数据完整可读,验证名称修饰机制的生效。
七、下划线命名模式全景速查对照
为了便于日常编码时快速核对,下表系统梳理了 Python 中 5 种下划线形态的核心维度对比:
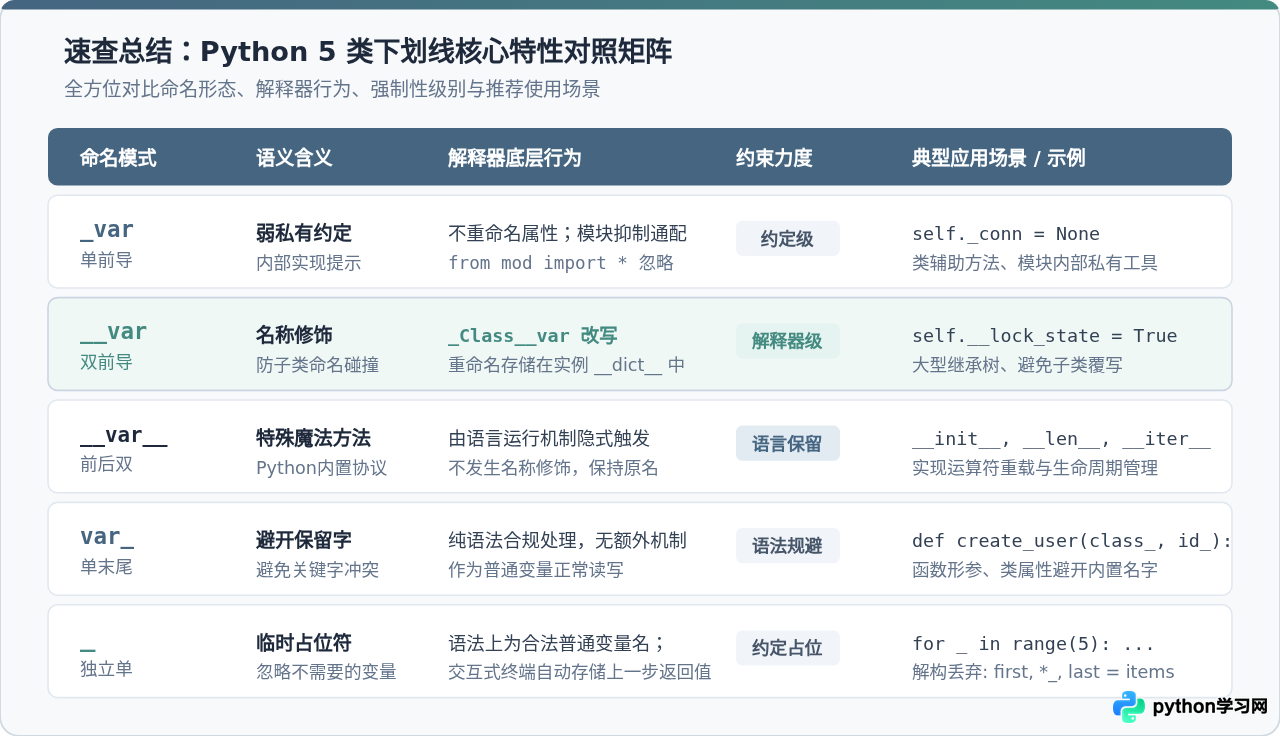
| 命名形式 | PEP 8 / 官方语义 | 解释器底层机制 | 强制约束级别 | 推荐使用场景与示例 |
|---|---|---|---|---|
_var |
弱私有约定 | 不修改属性名;模块级别抑制通配符导入(from mod import * 忽略) |
约定级(无硬性限制) | 类内部变量、辅助方法、模块私有工具函数,如 self._cache |
__var |
防继承冲突 / 名称修饰 | 改写属性键名为 _ClassName__var 存入实例字典 |
解释器级(语法转换) | 深层继承体系中防止子类意外覆盖父类属性,如 self.__uuid |
__var__ |
特殊魔法方法 | 语言核心协议挂钩,保持原名,由语法操作隐式调用 | 语言保留级 | 仅实现已有协议(如 __init__, __repr__),严禁自创新名 |
var_ |
避免关键字冲突 | 普通合规变量,无任何额外特殊机制 | 语法规避级 | 函数形参或变量名与 Python 保留字冲突时使用,如 class_, type_ |
_ |
临时占位符 / 上次求值 | 语法上为合法标识符;交互式终端自动存储上一步返回值 | 习惯约定级 | 解构丢弃无用值(a, *_ = items)、循环计数占位(for _ in ...) |
综上所述,Python 中的单下划线主要体现了“契约与约定”的哲学,依靠开发者自觉遵循规范;而双下划线则侧重于“防御与隔离”,通过解释器改名消除复杂继承中的命名踩踏隐患。在日常编程中,坚持“默认使用单前导下划线,仅在确有继承防重写需求时使用双前导下划线”的准则,能够保证代码既优雅清晰,又易于维护与扩展。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









