

Python原地快速排序 vs 列表推导式写法对比
深度对比Python原地快速排序与列表推导式写法的代码实现、内存开销、运行机制及工程选型,通过内联SVG图解剖析两者的性能边界与经典认知误区。
O(N log N) 的堆空间膨胀及剧烈的垃圾回收(GC)消耗。原地双指针实现虽然代码稍长,却能严格维持 O(1) 的辅助堆内存占用。本文将从源码实现、内存拓扑、执行流水线及工程选型四个维度展开系统对比。
一、两种写法的代码实现与执行逻辑
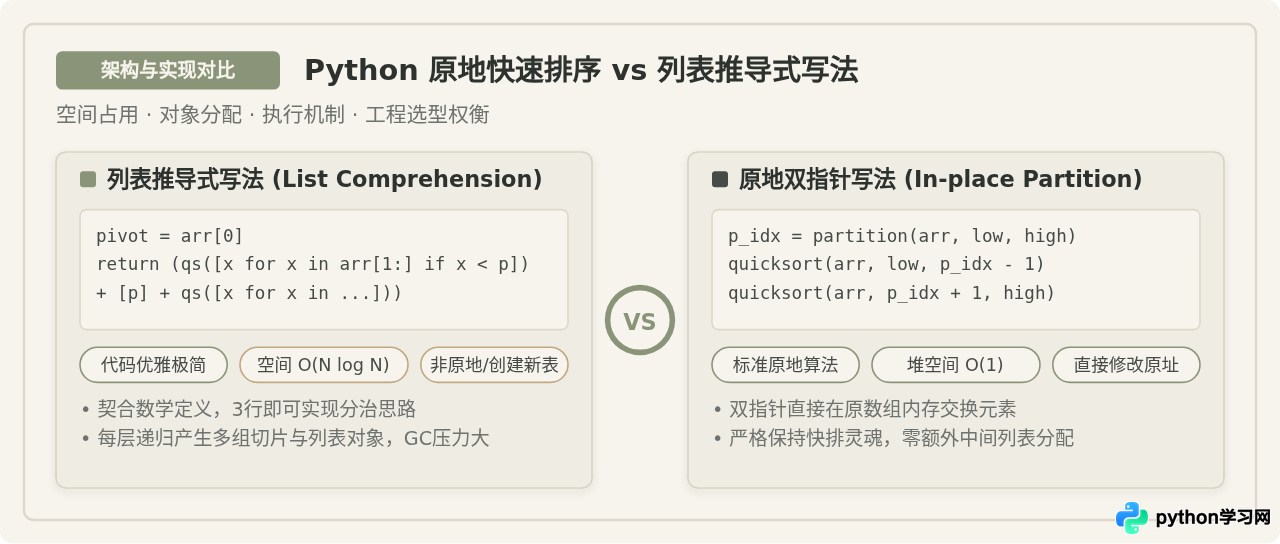
快速排序由 Tony Hoare 于 1959 年提出,其本质是分治思想(Divide and Conquer):选取一个基准元素(Pivot),将序列划分为“小于基准”与“大于基准”的两部分,随后递归对两部分进行排序。在 Python 中,这一逻辑可以通过两种截然不同的方式编码。
1. 列表推导式写法(函数式/极简版)
列表推导式写法充分利用了 Python 语法的高表达力。它直接选取首个元素为基准,利用两条推导式过滤出较小和较大的元素列表,最后通过列表相加(+)完成拼接:
def quicksort_comprehension(arr: list) -> list:
    """列表推导式实现的快速排序(非原地,返回新列表)"""
    if len(arr) <= 1:
        return arr

    pivot = arr[0]
    left = [x for x in arr[1:] if x < pivot]
    right = [x for x in arr[1:] if x >= pivot]

    return quicksort_comprehension(left) + [pivot] + quicksort_comprehension(right)

# 示例调用
test_arr = [5, 2, 8, 3, 9, 4]
sorted_arr = quicksort_comprehension(test_arr)
print("推导式排序结果:", sorted_arr)  # 示例输出: [2, 3, 4, 5, 8, 9]
print("原始列表是否受影响:", test_arr)  # 示例输出: [5, 2, 8, 3, 9, 4]
该写法的优点在于直观纯粹:代码结构与快速排序的数学定义完全一致,没有下标计算的琐碎边界,且具有函数式编程的“无副作用”特点(不修改原数组 test_arr)。
2. 原地双指针划分写法(经典工程版)
真正的原地快速排序不返回新列表,而是直接在传入的列表连续内存中通过索引互换元素值,通过递归传递索引边界 low 与 high 控制当前视窗:
def partition_hoare(arr: list, low: int, high: int) -> int:
    """双指针原地划分:调整元素位置并返回基准最终归位索引"""
    pivot = arr[low]
    i = low + 1
    j = high

    while True:
        # 左指针向右推进,定位首个大于等于 pivot 的元素
        while i <= j and arr[i] < pivot:
            i += 1
        # 右指针向左推进,定位首个小于等于 pivot 的元素
        while i <= j and arr[j] > pivot:
            j -= 1

        if i < j:
            # 原地互换失序元素,无需新内存
            arr[i], arr[j] = arr[j], arr[i]
            i += 1
            j -= 1
        else:
            break

    # 将基准归位至交错分界点 j
    arr[low], arr[j] = arr[j], arr[low]
    return j

def quicksort_inplace(arr: list, low: int = 0, high: int = None) -> None:
    """原地快速排序入口函数"""
    if high is None:
        high = len(arr) - 1

    if low < high:
        # 划分区间并获取基准就位下标
        pivot_idx = partition_hoare(arr, low, high)
        # 仅传递数值标量区间进行递归
        quicksort_inplace(arr, low, pivot_idx - 1)
        quicksort_inplace(arr, pivot_idx + 1, high)

# 示例调用
test_arr_2 = [5, 2, 8, 3, 9, 4]
quicksort_inplace(test_arr_2)
print("原地排序后原数组被改变:", test_arr_2)  # 示例输出: [2, 3, 4, 5, 8, 9]
二、内存模型与对象分配深度剖析
理解两者的本质差异,关键在于观察 Python 的堆内存(Heap Memory)对象分配。Python 列表是基于连续指针数组实现的动态向量,每次进行切片 arr[1:]、推导生成 [...] 或拼接 + 时,解释器底层都会调用 PyList_New 申请全新的连续内存块,并逐一递增元素对象的引用计数。
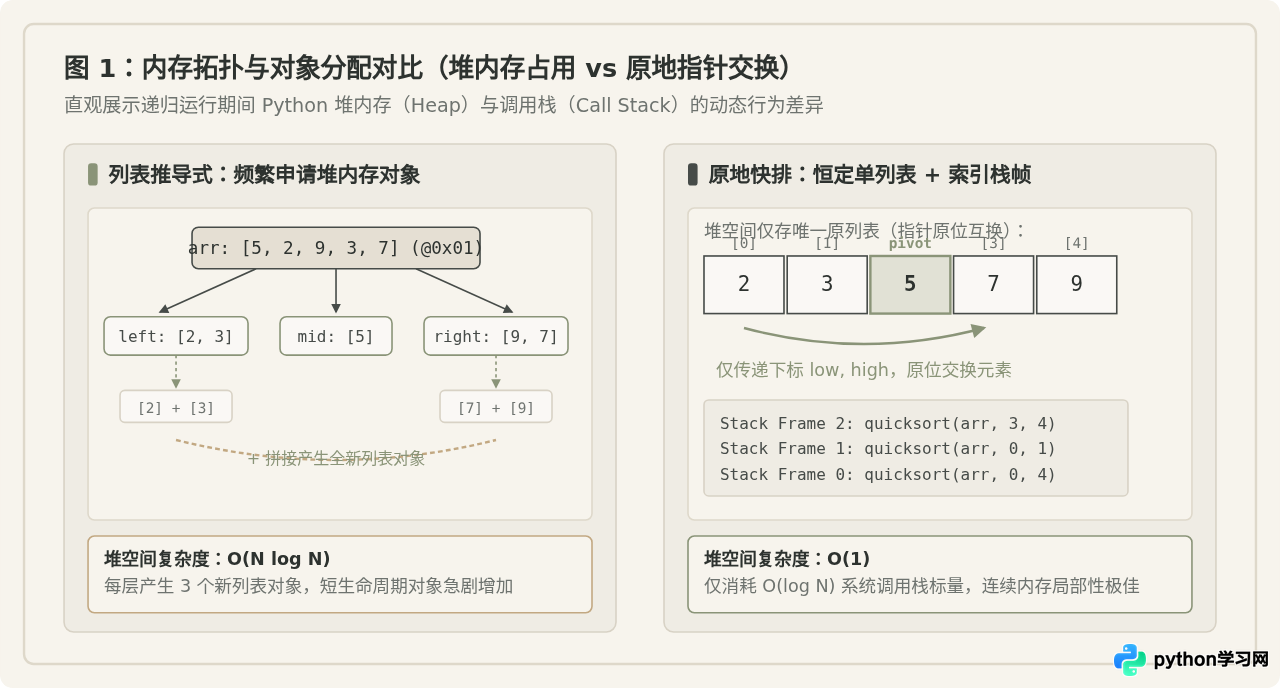
如图 1所示:
- 列表推导式版本:在递归树的每一层,原始数据都被复制拆分到
left、[pivot]和right三个完全独立的列表实例中。在树深度为log N的理想情况下,每一层累计分配的元素空间都与原数组长度N相当,总堆内存分配达到O(N log N)。更严重的是,这些列表中间变量生命周期极短,回溯拼接完成后即成为垃圾,对 Python 的分代垃圾回收器(Generational GC)造成巨大吞吐负担。 - 原地双指针版本:整个递归过程中,堆上自始至终只有唯一一个原始列表对象。双指针算法通过
arr[i], arr[j] = arr[j], arr[i]原地交换指针插槽,辅助堆内存开销严格为O(1)。唯一的额外开销仅为保存low、high、pivot_idx等整型标量的 Python 函数调用栈帧(Stack Frame),栈深度为O(log N)。
三、双指针原地划分(Partition)的执行步骤拆解
原地快速排序的精髓全在 partition 函数中。为直观呈现指针移动与元素对调过程,我们以数组 [4, 7, 2, 8, 1, 5] 为例进行分步推演。
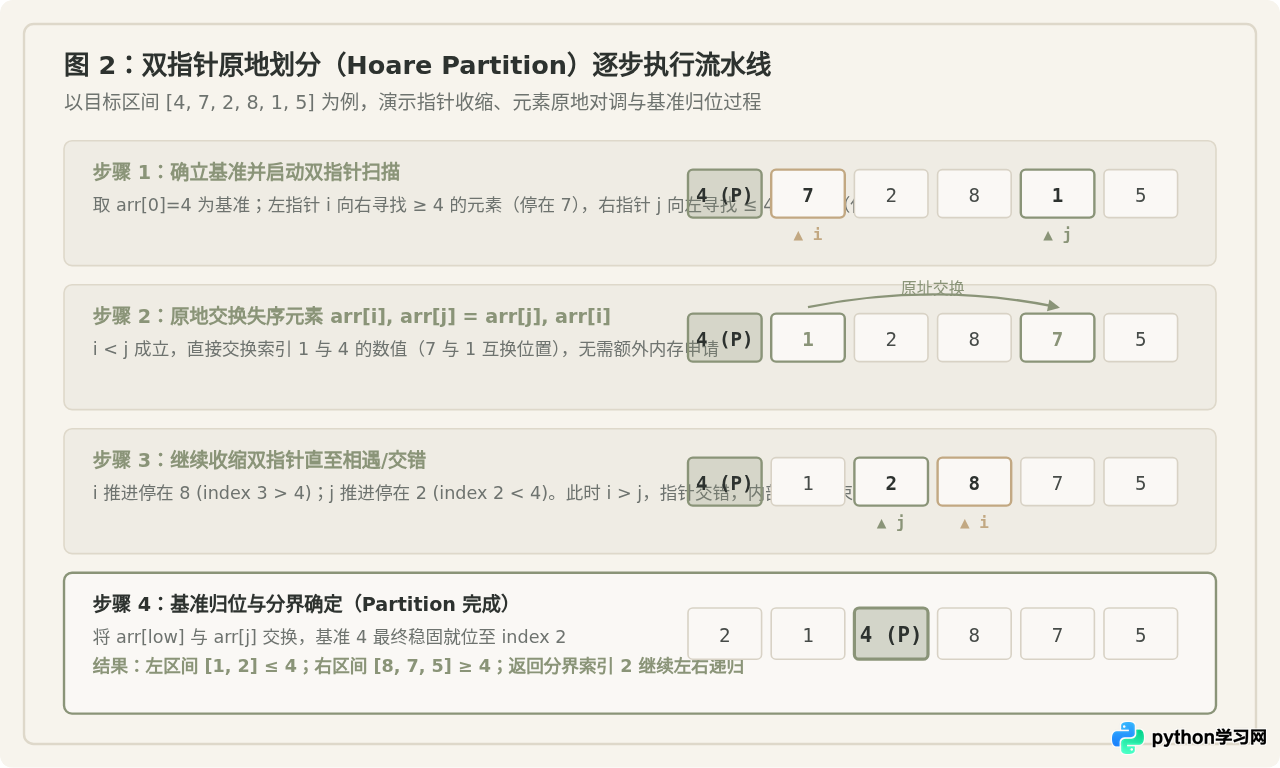
整个划分过程严格遵循双向夹逼原则(参考图 2):
- 确立基准与指针初始位:以
arr[0] = 4为基准,i从索引 1(值 7)起始,j从末尾索引 5(值 5)起始。 - 指针定位:左指针
i向右扫描,遇到首个大于等于基准的数值7即刻停驻;右指针j向左扫描,跨过5后停在小于基准的数值1(索引 4)。 - 就地交换:由于此时
i < j,直接在原数组内互换arr[1]与arr[4]。数组变动为[4, 1, 2, 8, 7, 5],失序元素被各自归置到合理区间。 - 继续收缩与交错:
i步进到索引 3(数值 8);j回退到索引 2(数值 2)。此时i > j发生交错,说明所有区间内的元素均已完成比对。 - 基准归位:将初始基准
arr[0](数值 4)与停留在分界点的arr[j](数值 2)互换,得到[2, 1, 4, 8, 7, 5]。此时基准 4 刚好坐落于左右两区的黄金分割点上,返回其下标 2。
四、常见认知误区辨析:三行代码真的“更优更 Pythonic”吗?
在许多技术讨论与入门教程中,围绕列表推导式快排存在若干常见观点。这些说法之所以广泛传播,往往是因为它们在特定语境下确实成立,但在脱离前置条件后容易引发误导:
辨析与修正:在单次线性过滤场景中,列表推导式的 C 底层字节码确实比纯 Python 编写的 while 循环稍快;但在快排场景中,决定性能的关键不是单次循环开销,而是算法复杂度与内存分配量级。推导式在每层递归中需要对剩余元素扫描两次(一次 < pivot,一次 >= pivot),还要频繁调用 malloc 申请多层列表并执行 + 操作。当数据规模上升到数万级别时,高频的堆内存申请与 GC 停顿会让推导式的运行耗时反超原地算法数倍以上。
辨析与修正:这种说法混淆了“元素本身的内存”与“列表容器结构的内存”。虽然列表中的每个整数都是堆上的 PyObject,但列表容器本身是一块连续的指针数组。原地排序复用了这块已分配的指针数组,元素交换只是改变了数组槽位中的指针地址;而列表推导式则在每一次递归中不断申请新的容器数组对象及其元数据,造成的内存峰值远非原地排序可比。
辨析与修正:纯函数在处理并发、数据变换流时确实具备天然的线程安全与易推理优势,这在数据量极小的配置项或脚本转换中是合理的。但在海量数据集或内存敏感场景中,这种安全性是以极高的内存代价和深度递归导致的 RecursionError(Python 默认递归深度仅 1000)为代价换取的,不能不加节制地泛化为“工程更优”。
五、列表推导式递归展开与拼接回溯过程
为进一步看清列表推导式为什么会在空间和时间上产生额外开销,我们需要审视其树状展开与回溯拼接的完整生命周期。
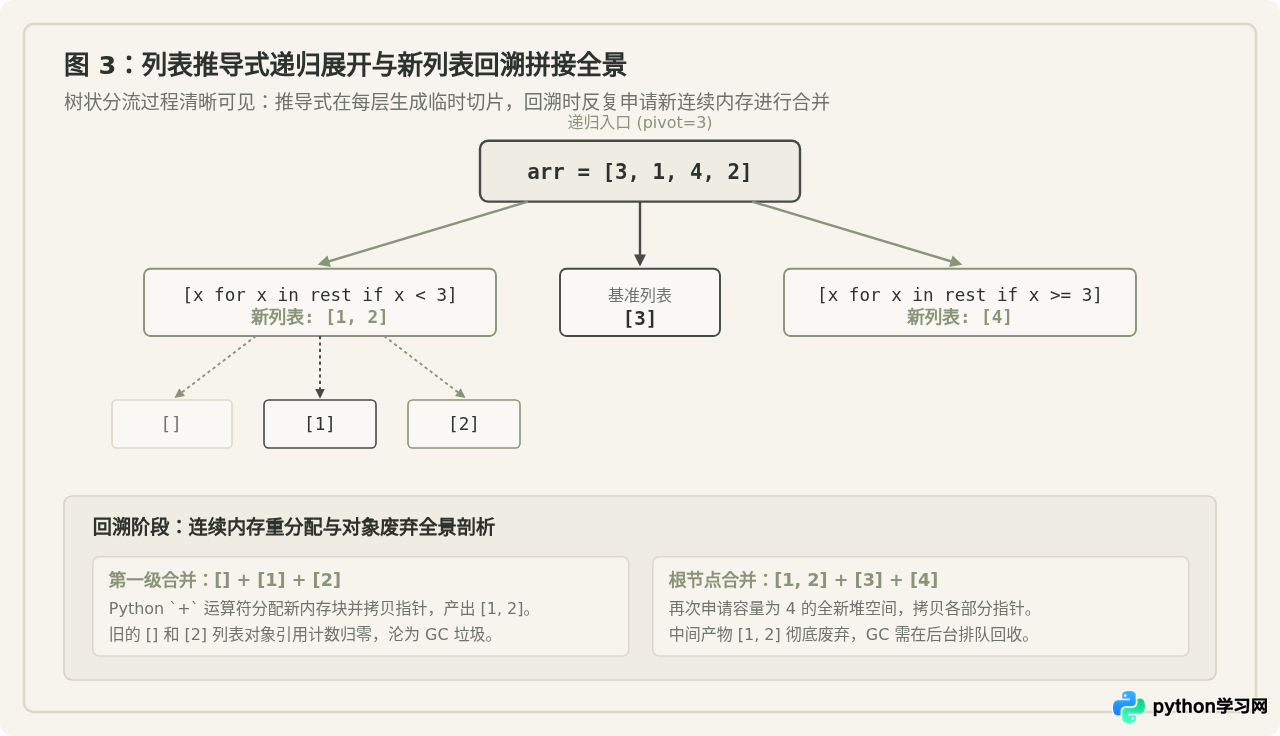
从图 3可以看出,推导式快排的运行流程由两条链路构成:
- 下行推导拆分:不仅基准元素被孤立包装为单元素列表
[pivot],每次拆分还会同时触发两次列表推导式,对序列进行双重遍历。 - 上行回溯拼接:函数返回时,
left + [pivot] + right需要先合并左半部与基准,再合并右半部。这会导致多次申请临时的中间列表缓冲区,底层不断进行指针拷贝。当整个递归链条展开后,形成的中间对象网络非常庞大。
六、全维度特性对比与工程选型指南
综合上述实现原理与运行机理,我们可以将两者的核心指标归纳为清晰的对比矩阵,并结合实际工程场景给出选型依据。
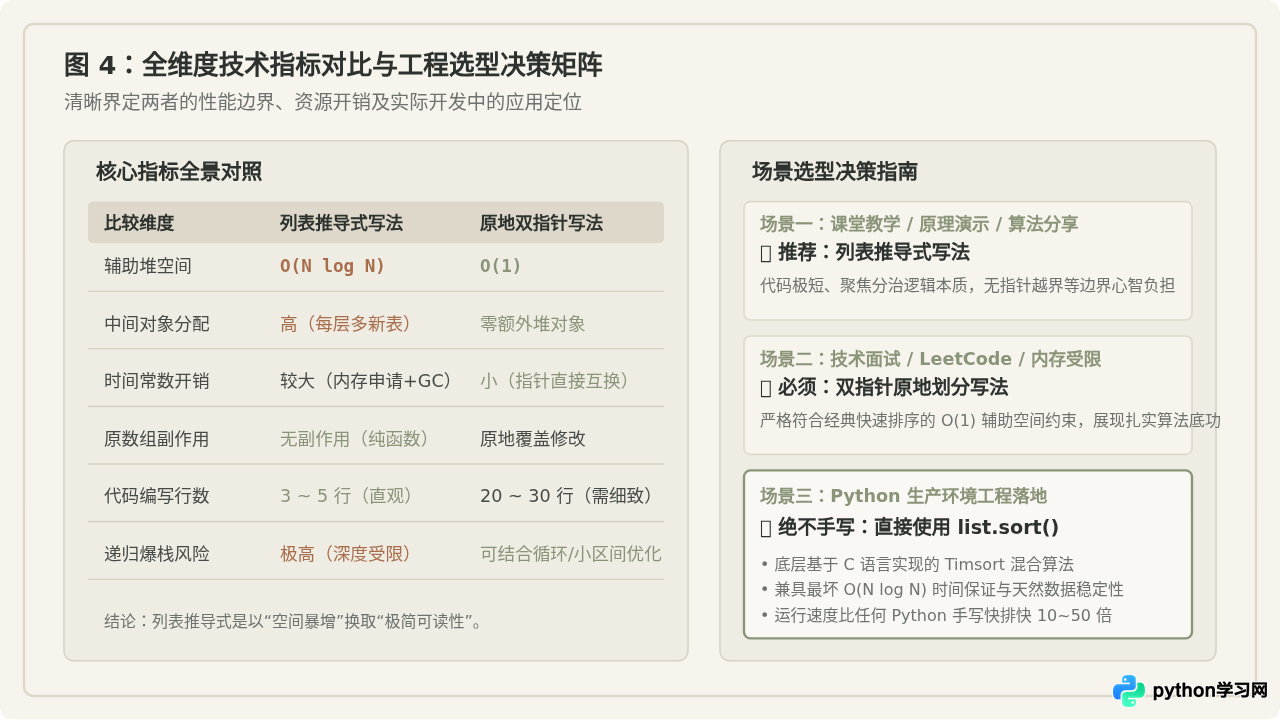
| 指标维度 | 列表推导式写法 | 原地双指针写法 |
|---|---|---|
| 代码可读性 | 极高(3~5行,直观呈现分治思想) | 中等(20~30行,需处理指针与越界边界) |
| 辅助堆空间 | O(N log N)(大量临时列表) |
O(1)(堆空间零额外增长) |
| 系统栈空间 | O(N)(最坏退化单链) |
O(log N)(可通过小区间尾递归优化) |
| 对原数组副作用 | 无副作用(返回新列表,保留原数据) | 原地修改(直接改写原数组槽位) |
| GC 压力 | 极高(产生数以万计的短期短命列表) | 极低(无临时容器对象) |
| 适用数据量级 | 仅适合 N < 1000 的小数据演示 |
适合大规模序列与内存受限环境 |
七、总结与生产环境实操建议
通过对两者的对比剖析,我们可以明确以下结论:
- 学习与概念表达优先选用推导式:如果在做算法演讲、编写教学文档或演示分治思想,列表推导式版本是极其优秀的教学工具。它剥离了复杂的指针移动细节,让读者能在一眼之下看懂分治与基准划分的精髓。
- 算法考察与底层训练必须掌握原地双指针:如果在技术面试、ACM 刷题或系统底层开发中被要求实现快速排序,必须使用双指针原地划分。只有原地划分才能体现对时间、空间复杂度及内存局部性的深刻理解。
- Python 生产开发绝不手写快速排序:在日常 Python 业务或数据工程中,面对排序需求,始终且唯一推荐使用 Python 原生的
list.sort()(就地排序)或sorted()(生成新列表)。Python 内置的排序算法是经过数十年优化的 Timsort 混合算法,采用纯 C 实现,最坏时间复杂度保持严格的O(N log N),具备自适应局部有序数据的巨大性能优势,实际执行速度比任何手写的 Python 快排快上数十倍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









