

零基础学Python爬虫看什么书?5本经典入门教材推荐
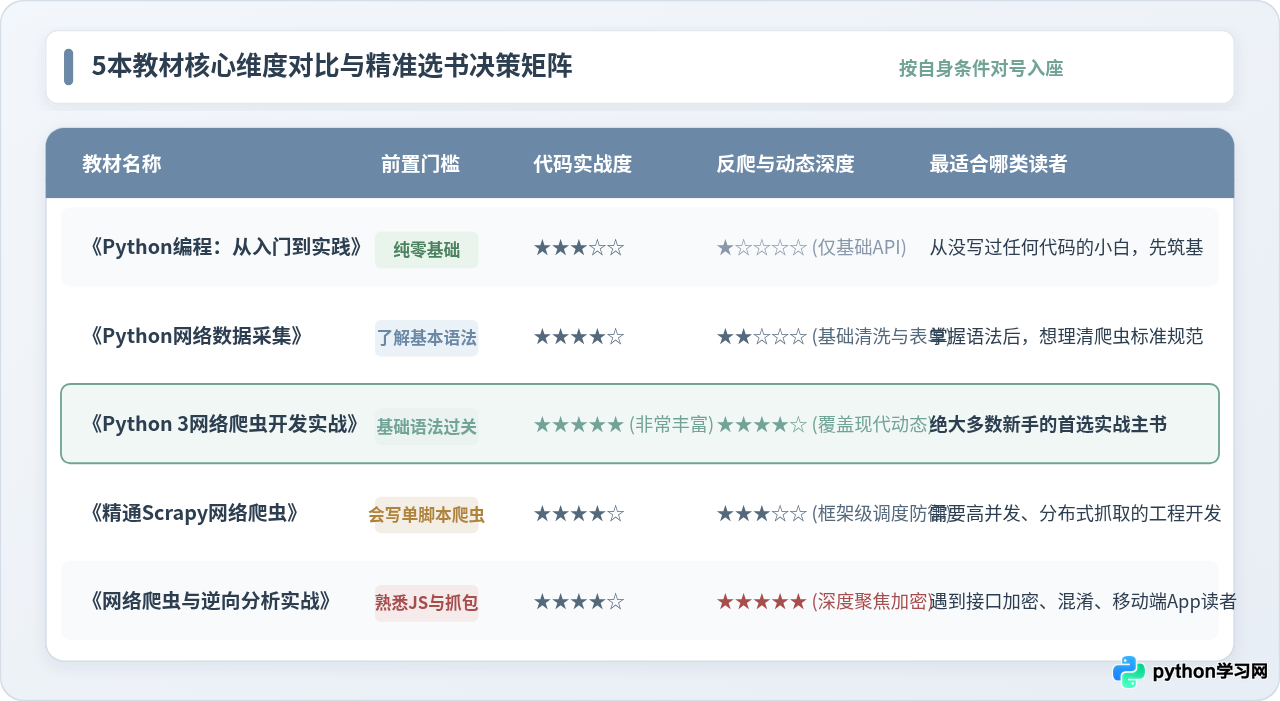
专为零基础读者梳理的Python爬虫经典教材选书指南,详细剖析5本代表性教材的核心特色、适用读者与梯度路线,附赠技术栈分层图与选书决策矩阵。
很多零基础读者在尝试学习 Python 爬虫时,常常陷入两个典型误区:要么随便找一本厚重的实战书,刚读到第三章就被密密麻麻的正则表达式和多线程代码劝退;要么一开始就照着网上零散教程直接抓取高难度动态网站,结果被各种滑块验证码和 IP 封锁拦截,完全不知道问题出在哪里。学爬虫不是死记某几个特定网站的抓取脚本,而是掌握从“发送网络请求、解析响应结构、应对动态加载到规整存储”的完整技术链条。本文围绕零基础读者的实际认知习惯,精选 5 本兼具权威性、循序渐进且经过大量读者检验的经典教材,并附上清晰的递进学习路线与选书决策建议。
一、零基础选书的三个核心判断标准
市面上带有“爬虫实战”字样的图书不下百种,但真正适合零基础起步的教材并不多。在挑选第一本学习资料时,读者应当基于以下三条可量化的客观标准来进行筛选:
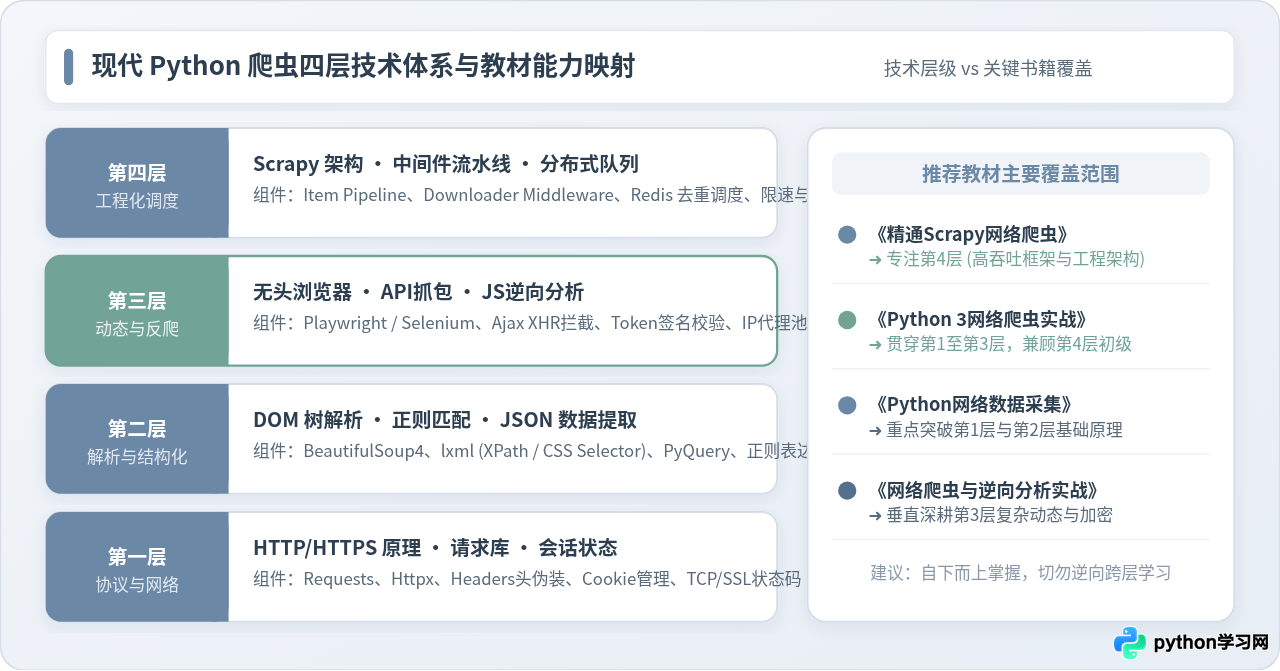
- 是否先把基础网络协议与请求原理解释清楚:网络爬虫的底层逻辑是模拟客户端向服务端索取数据。一本优质的入门教材绝不会一上来就堆砌几十行代码,而是会花必要篇幅讲解 HTTP 状态码、请求头(User-Agent)、Cookie、Session 以及 URL 编码。如果连 GET 和 POST 的区别都没弄懂,后续遇到接口报错只会手足无措。
- 是否正视现代前端渲染与接口交互的演进:许多老旧书籍只讲解抓取静态 HTML 页面。然而今天的 Web 应用普遍采用 Vue、React 等单页渲染架构,真实数据往往通过异步 Ajax(XHR/Fetch)加载。如果教材只教
requests.get()后直接解析 DOM,读者一旦面对动态渲染网页就会发现抓到的内容全是空标签。好的入门教材必须涵盖抓包分析或无头浏览器工具。 - 示例代码是否具备强复现性与工程规范意识:爬虫代码高度依赖外部网站结构,而真实网站的排版随时可能变动。优秀的教材会提供配套的测试练习平台(或者结构稳定的公共开放接口),并在代码中明确体现异常捕获(如网络超时、连接断开)、延时防封控制以及规范的数据存储方式,而不是把所有逻辑全写在全局脚本里。
二、5本经典入门教材深度推荐与解析
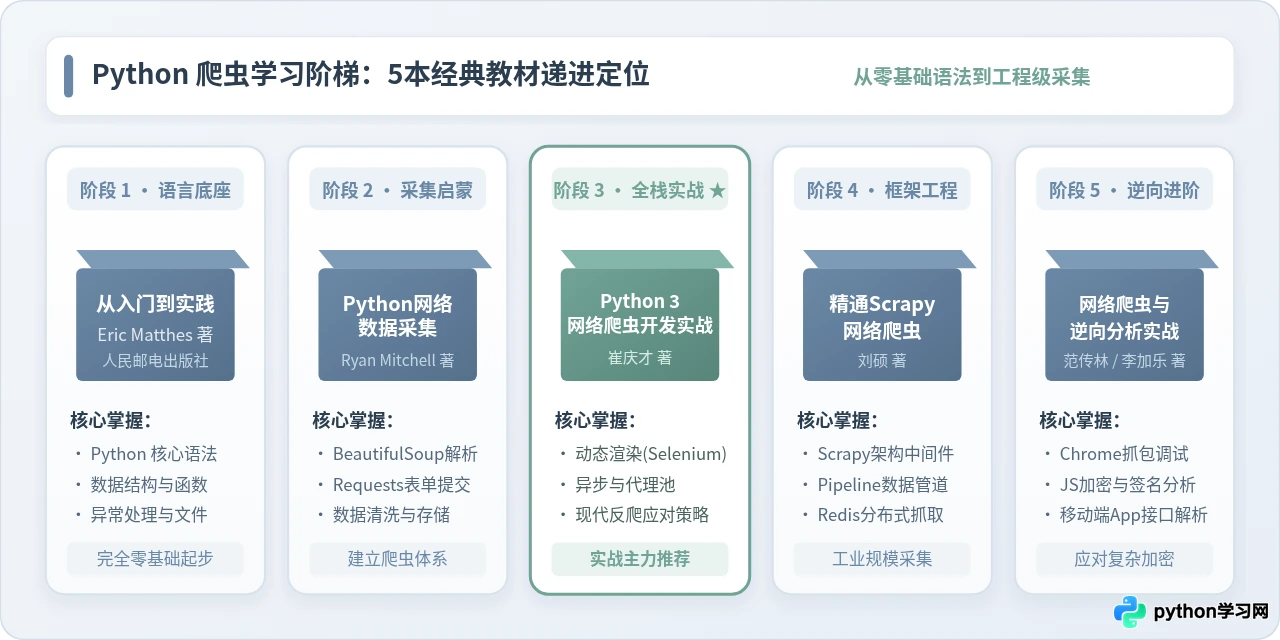
根据上述标准与学习梯度的衔接要求,我们精选了以下 5 本书籍。它们从语言基础、网络数据采集规范、全栈主流实战,一直延伸到工业级框架与复杂交互,构成了完整的知识闭环。
1. 《Python编程:从入门到实践》—— 零基础搭建编程与网络底座
定位解析:如果读者此前没有任何编程经验,连 Python 的基本语法、缩进规范、列表与字典取值都还不熟悉,千万不要直接阅读任何纯爬虫专业书,而应该先把本书的前半部分踏踏实实读完。
核心亮点:全书前半部分用极浅显清晰的语言,彻底扫清变量、字符串操作、列表与字典迭代、函数、面向对象编程以及文件读写和 try-except 异常处理等核心知识。后半部分包含使用 Web API(如 GitHub API)获取数据并进行数据可视化的完整项目。这一项目恰好为理解爬虫中的“发送请求并解析 JSON 数据”打下了极其平滑的认知基础。
2. 《Python网络数据采集》—— 建立标准爬虫思维与采集规范
定位解析:这是 O'Reilly 经典的“刺猬封面”动物书,公认的爬虫启蒙读物。适合掌握了基本语法之后,系统建立“爬虫到底在做什么、应该怎么规范做”的第一本专业书籍。
核心亮点:全书逻辑骨架极其扎实。作者从最基础的通过 urllib 和 BeautifulSoup 提取标签开始,层层递进讲解复杂 HTML 属性查找、树状导航定位、正则表达式清洗脏数据、遍历整个网站的重定向与死循环防范。书中不仅教抓取,还用单独章节讲解数据存储(MySQL、CSV)、多格式文档读取(PDF、Word)以及表单登录会话维持,非常注重网络数据工程的底层规范。
requests 库进行替换练习。核心吸收其树状解析与数据清洗的思维模型。
3. 《Python 3网络爬虫开发实战》—— 现代现代全栈实战百科全书
定位解析:国内技术圈影响力最大、好评最广泛的爬虫教材,堪称现代 Web 抓取的“百科全书”。如果一个零基础读者时间有限,只想完整啃透一本最能解决实际抓取难题的书,本书是毫无争议的首选。
核心亮点:全面覆盖当今真实的 Web 技术生态。作者不仅详细讲解了 requests、httpx、XPath、BeautifulSoup 和 PyQuery 等抓取与解析基础,还系统梳理了现代开发者必须面对的痛点问题:Ajax 异步数据包的抓取与分析、动态渲染工具(Selenium、Playwright、Pyppeteer)、反爬虫策略应对(代理池设计、模拟登录维持状态、常见验证码识别与绕过逻辑),并在后半部分给出了 Scrapy 基础与分布式抓取案例。
4. 《精通Scrapy网络爬虫》—— 走向工业级高吞吐工程化
定位解析:当读者已经能用几行脚本抓取单一网站,但面对成千上万个链接、需要保证每天稳定定时抓取并流式写入数据库时,单一的脚本往往会因为网络波动、内存泄漏或没有排队去重而崩溃。本书正是从“脚本抓取”进阶到“工程系统”的必读书。
核心亮点:专注深入剖析 Python 领域最强大的开源爬虫框架 Scrapy。书中从架构全景出发,细致拆解了 Spider(爬虫逻辑)、Engine(引擎控制)、Scheduler(调度器)、Downloader(下载器)与 Item Pipeline(数据管道)之间的协同工作原理。作者通过详实的项目案例,演示了如何编写自定义下载中间件(如动态代理注入、随机 User-Agent)、如何防止重复抓取,以及如何接入 Redis 构建分布式集群。
5. 《网络爬虫与逆向分析实战》—— 攻克现代 Web 加密与接口分析
定位解析:现代主流商业网站为了保护数据资产,普遍给前端接口加上了防篡改签名(如 Token、时间戳加密、混淆 JS)。面对这类网站,单纯看 HTML 源代码一无所获。本书专为希望跨过“反爬虫防线”的进阶读者而写。
核心亮点:围绕 Chrome 开发者工具(F12)的网络面板、断点调试(XHR Breakpoints、DOM Breakpoints)、Console 变量追踪展开。通过对主流前端混淆机制、常见对称与非对称加密算法的讲解,教会读者如何层层剥离前端代码,找到生成请求签名的关键 JavaScript 逻辑,并使用 Python 调用 JS 运行环境(如 Node.js 或 ExecJS)直接复现加密结果。
三、如何根据自身基础和目标精准选书?
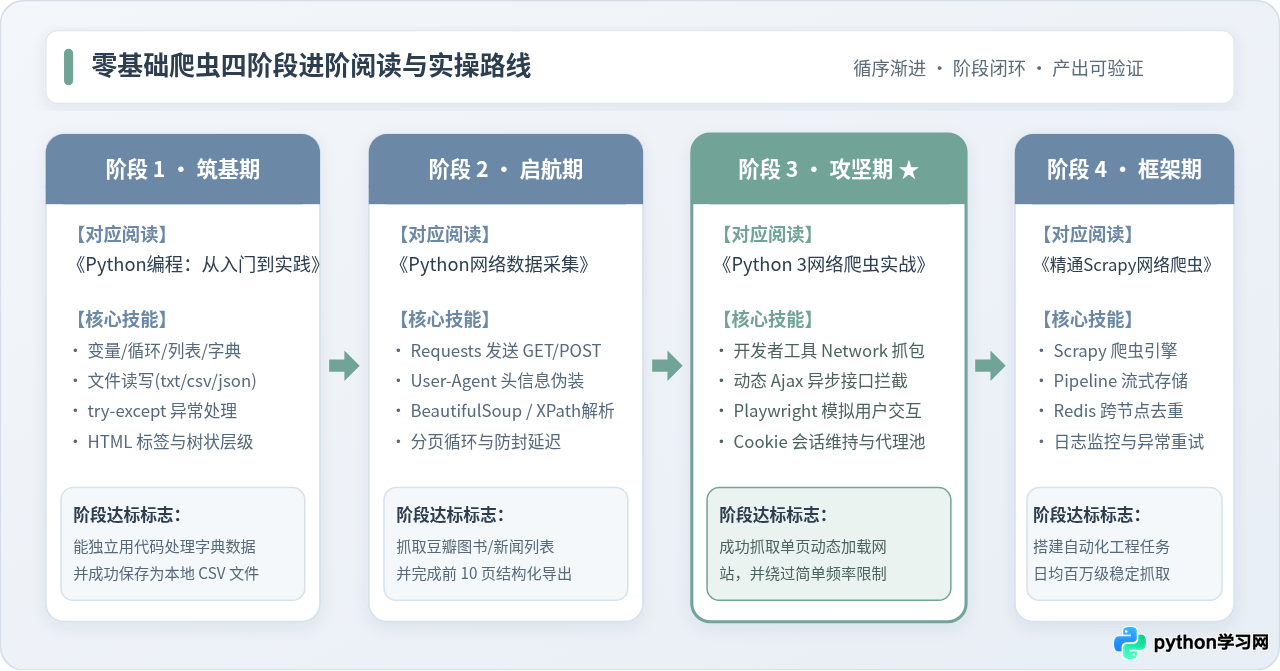
不同读者的计算机基础、时间投入和学习目的差异极大。盲目跟风买全套书很容易导致堆在书架上“吃灰”。读者可以根据以下三种典型诉求,对号入座选择自己的读书组合:
- 路径 A:文科/非技术背景、完全零基础(目标是抓取特定表格数据):
先读《Python编程:从入门到实践》掌握列表、字典和基本循环语法;随后直接翻阅《Python网络数据采集》学习 BeautifulSoup 和基础表格解析。这两本书的语言平易近人,能让新手在两到三周内跑通自己的第一个抓取脚本。
- 路径 B:工科背景或有基本编程概念(目标是快速应对现代网站实战):
直接以《Python 3网络爬虫开发实战》(崔庆才)作为主干教材。遇到不会的语法临时在网上查阅。跟随书中的环境配置、Requests 抓包、Playwright 自动化和 Ajax 拦截案例边看边敲,这是成长最快、实战覆盖最全的路线。
- 路径 C:计划从事数据分析师、爬虫工程师或需要海量采集:
主攻《Python 3网络爬虫开发实战》打牢全栈技能后,立即接续《精通Scrapy网络爬虫》建立工程化与框架思维,最后根据业务中遇到的加密难点翻阅《网络爬虫与逆向分析实战》拓展视野。
四、零基础读者的实践建议与避坑提醒
阅读爬虫技术书籍与其他软件开发类教材有一个显著不同:被抓取的网站是处于动态变化之中的。很多初学者在读书时容易产生挫败感,往往是因为没有建立正确的学习心智。以下三条建议有助于少走弯路:
- 切忌“只看不敲”,调试响应比背诵语法更重要:爬虫不是一门可以通过默写代码掌握的技术。在实际操作中,网络延时、编码格式(UTF-8 与 GBK)、请求头缺失都会导致结果与预期不同。每一段代码都必须在本地编辑器中实际运行,打印出
response.status_code和response.text[:200],亲眼观察服务器究竟返回了什么。 - 理解“反爬虫是规则的攻防对抗”,重点学思维而非死记代码:很多读者抱怨“书上的某某网站代码跑不通了”。事实上,商业网站在几年内改版是常态。读书的核心是学习作者“如何通过开发者工具发现接口”、“如何判断网站使用了反爬策略”以及“如何一步步定位加密参数”的分析方法。只要掌握了抓包分析原理,即便目标网站改版,也能在几分钟内重新分析出正确逻辑。
- 严格遵守法律法规与道德底线:爬虫技术本身是中立的,但使用爬虫抓取数据必须遵守法律红线。在编写爬虫时,应先查阅目标网站的
robots.txt协议;务必加入合理的访问间隔(如time.sleep(1)),避免对目标服务器造成高负载瘫痪;绝不触碰非公开数据、用户个人隐私与涉及商业秘密的核心数据资产。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









