

为什么我的Python代码在线运行超时或报错?
深入解析Python代码在各类在线运行环境、刷题网站中出现超时(TLE)及常见报错的核心原因,并提供系统化排查步骤与优化方法。
在各类编程学习平台、在线判题系统(Online Judge)或网页端编译器中,Python代码运行出现“超时”(Time Limit Exceeded, TLE)或“运行时错误”(Runtime Error, RE),本质上是因为代码消耗的计算与输入输出资源超出了服务器配额,或是在线沙箱环境的运行机制与本地终端存在差异。本文将系统拆解在线运行环境的核心限制,分析导致超时与报错的高频原因,并给出具体的排查排障路径与优化范例。
一、在线运行环境的底层机制与限制模型
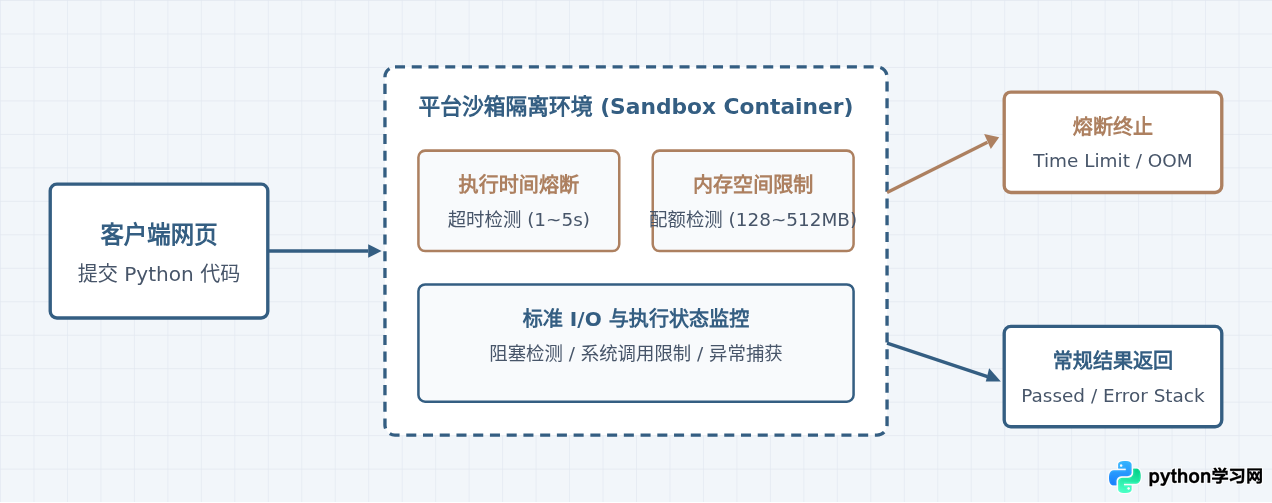
在线执行平台为了保证服务器的安全性与多用户稳定性,绝不会像本地电脑那样为单段脚本提供无限制的系统调用与运行时长。每一次点击“运行”或“提交”,平台都会在容器中分配一个受限沙箱并施加严格的边界条件。
理解这套限制是排查问题的前提。通常,在线平台会对以下四个维度施加硬性截断:
- CPU 时钟周期与绝对执行时间:大多数平台针对单个测试用例的执行时间上限设定在 1.0 秒至 5.0 秒之间。只要超出阈值,系统内核会立即发送 SIGKILL 信号终止进程,返回超时错误。
- 内存空间配额:常见限制为 128MB 到 512MB 不等。若脚本申请了过大列表或生成了过深的递归调用栈,超出限制后将被系统强制判定为内存溢出(Memory Limit Exceeded / Out of Memory)。
- 标准输入输出(I/O)管道机制:在线平台通过重定向标准输入输出(stdin/stdout)提供测试数据并抓取输出。脚本若尝试调用图形界面、发起网络连接,或未按预期读取到 EOF(文件结束符),就会出现阻塞或权限拦截。
- 无头(Headless)无交互限制:网页执行大多是非交互式的,如果在需要外部参数时执行了未提供预设输入的
input(),程序就会在等待输入队列中无限挂起直到触发超时。
二、导致代码超时的四大典型原因
在本地终端测试时,输入数据规模往往偏小(例如长度为 10 的列表),代码运行耗时只有几毫秒。但在在线平台评测时,后台通常注入极限边界数据(例如长度为 100,000 的数据流),算法的微小缺陷都会被成倍放大。
1. 时间复杂度过高与盲目嵌套循环
Python 是一门动态解释型语言,单核 CPU 每秒能够完成的基础操作数量大约在 $10^7$ 次左右。若数据规模 $N = 10^5$,算法复杂度为 $O(N^2)$,总操作量会达到 $10^{10}$ 次,理论耗时将达到数百秒,必然超时。
在 Python 中,嵌套循环内包含查询操作是最常见的隐形 $O(N^2)$ 陷阱。例如在列表内执行 in 查找:
# 隐患代码:每次 in 都是 O(N) 遍历,整体复杂度 O(N*M)
target_list = [i for i in range(100000)]
query_items = [i for i in range(50000)]

matched = 0
for item in query_items:
    if item in target_list:  # 列表查找复杂度为 O(N),导致整体性能坍塌
matched += 1修复方案是将列表转为基于哈希表实现的集合(set)或字典(dict),将单次查找的平均时间复杂度压降到 $O(1)$:
# 优化代码:哈希查找 O(1),整体复杂度降低为 O(N + M)
target_set = set(target_list)
matched = sum(1 for item in query_items if item in target_set)
2. 递归深度与无缓存重复计算
解决动态规划或搜索问题时,直接书写纯朴素递归往往会导致指数级复杂度 $O(2^N)$。大量重复子问题反复进入执行栈,不仅浪费 CPU 周期,还会撞上 Python 默认设定的栈深度保护机制。
通过使用标准库 functools.lru_cache 装饰器或直接改用迭代自底向上计算,可以避免无效耗时。
3. 大量标准 I/O 带来的系统调度开销
当在线题目涉及成千上万行数据输入时,Python 内置的 input() 和 print() 会频繁触发用户态到内核态的上下文切换,并处理额外的提示字符串与行缓冲区清理,累积带来数秒的无意义耗时。
针对大数据量场景,应当统一替换为底层缓冲区读取工具:
import sys

# 替换 input() 的高吞吐读取方案
input_data = sys.stdin.read().split()

# 大量输出时,汇总为单一字符串写入 stdout
output_lines = ["result_1", "result_2"]
sys.stdout.write("\n".join(output_lines) + "\n")
4. 循环终止条件设计缺陷(死循环)
如果 while 循环的迭代变量步进未能在所有分支中更新,或边界跳出条件依赖永远无法达到的浮点数全等判断,程序将持续占用沙箱资源直到被平台熔断机制强行截断。
三、常见报错类型的机理与解决方案
除了超时之外,在线运行平台最常抛出四种报错。它们的表现形式明确,排查时应当根据回溯栈(Traceback)逐一处理。
1. RecursionError: maximum recursion depth exceeded
原因:Python 解释器默认限制递归深度为 1000 层左右(视平台环境而定),防止 C 语言级别调用栈溢出导致进程崩溃。
解决方法:对于深度优先遍历(DFS)等场景,如果必须使用深度递归,可手动提升上限(需确保内存够用);更好的方案是将递归改为“显式栈 + while 循环”的迭代写法:
import sys
# 适当调整限制(通常建议设置在 100000 以内)
sys.setrecursionlimit(200000)
2. EOFError: EOF when reading a line
原因:代码在 while True 中调用了 input(),但在后台测试数据已经读取完毕后未做异常判断,依然请求读取不存在的行。
解决方法:捕获 EOFError,或者使用按行迭代器:
import sys

# 推荐规范写法:sys.stdin 会在读取到文件尾部时自动正常终止循环
for line in sys.stdin:
    line_content = line.strip()
    if not line_content:
        continue
    # 处理业务逻辑
3. IndexError: list index out of range
原因:代码假设了测试数据始终满足非空或具备固定长度(例如访问 data[0]),但在线评测往往包含空输入或特殊边界(如长度为 0 的数组)。
解决方法:在读取下标或切片前,显式增加边界与长度校验。
4. MemoryError
原因:过早或不必要地使用列表将海量数据常驻内存。例如在 $N = 10^7$ 时使用 [i for i in range(N)],会导致数百兆连续内存申请。
解决方法:改用生成器(Generator)进行流式按需处理:
# 错误示范:一次性生成包含巨量元素的列表
full_buffer = [compute(x) for x in range(10000000)]

# 推荐示范:使用生成器表达式流式求值
stream_buffer = (compute(x) for x in range(10000000))
total = sum(stream_buffer)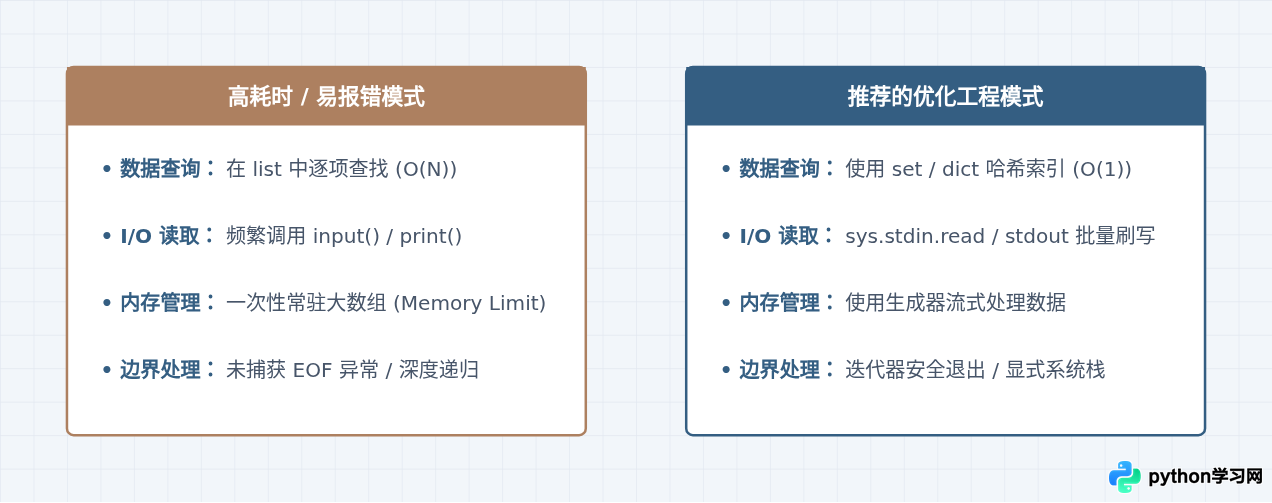
四、标准故障排查四步操作流程
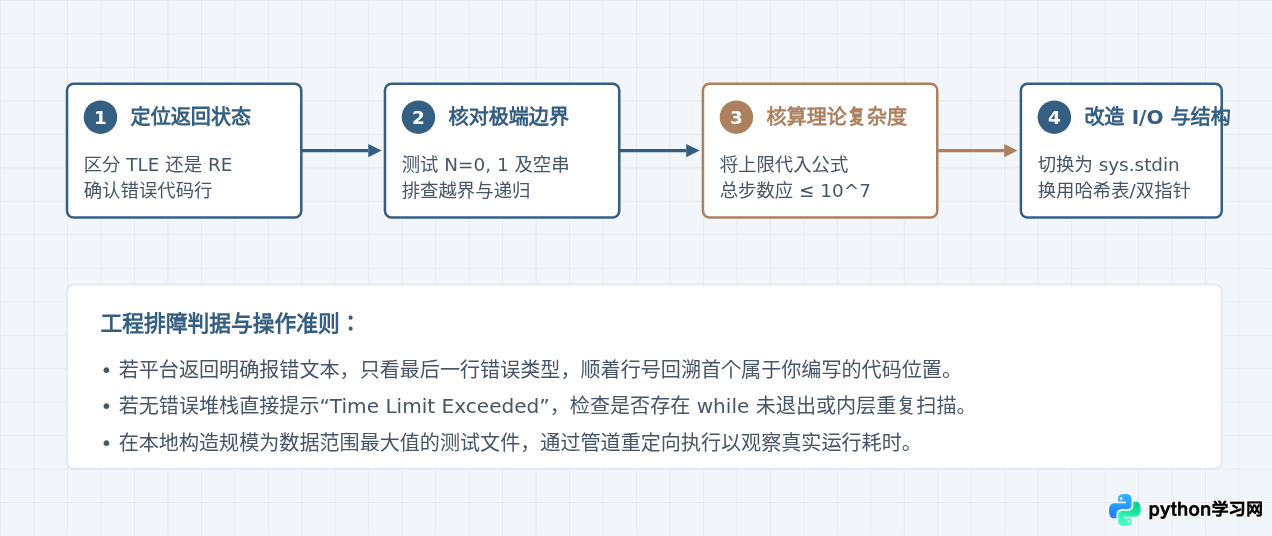
当平台提示超时或报错时,不要盲目逐行猜想,而应按照以下排查顺序逐级收敛问题范围:
-
第一步:通过平台反馈精准区分问题性质
仔细阅读评测结果:如果显示为Runtime Error,控制台通常会输出 Traceback 信息。优先查看最后一行(如IndexError或KeyError),并找到该行所指示的代码行数;如果提示Time Limit Exceeded,则排查重心应放在运算复杂度与死循环上。 -
第二步:核查极值边界数据
在本地运行以下几组极值测试:- 输入为空(无任何有效字符);
- 数据规模最小边界(如 $N = 0$ 或 $N = 1$);
- 所有元素完全相等的特殊序列(可能导致快排退化为 $O(N^2)$ 或二分查找无法跳出)。
-
第三步:代入极限规模进行计算量核算
查看题目描述给出的数据范围。如果题目给定 $N \le 2 \times 10^5$,则 $O(N \log N)$ 算法对应的计算量约为 $2 \times 10^5 \times 18 \approx 3.6 \times 10^6$,可以在 1 秒内通过;若使用 $O(N^2)$ 算法,则计算量达 $4 \times 10^{10}$,必须推翻重写,更换为更高效的算法。 -
第四步:重构标准输入输出与数据结构
当时间复杂度理论上符合要求但仍然被判超时时,将频繁的字符串拼接改为数组join(),将全部的input()替换为sys.stdin.read。
五、综合诊断与排障对照总结
为了在实际编写与调试过程中快速定位故障根源,可以通过下表进行对照确认:
| 具体表现形式 | 大概率原因 | 直接验证方法 | 常规修复手段 |
|---|---|---|---|
| 运行超过 5 秒被系统强制杀掉 (TLE) | 复杂度过高或存在死循环 | 本地注入题目最大数据测试耗时 | 改用哈希表、前缀和、双指针或二分 |
EOFError (RE) |
输入流已读完但仍在循环调用 input | 用包含少量行的输入文件重定向测试 | 改用 for line in sys.stdin |
RecursionError (RE) |
DFS 搜索未设计记忆化或分支过深 | 检查是否有循环引用或未归约参数 | 提高递归上限或使用显式栈迭代 |
MemoryError (MLE) |
申请了过大二维矩阵或全局变量泄露 | 本地通过 tracemalloc 测量内存 |
使用生成器按需迭代,避免预先分配 |
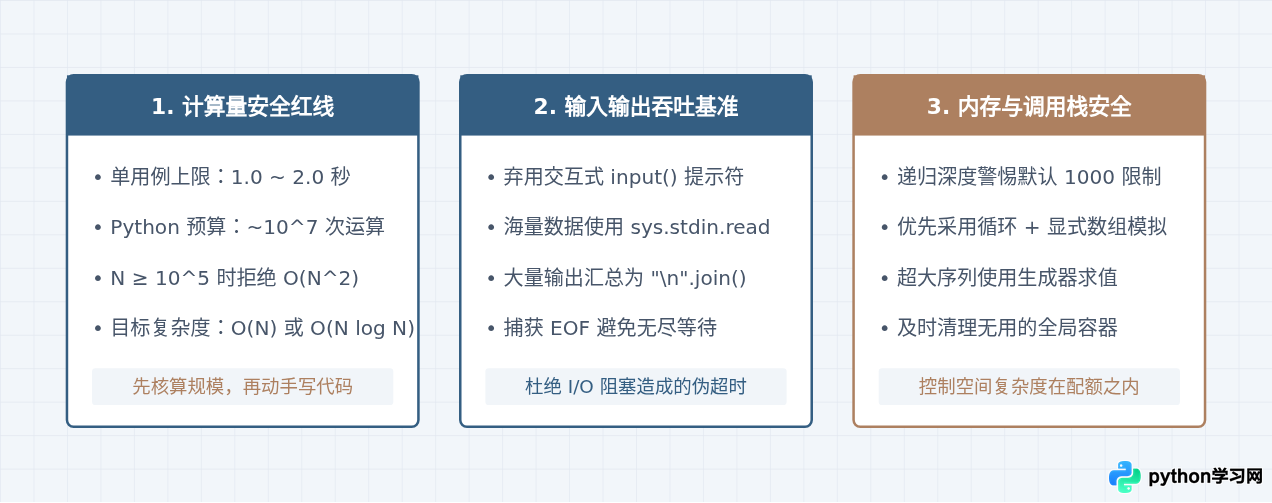
sys.stdin 消除 I/O 阻塞;最后用空值、单元素和全等值三组边界数据跑通逻辑。通过这三步过滤,绝大部分超时与报错都能在短时间内迅速定位并解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









