

Python元组解包技巧:变量交换与函数多返回值处理
深入解析Python元组解包核心机制,详解变量交换无需中间变量的执行时序、函数多返回值的高效接收方式(完全匹配、下划线占位与星号扩展解包),并提供高频异常排查与最佳工程选型。
元组解包(Tuple Unpacking,亦称序列解包)是 Python 最优雅且高频使用的核心特性之一。其核心运行逻辑分为两阶段:Python 首先对赋值语句右侧的表达式完成全量求值并隐式打包(Packing)成一个元组,随后依据位置顺序将元组内的元素指针依次绑定(Unpacking)到左侧的目标变量中。基于这一原子性机制,开发者可以在不借助第三方临时变量的情况下完成安全高效的变量交换,并能以简洁的模式接收函数返回的多个数据项。本文将从底层求值时序出发,深入剖析变量交换的栈操作原理、函数多返回值的多种接收范式(全量解包、占位忽略与星号动态收集),并系统梳理排查解包过程中常见异常的工程化实践。
一、解构语法基石:元组打包与解包的底层机制
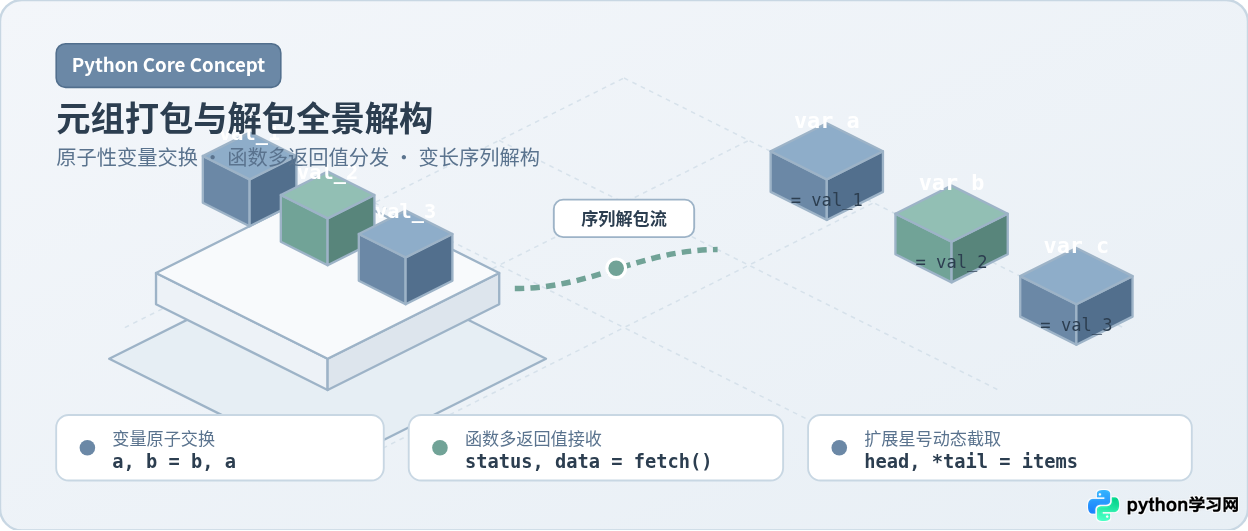
在深入探讨变量交换与多返回值之前,必须先纠正一个常见的认知误区:在 Python 语法中,构建元组的决定性符号是逗号(,),而不是圆括号(())。圆括号的主要作用是消除语法歧义与划定表达式边界。
当我们在赋值语句右侧书写由逗号分隔的多个值时,Python 会自动将它们封装为一个不可变的元组对象,这一过程被称为元组打包(Tuple Packing)。例如:
# 逗号触发自动打包,point 实际为 (100, 200)
point = 100, 200
print(type(point))
反之,当我们将一个包含多个元素的序列赋值给以逗号分隔的一组变量名时,Python 会提取序列中的各项,按位置一一对应地绑定到每个变量上,这一过程就是元组解包(Tuple Unpacking):
x, y = point
print(f"X坐标: {x}, Y坐标: {y}")
元组解包的三步执行生命周期
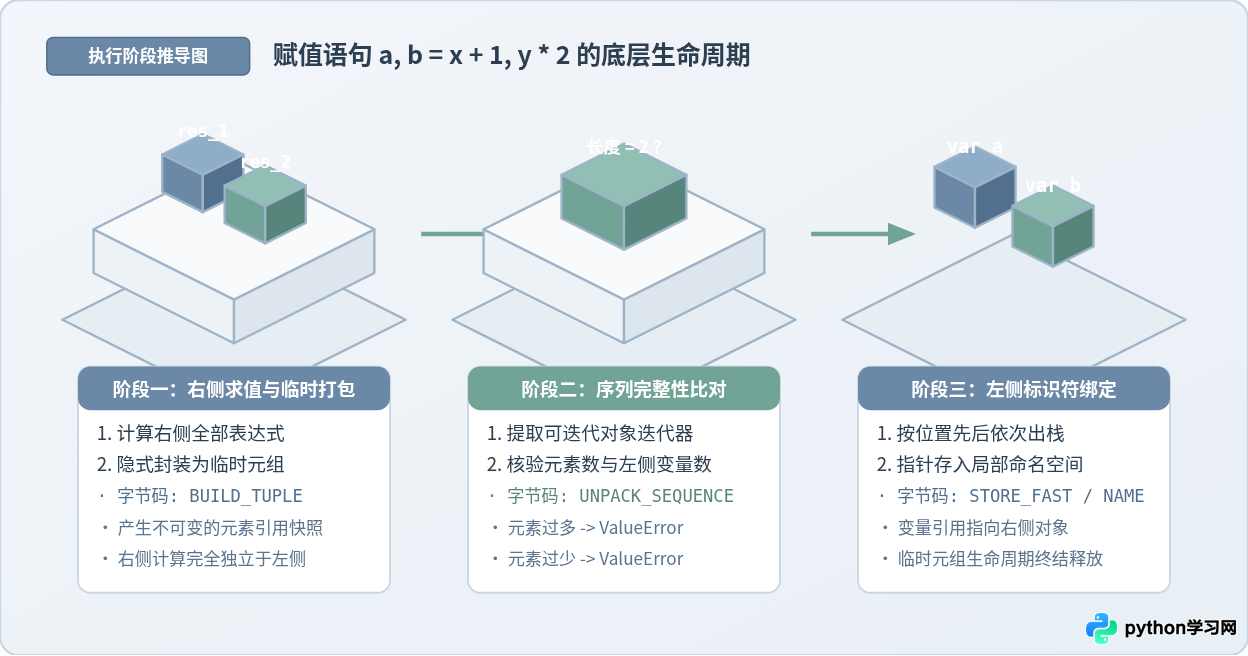
一条看似简单的解包赋值语句(例如 a, b = x + 1, y * 2),在 CPython 解释器内部经历了严谨的三阶段时序:
- 阶段一:右侧表达式全量求值与快照打包(RHS Evaluation):解释器首先完整计算等号右侧的所有表达式。这些值在求值栈上被推入,并通过
BUILD_TUPLE字节码隐式构造成一个不可变元组对象。此时右侧的值已经固化为内存快照,与后续赋值目标没有任何变量引用冲突。 - 阶段二:序列迭代与长度校验(Sequence Validation):解释器调用底层的
UNPACK_SEQUENCE操作,检查元组中元素的数量与左侧待接收变量的数量是否绝对一致。如果长度不匹配,将立即中断并抛出ValueError。 - 阶段三:左侧标识符原子绑定(LHS Target Binding):校验通过后,按从左至右的顺序依次将元组内元素的引用赋给左侧的变量标识符(通过
STORE_FAST或STORE_NAME)。在绑定完成后,临时构建的元组对象引用计数归零并随之销毁。
二、经典变量交换:a, b = b, a 的内部原理与进阶应用
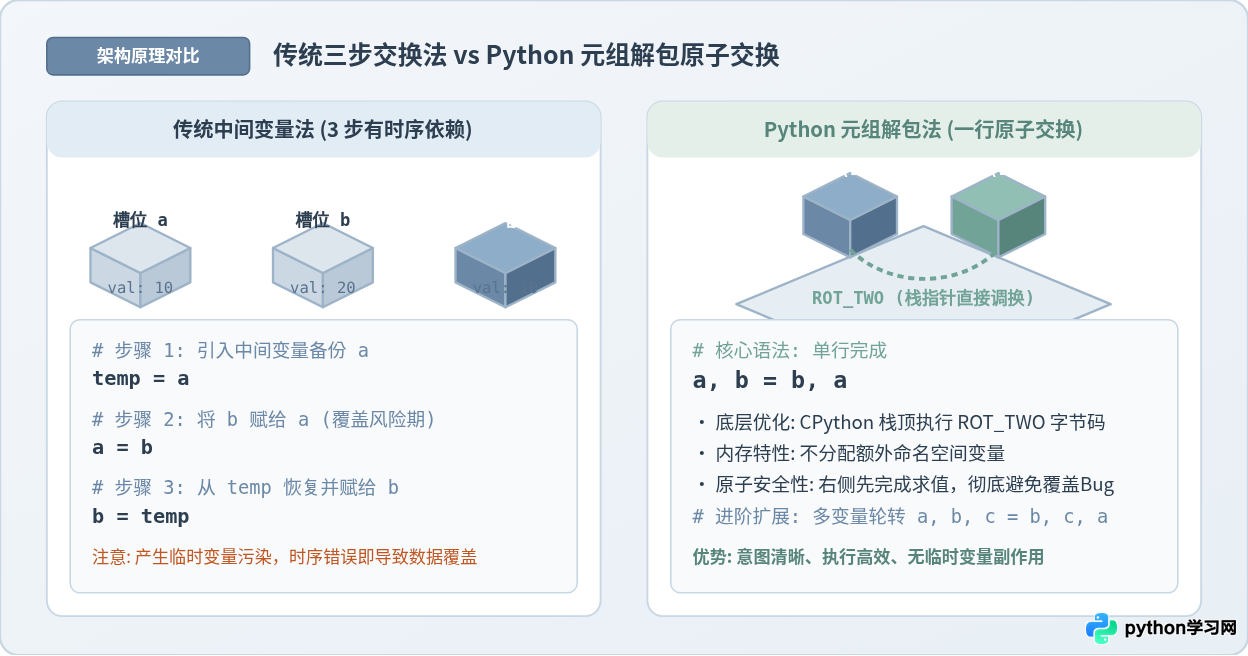
在传统编程语言(如 C 或 Java)中,交换两个变量的值必须引入一个第三方的中间变量 temp 来暂存其中一个值,否则直接赋值会导致原始数据被提前覆盖:
# 传统交换写法:需要 3 行代码与额外命名空间污染
temp = a
a = b
b = temp
这种写法不仅冗长,而且容易在手误写错赋值顺序时引入严重的数据丢失 Bug。而在 Python 中,开发者只需要一行代码即可完成变量交换:
a, b = b, a
为什么 a, b = b, a 不会发生数据相互覆盖?
结合前文介绍的三阶段执行机制,我们可以清晰地还原这行代码的执行真相:
- 在执行赋值之前,右侧的
b, a首先被求值。假设初始时a = 10, b = 20,右侧求值得到的是指向整数对象20和10的指针引用,打包生成了临时元组(20, 10)。 - 随后解包开始:元组第 0 个元素
20被绑定给左侧的变量a;元组第 1 个元素10被绑定给左侧的变量b。 - 在更深层的 CPython 虚拟机优化中,当解包涉及两个简单局部变量的对调时,编译器甚至不会实际在堆上分配元组,而是直接生成一条极度高效的
ROT_TWO字节码指令,直接在执行栈顶调换两个指针的位置,随后赋给目标槽位。
进阶应用:多变量轮转与滑动窗口计算
元组解包的原子性不仅限于两个变量对调,还可以推广到任意数量变量的循环轮转与状态同步迁移。最典型的应用场景是斐波那契数列(Fibonacci)的滑动迭代:
def fibonacci_sequence(n):
    a, b = 0, 1
    result = []
    for _ in range(n):
        result.append(a)
        # a 接收当前 b 的旧值,b 接收 a + b 的计算新值,两步同步生效
        a, b = b, a + b
    return result

print(fibonacci_sequence(7))
在上述代码中,a, b = b, a + b 如果拆解为多行,必须额外引入临时变量保存旧的 a,否则 a + b 就会使用已经被更新后的 a 导致逻辑崩塌。元组解包消除了这一认知负担。
同样地,若需要对三个状态变量进行循环轮转位移:
x, y, z = y, z, x # x<-y, y<-z, z<-x 顺时针轮转
三、函数多返回值处理:模式匹配与优雅接收
在 Python 中,函数可以看起来“返回多个值”,例如:
def parse_network_response():
    status_code = 200
    status_msg = "OK"
    payload = {"user_id": 1001, "name": "Alice"}
    cost_ms = 42.8
    # 逗号分隔返回多个值
    return status_code, status_msg, payload, cost_ms
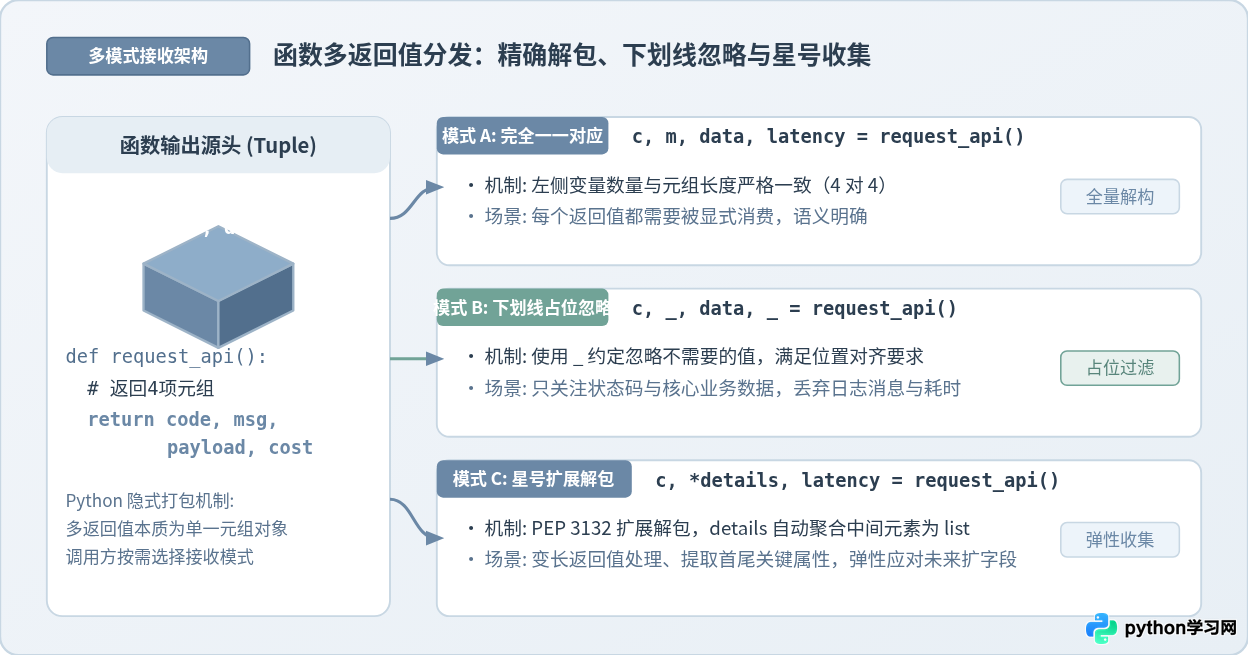
其真相依然是:Python 语言在底层根本不支持原生多返回值,函数只返回了一个对象——即一个包含了这四个元素的元组。调用方之所以能以多种方式接收,完全依赖于元组解包语法。
1. 模式 A:完全一一对应解包
当调用方需要消费函数返回的所有数据项时,使用相同数量的变量显式接收:
code, message, user_data, latency = parse_network_response()
print(f"状态: {code} | 用户: {user_data['name']} | 耗时: {latency}ms")
2. 模式 B:使用单下划线 _ 忽略冗余项
如果调用方只关心其中的某几项,而不需要其余项,直接随意声明无意义的变量名(如 dummy, useless)会造成代码噪音并引发静态检查工具警告。Python 官方推荐使用单个下划线 _ 作为通用的废弃占位符:
# 仅提取 status_code 与 user_data,忽略 msg 与 latency
code, _, user_data, _ = parse_network_response()
3. 模式 C:扩展星号解包(Extended Iterable Unpacking,PEP 3132)
从 Python 3.0 开始引入的 PEP 3132 扩展解包语法,允许在接收变量前加上星号(*)。带星号的变量会自动吸收所有剩余的元素,并将其封装为一个列表(list)。这一特性在面对动态长度序列或多返回值时极为强大:
# 提取首个元素,中间所有元素汇聚至 details,提取最后一个元素
code, *details, latency = parse_network_response()
print(f"Code: {code}")
print(f"Details 集合 (类型: {type(details).__name__}): {details}")
print(f"Latency: {latency}")
Details 集合 (类型: list): ['OK', {'user_id': 1001, 'name': 'Alice'}]
Latency: 42.8
first, *tail = items),也可以放在头部(*head, last = items)或中间(head, *mid, tail = items)。但需特别注意:在一个赋值表达式中,只能出现一次带星号的变量。
四、常见异常排查与边界陷阱防范
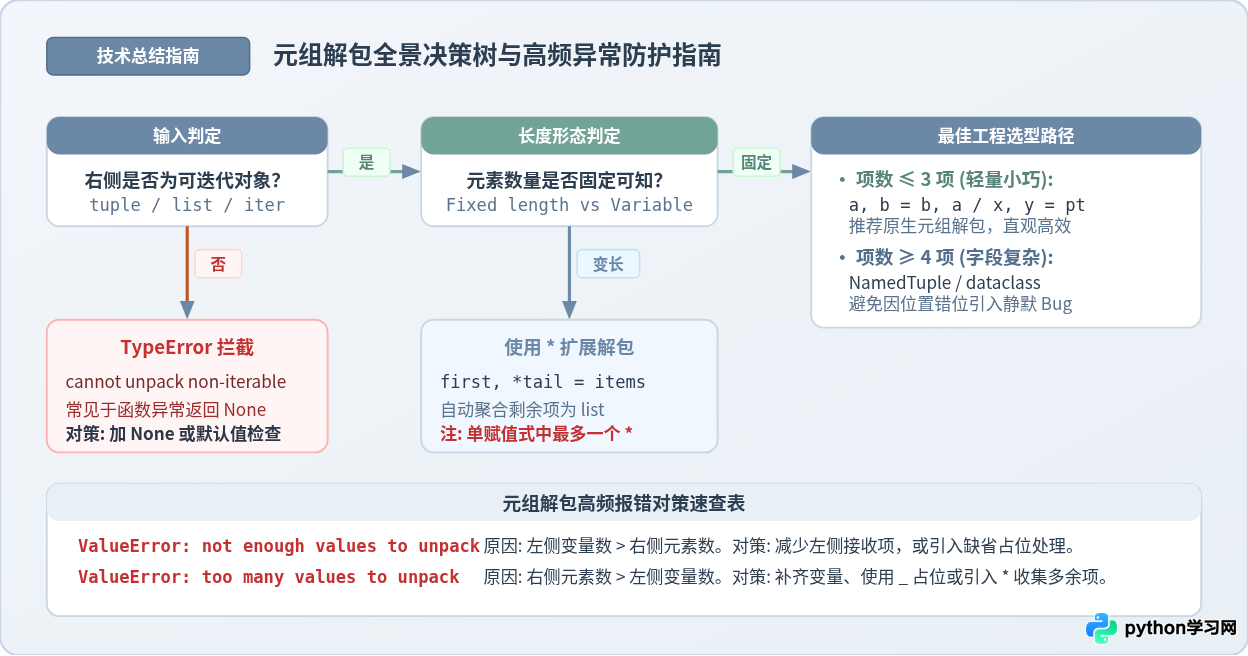
虽然元组解包语法精炼,但在实际开发中,因类型或数量不匹配导致的运行时崩溃屡见不鲜。以下是四种最高频的异常场景及其排查对策:
1. 数量失配:ValueError
当解包两侧的数量无法一一对齐,且未声明星号变量时,CPython 会在阶段二抛出 ValueError:
# 场景 A: 左侧变量少于右侧元素
x, y = (1, 2, 3)
# 报错: ValueError: too many values to unpack (expected 2)

# 场景 B: 左侧变量多于右侧元素
x, y, z = (1, 2)
# 报错: ValueError: not enough values to unpack (expected 3, got 2)
修复方案:如果返回值长度固定,核对并补齐接收变量;如果返回值长度随业务变化(例如数据库查询返回的可变字段),改用星号表达式 x, *rest = data 吸收多余值。
2. 语法冲突:多个星号引发 SyntaxError
如果在同一解包表达式中定义了多个带星号的变量,Python 无法确定各个变量分配元素的边界,会在编译期直接报错:
# 错误写法:无法判定中间分配
*a, b, *c = [1, 2, 3, 4]
# 报错: SyntaxError: multiple starred expressions in assignment
3. 单元素解包与逗号陷阱
当解包只有一个元素的容器时,左侧变量名后面必须保留逗号,否则会退化为普通的单一变量赋值:
single_list = [42]

# 正确解包: a 的值为整数 42
a, = single_list

# 错误写法: b 的值依然是包含一个元素的列表 [42]
b = single_list
4. 不可迭代对象:TypeError
在复杂的业务逻辑中,如果一个函数在正常分支返回元组,但在异常分支误返回了 None 或错误码整数,解包操作就会立即崩溃:
def find_record(record_id):
    if record_id < 0:
        return None  # 异常分支未返回元组
    return "rec-01", "valid"

# 当传入负数时触发崩溃
name, status = find_record(-1)
# 报错: TypeError: cannot unpack non-iterable NoneType object
None,调用端必须显式判定,或由函数统一返回空元组 return () 并配合解包默认值处理,杜绝 TypeError 静默渗透。
五、工程化进阶场景与架构选型建议
除了变量交换和函数调用,元组解包在日常数据处理与工程架构中有着广泛而深度的延伸应用。
1. 字典与迭代器遍历中的复合解包
在循环遍历字典的键值对,或带有序号的列表时,嵌套解包能使循环体内部省去多余的索引查询代码:
service_ports = {"http": 80, "https": 443, "ssh": 22}

# 复合解包:同时解包 enumerate 的序号与 items 的 (key, value)
for index, (protocol, port) in enumerate(service_ports.items(), start=1):
    print(f"[#{index}] 协议: {protocol.upper()} 映射端口: {port}")
[#2] 协议: HTTPS 映射端口: 443
[#3] 协议: SSH 映射端口: 22
2. 深度嵌套数据结构的精准提取
只要左侧变量的嵌套结构与右侧数据容器的层级保持一致,Python 支持多层递归解包:
node = ("gateway-node", ("192.168.1.1", 9000), "RUNNING")

# 内层使用圆括号精准解构嵌套的 (ip, port)
node_name, (host_ip, port), node_status = node
print(f"节点名: {node_name}, IP地址: {host_ip}, 端口: {port}")
3. 架构权衡:何时应该放弃元组解包?
尽管元组解包极其方便,但它高度依赖于位置顺序。当返回值的数量超过 3 到 4 个时,位置解包会带来严重的维护隐患:
- 调用端极易记错变量顺序(例如混淆
created_at与updated_at),产生不会报错但业务完全错误的逻辑 Bug。 - 底层函数一旦新增或调换字段顺序,所有上游调用代码的解包语句全部被破坏。
在大型项目或复杂业务领域中,推荐按照以下对照表进行工程选型升级:
| 数据场景 / 规模 | 推荐技术方案 | 核心收益与适用边界 |
|---|---|---|
| 2~3 个基础属性(如坐标、宽高、键值) | 原生元组解包(Tuple Unpacking) | 极致简洁、无抽象开销、原子交换与模式匹配首选。 |
| 4 个以上只读属性(如用户信息、API响应) | typing.NamedTuple |
支持属性名访问与智能提示,同时完全向后兼容元组解包操作。 |
| 复杂业务领域对象(带校验、默认值、可变) | dataclasses.dataclass |
显式字段类型、自动生成方法,面向对象工程标准。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









