

Anaconda环境下怎么安装Python库?conda与pip的区别及使用
详细解析在Anaconda环境下安装Python第三方库的标准流程,深入对比conda与pip的机制区别、适用场景及混用时的避坑原则。
在Anaconda中安装库,核心机制是先激活目标独立环境,再依据包的来源与依赖类型选用 conda 或 pip。掌握二者底层的环境隔离差异与依赖求解模型,是规避依赖破坏与环境损坏的根本途径。
不少开发者初次接触Anaconda时,常会遇到一个迷惑现象:明明终端提示库安装成功,但在Jupyter Notebook或VS Code中导入时依然报错 ModuleNotFoundError;又或者在安装某个包后,原先可以正常运行的代码突然因为依赖冲突全盘崩溃。这类问题大多不是安装命令打错,而是混淆了当前运行的环境上下文,或是没理清 conda 与 pip 之间协同和冲突的边界。
一、标准的安装工作流:环境切换与库安装
在Anaconda中安装任何第三方库,必须遵守一个铁律:永远不要直接在 base(默认基础环境)中随手安装特定项目的依赖。正确的流程是为每个任务创建独立环境,在目标环境中操作。
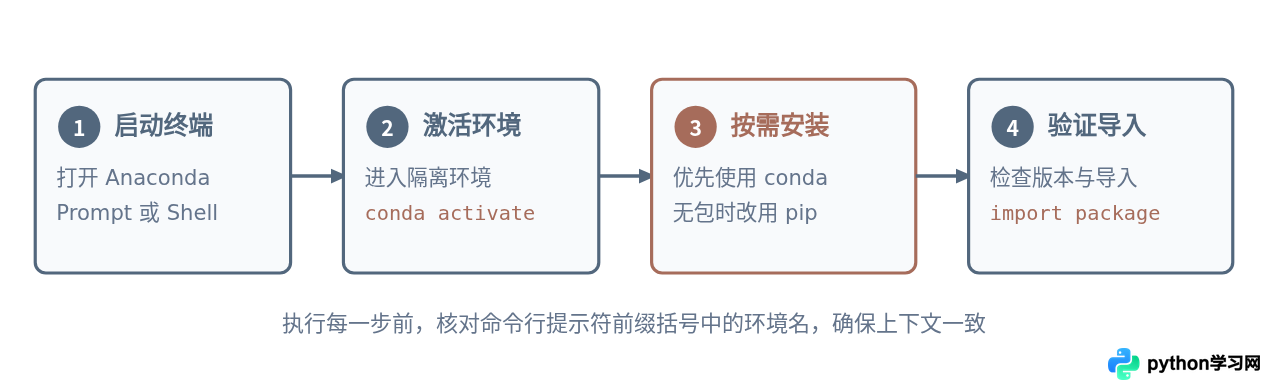
第 1 步:进入正确的命令行界面
在 Windows 平台下,点击开始菜单,找到并启动 Anaconda Prompt(如果配置过系统环境变量,也可使用 PowerShell 或 CMD)。在 macOS 或 Linux 系统下,打开系统自带终端即可。进入终端后,前缀应显示当前环境名称,例如 (base)。
第 2 步:创建并激活隔离环境
如果要开展一个新项目(例如名为 data_analysis,且需要 Python 3.10),请在终端输入:
# 创建一个名为 data_analysis 的新环境,并指定 Python 版本
conda create -n data_analysis python=3.10 -y

# 激活该环境
conda activate data_analysis
执行成功后,终端行首的标记会自动从 (base) 变为 (data_analysis)。
第 3 步:使用包管理器执行安装
在目标环境处于激活状态下,执行安装命令。以安装经典数据科学库 pandas 为例:
# 首选:使用 conda 安装
conda install pandas

# 或者:指定频道安装(如常用的 conda-forge 频道)
conda install -c conda-forge pandas

# 备选:当 conda 仓库没有收录时,使用 pip 安装
pip install pandas
第 4 步:验证是否安装成功
安装完成后,调用 Python 交互界面进行导入测试,确保未遗漏底层依赖:
python -c "import pandas; print('Pandas 版本:', pandas.__version__)"二、深入机制:conda 与 pip 的本质区别
很多初学者常把 conda 单纯视作 Anaconda 里的另一个“pip”。这种认知并不准确。它们在软件范围、依赖解析、包打包机制和安装目录管理上存在根本差异。
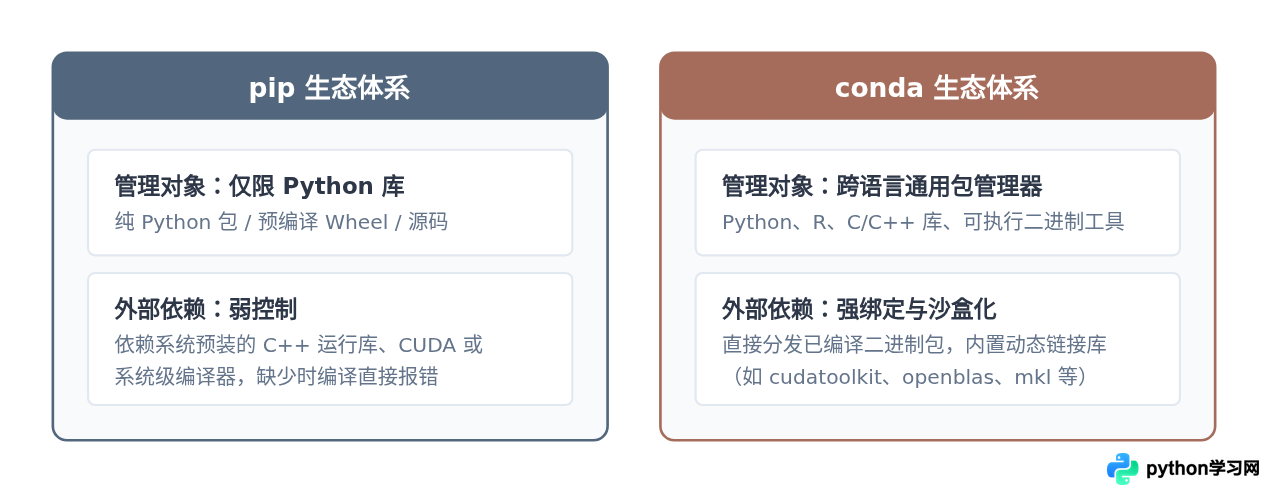
为了更直观地看清两者的技术实现差异,我们将核心属性归纳如下:
| 对比维度 | conda | pip |
|---|---|---|
| 软件定位 | 系统级跨语言包管理器 + 虚拟环境管理器 | Python 专用的官方标准包安装器 |
| 支持语言 | 跨语言(Python, C/C++, R, Fortran 等) | 仅针对 Python |
| 包索引来源 | Anaconda Repo、conda-forge、Bioconda 等 | PyPI(Python Package Index) |
| 二进制与依赖处理 | 严格的 SAT 依赖求解器,包含底层 C 库与工具链 | 依赖 Wheel 预编译包或依赖宿主系统编译器现场构建 |
| 环境感知能力 | 天然感知并能自主创建、导出、销毁隔离环境 | 无内置环境隔离功能,需配合 venv 或 virtualenv |
举个很普遍的例子:当你尝试安装深度学习库 PyTorch 并需要 GPU 加速时。使用 pip install torch 时,如果预编译 Wheel 中没有契合你宿主系统驱动的 CUDA 组件,你必须自行在操作系统层面配置 NVIDIA 驱动套件;而使用 conda install pytorch pytorch-cuda=11.8 -c pytorch -c nvidia 时,conda 会把对应的编译库与基础运行时一并打包进该隔离环境内,互不干扰且不污染宿主操作系统。
三、在实际项目中该如何选择与混用?
既然两者各有所长,到底该选谁?日常使用遵循一个清晰的决策顺序:
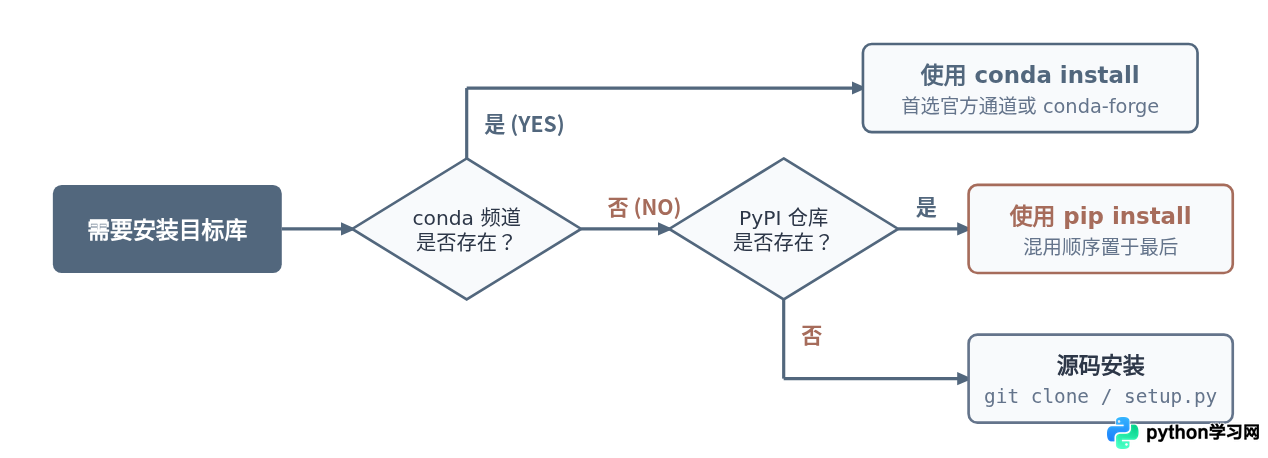
混用时的核心原则:先 conda,后 pip
官方包管理仓库通常落后于 PyPI 的最新更新,因此在同一个环境中混用 conda 和 pip 几乎是所有 Python 开发者避不开的现实。混用本身并不会直接导致崩溃,导致环境崩溃的通常是交替乱用。
核心防踩坑准则:
- 尽可能先通过 conda 完成所有核心库安装:例如
python,numpy,scipy,pytorch或底层科学计算栈。让 conda 的 SAT 求解器先把整个环境的底层图谱规划妥当。 - 将 pip 用作最后补位工具:当且仅当某个特殊库在
conda search <package>以及conda-forge频道均无法检索到时,再启动pip install <package>进行安装。 - 使用 pip 之后,避免再次运行 conda install:因为 pip 安装的元数据 conda 并不总是能够完全掌控,后续再调用
conda install可能会将 pip 刚安装的高版本底层包“强行降级”,引发隐性依赖破坏。
pip install 之前,请务必执行 which pip(Mac/Linux)或 where pip(Windows),确保调用的 pip 路径正位于当前 Anaconda 环境的子目录下(例如 .../anaconda3/envs/data_analysis/bin/pip),而不是操作系统全局 Python 的 pip。
四、避坑指南:依赖冲突与常见报错
1. conda 卡在 "Solving environment" 极度缓慢
由于 conda 默认的解析器需要对海量历史版本的依赖图进行布尔可满足性(SAT)求解,当环境安装包变多时,解析速度会急剧下降。
目前 Anaconda 已经内置了基于 C++ 开发的新一代依赖求解器 libmamba。如果你使用的版本解析速度很慢,可以明确指定采用该加速求解器:
# 临时指定使用 libmamba 加速依赖解析
conda install pandas --solver=libmamba

# 或永久将默认求解器设为 libmamba
conda config --set solver libmamba
2. 环境不可逆损坏时的应急对策
如果由于频繁混用导致依赖冲突已无法调和(如无论安装什么都报依赖不可满足),最明智也是耗时最短的处理方式是“快速放弃并重建”,而不是人工反向降级数十个库。为了降低这种风险,在项目环境健康时应养成导出配置的习惯:
# 导出当前环境完整的配置文件
conda env export > environment.yml

# 当环境损坏时,一键从文件复现全新环境
conda env create -f environment.yml
理解了环境隔离、二进制跨语言依赖以及包求解器的行为逻辑后,安装 Python 库就不再是一件充满不确定性的玄学操作。按顺序、分环境去管理工具链,无论项目如何演进,本地开发环境都能保持干净且可复现的状态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









