

Python列表嵌套与展平:多维列表的处理方法
详细讲解Python中多维嵌套列表的构建、索引访问、数据修改避坑指南,以及针对规则二维列表与任意深度不规则列表的高效展平方法。
在Python中处理表格、坐标矩阵或树状层级数据时,多维嵌套列表是最基础的数据载体。处理这类数据的核心在于两步:在构造与访问时准确把握多维索引和内存引用关系;在提取与清洗时根据嵌套结构的深度与规律性,选用合适的方法将多层列表还原为扁平的一维列表。本文将具体讲解嵌套列表的内部结构、常见陷阱,以及针对规则与不规则嵌套列表的展平方案。
一、什么是嵌套列表及其多维结构
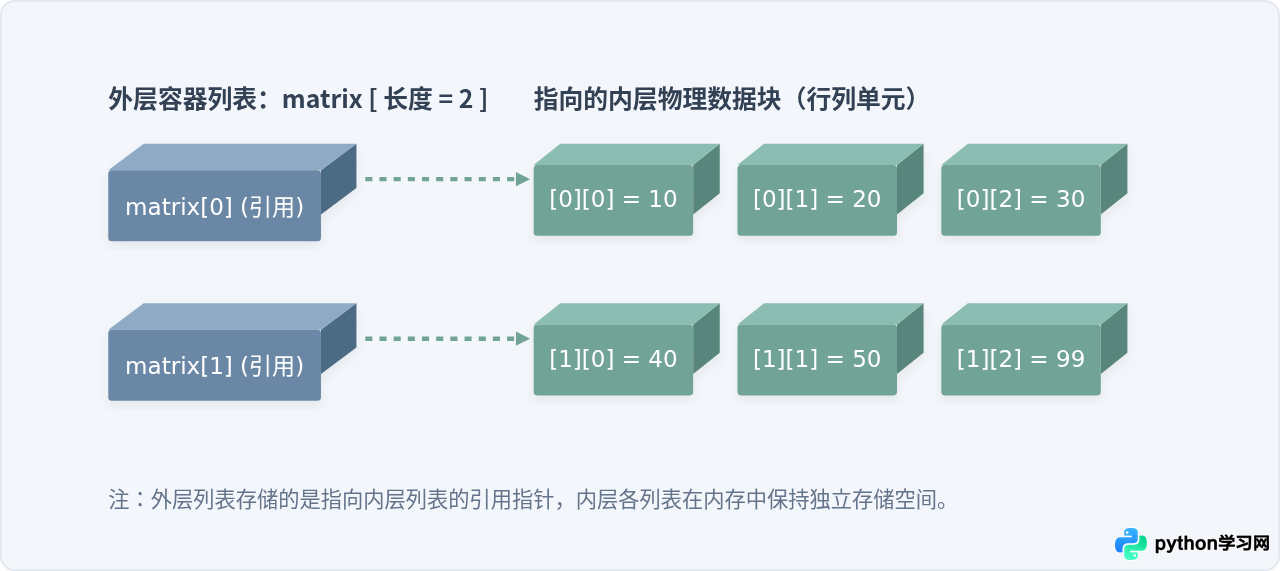
Python的列表可以容纳任意类型的对象。当一个列表的元素本身仍然是列表时,就构成了“嵌套列表”(Nested List)。一个包含子列表的列表在逻辑上等同于二维表格,外层列表的每个元素代表一行,内层列表的每个元素代表该行中的一列。
访问嵌套列表中的具体元素需要使用链式索引语法:第一个方括号指定外层索引(行),随后的方括号指定内层索引(列)。
# 定义一个 2x3 的二维列表
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

# 访问第一行第二个元素(索引均为从 0 开始计数)
val = matrix[0][1]
print("matrix[0][1] 示例输出:", val)

# 修改第二行第三个元素
matrix[1][2] = 99
print("修改后的 matrix 示例输出:", matrix)
# 运行结果输出示例
matrix[0][1] 示例输出: 20
修改后的 matrix 示例输出: [[10, 20, 30], [40, 50, 99]]为了直观展现多维列表在内存引用与逻辑行列之间的映射机制,可以通过下方模块化立体结构图进行对照:
二、初始化嵌套列表的常见浅拷贝陷阱
在需要生成一个固定行数和列数的二维网格时,初学者经常尝试使用乘法操作符 * 进行快速复制。这种写法极易引发“改动一处,整列全变”的逻辑错误。
# 错误示例:使用乘法快速初始化
wrong_matrix = [[0] * 3] * 3
wrong_matrix[0][0] = 7
print("错误初始化结果示例:", wrong_matrix)

# 正确示例:使用列表推导式独立创建每一行
correct_matrix = [[0] * 3 for _ in range(3)]
correct_matrix[0][0] = 7
print("正确推导式结果示例:", correct_matrix)
# 运行结果输出示例
错误初始化结果示例: [[7, 0, 0], [7, 0, 0], [7, 0, 0]]
正确推导式结果示例: [[7, 0, 0], [0, 0, 0], [0, 0, 0]]原因在于:外层的乘法 [[0] * 3] * 3 并没有把内部的列表复制3份,而是将同一个内部列表的内存地址重复引用了3次。修改 wrong_matrix[0] 时,另外两行所指向的其实是同一个内存对象。使用列表推导式时,循环每执行一次,都会在内存中新建一个独立列表,彼此互不干扰。
三、规则二维列表的展平方法
如果嵌套列表结构规整(所有子元素都是深度仅为一层的子列表),将它们压平成一维列表有几种常见解法。
1. 嵌套列表推导式(推荐常用)
列表推导式执行速度快且无需导入外部模块,语法逻辑与普通双重 for 循环的顺序保持完全一致:
nested = [[1, 2, 3], [4, 5], [6, 7, 8, 9]]
flattened = [item for sublist in nested for item in sublist]
print("列表推导式展平输出示例:", flattened)
# 对应传统双重循环理解:
# result = []
# for sublist in nested:
#     for item in sublist:
#         result.append(item)
2. 使用标准库 itertools.chain.from_iterable
当处理大规模列表且需要最高执行性能或流式生成时,标准库模块 itertools 提供了效率更高的迭代器:
import itertools

nested = [[1, 2, 3], [4, 5], [6, 7, 8, 9]]
# 直接传入外层可迭代对象,产生平铺的生成器
flattened_iter = itertools.chain.from_iterable(nested)
flattened = list(flattened_iter)
print("itertools 展平输出示例:", flattened)
3. sum 函数的拼接技巧与使用限制
Python允许通过指定 sum() 的起始值来拼接列表:sum(nested, [])。这种写法非常短小,但它的时间复杂度是二次方级别 $O(N^2)$。每拼接一个子列表,底层都会重新分配一次内存并拷贝历史数据,因此仅适合在快速原型或包含极少元素的小列表上使用,严禁在包含上千个子列表的场景下运行。
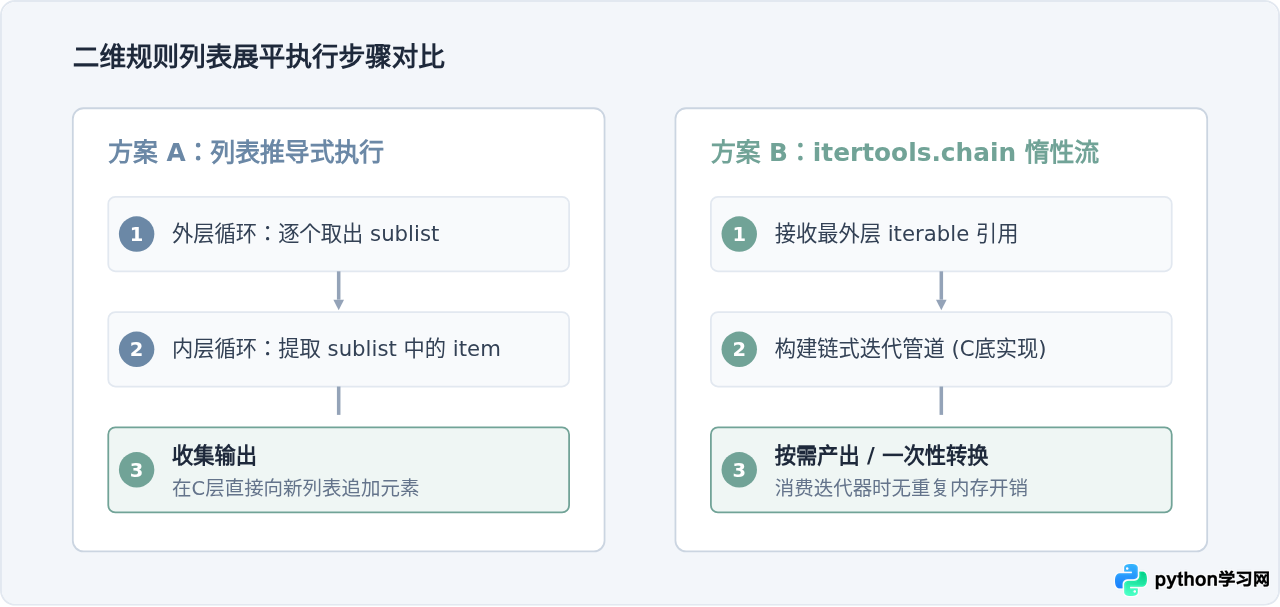
下面通过具体执行流程拆解两种主流展平操作的内部步序:
四、任意深度不规则列表的递归展平
在现实业务中,数据结构往往不会保持整齐划一。例如从JSON解析出的结构可能是 [1, [2, [3, 4], 5], 6],甚至夹杂着字符串、字典或空列表。这种情况下,列表推导式与 itertools.chain 均无法处理深层嵌套。
针对这类数据,可以通过递归生成器解决。判断每个元素是否是列表或集合容器:如果是,则向下递归;如果是普通数据项,则产出该值。
str)和字节(bytes)本身也是可迭代对象。如果仅使用 isinstance(item, Iterable) 做判断,字符串会被当作容器无限拆解成单字符甚至引发栈溢出。因此务必显式排除字符串与字节类型,或明确只判定 (list, tuple)。
from collections.abc import Iterable

def flatten_deep(items, ignore_types=(str, bytes)):
    """
    通用深度递归展平生成器。
    按序遍历多维复杂嵌套列表,提取所有非容器元素。
    """
    for x in items:
        # 如果是可迭代容器且不是字符串类型,向下深入展平
        if isinstance(x, Iterable) and not isinstance(x, ignore_types):
            yield from flatten_deep(x, ignore_types)
        else:
            yield x

# 包含混合深度、元组与字符串的测试数据
deep_nested = [1, "hello", [2, [3, 4, ("tuple_item", 5)], 6], [7, 8]]

# 运行并转为列表查看输出
flattened_result = list(flatten_deep(deep_nested))
print("深度展平输出示例:", flattened_result)
# 运行结果输出示例
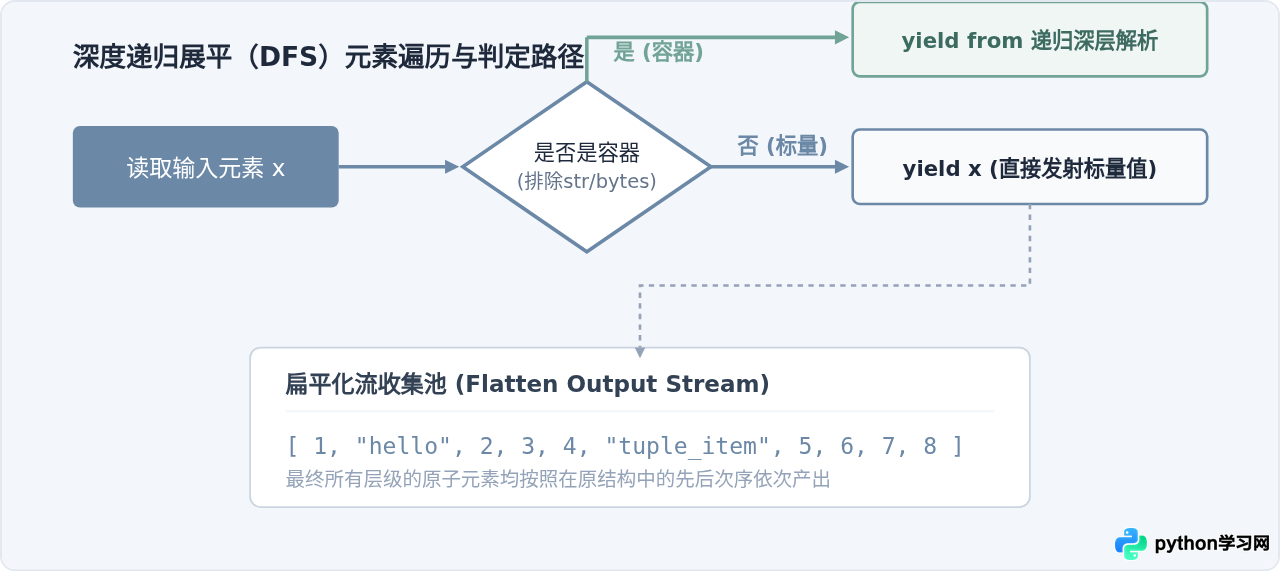
深度展平输出示例: [1, 'hello', 2, 3, 4, 'tuple_item', 5, 6, 7, 8]递归展平的过程本质上是对一棵“数据多叉树”进行深度优先遍历(DFS)。下面展示该递归逻辑的执行判定路径:
五、各展平方案的选择依据与综合对比
在面对不同形态的多维列表时,合理选择工具可以在保持代码简洁的同时避免性能浪费。下表总结了各常见方法的适用边界:
| 方法 | 适用深度 | 时间复杂度 | 依赖 | 核心特点与限制 |
|---|---|---|---|---|
| 列表推导式 | 固定二维 | $O(N)$ | 无(内置) | 直观快速,语法原生,二维首选 |
| itertools.chain | 固定二维 | $O(N)$ | 标准库 | 底层为C迭代器,内存友好,大数据量推荐 |
| 递归生成器 | 任意深层嵌套 | $O(N)$ | 无(需自定义) | 灵活通用,能处理混合类型,受递归栈深度限制 |
| sum(nested, []) | 小规模二维 | $O(N^2)$ | 无(内置) | 代码极短,但二次方复杂度性能低下,严禁用于大列表 |
为便于在工程开发中快速决策,以下为整体处理方案的选择决策图示:
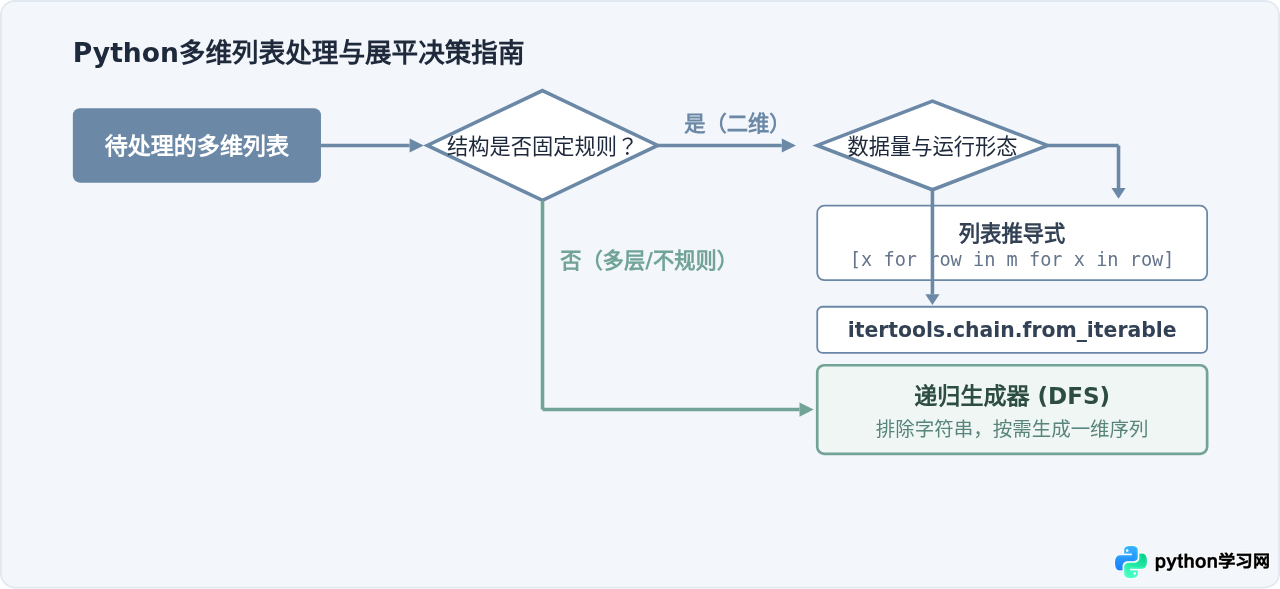
掌握列表嵌套时引用地址的运作规律,不仅能避免在初始化和修改时出现意外数据篡改,还能在需要聚合清洗多维数据时,根据层级特征准确选用推导式、标准库或递归函数,保证数据处理高效且符合预期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









