

Python模块导入语法:import与from...import区别
全面解析Python中import与from...import的核心区别。涵盖命名空间绑定机制、sys.modules缓存原理、变量不可变性陷阱、循环导入产生原因与排查步骤,以及大型项目中的导入规范选型指南。
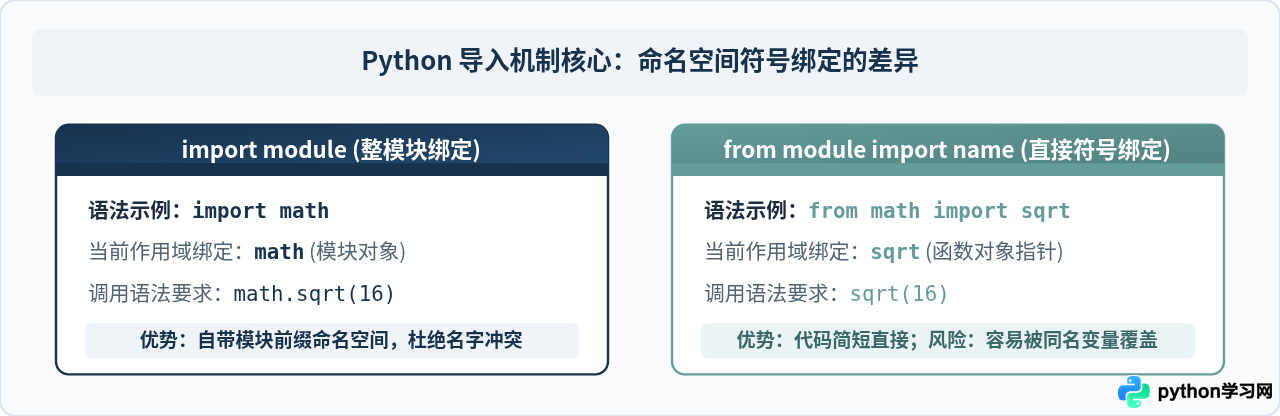
import 模块名 与 from 模块名 import 成员名 的核心区别不在于模块是否被加载进内存,而在于当前命名空间绑定的符号对象不同。两者在首次执行时都会完整解析目标模块并存入全局缓存 sys.modules,但前者将模块对象本身绑定到当前命名空间,调用时必须携带模块前缀;后者则直接将模块内部的具体函数、类或变量提取并绑定到当前命名空间,调用时无需前缀。
一、底层运行机制:模块加载与符号绑定
许多初学者存在一个误区,认为 from math import sqrt 只会加载 math 模块中的 sqrt 函数,而 import math 才会加载整个模块,进而推断前者比后者更省内存或执行更快。这种理解是不符合 Python 解释器实际运行机制的。
无论采用哪种导入语法,Python 在背后的加载步骤都是完全一致的:
- 检索与查找:检查模块是否已经存在于全局缓存
sys.modules中。如果未加载,解释器会按照sys.path中的路径列表依次查找对应的.py或已编译文件。 - 编译与执行:创建新的模块对象,从头到尾执行模块文件的所有顶层代码(包括定义类、函数、赋值变量等),将模块内部所有的属性和符号存入该模块的字典空间中。
- 全局缓存:将该模块对象登记到
sys.modules字典中。后续无论在哪个文件中再次导入该模块,都不会重复执行模块代码,而是直接从缓存读取。 - 当前作用域绑定(核心差异点):根据导入语法的不同,在当前代码执行的作用域(
globals())中绑定不同的符号引用。
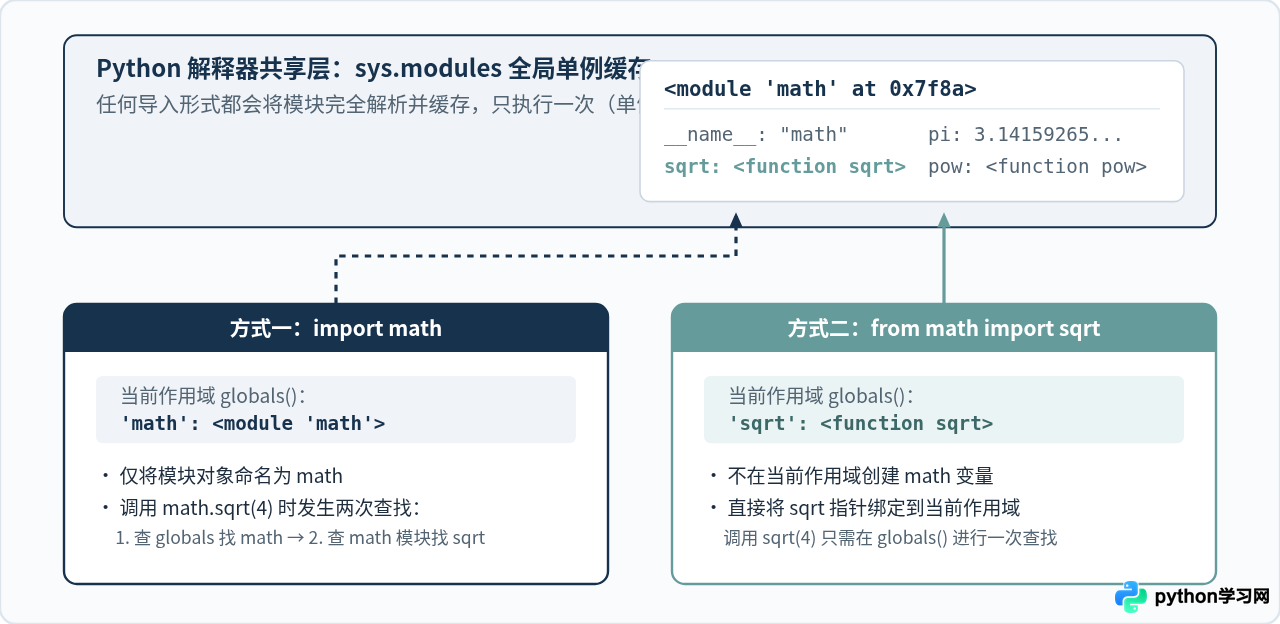
我们可以通过代码直接打印当前模块的 globals() 字典验证上述结论:
# 场景一:使用 import math
import math

print("math" in globals())  # 输出: True
print("sqrt" in globals())  # 输出: False
print(math.sqrt(9))         # 输出: 3.0

# 场景二:使用 from math import sqrt
from math import sqrt

print("math" in globals())  # 输出: False (当前作用域并无 math 变量)
print("sqrt" in globals())  # 输出: True (直接将 sqrt 绑定到 globals)
print(sqrt(9))              # 输出: 3.0
二、语法形态与日常使用场景对照
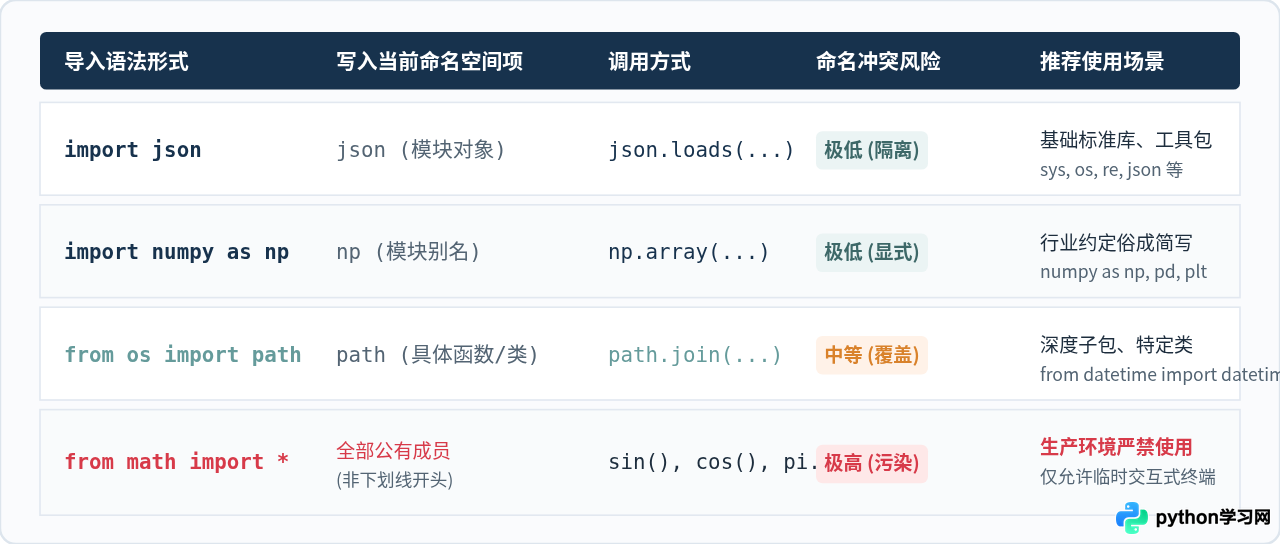
在实际编码中,导入语句存在多种衍生写法(如别名重命名、批量导入、通配符导入等)。理解它们各自对应的命名空间行为是合理选型的关键。
1. 别名导入(as 语法)
当模块名称较长或多个库中存在同名类时,可以使用 as 关键字为导入对象重命名:
# 场景一:缩短冗长模块名(数据分析标准惯例)
import numpy as np
import pandas as pd

# 场景二:解决类名冲突
from sqlmodel import Session as SQLSession
from requests import Session as HTTPSession
2. 通配符导入(* 导入)的隐患
from module import * 会将目标模块中所有不以下划线开头的对象全部注入当前命名空间。这种做法存在三个严重问题:
- 隐式名称覆盖:如果两个模块都定义了名为
close或open的函数,后导入的模块会毫无警示地覆盖掉前面的定义。 - 代码可读性极差:阅读代码的人无法通过静态文本判断某个函数或变量究竟源自哪个模块。
- 破坏静态代码检查工具:Pylance、Mypy、Flake8 等代码分析工具将难以进行类型推断与自动补全。
三、核心差异深究:变量重绑定与模块状态修改
除了命名空间的前缀差异外,import 与 from...import 在处理全局变量的修改时表现出截然不同的行为。这是日常排错中最易忽视的陷阱之一。
假设我们有一个配置模块 config.py:
# config.py
retry_count = 3
server_settings = {"timeout": 30}
不可变对象(如整数、字符串)的重绑定陷阱
如果使用 from config import retry_count,当前作用域中的 retry_count 只是在导入那一刻指向了整数 3。如果某个模块修改了该值,另一个文件是感知不到的:
# service_a.py
from config import retry_count

# 注意:这仅仅是在当前 service_a 模块的命名空间中让 retry_count 指向了 5
# config 模块内部的 retry_count 并没有改变!
retry_count = 5

# ---------------------------------------------
# service_b.py
import config

print(config.retry_count) # 仍然输出: 3(并没有变成 5!)若希望在多模块之间共享并修改全局状态,必须使用 import config 并通过属性访问进行修改:
# 正确做法:直接修改模块对象的属性
import config

config.retry_count = 5 # 这会直接修改 sys.modules 中 config 模块对象的属性字典from module import var 是将目标对象的当前引用复制到本地命名空间;对不可变对象的“修改”实际上是本地变量的重新赋值(Rebinding),不会反向同步给源模块。若需要修改或监控模块级状态,请始终使用 import module。
四、循环导入(Circular Import)问题与排查步骤
循环导入(Circular Dependency)是大型 Python 项目中极易遭遇的运行时错误,其常见表现形式为:ImportError: cannot import name 'xxx' from partially initialized module。在循环依赖中,from...import 远比 import 更脆弱。
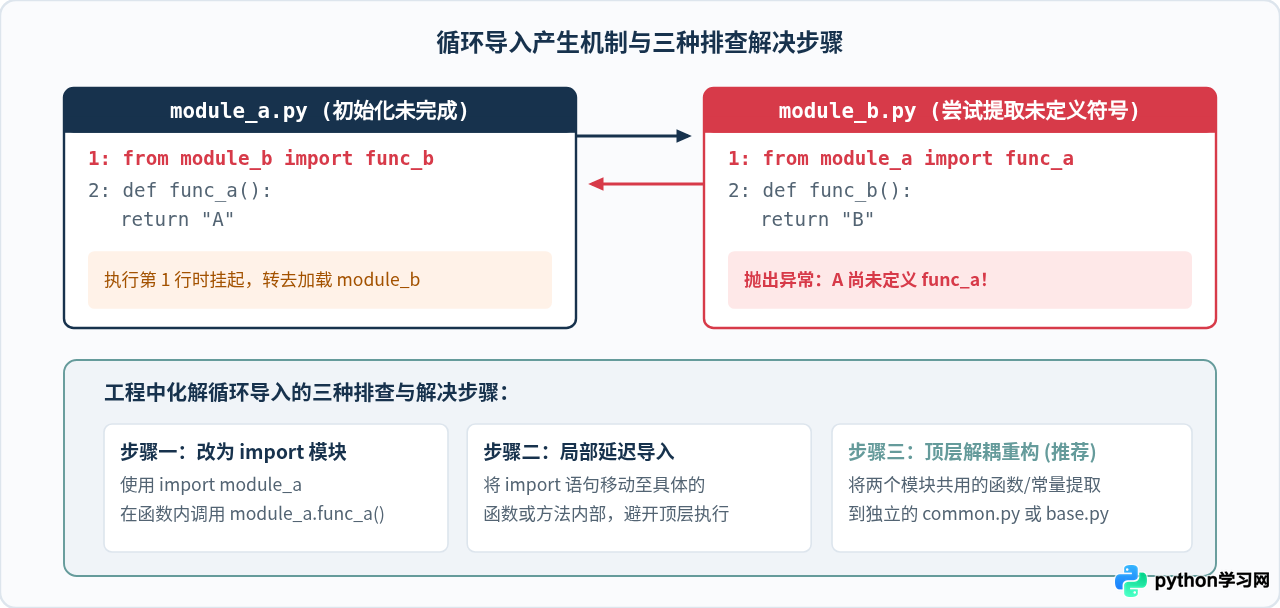
为什么 from...import 会更容易报错?
当 Python 执行 from module_a import func_a 时,它要求 module_a 此时必须已经拥有 func_a 这个属性。但在循环引用中,module_a 刚执行到第一行就被中断去加载 module_b,此时 func_a 根本还没被定义,因此抛出 cannot import name。
如果改用 import module_a,Python 只在当前命名空间创建模块对象的占位符,只要在真正调用 module_a.func_a() 之前 module_a 已经完成加载,程序就能正常运行。
五、选型指南与工程最佳实践
在实际工程架构中,如何在这两者之间做出规范、合理的选择?遵循 PEP 8(Python官方代码风格指南)以及主流开源项目的规范,可以归纳出清晰的决策流程:
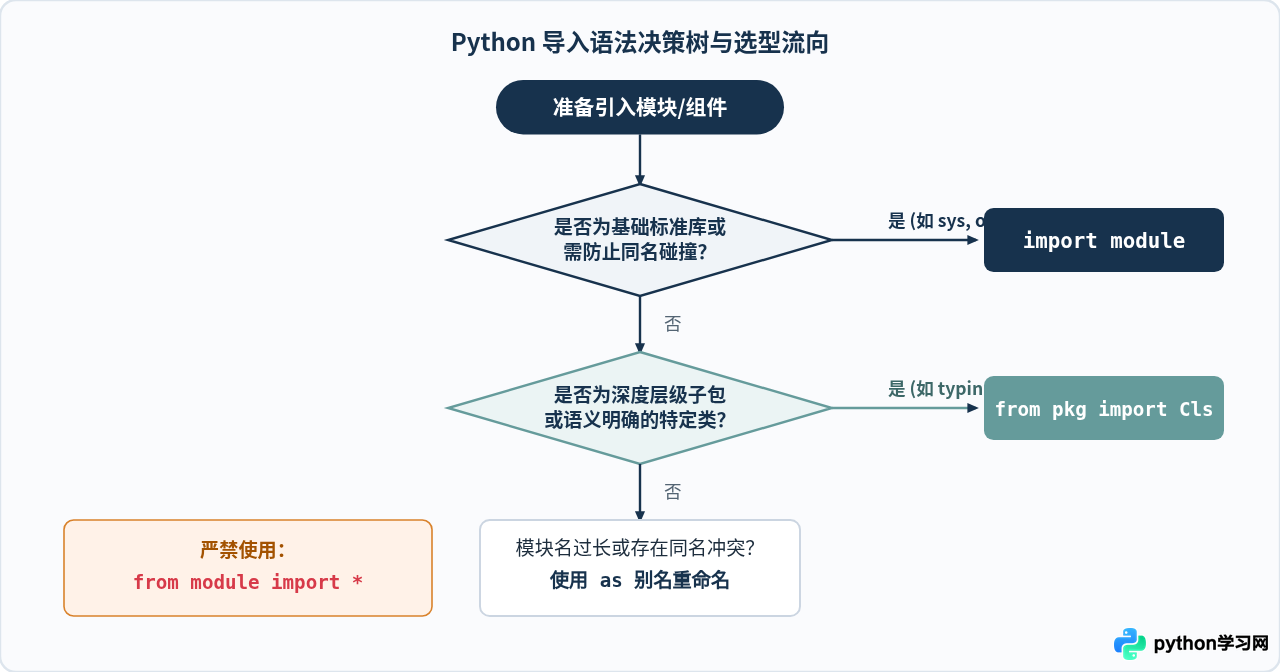
生产环境推荐规范:
- 标准库基础模块优先整模块导入:对于
import sys、import os、import time、import json,保留模块名前缀能够让阅读者一眼明晰函数的来源,例如os.remove()比直接一个孤立的remove()更加具备自解释性。 - 层级深的子模块与类型注解推荐
from...import:当包层级达到三四级时(例如from app.infrastructure.database.models import UserModel),如果不使用from...import,在代码中每次书写app.infrastructure.database.models.UserModel()会极度臃肿。 - 导入顺序分组(PEP 8 标准):文件顶部的导入应按以下顺序分块,各组之间空一行:
- 标准库导入(Standard library imports)
- 第三方库导入(Related third party imports)
- 本地应用/特定库导入(Local application/library specific imports)
六、总结
回到文章开头的核心问题,import 与 from...import 的本质差异并非性能或加载内容的多寡,而是命名空间隔离性与调用便利性之间的权衡:
- 使用
import module时,你获得了一个具备严谨隔离边界的命名空间,适合短小的核心库、需要共享修改全局状态的模块,以及防止局部名称污染的场景。 - 使用
from module import symbol时,你换取了更精炼的本地调用代码,适合长路径子包、不可重名的核心类和类型注解,但需警惕名称覆盖与循环引用的脆弱性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









