

Python中自然常数e怎么输入:使用math.e获取准确值
在Python中输入自然常数e的标准方法是导入内置math模块并使用math.e。本文详解math.e的准确获取方式、浮点数精度特征、计算e的x次方时的函数选择以及常见误区。
在 Python 中,自然常数 e(欧拉数)并没有被设计为内置的全局关键字或字面量,直接输入单个字母 e 会触发 NameError。要获取其符合 IEEE 754 双精度浮点标准的准确值,最标准、可靠的方式是导入 Python 内置的 math 模块,读取其中的 math.e 常量。本文将清晰讲解 math.e 的标准使用方法、数值精度原理,以及在指数运算中为何应优先选用专用函数。
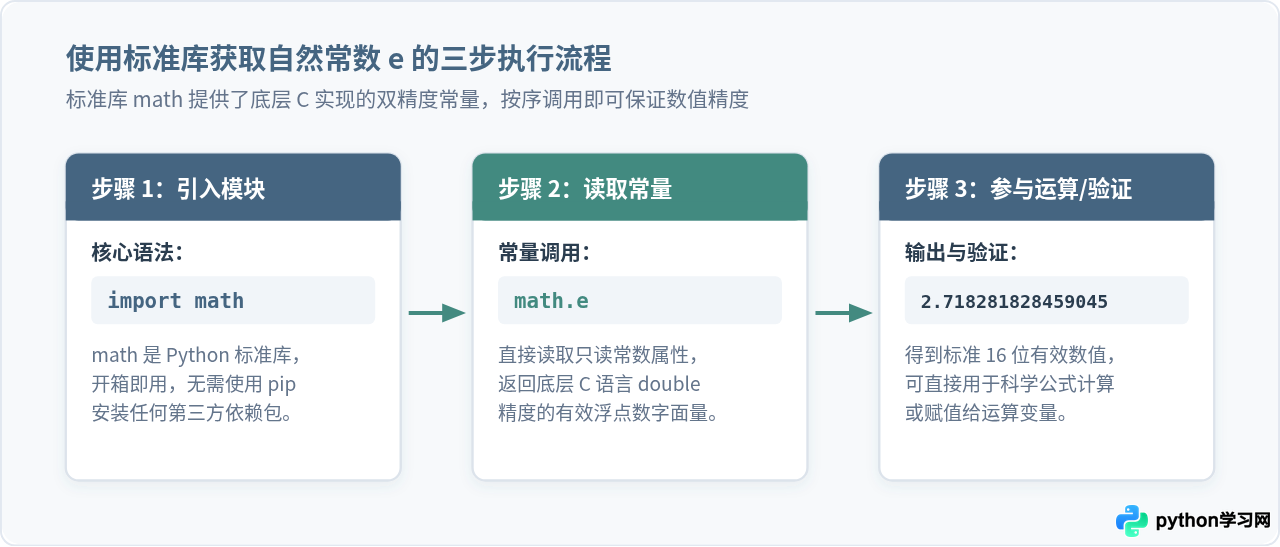
一、快速输入:使用 math.e 的两种标准语法
Python 将数学相关的常用函数和常量集中在标准库 math 中。因为这是内置模块,开发者不需要通过终端执行 pip install 安装任何第三方库,在任何支持 Python 的环境中都可以直接调用。
1. 完整模块导入(推荐)
最常见且最推荐的写法是在代码开头导入 math,随后通过命名空间访问 math.e。这种写法清晰明了,不会与代码中定义的同名变量产生冲突:
# 导入标准数学库
import math

# 打印自然常数 e 的精确值
print(math.e)

# 参与日常数学公式计算,例如计算 2 * e
result = 2 * math.e
print("计算结果:", result)计算结果: 5.43656365691809
2. 单独引入常量
如果当前脚本涉及大量频繁的数学计算,且确认局部作用域内不会定义名为 e 的变量,也可以直接从模块中按需导入:
# 直接引入常数 e
from math import e

# 直接使用名称 e
print("自然常数:", e)
value = e + 1.0
print("e + 1 =", value)e + 1 = 3.718281828459045
二、为什么不能手动写 2.71828?精度与截断误差
初学者在编写简单公式时,有时为了省去导入模块的步骤,会直接在代码中手动输入 2.718 或 2.71828。这种做法在严谨的工程与科学计算中存在严重隐患。
Python 的浮点数遵循 IEEE 754 双精度标准(64位),其尾数部分拥有 53 位二进制精度,换算为十进制相当于 15 到 17 位的有效数字。math.e 的底层实现对应 C 运行时库的最高精度浮点硬编码常量,取值为 2.718281828459045。
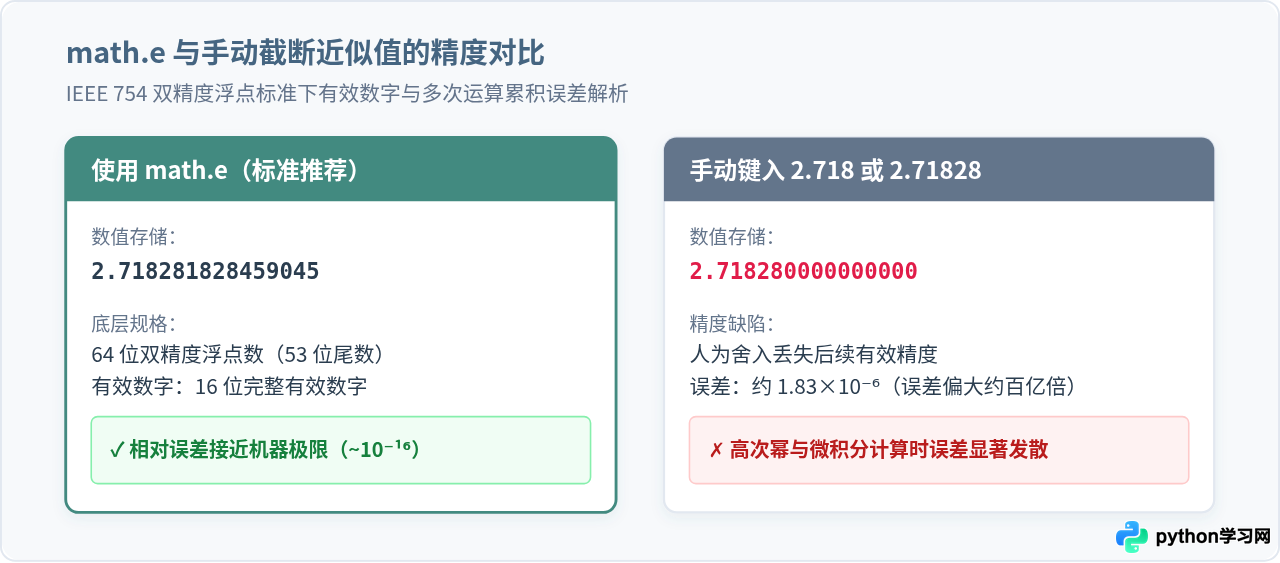
若手动书写近似值,有效位数被人为截断,会引入固定的初始舍入误差:
- 手写
2.718:误差约为2.818×10⁻⁴; - 手写
2.71828:误差约为1.828×10⁻⁶; - 使用
math.e:误差小于1.0×10⁻¹⁶,达到硬件浮点数的精度极限。
在复利计算、概率密度函数积分或常微分方程数值求解等迭代过程中,初始微小的精度损失会随运算步数指数级扩散,导致最终结果发生严重漂移。
三、计算 e 的 x 次方:为什么强烈建议使用 math.exp(x)
在涉及自然常数的实际应用中,单纯使用 $e$ 本身的场景并不多,绝大多数场景是在计算自然指数 $e^x$。很多开发者习惯性地使用乘方运算符写作 math.e ** x,但这并不是最佳实践。
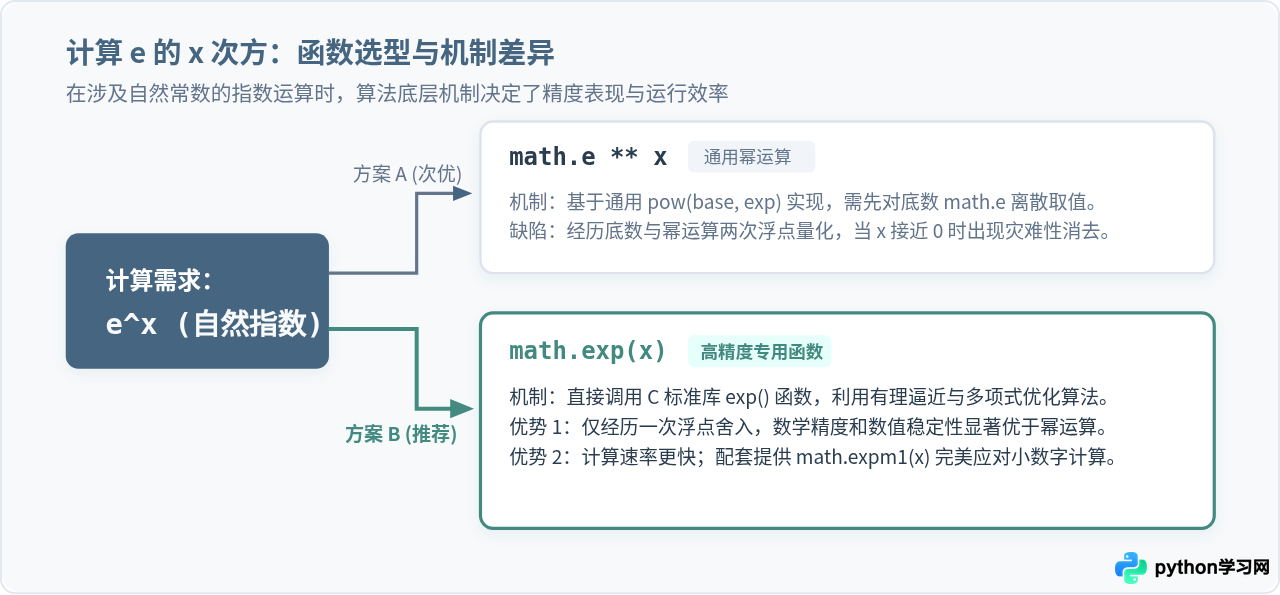
Python 标准库专门提供了计算自然指数的函数 math.exp(x)。对比二者的底层机制,math.exp(x) 具有显著优势:
- 避免双重舍入误差:
math.e ** x本质上调用了通用幂运算pow(base, exp)。计算机首先将math.e视为普通浮点底数,再执行对数和幂逼近,经历了底数截断与幂运算两次舍入;而math.exp(x)是针对基数 $e$ 专门优化的 C 语言库函数,直接采用多项式/有理函数逼近算法,只经历一次舍入。 - 极限情况下的数值稳定性: 当 $x$ 极其接近 0 时,
math.exp(x)依然能保持出色的精度。如果需要计算 $e^x - 1$,标准库还提供了配套的math.expm1(x)函数,可以彻底避免小数字相减时的严重消去误差。 - 运行性能更优: 专有指数函数省略了通用底数展开的判断分支,在基准测试中运行速度普遍快于普通的乘方运算符。
import math

x = 0.05

# 方式一:乘方运算(次选)
res_pow = math.e ** x

# 方式二:专用指数函数(推荐)
res_exp = math.exp(x)

print(f"math.e ** x  = {res_pow:.17f}")
print(f"math.exp(x)  = {res_exp:.17f}")
print(f"两者差值 = {abs(res_pow - res_exp)}")math.exp(x) = 1.05127109637602414
两者差值 = 0.0
四、常见误区与避坑指南
在日常开发与数据处理中,关于自然常数 $e$ 容易出现以下几种典型误解:
初学者容易受代数直觉影响,直接写 print(e)。Python 语言本身没有将 e 设为保留常数,未声明直接使用会报 NameError: name 'e' is not defined。此外,切忌将循环临时变量命名为 e(例如 except Exception as e: 或 for e in list:),这会覆盖已从 from math import e 引入的常量定义。
Python 支持浮点数的科学计数法,例如 1e3 表示 $1 imes 10^3 = 1000.0$,2.5e-2 表示 $2.5 imes 10^-2 = 0.025$。此处的字母 e 或 E 属于字面量语法标记,代表以 10 为底的指数,与自然常数 $e$ 没有任何数学关联。
在使用科学计算库 SciPy 时,部分开发者会直接从 scipy.constants 中导入 e。请特别注意:在 scipy.constants 模块中,e 代表的是物理学中的基本电荷(Elementary charge),其数值约为 1.602176634e-19 库仑,并非自然常数。若在数学公式中误用将产生致命逻辑错误。
拓展:科学计算中的 numpy.e
在处理多维数组和大规模矩阵运算时,如果使用了 NumPy,也可以直接使用 numpy.e。它的数值同样为 2.718281828459045,并且能够无缝配合 NumPy 的矢量化运算:
import numpy as np

# 验证 numpy.e 的取值
print("numpy.e:", np.e)

# 对数组进行指数计算
arr = np.array([0.0, 1.0, 2.0])
print("批量计算 exp(arr):", np.exp(arr))批量计算 exp(arr): [1. 2.71828183 7.3890561 ]
五、核心要点总结速查
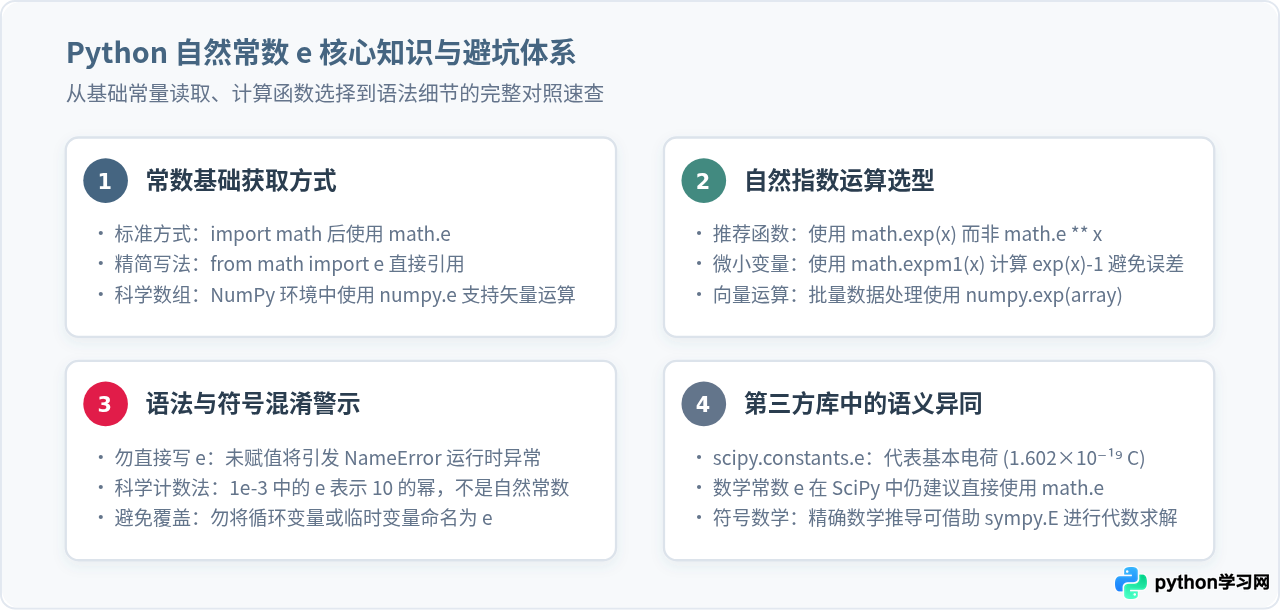
为了便于在日常编写代码时快速决策,以下是关键场景下的选择清单:
| 需求场景 | 推荐写法 | 备选/说明 |
|---|---|---|
| 获取自然常数 $e$ 单个值 | import mathmath.e |
标准库内置,保证双精度最高有效数字(约 2.718281828459045) |
| 计算自然指数 $e^x$ | math.exp(x) |
强烈推荐。避免 math.e ** x 的双重舍入误差,性能更优 |
| 计算微小变量 $e^x - 1$ | math.expm1(x) |
在 $x o 0$ 时避免精度损失,专门用于高精度数值分析 |
| 数组/矩阵批量指数计算 | import numpy as npnp.exp(arr) |
NumPy 矢量化计算;NumPy 同样提供常数 np.e |
| 避免常见语法错误 | 避免单字母 e 命名变量 |
区分科学计数法(如 1e-3)与自然常数;警惕 scipy.constants.e 为基本电荷 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









