

Python切片返回新对象还是引用?浅拷贝机制解析
深入解析Python切片操作返回的是新对象还是引用。通过内存指针模型、代码示例与图解,系统阐明浅拷贝机制、嵌套对象修改陷阱以及不可变序列的特殊优化。
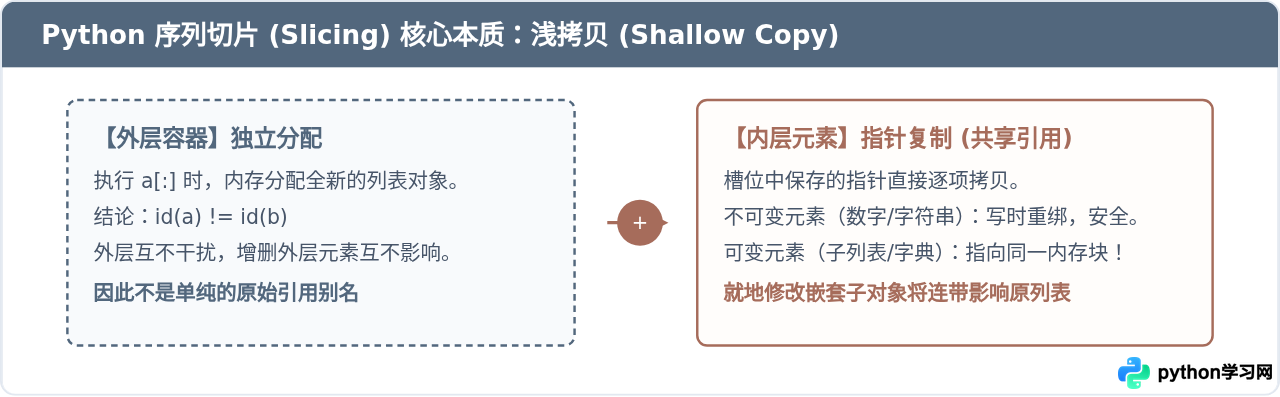
b = a[:] 或 b = a[1:3])时,既不是单纯的引用传递,也不是彻底独立的深层复制,而是创建了一个全新的外层容器对象,但内部所有元素直接复用原有的对象引用——这种行为就是标准的“浅拷贝”(Shallow Copy)。理解这一机制,是规避数据意外联动与内存隐患的关键。
一、直观现象:切片是新对象,为什么改动还会“串门”?
很多初学者接触 Python 时,常常在两个看似矛盾的实验现象之间产生困惑:
一方面,如果直接赋值 b = a,修改 b 的任何元素原列表 a 都会跟着变,因为两者指向同一个列表;而用切片 b = a[:] 后,给 b[0] 重新赋值,a[0] 却纹丝不动,此时检查 b is a 也返回 False。这让很多人得出“切片会返回一个完全独立的新对象”的结论。
但另一方面,当列表包含嵌套结构时,这个结论会瞬间被打破。看下面这段典型的测试代码:
# 示例 1:一维纯基础数据与嵌套可变数据的切片对比
original = [100, [1, 2]]
sliced = original[:]

# 1. 验证外层容器是否是同一个对象
print("original 与 sliced 是否同一对象:", original is sliced)

# 2. 修改第一项(不可变对象:整数)
sliced[0] = 999
print("修改 sliced[0] 后的 original[0]:", original[0])

# 3. 就地修改第二项(可变嵌套对象:子列表)
sliced[1].append(3)
print("修改 sliced[1] 后的 original[1]:", original[1])修改 sliced[0] 后的 original[0]: 100
修改 sliced[1] 后的 original[1]: [1, 2, 3]
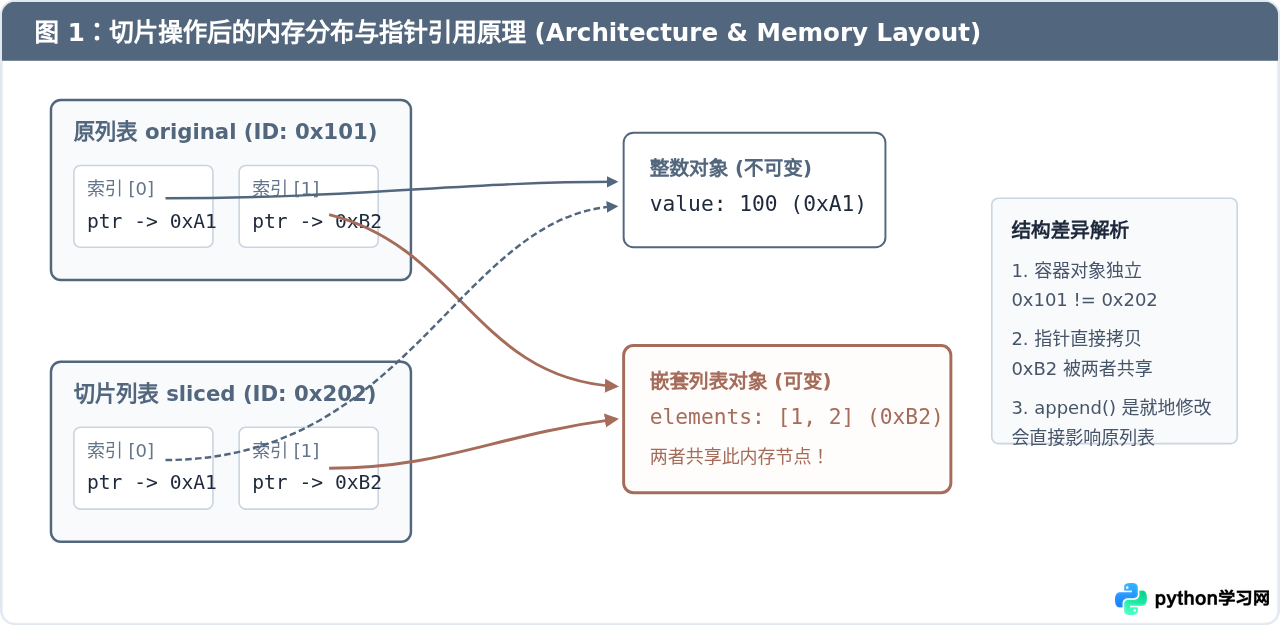
为什么 sliced[0] = 999 没有改变 original,但 sliced[1].append(3) 却直接渗透到了 original 中?答案就在 Python 列表底层的指针结构与浅拷贝机制中。
二、浅拷贝的底层运作机制
在 CPython 实现中,列表本质上是一个指针数组(连续存放指向各个对象的 PyObject* 指针)。
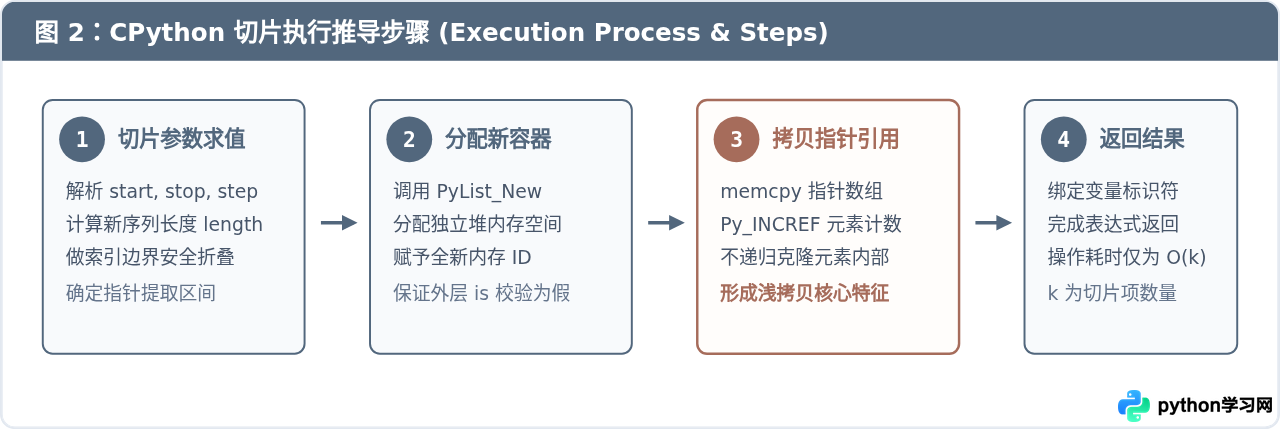
当执行切片表达式 original[start:stop:step] 时,解释器内部调用对应底层函数(例如 list_slice):
- 计算切片长度并分配新内存:依据指定的区间范围和步长,计算出新列表需要的容量,在堆内存中开辟一个新的
PyListObject。 - 逐项复制指针地址:将原列表中对应范围内的元素指针地址直接按顺序拷贝到新列表的内部数组中。
- 递增引用计数:对于每一个被复制指针的对象,将其引用计数加 1(
Py_INCREF)。 - 返回新列表:将新分配的列表对象指针返回给 Python 运行环境。
整个流程只拷贝了最外层的“收纳盒”(外层列表结构),盒子里装的卡片地址原封不动地抄写了一遍,而并没有递归深入到每一个对象内部去克隆一份实体。这就是浅拷贝的本质。
三、修改行为差异:重新赋值 vs 就地修改
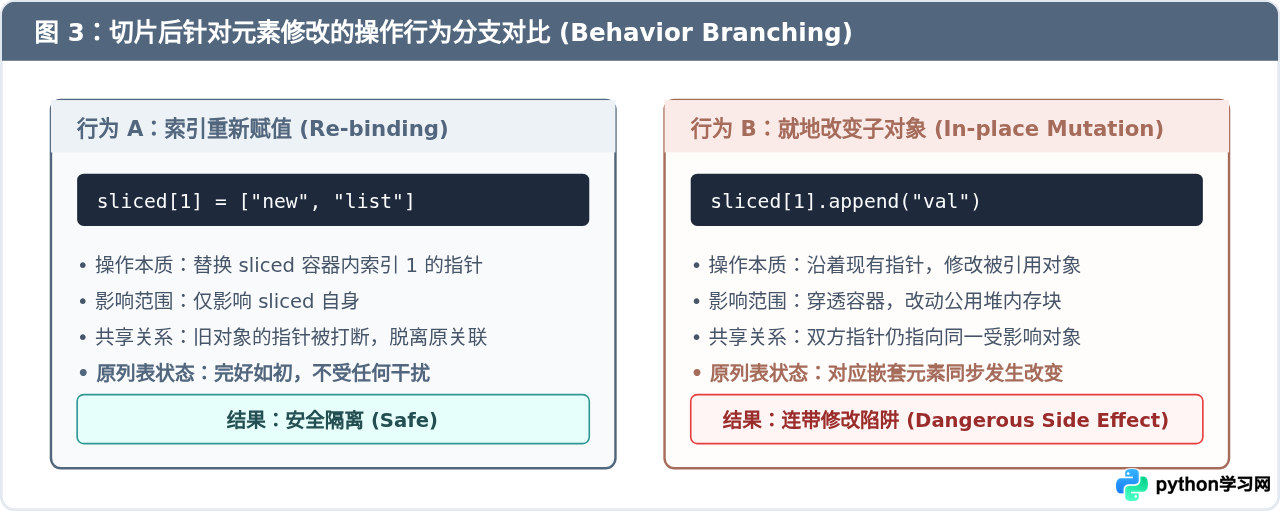
很多开发者之所以写出隐藏 bug,是因为混淆了“对切片列表索引重新赋值”与“对切片列表元素做就地修改(In-place Mutation)”。
1. 重新赋值:打断指针引用(安全)
当执行 b[0] = 999 或 b[1] = [5, 6] 时,发生的操作是修改新列表容器自身第 0 号或第 1 号槽位里保存的指针地址,让它改指到一个新的内存对象。这个改写只发生在新列表自身内部,原列表对应的槽位依然保留原指针,因此完全不会对原列表产生任何反向影响。
2. 就地修改:沿指针穿透修改共享对象(危险)
当执行 b[1].append(3) 或 b[1]["key"] = val 时,b[1] 首先通过槽位解析出了嵌套子对象的地址 0xB2,然后直接调用了该子对象自身的方法来改变其内部状态。由于原列表的槽位也指向 0xB2,因此原列表“看”过去的数据同步发生了变化。
四、不可变序列切片的特殊优化:`str` 与 `tuple`
值得特别说明的是,上述“必定产生新外层容器”的结论适用于可变序列(如 list、bytearray)。但在不可变序列(如 tuple、str、bytes)中,Python 引入了极致的内存优化:
# 示例 2:不可变类型的全切片优化现象
t1 = (1, 2, 3)
t2 = t1[:]
print("元组全切片是否为同一对象:", t1 is t2)  # True

s1 = "hello_python"
s2 = s1[:]
print("字符串全切片是否为同一对象:", s1 is s2)  # True

# 但如果切片产生的是子集:
t3 = t1[0:2]
print("元组子切片是否为同一对象:", t1 is t3) # False字符串全切片是否为同一对象: True
元组子切片是否为同一对象: False
因为不可变对象一旦生成就不可篡改,即便两个变量共享同一个不可变对象,也绝不存在通过其中一个变量偷偷修改内容、导致另一个变量受影响的风险。因此,CPython 针对 tuple[:] 和 str[:] 采取了直接返回原引用的优化策略,既避免了重复分配内存,又加快了执行效率。
tuple[:] is tuple 的恒真假设;只要把切片理解为“概念上的浅拷贝”,你的代码逻辑在任何实现中都始终成立。
五、直接赋值、浅拷贝与深拷贝的选型总结
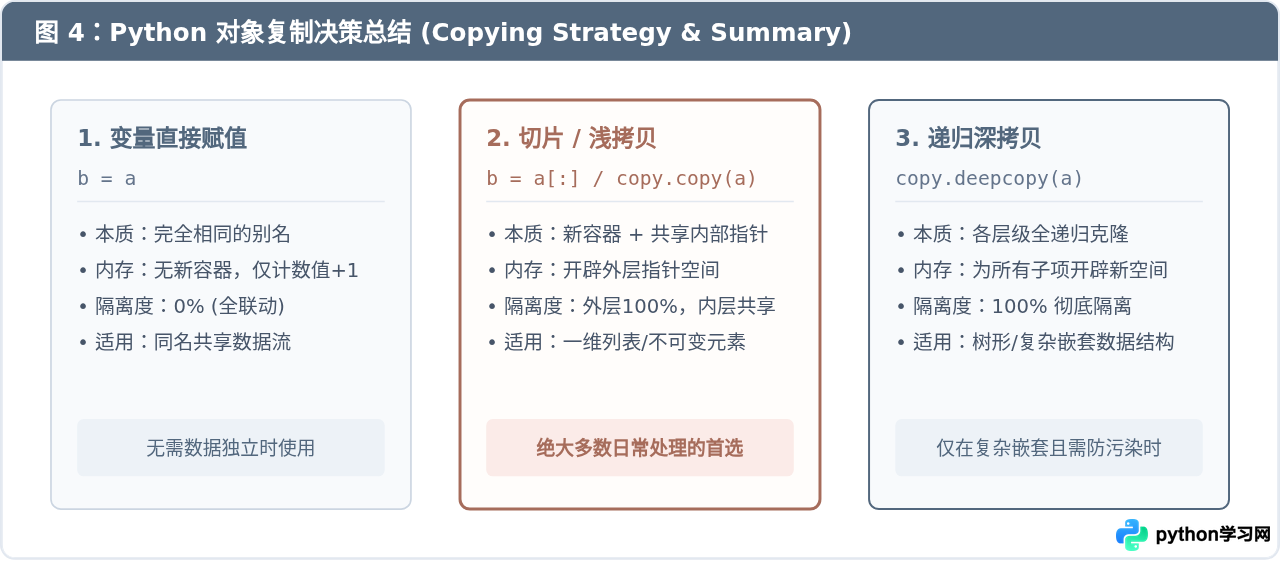
在日常开发中,面对数据复制需求,开发者常在 =(赋值)、切片 [:] / copy.copy()(浅拷贝)和 copy.deepcopy()(深拷贝)之间权衡:
| 操作方式 | 典型语法 | 外层容器 | 嵌套子对象 | 性能开销 | 适用场景 |
|---|---|---|---|---|---|
| 直接赋值 | b = a |
共享同一对象 | 完全同一 | 最小 (O(1)) | 仅需增加别名,明确希望双向同步修改 |
| 切片 / 浅拷贝 | b = a[:]b = list(a)b = copy.copy(a) |
全新对象 | 共享引用 (指针复制) | 适中 (O(k)) | 一维列表、或确定内部元素皆为不可变类型 |
| 深拷贝 | b = copy.deepcopy(a) |
全新对象 | 递归克隆所有层级 | 最大 (较高内存与递归开销) | 多层嵌套结构,且必须彻底杜绝副作用污染 |
六、排查与自检清单
当你不确定某段代码中的切片是否能安全使用时,可以通过以下步骤进行快速自检:
- 使用
is操作符核对身份:打印b is a。如果返回False,说明外层容器已经隔离;如果返回True,说明是赋值别名或触发了不可变优化。 - 核对内部元素 ID:随机抽取嵌套对象打印
id(b[i]) == id(a[i])。如果为True且该元素类型是list或dict,就要警惕后续不要使用.append()、.update()或pop()等就地修改方法。 - 有防御需求直接深拷贝:在编写公共类库、处理用户传入的复杂 JSON/配置字典或处理多维矩阵(非 NumPy)时,若需保证原参数不受污染,优先引入
import copy; data = copy.deepcopy(input_data)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









