

Python怎么用切片快速反转字符串?负步长用法解析
全面解析在Python中利用切片s[::-1]快速反转字符串的具体写法与底层原理。包含正负步长默认值机制、索引执行过程拆解、边界陷阱排查、性能基准分析及Unicode字形簇处理。
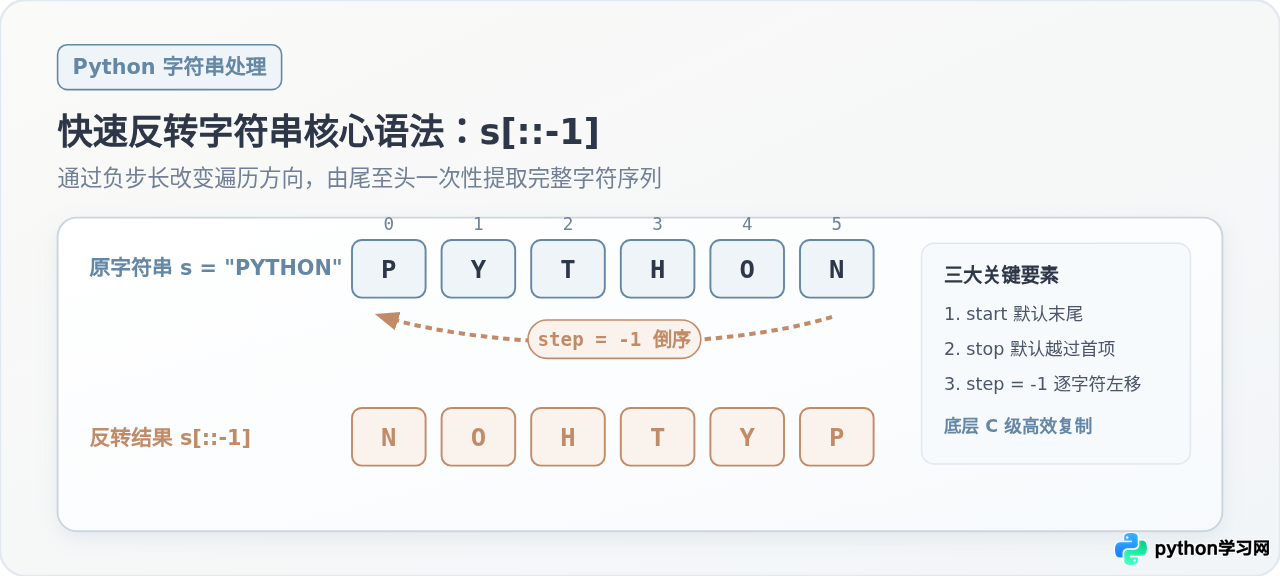
在 Python 中,反转字符串最快速、最简洁的标准做法是使用切片语法 s[::-1]。它的原理在于将切片的步长(step)设定为 -1,指示 Python 从序列最右侧向最左侧逐个提取字符。由于切片操作在 CPython 底层直接调用 C 语言级别的内存指针搬移,它不仅省去了编写循环的繁琐,也在运行性能上大幅超越了显式循环和常规拼接方案。
一、核心写法:一秒上手的单行代码
在交互式终端或脚本中,反转任意字符串只需对该变量追加 [::-1]。切片操作不会修改原始字符串(因为 Python 的 str 对象是不可变的),而是返回一个全新的、字符倒序排列的字符串对象。
# 示例 1:基础英文反转
original_text = "hello"
reversed_text = original_text[::-1]
print("反转结果:", reversed_text)
# 示例输出:olleh

# 示例 2:中文字符反转
slogan = "人生苦短我用Python"
print("中文字符反转:", slogan[::-1])
# 示例输出:nohtyP用我短苦生人

# 示例 3:判断是否为回文字符串(从前往后与从后往前完全相同)
word = "level"
is_palindrome = (word == word[::-1])
print(f"'{word}' 是回文吗?", is_palindrome)
# 示例输出:'level' 是回文吗? True
很多初学者会产生疑问:这里的两个冒号代表什么?为什么省略了两边的数字,只保留一个 -1 就能精确反转整段字符串?答案就在 Python 切片的参数默认值机制中。
二、语法拆解:负步长改变了什么?
Python 切片的完整语法形式为 sequence[start:stop:step],接受三个参数:
- start(起始索引):切片开始提取的位置,结果中包含该位置的元素(闭区间)。
- stop(终止索引):切片停止提取的边界,结果中不包含该位置的元素(开区间)。
- step(步长):提取元素的跨度与方向。绝对值决定跨度,符号决定方向。
关键的转折点在于 步长的正负符号直接颠覆了 start 和 stop 的默认缺省规则。当步长为正(如默认的 +1)时,序列从左向右读取;而一旦步长为负,Python 会切换为自右向左的逆向提取模式。
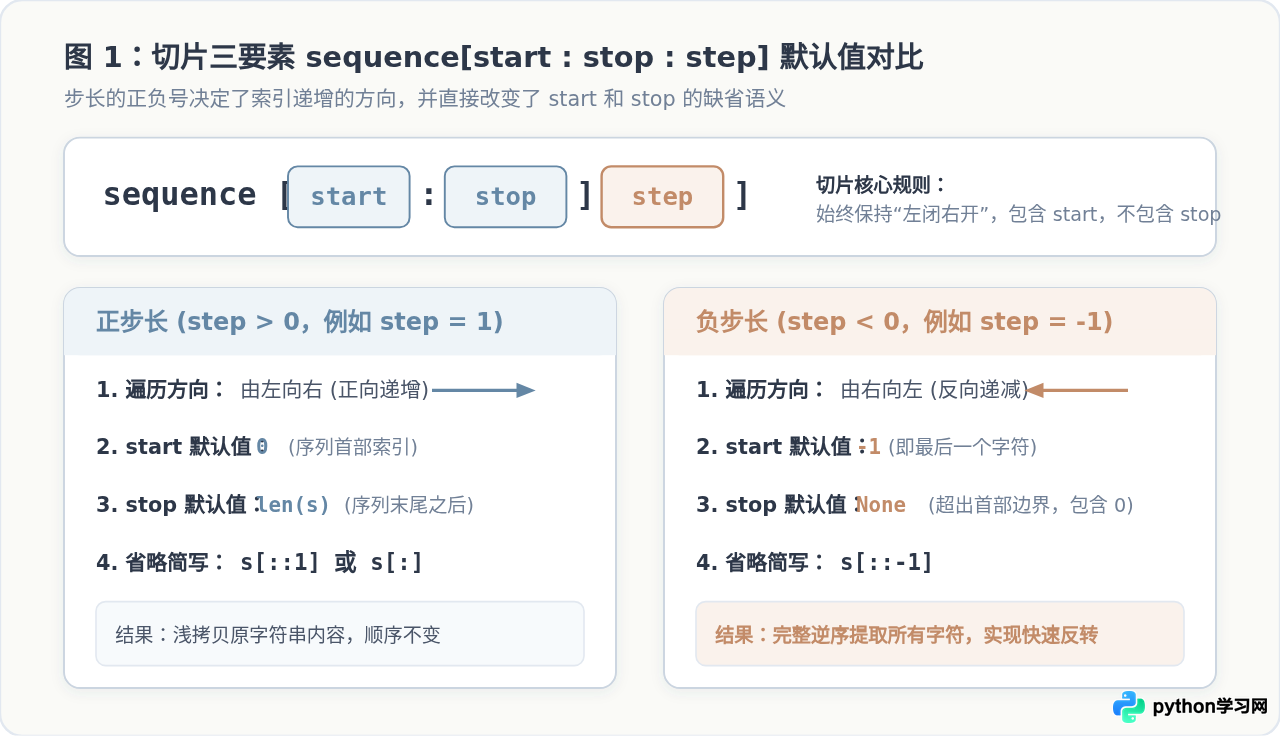
当我们在代码中书写 s[::-1] 时,省略了 start 与 stop,Python 内部会触发以下推导:
- 检测 step 为 -1:判断出遍历方向必须是从右向左(索引递减)。
- 推导 start 缺省值:由于要向左移动,起点必须从序列的最右端开始,因此
start自动取末尾索引len(s) - 1(也就是负索引-1)。 - 推导 stop 缺省值:为了保证最左侧索引
0处的字符也能被成功提取,终止位置被设定为一个“越过首字符之前”的特殊哨兵标志(在内部逻辑中相当于None,即没有边界限制直到头部左侧全部走完)。
因此,s[::-1] 并不是省略了参数,而是利用了 Python 为负步长专门定制的边界推导机制,从而自然而然地覆盖了从末尾到开头的全部字符。
三、执行过程追踪:负步长如何单步运作
为了直观感受解释器如何遍历字符,我们以六个字母的字符串 s = "PYTHON" 为例。该字符串的正向索引是 0, 1, 2, 3, 4, 5,长度为 6。
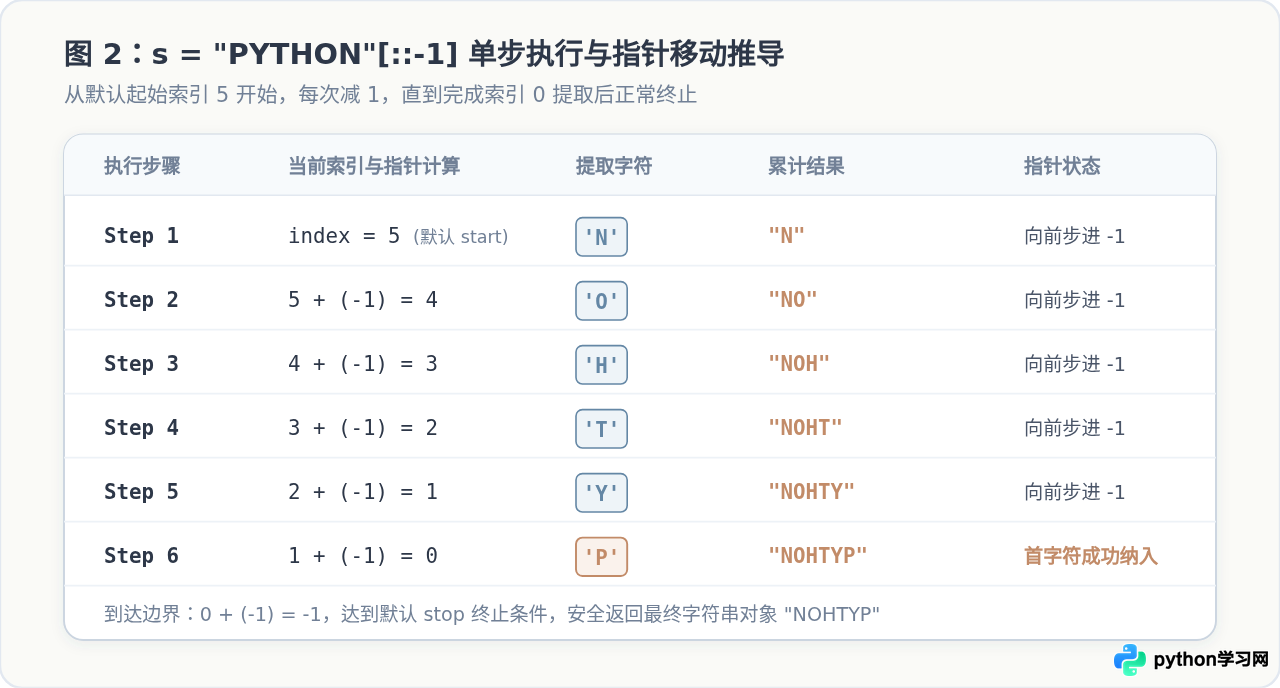
当执行 s[::-1] 时,底层的循环逻辑如下:
- 第 1 次取值:指针位于
start默认位置(索引 5),提取出'N'。 - 第 2 次取值:指针加上步长
5 + (-1) = 4,提取出'O'。 - 第 3 次取值:指针加上步长
4 + (-1) = 3,提取出'H'。 - 第 4 次取值:指针加上步长
3 + (-1) = 2,提取出'T'。 - 第 5 次取值:指针加上步长
2 + (-1) = 1,提取出'Y'。 - 第 6 次取值:指针加上步长
1 + (-1) = 0,提取出'P'。 - 循环终止:下一次运算
0 + (-1) = -1已越过序列前端边界,循环停止,汇总所得字符组装为最终字符串"NOHTYP"。
四、新手必避的负步长切片边界陷阱
虽然 s[::-1] 简单直接,但在需要对局部字符串进行倒序截取时,许多开发者容易陷入两个典型的索引陷阱。
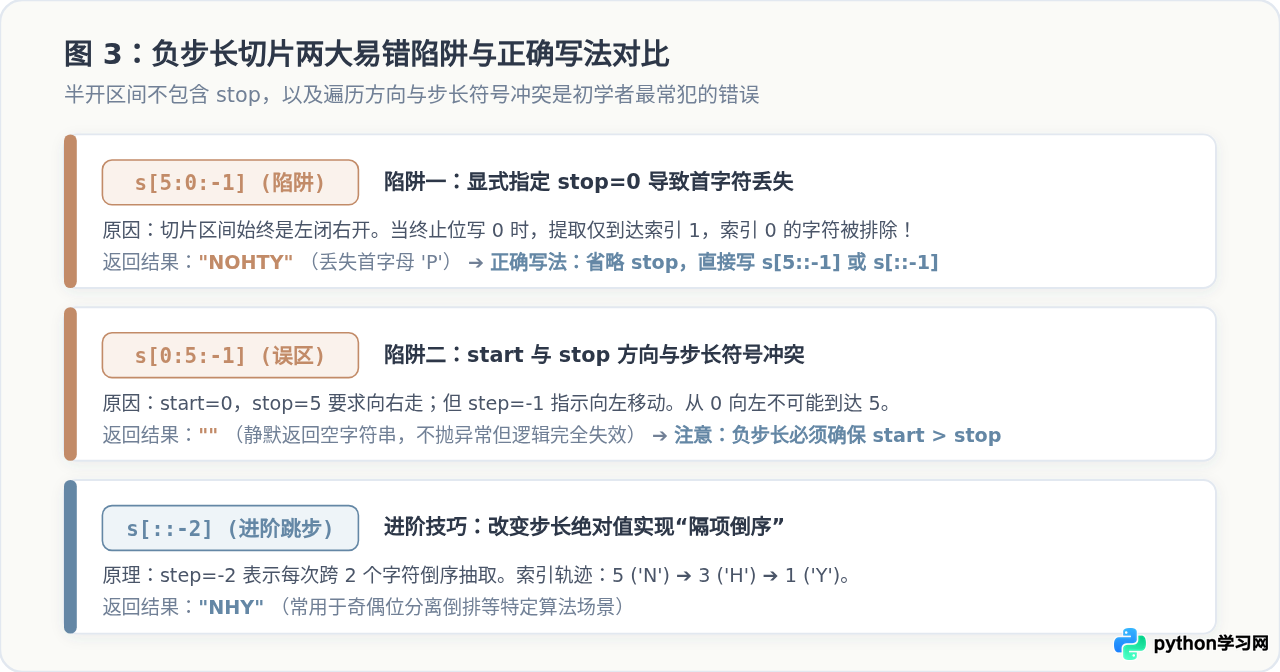
陷阱一:显式指定 stop=0 导致首字母丢失
有些开发者试图“从最后一个字符反转到第 0 个字符”,于是手动写下:
s = "PYTHON"
wrong_slice = s[5:0:-1]
print("显式 stop=0 的结果:", wrong_slice)
# 示例输出:NOHTY (注意:首字符 'P' 丢失了!)Python 切片始终严格遵守半开区间(包含起始,排除结束)。当 stop 明确设为 0 时,索引 0 本身被排除在外,提取在索引 1 处便提前终止。要包含索引 0 的字符,必须省略 stop:写作 s[5::-1] 或使用切片对象 slice(5, None, -1)。
陷阱二:遍历方向与索引正负次序冲突
如果给定的起始位置与终止位置无法沿着步长方向前进,Python 不会报错,而是会默默返回一个空字符串:
s = "PYTHON"
# 起点为 0,终点为 5,但要求向负方向(向左)移动
conflict_slice = s[0:5:-1]
print("方向冲突时的结果:", repr(conflict_slice))
# 示例输出:'' (空字符串)
当 step < 0 时,必须保证逻辑上的 start > stop,例如 s[4:1:-1] 才能成功获取 "OT"。
五、性能基准与原理剖析:为什么切片速度极快?
在 Python 中实现反转字符串的方式并不止一种,常见的替代手段还有内置函数 reversed() 与循环累加。为什么 s[::-1] 被公认为最佳实践?
# 常见的三种反转实现方式
s = "PythonSlice"

# 方式 1:切片法(推荐)
res1 = s[::-1]

# 方式 2:reversed() 配合 join(可读性好)
res2 = ''.join(reversed(s))

# 方式 3:循环累加(强烈不推荐)
res3 = ""
for char in s:
    res3 = char + res3
底层机制差异
在 CPython 解释器实现中:
- 切片法
s[::-1]:直接进入 C 语言函数unicode_subscript与PySequence_GetSlice。解释器在读取切片参数后立即计算出目标字符串的精确字节长度,向操作系统一次性申请足量连续内存空间,接着通过原生 C 指针逆向读取源内存并依次写入新内存。整个过程完全在 C 语言层完成,不产生中间的 Python 虚拟机指令与临时对象。 - 迭代器法
''.join(reversed(s)):需要先构建一个专门的reversed逆向迭代器对象,再将其传递给str.join()。join需要遍历该迭代器并逐个消费元素,多了一层 Python 对象的封装与方法调用开销。 - 循环累加
char + res:由于 Python 字符串是不可变对象,每次+操作都会触发分配新内存 + 复制旧字符 + 写入新字符的完整过程。对于长度为 n 的字符串,其时间复杂度恶化至 O(n²),极易导致严重的性能瓶颈。
下表为在标准 CPython 环境下对不同长度字符串执行 100,000 次反转的耗时对比示例:
| 实现方式 | 底层实现方式 | 时间复杂度 | 短字符串耗时 (10字符) | 中长字符串耗时 (1000字符) |
|---|---|---|---|---|
切片法 s[::-1] |
C 语言底层指针直接搬移 | O(n) | 0.038 秒 | 0.071 秒 |
''.join(reversed(s)) |
迭代器协议 + 内存缓冲拼接 | O(n) | 0.142 秒 | 0.485 秒 |
| 循环累加拼接 | 频繁重新申请不可变内存 | O(n²) | 0.298 秒 | 18.320 秒 |
六、边界与特殊场景:Unicode 复合字形簇的处理
对于绝大多数常见的文本处理(英文字符、中文汉字、常见标点),s[::-1] 表现得十分稳健。然而,在面对现代多语言与复杂字符集时,切片存在一个不可忽视的前提:Python 的切片是基于 Unicode 码点(Code Point)操作的,而不是人类视觉所见的“字符”(字形簇,Grapheme Cluster)。
某些复杂的 Emoji(如带肤色的手势 👍🏽)或带有组合重音符号的拉丁字母(如 é 由字符 'e' 和组合音标 '́' 组合而成)由多个连续的 Unicode 码点拼接而成。如果直接使用切片 [::-1],码点的先后次序会被强行颠倒,从而导致变音符脱落错位或 Emoji 拆散为乱码。
# 示例:组合重音字符反转对比
# 'e' + 组合尖音符 '́' 构成可视的 'é'
combined_char = "é"

# 使用切片反转时,变音符被置于 'e' 之前,破坏了组合字形
broken = combined_char[::-1]
print("反转后的码点序列:", [ord(c) for c in broken])
# 示例输出:[769, 101] (769 即变音符被独立置于前部,无法正确附着)
如果你的应用涉及跨语言高精度排版或富文本 Emoji 处理,建议使用外部专门维护字形簇规则的库(如 regex 库的 \X 匹配或 grapheme 库)以字形簇为最小单位执行倒序:
# 若需保护组合字符,可选用 grapheme 库(需 pip install grapheme)
import grapheme

complex_str = "café 👍🏽"
# 以用户感知字符(字形簇)为粒度反转
safe_reversed = "".join(list(grapheme.graphemes(complex_str))[::-1])
print("安全反转结果:", safe_reversed)
七、总结与技术选型建议
在 Python 中反转字符串时,绝大多数场景下 s[::-1] 都是最佳的生产级解法。为了便于日常编码记忆与选型,下方的架构总结图梳理了核心决策逻辑:
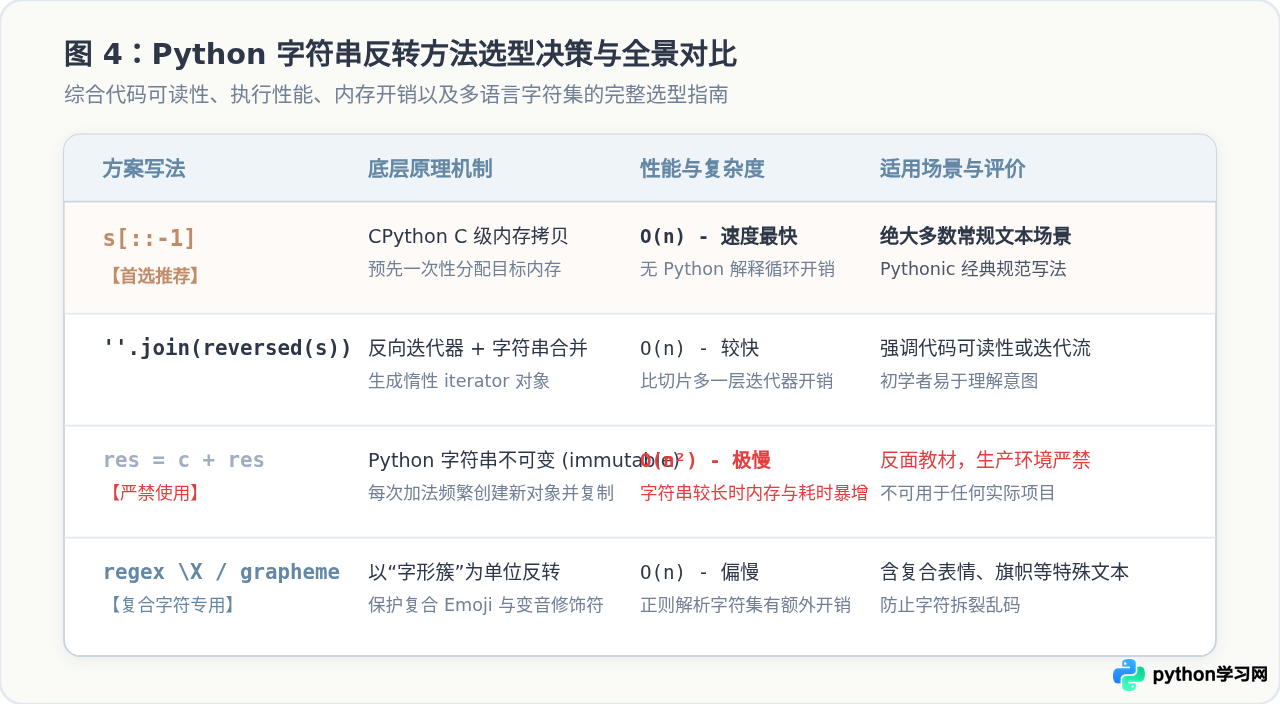
核心要点速查
- 推荐标准语法:
s[::-1]。语法最少,代码最地道,C 级底层实现性能最优。 - 负步长实质:
step = -1会将默认起点设为序列末尾,并将默认终点设为序列头部之外,实现从尾至头的完整采集。 - 避免显式
stop=0:半开区间会导致索引0的字符被忽略。若要倒序至首位,切记省略终止参数。 - 避开性能陷阱:坚决不要使用
for循环加号拼接不可变字符串,避免引发 O(n²) 级别的内存与耗时灾难。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









