

Python在for循环中使用with语句的正确语法
深入讲解Python中在for循环中结合with语句的正确语法结构、资源生命周期、异常保护及最佳实践。掌握逐个管理与流式迭代的差异,彻底避免文件描述符泄漏与内存激增。
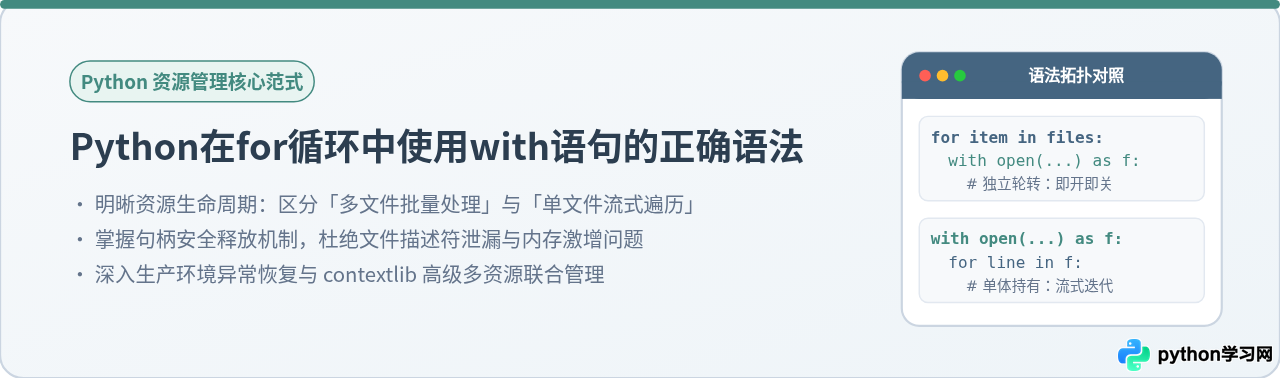
for 循环与 with 语句并没有生僻的特殊关键字,其核心关键在于“谁在外层,谁在内层”。如果需要逐个处理多个独立的外部资源(如批量打开文件、独立数据库连接),应采用“for 在外、with 在内”的形态;如果是对单一资源进行按行或分块流式读取,则应采用“with 在外、for 在内”的形态。正确组织二者的嵌套顺序,是杜绝操作系统文件句柄泄漏与内存崩溃的根本保障。
一、核心语法对比:两种基本形态与生命周期
在日常开发中,文件操作、网络会话以及互斥锁都需要由上下文管理器(即 with 语句)进行保护。很多初学者常困惑于 for 与 with 究竟该如何摆放。两者的组合并非简单的语法套用,而是直接决定了资源申请与释放的时间点。
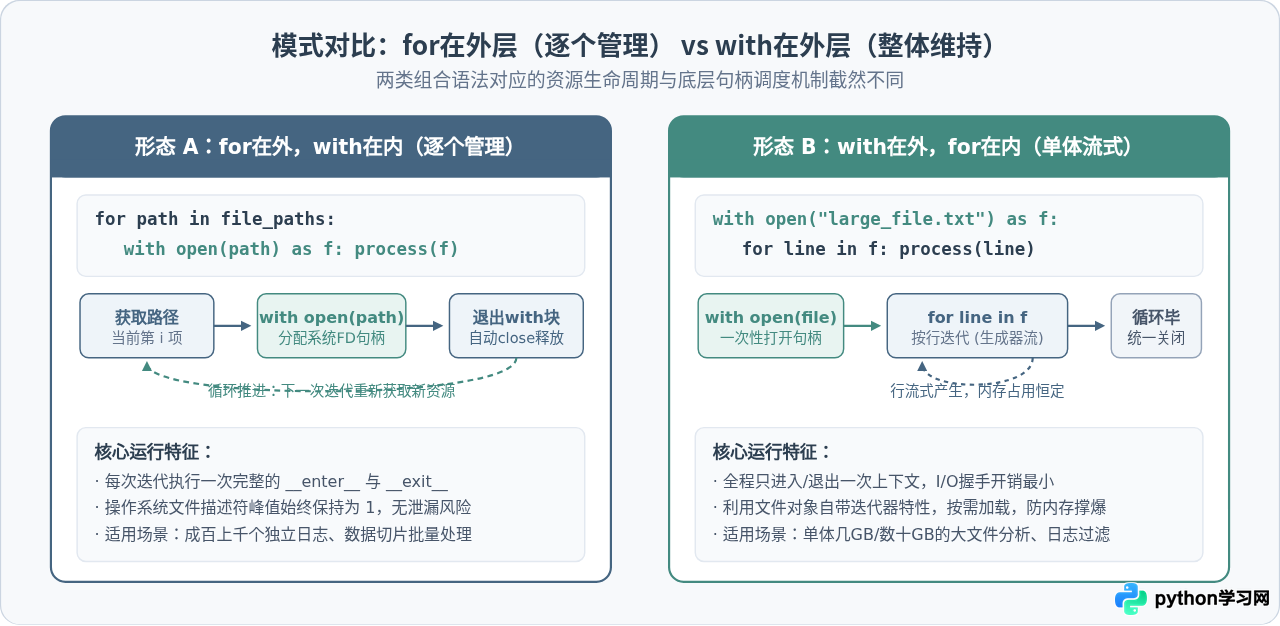
从底层调度来看:
- 形态 A(
for在外,with在内):针对一系列独立资源,在每次循环迭代中调用资源的__enter__()方法建立连接,并在当前单次迭代结束离开with块时立即触发__exit__()释放资源。这确保了在整个循环过程中,系统持有的资源句柄数量始终保持为极低水平(通常为 1)。 - 形态 B(
with在外,for在内):在进入循环前一次性获取大资源并激活上下文,循环体内借助迭代器(如 Python 文件对象的生成器行为)逐行或逐批消耗数据,全部消耗完毕后才统一退出上下文并释放资源。
二、形态一:for在外层,with在内层(逐个管理多个独立资源)
当需要处理一个文件列表、多个数据切片或向一系列接口轮流推送数据时,必须将 for 放在外层,with 放在内层。这样可以做到“每次只打开一个文件,读完立即关闭,再打开下一个”。
1. 标准语法代码示例
# 准备待处理的文件路径列表
import os

log_files = ["logs/2026-11-01.log", "logs/2026-11-02.log", "logs/2026-11-03.log"]

for file_path in log_files:
    # 每次迭代独立进入 with 块,申请当前文件描述符
    with open(file_path, mode="r", encoding="utf-8") as f:
        content = f.read()
        # 执行数据清洗与业务逻辑
        total_lines = len(content.splitlines())
        print(f"文件 {file_path} 解析完成,共 {total_lines} 行")
    # 一旦跳出 with 缩进块,底层的 f.close() 已被自动调用
    # 此时该文件句柄已从系统回收,不占用系统描述符配额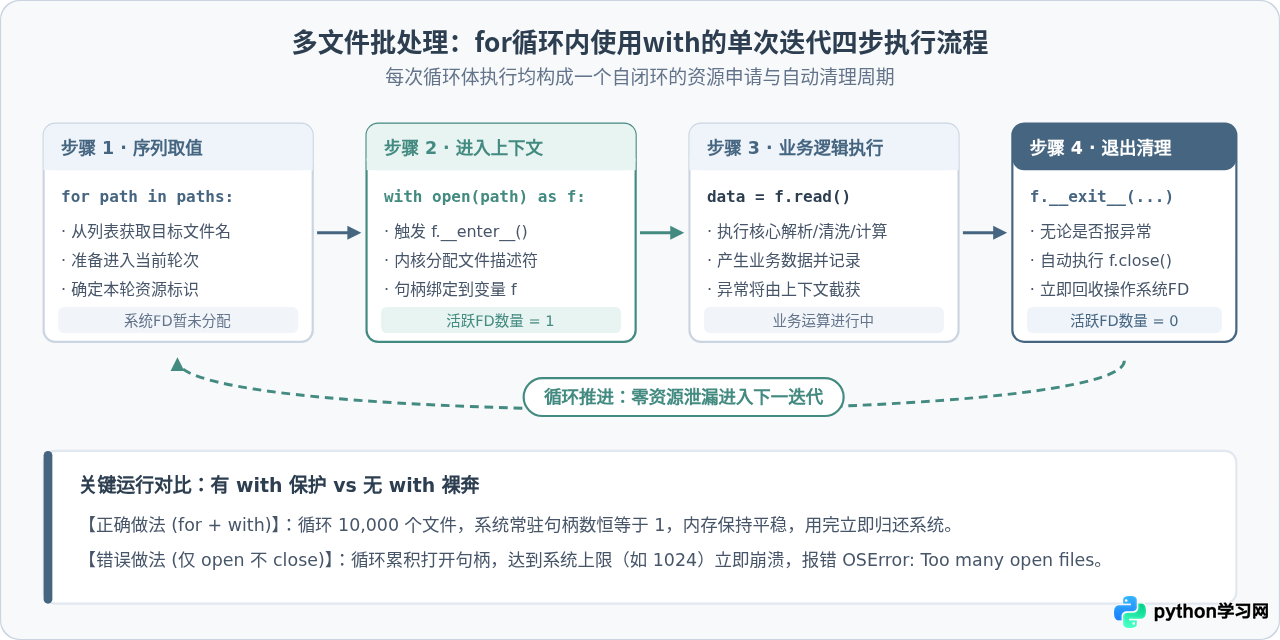
2. 为什么不能在循环外提前全部打开?
很多开发者容易写出形如 handles = [open(f) for f in log_files] 的列表推导式,随后再用 for h in handles: ... 遍历。在 POSIX 系统(如 Linux、macOS)中,每个进程默认允许打开的文件描述符(File Descriptor)上限通常为 1024。
若列表包含数千个文件,一口气同时打开会直接抛出经典的 OSError: [Errno 24] Too many open files 异常导致程序崩溃。即使在没有超过配额的小规模场景下,长期悬挂的文件句柄也会阻碍垃圾回收并占用操作系统内存缓冲区。因此,“即用即开、用完即关”是批量处理的首要原则。
三、形态二:with在外层,for在内层(单一资源内部流式迭代)
当目标仅仅是单个文件,但该文件体积非常巨大(例如几个 GB 甚至几十 GB 的访问日志、CSV 原始库),绝不能一次性将其 read() 到内存中,而应当由 with 在外层维持住该文件的只读句柄,由内层的 for 循环按行推进。
1. 标准语法代码示例
# 单个大文件的逐行流式读取与统计
error_count = 0
target_large_file = "server_access_big.log"

# with 在外层:整个遍历期间仅打开一次句柄
with open(target_large_file, mode="r", encoding="utf-8") as file_handle:
    # for 在内层:利用文件自身的生成器迭代特性,一次只加载一行进内存
    for line in file_handle:
        line_clean = line.strip()
        if "500 InternalServerError" in line_clean:
            error_count += 1

# 循环结束后离开 with 块,文件自动关闭
print(f"500 错误统计完成,总计出现: {error_count} 次")open() 返回的文件对象本身就是一个可迭代对象(Iterable),内部实现了缓冲 I/O 与生成器协议。直接使用 for line in file_handle 会按需从磁盘读取下一个块并切分行,整个进程的内存消耗恒定在数十 KB 级别,无论原始文件是 100MB 还是 100GB。严禁在此处调用 for line in file_handle.readlines():,因为 readlines() 会强行将全部文本一次性载入内存列表。
四、异常处理与资源安全保障机制
真实业务场景中,批处理任务常遇到网络波动、文件被损坏、编码不符或格式错误等突发状况。理解 with 语句在异常链路中的行为至关重要。
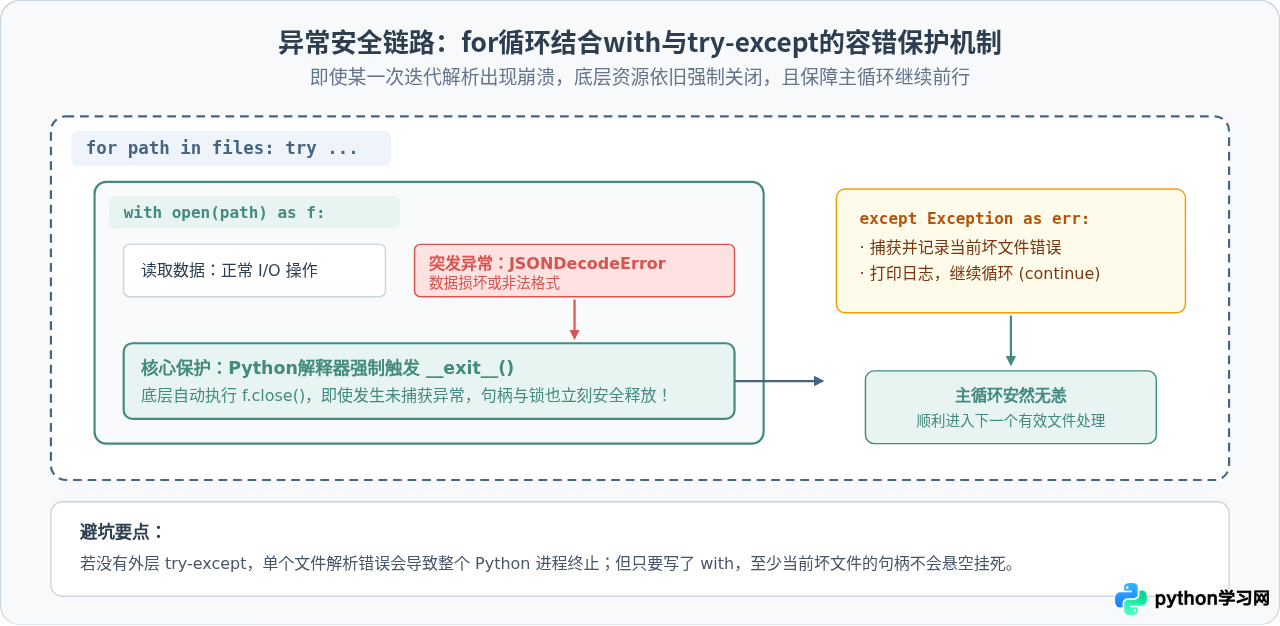
1. with 的核心承诺:保证 __exit__ 的强制执行
无论循环体内部是正常执行完毕、被 break 提前打断、被 continue 跳过,还是抛出未被捕获的异常,Python 虚拟机都会保证执行当前上下文管理器的 __exit__(exc_type, exc_val, exc_tb) 方法。这意味着正在写入的缓冲区会被刷盘,文件描述符会被立刻归还。
2. 生产级健壮结构:for + try-except + with
若希望某个损坏的文件不影响后续其他文件的继续处理,应在 for 循环内部、with 外部包裹 try...except 结构:
import logging

batch_targets = ["valid_1.json", "corrupt_file.json", "valid_2.json"]

for item_path in batch_targets:
    try:
        # with 保证了即使在 json.load 阶段解析崩溃,文件也能被妥善关闭
        with open(item_path, mode="r", encoding="utf-8") as f:
            data = json.load(f)
            process_record(data)
    except (IOError, json.JSONDecodeError) as err:
        # 捕获异常后记录日志,不让异常打断主循环
        logging.error(f"跳过损坏文件 {item_path},原因: {err}")
        continue
五、复合进阶场景:双上下文与动态资源管理
1. 读写成对文件:同一行声明多个上下文
在批量数据清洗与转存场景中,往往需要从一个旧文件读入并流式写入新文件。Python 允许在同一个 with 语句中使用逗号分隔声明多个上下文管理器:
tasks = [
    ("raw_a.txt", "clean_a.txt"),
    ("raw_b.txt", "clean_b.txt"),
]

for src_path, dst_path in tasks:
    # 同时打开输入源与输出目标,以逗号分隔
    with open(src_path, "r", encoding="utf-8") as src,          open(dst_path, "w", encoding="utf-8") as dst:
        for line in src:
            if line.strip():
                dst.write(line.upper())
2. 动态数量资源:使用 contextlib.ExitStack
如果每次迭代中需要打开的资源数量事先不固定(例如同时对比 N 个不确定数量的基准文件),静态写多个 with open() 将无法满足需求。此时应当引入标准库提供的 contextlib.ExitStack:
from contextlib import ExitStack

file_groups = [
    ["sample1.txt", "sample2.txt"],
    ["chunk_a.log", "chunk_b.log", "chunk_c.log"]
]

for group in file_groups:
    # ExitStack 能够在循环内动态注册并管理任意数量的上下文
    with ExitStack() as stack:
        handles = [stack.enter_context(open(path, "r", encoding="utf-8")) for path in group]
        # 此处所有 handles 均在有效保护中
        merge_and_validate(handles)
    # 退出 with 时,stack 保证以相反的顺序关闭所有已注册句柄
六、常见误区与避坑清单
写出 files = (open(f) for f in path_list) 并试图传递给 with。生成器表达式本身并不是上下文管理器,必须在每次通过 next() 取得具体对象时再由 with 接管,否则极易发生句柄遗漏。
Python 中只有模块、类和函数会引入局部作用域。在 for item in list: with open(item) as f: 中,变量 item 和 f 在跳出循环后依然存在于当前函数或全局命名空间中。请注意不要在后续代码中误用未赋新值的旧变量名。
七、选型决策指南与全景总结
为了在实际编写代码时能够快速决策,下表给出了不同任务特征对应的语法组织标准:
| 任务目标 | 输入数据特征 | 标准语法形态 | 系统资源峰值表现 |
|---|---|---|---|
| 批量多文件处理 | 包含多个文件名或路径的列表 | for path in paths: with open(path) as f: |
句柄数恒为 1,内存开销低 |
| 单大文件逐行统计 | GB 级别的单一文本或日志 | with open(file) as f: for line in f: |
单句柄开销,内存恒定数十KB |
| 数据成对清洗转存 | 输入与输出路径成对存在 | for in_p, out_p in pairs: with open(...) as r, open(...) as w: |
双句柄原子性保证,安全同步释放 |
| 不定量多文件归并 | 动态集合,数量随条件变动 | with ExitStack() as stack: [stack.enter_context(...) ...] |
按需分配,自动逆序注销全部句柄 |
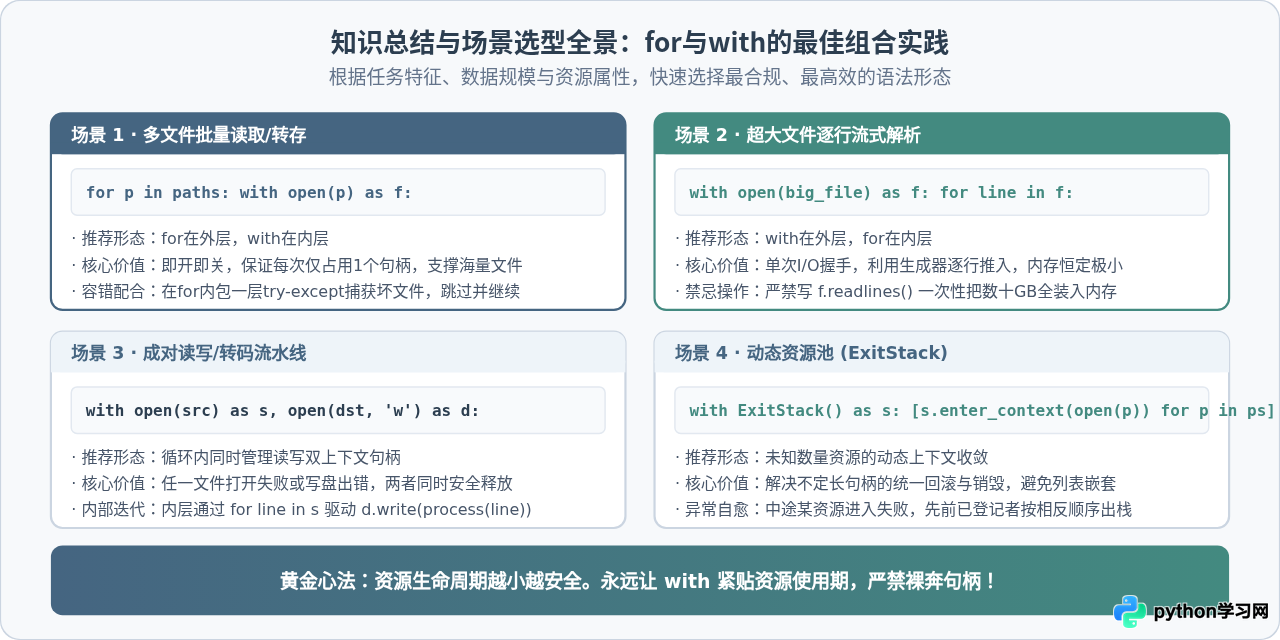
总结:编写带有上下文管理的循环代码时,牢记“资源在哪一层被需要,with 就放在哪一层”。多资源循环切换必须保持每次迭代自闭环,单资源长效消费必须保持外部单次开启内部按需流转。配合合理的 try...except 异常隔离,便能写出兼具高性能与高健壮性的优质 Python 生产代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









