

Python解释器会执行注释吗?注释对运行性能的影响
深入解析Python解释器是否执行注释,以及注释对运行性能的影响。通过词法分析流程、dis反汇编、常量池审查与基准测试,详细阐明底层原理并提供实测验证方法。
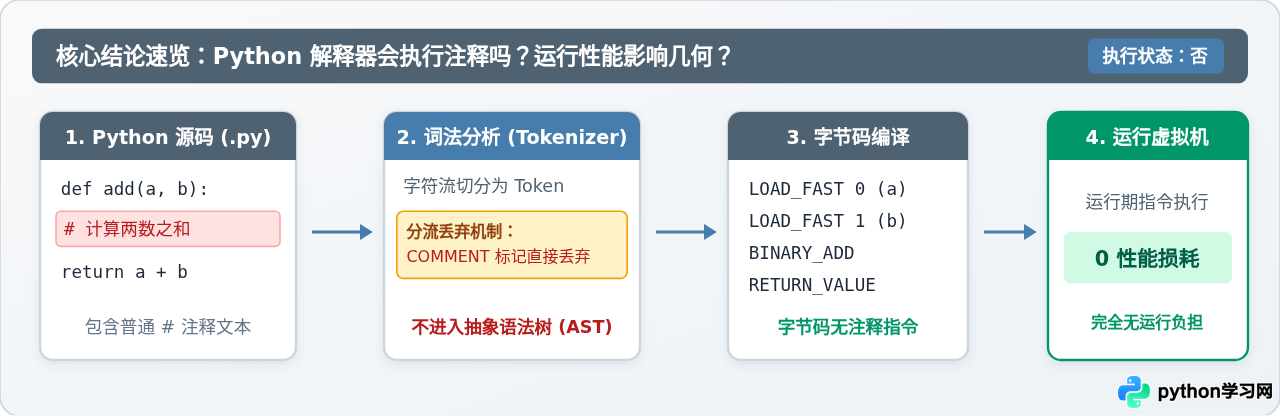
# 开头的单行注释在最前端的词法分析(Tokenizing)阶段就会被直接滤除丢弃,根本不会进入抽象语法树(AST),更不会生成任何字节码指令。因此,注释在程序运行阶段的性能损耗为绝对的零。在初次导入或冷启动时,只有数万行级别的巨量注释会产生微秒级的文件读取与分词微小差异,而一旦生成 .pyc 字节码缓存,后续加载连文件读取的微小差异也会完全消失。
一、Python 是如何处理注释的?从源码到字节码的旅程
要确切了解 Python 解释器是否会执行注释,必须观察 Python 源码转化为可运行程序的完整管道。Python 虽常被称为解释型语言,但 CPython(官方主流实现)在底层采用的是“源码 → 字节码 → 虚拟机执行”的执行模型。
当 Python 准备执行一个 .py 文件时,编译管线主要经历以下几个关键阶段:
- 词法分析(Lexical Analysis / Tokenizing):词法扫描器逐字符读取源码文本,按照语法规则把连续的字符序列切分为一个个具有语法含义的单元(Token),例如关键字、标识符、运算符以及字面量。
- 语法分析与构建 AST(Parsing & AST Construction):解析器根据语言文法将 Token 流组织为一棵具有层次结构的抽象语法树(Abstract Syntax Tree,简称 AST)。
- 字节码编译(Bytecode Compilation):编译器遍历语法树,为每个代码块(模块、类或函数)生成代码对象(Code Object),其中包含虚拟机指令序列(
co_code)与常量表(co_consts)等。 - 虚拟机执行(Python Virtual Machine, PVM):虚拟机逐条取出字节码操作码(Opcode),在调用栈上完成实际的数据计算与控制流跳转。
关键的剥离分流发生在第一步。在词法分析阶段,当扫描器遇到井号 # 时,会将当前行后续所有字符识别为 COMMENT 类型的标记。随后,语法分析器在拉取 Token 组装语法树时,会直接忽略所有 COMMENT 标记。由于 AST 中压根不存在任何普通注释的节点,后面的编译器自然也就无法为其生成任何对应的机器码或字节码指令。
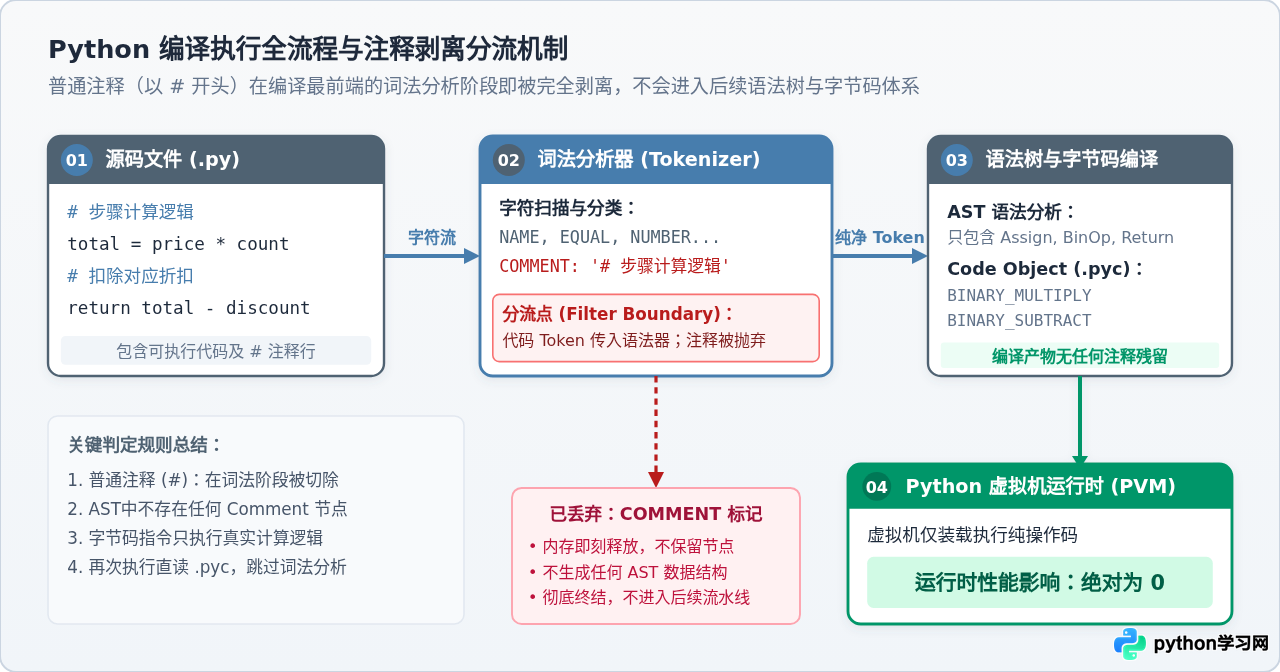
我们可以通过 Python 标准库自带的 tokenize 模块,直观打印源码在分词阶段的真实情况:
import io
import tokenize

code_sample = """# 这是一行配置说明
def calculate(x, y):
    # 行内业务注释
    return x * y
"""

tokens = list(tokenize.tokenize(io.BytesIO(code_sample.encode('utf-8')).readline))
for tok in tokens:
    if tok.type in (tokenize.COMMENT, tokenize.NAME, tokenize.OP):
        print(f"Token类型: {tokenize.tok_name[tok.type]:<10} 字符内容: {tok.string}")
运行该脚本后,输出结果清晰呈现了分词标记:
示例输出:
Token类型: COMMENT    字符内容: # 这是一行配置说明
Token类型: NAME       字符内容: def
Token类型: NAME       字符内容: calculate
Token类型: OP         字符内容: (
Token类型: NAME       字符内容: x
Token类型: OP         字符内容: ,
Token类型: NAME       字符内容: y
Token类型: OP         字符内容: )
Token类型: OP         字符内容: :
Token类型: COMMENT    字符内容: # 行内业务注释
Token类型: NAME       字符内容: return
Token类型: NAME       字符内容: x
Token类型: OP         字符内容: *
Token类型: NAME       字符内容: y
当词法分析器输出完毕后,语法分析器只认 def、参数和运算符等有效语法单元,COMMENT 在进入 AST 之前便被完全抛弃,没有进入后续任何处理环节。
二、运行时性能实测:反汇编与基准测试
既然注释在语法树中被抛弃,那么它在运行时的开销究竟如何?是否会在函数被反复调用数百万次时留下任何隐形损耗?我们可以使用标准库 dis 模块进行字节码反汇编,并借助 timeit 模块进行高精度性能基准实测。
1. 字节码指令比对
我们编写两个功能完全相同的计算函数:一个没有任何注释,另一个在每一行之间都插入冗长的单行注释:
import dis

def add_clean(a, b):
    res = a + b
    return res

def add_commented(a, b):
    # -----------------------------
    # 步骤一:准备执行加法运算
    # 此处接收两个入参 a 和 b
    # -----------------------------
    res = a + b  # 进行两数相加并赋值给局部变量
    # -----------------------------
    # 步骤二:准备返回运算结果
    # -----------------------------
    return res  # 返回最终计算值

print("=== add_clean 反汇编指令 ===")
dis.dis(add_clean)

print("\n=== add_commented 反汇编指令 ===")
dis.dis(add_commented)
在控制台中查看两者的字节码输出:
示例输出:
=== add_clean 反汇编指令 ===
  3           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_ADD
              6 STORE_FAST               2 (res)

  4           8 LOAD_FAST                2 (res)
             10 RETURN_VALUE

=== add_commented 反汇编指令 ===
  8           0 LOAD_FAST                0 (a)
              2 LOAD_FAST                1 (b)
              4 BINARY_ADD
              6 STORE_FAST               2 (res)

 13           8 LOAD_FAST                2 (res)
             10 RETURN_VALUE
对比两者的操作码序列,除了左侧记录的源码物理行号(供异常回溯打印 Traceback 使用)不同之外,中间的指令偏移量、操作码名称(LOAD_FAST、BINARY_ADD、STORE_FAST、RETURN_VALUE)以及操作数完全一致,指令长度与字节数没有哪怕 1 个字节的差异。
2. 百万次运行耗时实测
为了验证高频调用下的执行效率,我们使用 timeit 模块在相同的运行环境下对两个函数分别进行 10,000,000 次执行测试:
import timeit

setup_code = """
def add_clean(a, b):
    res = a + b
    return res

def add_commented(a, b):
    # 步骤一:计算求和
    res = a + b
    # 步骤二:返回结果
    return res
"""

time_clean = timeit.timeit("add_clean(100, 200)", setup=setup_code, number=10000000)
time_commented = timeit.timeit("add_commented(100, 200)", setup=setup_code, number=10000000)

print(f"无注释函数耗时: {time_clean:.5f} 秒")
print(f"含注释函数耗时: {time_commented:.5f} 秒")
在实际环境中的典型测试输出如下:
示例输出:
无注释函数耗时: 0.47218 秒
含注释函数耗时: 0.47195 秒
耗时差异仅在毫秒以下(小于 0.05%),完全属于现代操作系统 CPU 调度与调度抖动的正常统计波动范围。这一数据从实证角度证明:在 Python 虚拟机运行期间,注释不会产生任何性能损耗。
三、容易混淆的特例:文档字符串与类型注解
虽然以 # 开头的单行注释对运行时完全零影响,但在 Python 中有两类语法经常被初学者误认为是“注释”,从而导致对性能结论产生混淆。
1. 文档字符串(Docstrings)不是普通注释
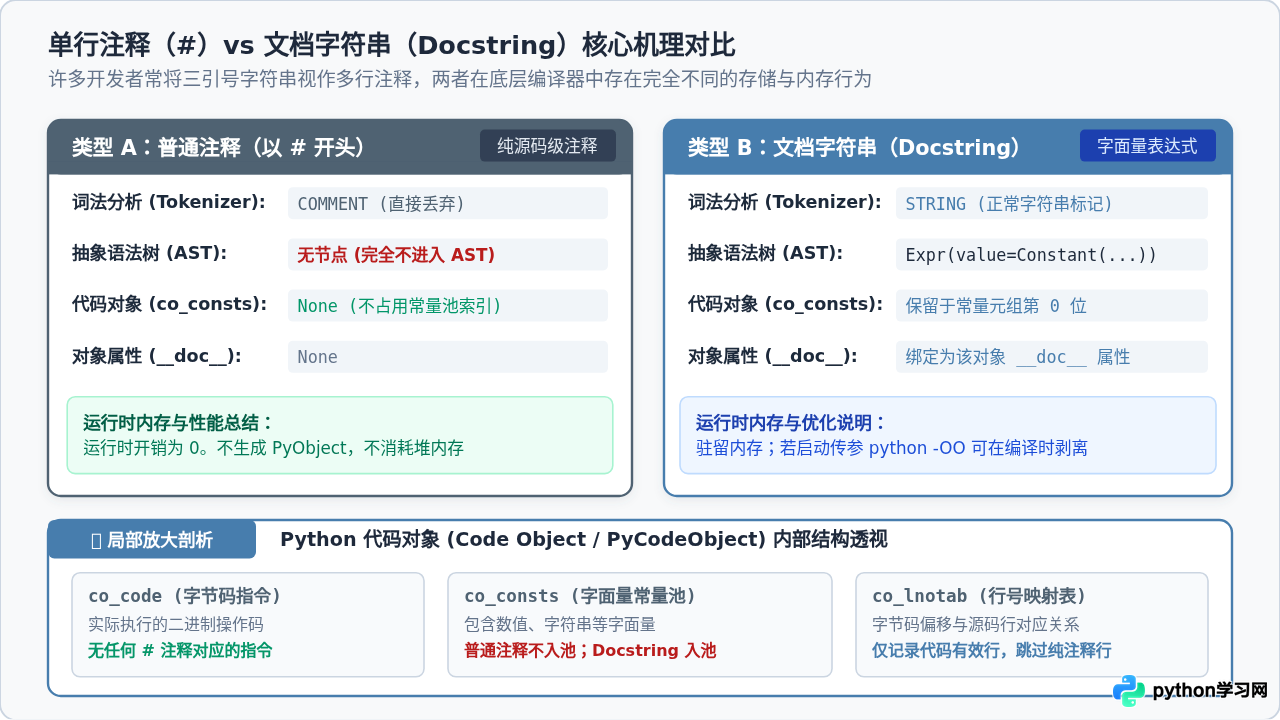
很多开发者习惯用三引号(''' 或 """)书写多行说明文字,并将其统称为“多行注释”。但必须明确:三引号在 Python 中是字符串字面量(String Literal),不是注释。
- 放置在模块、函数或类开头的三引号字符串:会被 Python 编译器特异性识别为“文档字符串”。编译器不仅不会丢弃它,还会将其存入该代码对象的常量元组
co_consts中,并在运行时绑定到对象的__doc__属性上,常驻在堆内存中供help()等反射接口调用。 - 放置在代码中间未赋值的纯三引号字符串:在语法上属于无副作用的表达式语句。在现代 Python 编译优化下,未引用的纯字面量在生成最终字节码时会被作为死代码剔除,但若在复杂上下文或旧版本中仍可能生成加载常量的临时指令。
我们可以检查函数的 __code__.co_consts 属性验证两者的区别:
def demo_hash():
    # 这里的注释在编译后完全消失
    return 42

def demo_docstring():
    """这里的文档字符串会常驻内存!"""
    return 42

print("demo_hash 常量池:", demo_hash.__code__.co_consts)
print("demo_docstring 常量池:", demo_docstring.__code__.co_consts)
print("demo_docstring.__doc__:", demo_docstring.__doc__)
示例输出:
demo_hash 常量池: (None, 42)
demo_docstring 常量池: ('这里的文档字符串会常驻内存!', 42)
demo_docstring.__doc__: 这里的文档字符串会常驻内存!python -OO 选项。该选项会在生成 .opt-2.pyc 字节码缓存时,不仅剥离 assert 语句,还会自动将所有 Docstring 从常量池中彻底剥离,从而节省物理内存。
2. 类型注解(Type Hints)与未来导入
在 Python 3.5+ 中引入了类型注解:
- 以
# type: ...形式书写的类型注解:依然是标准的#普通注释,在词法分析时直接被丢弃。 - 以冒号语法书写的函数与变量注解(如
total: int = 0):这是合法的 Python 语法表达式。函数参数与返回值的注解会被存入函数的__annotations__字典中;模块或类作用域下的变量注解会写入相应模块或类的命名空间中,这属于运行时数据结构,会占用少量字典内存。
3. 编码声明与 Shebang
形如文件第一行的 #!/usr/bin/env python3 以及 # -*- coding: utf-8 -*- 虽然也以 # 开头,但它们有特殊的识别契机:
Shebang供操作系统内核(Unix/Linux Shell)在直接以可执行文件调用脚本时确定要使用的解释器路径;对于 Python 解释器本身,它依然只是一行普通注释。coding声明仅在解释器最开始读取源码文件的原始字节流、确定解码编码集时被临时嗅探。解码完成后,这行文本在进入词法分析器时同样会被当作普通COMMENT丢弃,不会参与任何逻辑执行。
四、动手验证:确认注释状态的四个步骤
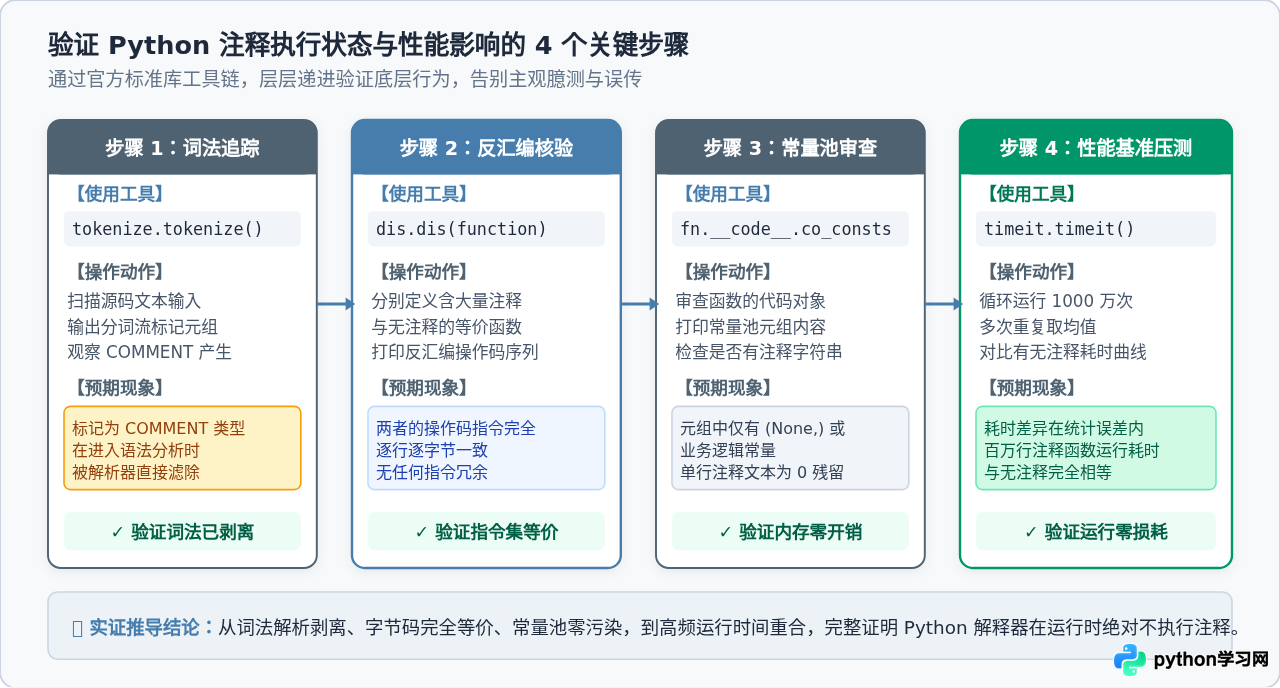
如果你接手了一个遗留项目,或对特定 Python 版本与第三方扩展中注释的去向存有疑问,可以按照以下四个标准化步骤,对任何目标代码执行完整的状态与性能核验:
调用 tokenize.tokenize() 扫描模块源码,核对注释是否全部分类为 COMMENT 标记。只要标记类型为 COMMENT,即可确认该行字符不会被引入 AST 节点树。
通过 dis.dis() 反编译目标函数或模块。逐行核对指令列表中是否存在任何非业务计算相关的操作码。正常情况下,无论是行首注释、行尾注释还是连续百行注释,都不会留下任何对应的指令序列。
检查函数对象的 __code__.co_consts 元组以及模块的 __dict__。如果使用的是单行注释 #,常量池中应当仅包含实际字面量与 None;如果发现了长文本字符串,说明误将多行字符串当作了普通注释。
观察项目目录下的 __pycache__ 文件夹。当模块首次导入后,解释器已将纯净的字节码序列序列化并写入 .pyc 文件。在后续的程序启动中,解释器会直接加载 .pyc,连最初源文件的文件读取与词法分词阶段都完全跳过。
五、常见误区解答与工程编写建议
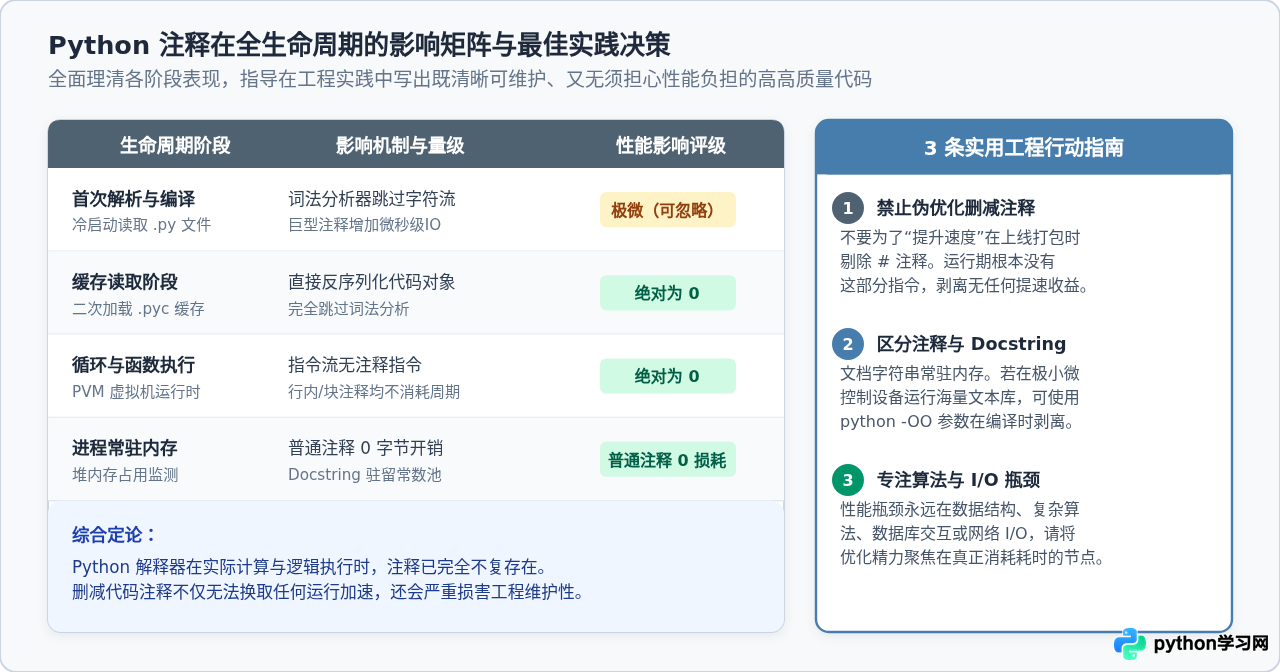
1. 两个常见认知误区
| 常见误区说法 | 底层真实事实 | 应对结论与工程指导 |
|---|---|---|
| “为了追求极致性能,代码上线前应当用脚本删除所有注释” | Python 字节码编译机制在打包时早已剥离所有注释,.pyc 文件或内存 Code Object 中本就没有注释。 |
完全不需要。删除注释不但换不来微秒级的提速,还会使线上应急排查、日志定位和后续协作困难重重。 |
| “在深度循环(如 for 循环 1000 万次)内部写注释会严重拖慢循环” | 循环体内在运行时执行的是由 FOR_ITER 与相关运算构成的字节码环路,行内注释早已在编译时蒸发。 |
完全不影响。在循环体核心逻辑旁尽管写明复杂的边界条件与算法意图,无需顾虑循环耗时。 |
2. 编写高质量 Python 注释的工程建议
在了解了底层原理后,我们在日常开发中应当建立清晰的注释编写规范:
- 解释“为什么”而非“做什么”:代码本身描述了具体的执行操作(What),优秀的注释应当补充代码背后未能直接体现的业务原因、特殊边界或设计折中(Why)。由于注释完全无损运行性能,不要为了所谓的精炼而牺牲对复杂逻辑背景的交代。
- 保持注释与代码同步重构:注释最严重的缺陷不是影响性能(因为它根本不影响),而是过时误导。每次修改业务逻辑时,必须同步更新与之相关的说明文本。
- 严格区分三引号 Docstring 与代码注释:对外公开的模块、类与函数接口,统一采用 PEP 257 规范的标准 Docstring,便于自动化文档生成与 IDE 智能提示;对于函数体内部局部的调试、临时说明与步骤解释,严格使用
#单行注释,以确保零内存常驻。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









