

怎么使用Selenium或Playwright处理Python爬虫中的JavaScript动态渲染
深入讲解如何使用Selenium和Playwright解决Python爬虫中JavaScript动态渲染问题,涵盖无头配置、显式等待、动态滚动、网络拦截与选型对比。
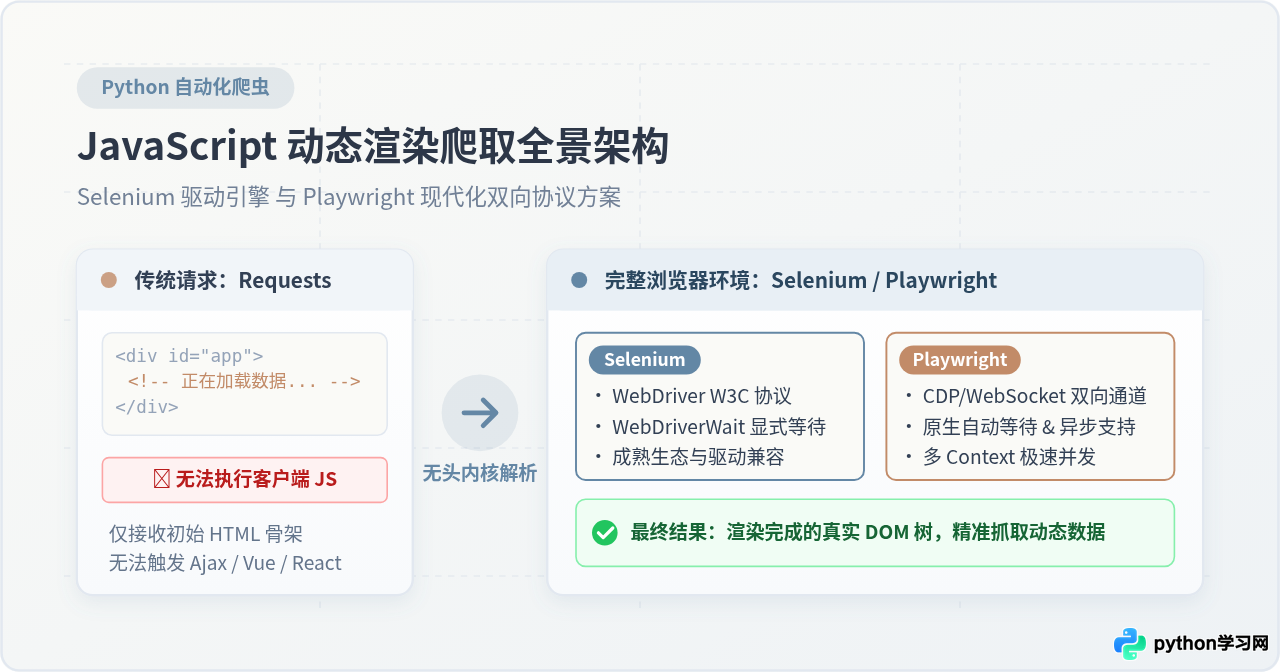
requests 或 httpx 请求现代单页面应用(SPA)或采用前端渲染的网站,往往只能抓取到一个仅包含骨架标签(如 <div id="app"></div>)的空白页面。这是因为真实的数据内容依赖客户端浏览器执行 JavaScript 脚本后才能通过异步请求填充到 DOM 树中。解决此问题的标准路径是引入真实的浏览器自动化驱动引擎——利用 Selenium 或 Playwright 控制无头浏览器(Headless Browser)完成页面加载、JavaScript 执行与状态等待,进而稳定提取出完全渲染后的结构化数据。
一、JavaScript 动态渲染的运作机制与排查方法
在深入编写自动化代码之前,理解动态渲染的底层运作链路是确保抓取成功率的前提。传统网站采用“服务端渲染”(SSR),服务器在响应 HTTP GET 请求时直接将拼接好数据的完整 HTML 文本下发给客户端;而现代前端架构普遍采用“客户端渲染”(CSR),服务器初始返回的仅是轻量化的 HTML 外壳、样式表及 JS 脚本入口。
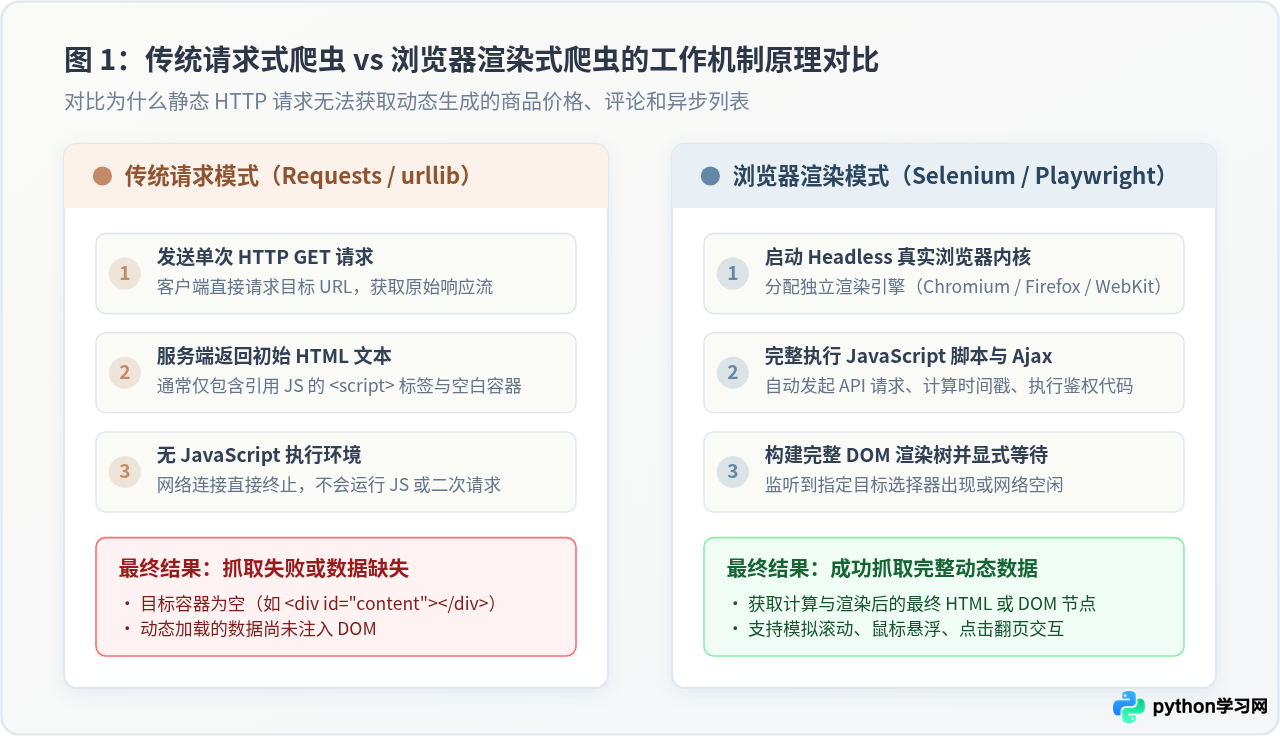
在客户端渲染模式下,浏览器的核心处理顺序如下:
- 主文档下载:浏览器接收到状态码为 200 的初始 HTML 文件,此时 DOM 树仅有基础容器结构。
- 脚本解析与执行:JavaScript 引擎(如 V8)解析执行页面内联及外链的脚本文件。
- 异步数据拉取:脚本在运行时向后端 API 接口发起 XHR 或 Fetch 请求获取 JSON 数据。
- DOM 节点挂载与重绘:数据返回后,前端框架将其转化为真实的 DOM 节点并挂载至页面,渲染完成。
前期排查原则:在决定使用无头浏览器之前,建议先在 Chrome 开发者工具(F12)的 Network 面板中过滤 Fetch/XHR 请求。若目标数据直接以清晰规范且未加高强度签名防护的 JSON 格式暴露在接口中,直接使用 requests 请求该接口往往在效率和机器资源开销上远优于驱动无头浏览器。只有当接口存在复杂的客户端加签、字体反爬混淆,或者数据纯粹由复杂前端 Canvas/SVG 实时绘制时,采用 Selenium 或 Playwright 驱动真实渲染才是最稳定可行的方案。
二、动态渲染页面抓取的核心标准流程
无论是使用经典的 Selenium 还是现代的 Playwright,处理动态渲染时均不能把浏览器当作简单的“带界面的 Requests”。严谨的动态页面采集由五个紧密衔接的阶段构成:
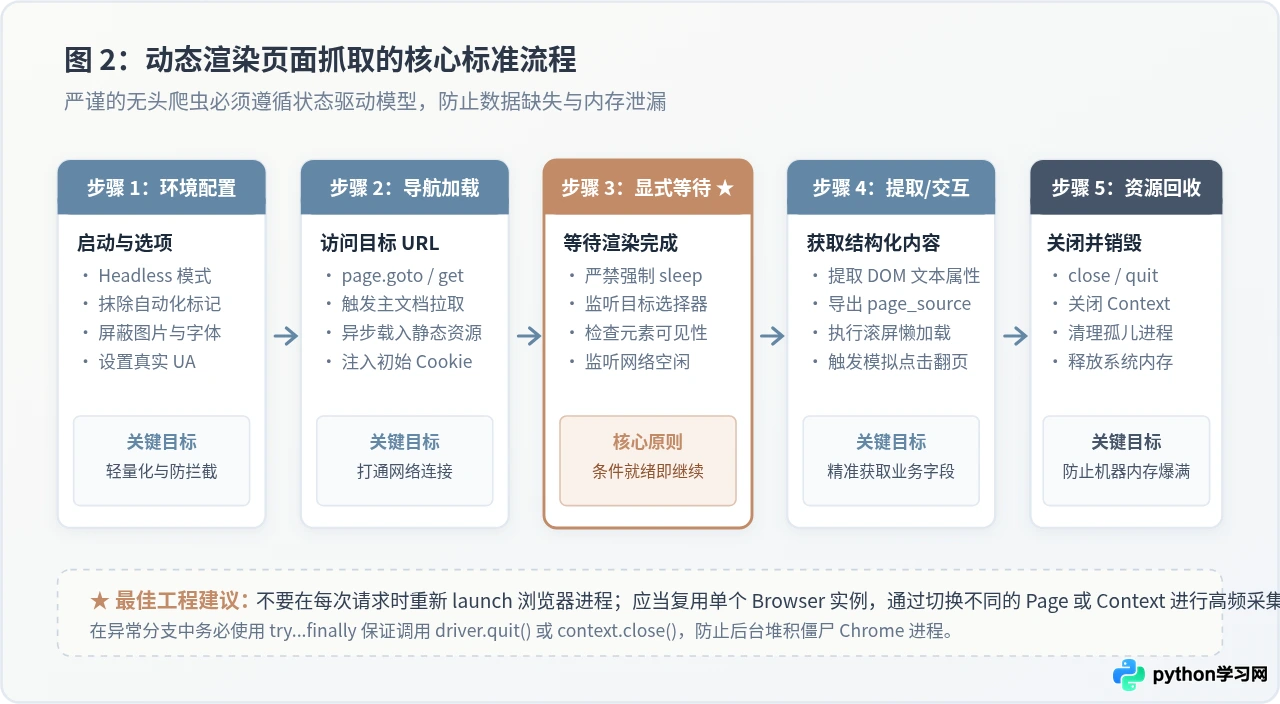
- 阶段 1:驱动与选项配置——配置浏览器启动参数,包括启用无头模式(Headless)、抹除
navigator.webdriver自动化特征标识、设置桌面端视口大小与请求头,并根据需要屏蔽媒体资源。 - 阶段 2:页面导航与加载——调用导航方法访问目标 URL,建立底层网络通道并监听主文档载入。
- 阶段 3:显式条件等待——关键核心步骤。坚决杜绝粗暴使用
time.sleep(),必须依据目标数据节点的出现或网络请求静默状态进行条件等待。 - 阶段 4:数据提取与滚动交互——直接在当前活页 DOM 中利用选择器抓取属性,或者在页面存在懒加载(Lazy Load)时,注入 JavaScript 脚本驱动视口平滑滚动触发数据渲染。
- 阶段 5:会话与资源释放——通过严格的生命周期管理(如
try...finally块)及时销毁会话或关闭页面,防止服务器后台堆积大量的无头 Chrome 僵尸进程。
三、使用 Selenium 处理动态渲染的具体实践
Selenium 是自动化测试与网页爬虫领域历史最悠久、使用最广泛的库。在 Python 中使用 Selenium 处理动态渲染的核心在于合理配置 ChromeOptions 以及使用 WebDriverWait 配合 expected_conditions。
1. 依赖安装与驱动准备
在 Python 虚拟环境中安装 Selenium 以及自动驱动管理工具:
pip install selenium webdriver-manager2. 完整实战代码示例
以下代码演示了如何使用 Selenium 在全新无头模式下规避反爬检测、设置显式等待并提取动态渲染列表:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from webdriver_manager.chrome import ChromeDriverManager

def scrape_with_selenium(target_url: str):
    # 1. 配置 Chrome 启动选项
    chrome_options = Options()
    chrome_options.add_argument("--headless=new")  # 使用 Chromium 全新无头模式
    chrome_options.add_argument("--disable-gpu")
    chrome_options.add_argument("--window-size=1920,1080")
    chrome_options.add_argument("--no-sandbox")
    chrome_options.add_argument("--disable-dev-shm-usage")

    # 防指纹检测:关闭自动化受控特征提示
    chrome_options.add_experimental_option("excludeSwitches", ["enable-automation"])
    chrome_options.add_experimental_option("useAutomationExtension", False)
    chrome_options.add_argument("user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36")

    # 2. 自动下载并匹配对应的 ChromeDriver 驱动
    service = Service(ChromeDriverManager().install())
    driver = webdriver.Chrome(service=service, options=chrome_options)

    # 抹除 navigator.webdriver 标记
    driver.execute_cdp_cmd("Page.addScriptToEvaluateOnNewDocument", {
        "source": "Object.defineProperty(navigator, 'webdriver', {get: () => undefined})"
    })

    try:
        # 3. 导航访问目标网站
        driver.get(target_url)

        # 4. 显式等待:等待数据容器渲染完成(最多等待 15 秒,轮询间隔 0.5 秒)
        wait = WebDriverWait(driver, timeout=15, poll_frequency=0.5)

        # 依据具体业务选择器判断目标节点是否挂载并且可见
        product_card_locator = (By.CSS_SELECTOR, "div.product-item")
        wait.until(EC.visibility_of_element_located(product_card_locator))

        # 若存在图片懒加载或按需渲染,可通过 JS 执行向下滚动
        driver.execute_script("window.scrollTo(0, document.body.scrollHeight);")

        # 5. 提取数据
        cards = driver.find_elements(By.CSS_SELECTOR, "div.product-item")
        results = []
        for card in cards:
            title = card.find_element(By.CSS_SELECTOR, "h3.title").text.strip()
            price = card.find_element(By.CSS_SELECTOR, "span.price").text.strip()
            results.append({"title": title, "price": price})

        return results

    finally:
        # 6. 务必在 finally 块中关闭驱动,回收进程资源
        driver.quit()

if __name__ == "__main__":
    # 示例调用
    data = scrape_with_selenium("https://quotes.toscrape.com/js/")
    print(f"成功采集到 {len(data)} 条记录")
driver.implicitly_wait() 隐式等待与 WebDriverWait 显式等待混合使用,两者在底层超时判定策略不同,混用会导致等待时间出现不可预期的倍数放大。
四、使用 Playwright 处理动态渲染的具体实践
Playwright 是由微软推出的新一代浏览器自动化框架,底层通过 Chrome DevTools Protocol(CDP)和 WebSocket 直接与浏览器内核建立全双工长连接。其在动态渲染爬取场景下的核心优势在于:原生支持异步 asyncio、开箱即用的自动等待(Auto-waiting)机制、以及高效的多浏览器上下文(BrowserContext)轻量隔离技术。
1. 依赖安装与环境初始化
通过 pip 安装 Playwright 并调用其自带命令行工具一键下载配套浏览器内核:
pip install playwright
playwright install chromium
2. 完整实战代码示例(网络拦截与并发优化)
在动态爬取中,下载大量高清图片与多余字体文件是耗时大户。Playwright 允许通过 route 机制在网络层直接拦截并终止无关资源的请求,从而将单页渲染加载速度提升数倍:
import asyncio
from playwright.async_api import async_playwright

async def scrape_with_playwright(target_url: str):
    async with async_playwright() as p:
        # 1. 启动 Chromium 内核
        browser = await p.chromium.launch(
            headless=True,
            args=["--no-sandbox", "--disable-setuid-sandbox"]
        )

        # 2. 创建独立的浏览器上下文(环境沙箱,互不影响 Cookie 与缓存)
        context = await browser.new_context(
            viewport={"width": 1920, "height": 1080},
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
        )

        page = await context.new_page()

        # 3. 性能优化:路由拦截,屏蔽图片、媒体、字体等无关资源
        async def block_unnecessary_resources(route):
            if route.request.resource_type in ["image", "media", "font"]:
                await route.abort()
            else:
                await route.continue_()

        await page.route("**/*", block_unnecessary_resources)

        try:
            # 4. 访问页面,并等待基本网络达到空闲(500ms 内无超过 2 个并发请求)
            await page.goto(target_url, wait_until="networkidle", timeout=20000)

            # 5. 等待关键选择器出现在 DOM 树中并且可见
            target_selector = "div.quote"
            await page.wait_for_selector(target_selector, state="visible", timeout=10000)

            # 6. 提取结构化数据(利用内置 locator 进行评估)
            quotes = page.locator("div.quote")
            count = await quotes.count()

            results = []
            for i in range(count):
                quote_elem = quotes.nth(i)
                text = await quote_elem.locator("span.text").inner_text()
                author = await quote_elem.locator("small.author").inner_text()
                results.append({"quote": text, "author": author})

            return results

        finally:
            # 7. 优雅关闭页面与上下文
            await page.close()
            await context.close()
            await browser.close()

if __name__ == "__main__":
    items = asyncio.run(scrape_with_playwright("https://quotes.toscrape.com/js/"))
    print(f"Playwright 采集完成,共获取 {len(items)} 条内容")
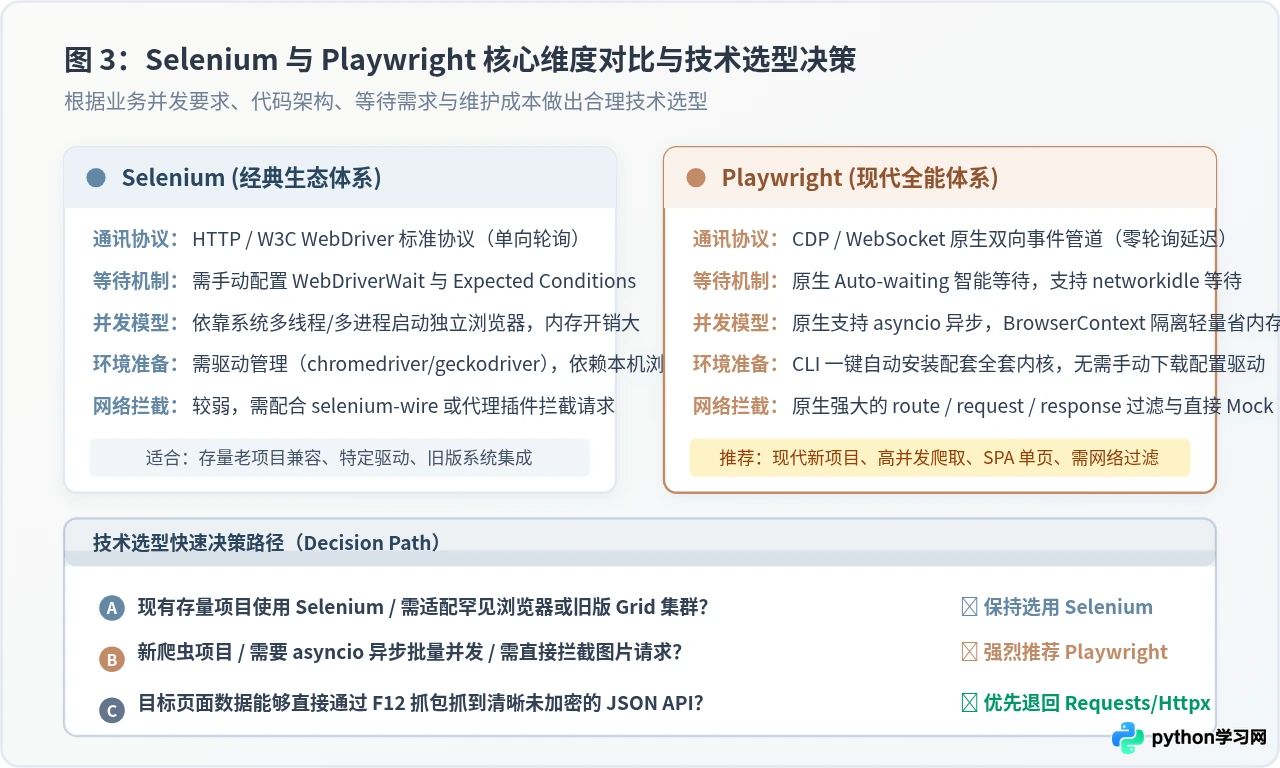
五、Selenium 与 Playwright 核心选型对比
在面对具体的业务爬虫需求时,应当根据项目特点、并发量、维护成本及运行环境综合权衡工具选型:
| 对比维度 | Selenium | Playwright |
|---|---|---|
| 底层通讯架构 | HTTP / W3C WebDriver 协议,请求-应答模式,指令具有轮询开销 | CDP / WebSocket 双向管道通信,实时事件监听,延迟极低 |
| 等待机制 | 需显式编写 WebDriverWait 和 EC 规则,否则极易报找不到元素 |
开箱即用的 Auto-waiting,操作前自动校验节点可用性 |
| 网络控制与拦截 | 原生功能弱,需引入额外代理中间件或第三方封装库 | 原生支持强大的 page.route,支持篡改、拦截、Mock 响应 |
| 异步与高并发 | 仅支持同步 API,高并发依赖多线程或多进程,内存占用显著 | 原生全面支持 Python asyncio 协程,多 Context 轻量隔离 |
| 驱动与环境部署 | 需手动或通过工具维护 chromedriver 版本与浏览器匹配 | 命令行自带一键管理所有浏览器内核,容器化(Docker)更便捷 |
六、动态渲染爬虫高频误区与性能调优清单
在生产环境中运行动态渲染爬虫时,很多初学者常常因为代码组织不当而导致程序卡顿、内存泄漏或被目标站点拦截。以下是四项必须遵循的最佳实践:
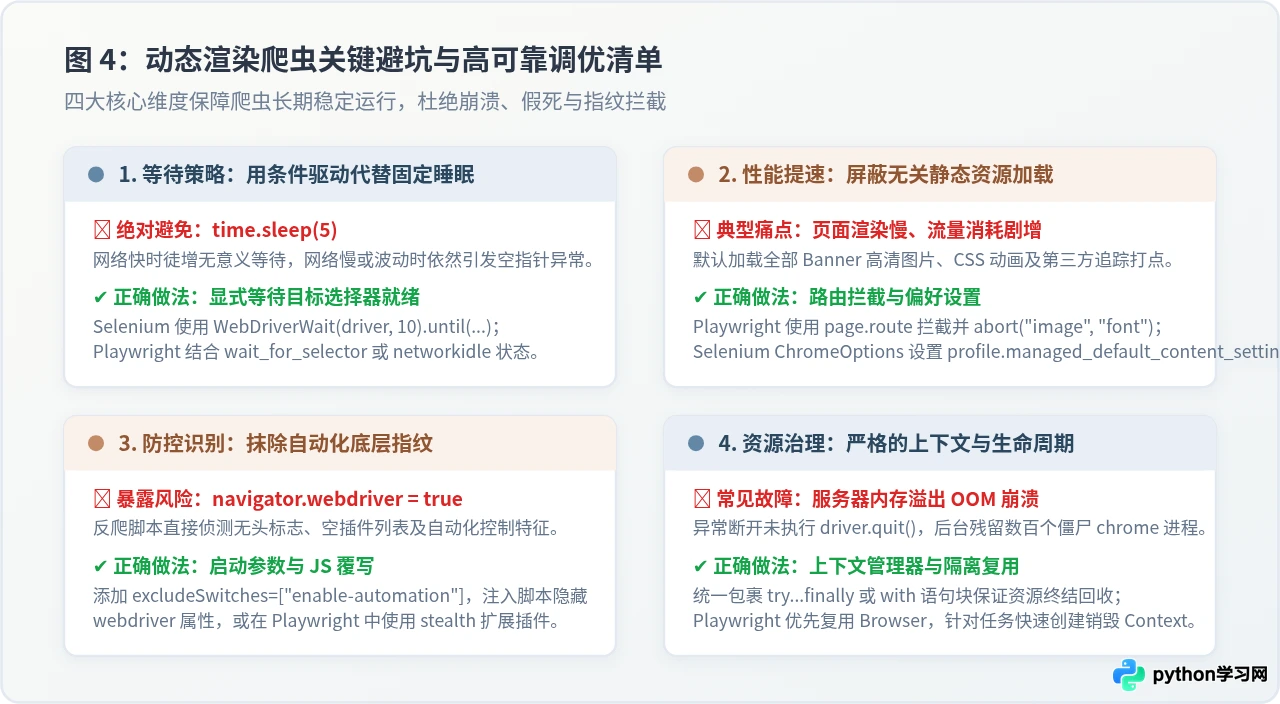
1. 坚决弃用固定休眠 time.sleep()
固定休眠是一种脆弱的反模式。若休眠时间设为 5 秒,当网络顺畅时,程序每页都会浪费数秒宝贵时间;当遇到服务器限流或网络波动时,5 秒后数据仍未加载完成,程序依然会因抛出 NoSuchElementException 崩溃。始终应采用基于选择器挂载状态、可见性(Visibility)或网络静默状态的条件驱动等待。
2. 严密管理浏览器进程的生命周期
浏览器实例是一个重量级的系统进程。如果在抓取过程中发生未捕获的异常导致脚本退出,未能执行 quit() 或 close(),后台将遗留大量失去父进程的 Chrome 僵尸进程。对于高频批量采集任务,应当:
- 使用
try...finally或上下文管理器确保即使抛出网络超时异常也能强制终止浏览器。 - 在批量任务中,严禁每次抓取一个 URL 就启动一次浏览器进程。应保持一个持久的
Browser实例,通过循环创建和销毁轻量的Page或Context来完成采集。
3. 防范自动化浏览器指纹识别
现代动态网站常植入反爬虫脚本(如 Cloudflare、Akamai、DataDome),它们会直接在客户端检查浏览器的原生属性。最基础的防御措施包括:
- 移除
window.navigator.webdriver属性标志。 - 为无头浏览器配置合理的视口大小(如 1920×1080)与合法的
User-Agent,避免使用无头模式默认的空视口或带有HeadlessChrome字样的特征头。 - 必要时结合社区维护的
undetected-chromedriver(针对 Selenium)或playwright-stealth插件以抹除高阶 WebGL、Canvas 硬件指纹异常。
4. 识别并提取渲染后 HTML(避免逐个元素网络调用)
如果页面上有数百条商品数据,在 Selenium 中使用 card.find_element() 循环遍历每一个标题和价格,会导致驱动层向浏览器内核发起成百上千次 IPC/网络调用,耗时极长。高效的折中策略是:在浏览器完成 JS 渲染和等待之后,通过 driver.page_source 或 Playwright 的 page.content() 一次性导出完整的活页 HTML,随后将其传入 BeautifulSoup 或 lxml 在内存中执行本地高速解析。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









