

学习Python常见的5个误区及高效避坑建议
针对Python初学者常见的只看不练、死记硬背、忽视虚拟环境、盲目冲刺框架、忽视调试排错等5大典型误区,提供切实可行的避坑建议与高效实践指南。
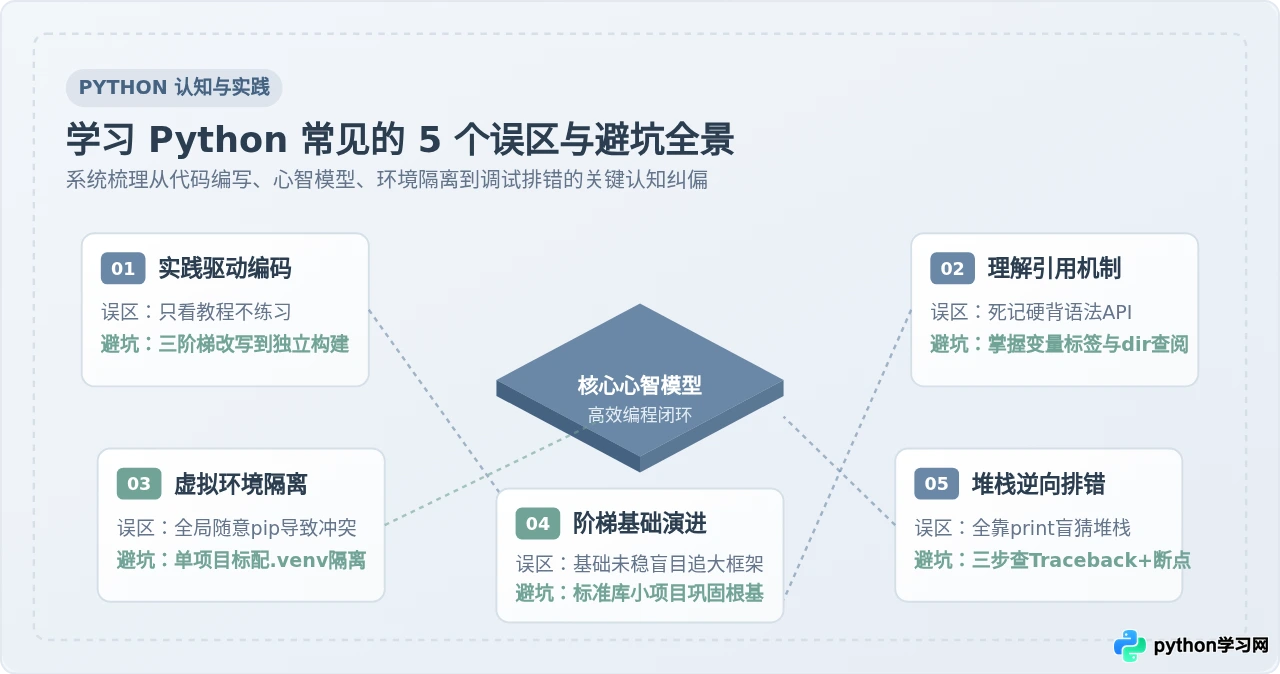
误区一:陷入“教程地狱”,只看不练缺乏自主编码能力
许多刚接触 Python 的学习者喜欢连续观看几十个小时的视频教程,或是成套阅读图文教程。在看教程的过程中,代码逻辑清晰易懂,读者往往会产生“我已经完全掌握了”的顺畅感。然而,一旦关闭教程、打开空白的代码编辑器,面对一个实际需求时,大脑却常常一片空白,不知道第一行代码该如何下手。
这种现象在编程学习中被称为“教程地狱”(Tutorial Hell)。它的本质是被动识别(Recognition)与主动提取(Production)之间的认知断层。看懂别人的解题过程只需要顺着讲师的思路做线性验证,而自主编写代码则需要将模糊的需求拆解为数据结构、控制流分支以及函数边界,这需要完全不同的大脑协同回路。
高效避坑建议:采用“三阶梯改写法”建立反馈回路
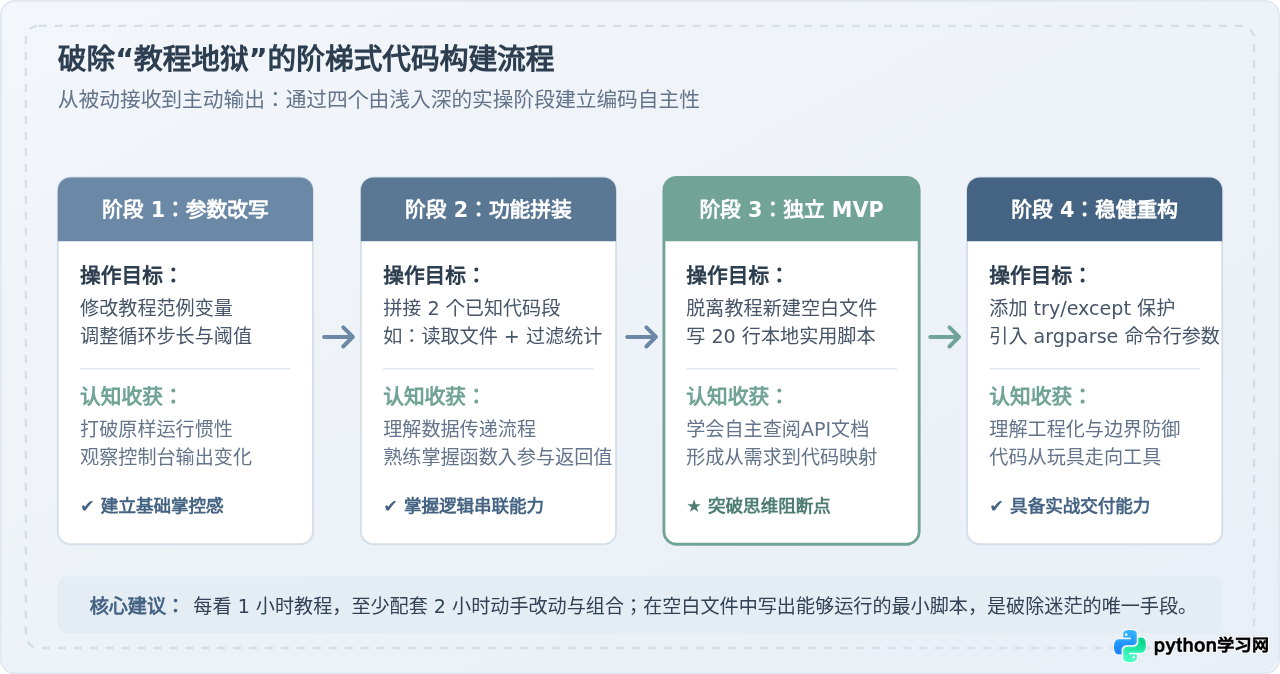
摆脱教程地狱的核心策略是缩短从“输入知识”到“主动输出代码”的时间间隔,不要等到学完一整门课程才开始做项目。读者可以采用以下三个由浅入深的步骤逐步建立掌控力:
- 阶梯 1(参数改写与边界试探):运行教程中的示例代码,但绝不原样照抄。主动修改其中的参数变量、反转排序顺序、测试空字符串或负数等边界条件,观察终端输出的反馈。
- 阶梯 2(功能拼装与管道连接):选取两个独立的教程片段,尝试将其串联。例如将“读取本地文本文件”的代码段与“统计单词频次”的代码段结合,写成一个词频分析小函数。
- 阶梯 3(独立构建最小可用脚本 MVP):脱离现成教程代码,完全从零新建一个
.py文件,限定在 20 至 50 行内实现一个身边可用的自动化小脚本。
下面是一个典型的小型实战练习示例:编写一个批量重命名指定目录下所有 .txt 文件的脚本。初学者可以亲自动手在本地目录测试并扩展功能:
# 文件名:batch_rename.py
# 功能:将当前目录下的所有 .txt 文件统一添加前缀并按顺序编号
import os
from pathlib import Path

def rename_text_files(target_dir: str, prefix: str) -> int:
    folder = Path(target_dir)
    if not folder.exists() or not folder.is_dir():
        print(f"指定目录不存在或不是文件夹: {target_dir}")
        return 0

    count = 0
    txt_files = sorted(folder.glob("*.txt"))
    for index, file_path in enumerate(txt_files, start=1):
        new_filename = f"{prefix}_{index:03d}{file_path.suffix}"
        new_path = file_path.with_name(new_filename)

        # 执行重命名并打印进度
        file_path.rename(new_path)
        print(f"已重命名: {file_path.name} -> {new_filename}")
        count += 1

    return count

if __name__ == "__main__":
    # 在当前目录下新建 test_docs 测试文件夹验证效果
    renamed_total = rename_text_files("./test_docs", "report")
print(f"处理完成,共重命名 {renamed_total} 个文件。")已重命名: draft.txt -> report_001.txt
已重命名: notes.txt -> report_002.txt
已重命名: summary.txt -> report_003.txt
处理完成,共重命名 3 个文件。误区二:死记硬背语法与内置API,忽视心智模型与检索能力
第二个常见误区是将编程当作外语单词来背诵。有些读者准备了笔记本,密密麻麻抄录了 str 的几十种切片方法、各种数据类型的内置函数清单以及标准库模块名,写代码时一旦想不起某个方法名就觉得自己没学好。
实际上,现代软件工程的核心能力是利用检索系统快速定位解决方案,而非全量记忆。更重要的是,死记硬背往往会导致初学者忽视 Python 底层最关键的运行机制——例如“变量是对象的贴纸(引用),而不是装东西的盒子”以及“可变对象(Mutable)与不可变对象(Immutable)的行为差异”。
高效避坑建议:建立对象引用心智模型,善用内建自省工具
初学者应当停止孤立记忆 API 列表,将重心转移到以下两项基础能力上:
1. 牢记“一切皆对象”与引用传递:在 Python 中,赋值语句 b = a 并非在内存中复制一份数据,而是让标签 b 也指向了 a 当前所绑定的同一个对象。如果该对象是可变类型(如列表、字典),通过 b 进行的就地修改会直接反映在 a 上。
# 验证变量作为对象引用的行为差异
list_a = [10, 20, 30]
list_b = list_a  # list_b 与 list_a 绑定同一个列表对象

list_b.append(40)
print(f"list_a 当前值: {list_a}")
print(f"内存标识 id(list_a): {id(list_a)}, id(list_b): {id(list_b)}")list_a 当前值: [10, 20, 30, 40]
内存标识 id(list_a): 4392817280, id(list_b): 4392817280通过上面的输出可以清晰地看到,id(list_a) 和 id(list_b) 完全一致,说明它们在底层就是同一个对象。理解了这一规则,就不会在后续处理复杂函数传参或多维列表复制(浅拷贝 vs 深拷贝)时感到费解。
2. 善用 Python 内建自省函数:在日常编码或终端实验中,不需要频繁切换网页查询语法。使用内建的 dir() 查看对象具备的所有属性和方法,使用 help() 查阅官方函数签名与文档说明:
# 在终端直接探索未知对象的方法和文档
import math
print([attr for attr in dir(math) if not attr.startswith("_")][:5])
# 输出示例: ['acos', 'acosh', 'asin', 'asinh', 'atan']

help(math.gcd)  # 立即查看最大公约数函数的参数定义与用途
误区三:全局环境随意安装依赖,忽视虚拟环境与依赖隔离
许多初学者在安装第三方库时,习惯直接在终端敲击 pip install package_name。在学习最初的两周,这种做法看似没有任何问题;但随着学习的深入,练习项目逐渐增多,问题便会集中爆发:
- 做数据分析项目需要安装某个特定版本的库(例如
pandas 1.5),而后来做网站开发项目又需要安装高版本(pandas 2.2),两者直接在全局环境互相覆盖; - 在 macOS 或 Linux 系统下,全局安装可能不小心修改系统底层工具依赖的 Python 环境,导致系统自带的软件包管理器或工具链出现不可逆的损坏;
- 将写好的代码发送给朋友或部署到服务器时,因为无法精确说明到底依赖了哪些版本的包,程序直接抛出
ModuleNotFoundError或版本不兼容异常。
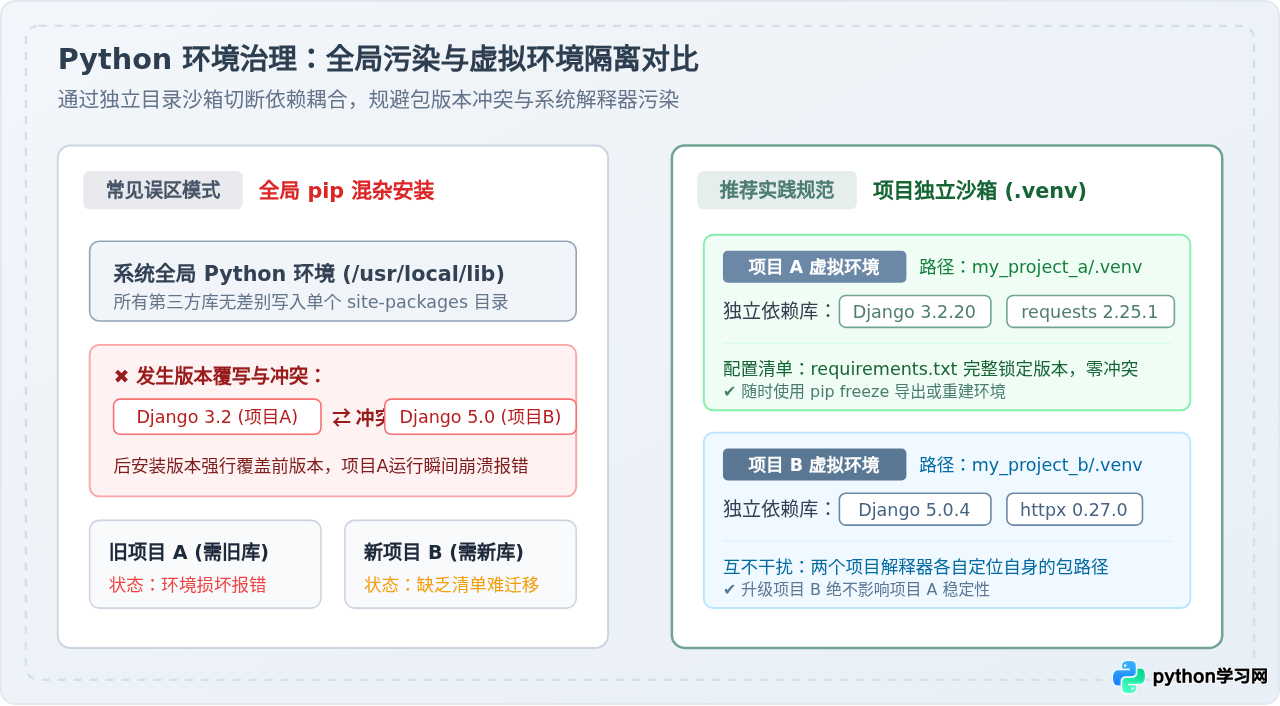
高效避坑建议:养成“一个项目、一个虚拟环境”的固定规范
从开始写第一个多文件项目起,就应该为每个工程建立独立的沙箱环境。Python 3 自带的 venv 模块无需额外安装任何工具即可满足全部需求。推荐的日常操作步骤如下:
- 创建虚拟环境:在项目的根目录下打开终端,执行以下命令,该命令会在当前目录下生成一个名为
.venv的隐藏文件夹,里面包含独立的 Python 解释器副本与包目录:python3 -m venv .venv - 激活虚拟环境:
激活成功后,命令行终端提示符前面会出现# macOS / Linux 系统: source .venv/bin/activate # Windows PowerShell 系统: .venv\Scripts\Activate.ps1(.venv)前缀。 - 验证环境生效:
终端输出的路径应该指向当前项目目录下的which python # Windows 对应使用 where python.venv/bin/python,而非系统的/usr/bin/python。 - 安装并固化依赖清单:在当前虚拟环境中安装所需要的第三方库,并导出版本锁定文件:
pip install requests
pip freeze > requirements.txt
.venv 文件夹提交到 Git 等代码版本管理工具中。在 .gitignore 文件中添加 .venv/,他人获取代码后只需运行 pip install -r requirements.txt 即可在自己的电脑上完整还原依赖。
误区四:未扎实基础语法与核心机制,盲目扎入高深框架
在大数据、人工智能和全栈开发的宣传驱动下,不少初学者刚刚接触 Python 几周,仅掌握了变量与 for 循环,就急于上手复杂的重型框架——例如直接扎进 PyTorch、TensorFlow 搭建神经网络,或者使用 Django、Scrapy 构建复杂系统。
这种“跳跃式学习”往往带来极大的挫败感。因为现代工业级框架封装了大量高阶语言机制:
- Web 框架中大量运用函数装饰器(Decorator)来绑定路由,初学者如果不懂闭包与作用域,就无法理解
@app.route是如何工作的; - 数据科学框架大量依赖类继承(Inheritance)与特殊方法(Dunder Methods,如
__getitem__、__call__),基础薄弱者在自定义数据集或模型层时根本看不懂源码逻辑; - 高深框架内部异常层层封装,一旦配置文件或参数出现细微错误,控制台会抛出长达数十行的嵌套异常,初学者因缺乏语言底层的认知,往往完全无力排查。
高效避坑建议:遵循阶梯式学习路径,设立明确的自测节点
在投入具体领域框架之前,应先使用 Python 原生语法和标准库构建至少两到三个结构清晰的小程序。读者可以通过以下阶梯路径有序推进:
- 阶段一(语法与核心容器):熟练掌握
list、dict、set的常用操作及其时间复杂度特性(例如为什么字典查询是 O(1) 而列表检索是 O(n))。 - 阶段二(面向对象与抽象思维):理解类与实例、属性与方法,能够合理设计包含 2 至 3 个类的小型数据处理模型,掌握
__init__与__str__等核心协议。 - 阶段三(标准库实战小工具):熟练运用内置模块(如
pathlib操作文件路径、json进行数据序列化、sqlite3操作本地轻量数据库),独立写出一个包含增删改查功能的命令行记账或任务管理程序。
完成上述阶段并能够独立解决问题后,再去学习 Flask、FastAPI、Pandas 或深度学习框架,学习者会发现框架不过是对这些语言基础的优雅组织,学习效率将提升数倍。
误区五:排错全靠 print 盲猜,忽视 Traceback 堆栈与调试工具
写代码不可避免地会遇到程序崩溃报错。许多初学者的典型应对反应是:看到终端出现红字就感到慌乱,随手复制最后一行错误信息去搜索引擎碰运气;或者在代码的每一行之间疯狂插入 print("111")、print("here"),试图靠肉眼观察代码运行到了哪一步。
这种纯靠盲猜的排错方式效率极低,而且很容易因为在排错后遗漏删除 print 语句而引入新的隐患。事实上,Python 解释器在发生异常时提供的堆栈回溯跟踪信息(Traceback)已经完整记录了导致故障的“第一现场”与调用链条。
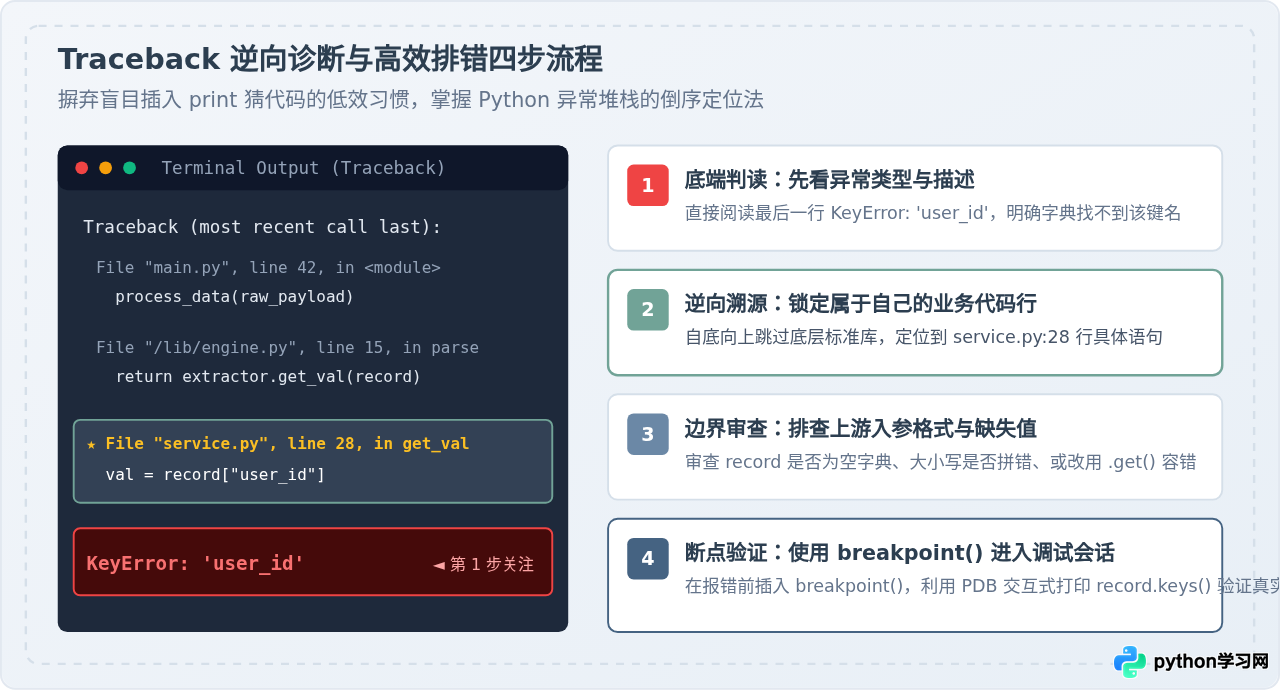
高效避坑建议:掌握 Traceback 倒序诊断法与内置断点
阅读 Python 的错误堆栈信息时,切记不要从最顶部看起,而应该采用“自底向上逆向定位法”:
- 第一步(看最后一行):直奔 Traceback 的最底部,这里写着具体的异常类型(Exception Name)和简明描述。例如
KeyError: 'user_id'表示字典缺少指定的键,IndexError: list index out of range表示列表索引越界。 - 第二步(向上找自己的文件):从底部向上回溯,跳过所有属于 Python 标准库或第三方包的路径(如
/site-packages/...),找到最后一条指向你自己编写的代码文件(例如service.py第 28 行)。这一行正是触发异常的代码位置。 - 第三步(结合上下文分析变量):回到代码编辑器对应的行号,审视该行涉及的变量值,检查是否有预料之外的
None值、数据类型不匹配或空集合。
如果业务逻辑较为复杂,无法仅通过静态阅读找出原因,推荐直接使用 Python 3.7 起原生内置的 breakpoint() 函数。在怀疑有问题的代码行前直接插入断点:
def calculate_user_discount(user_profile: dict) -> float:
    # 在关键计算前插入内置断点,程序执行到此处会暂停并进入交互式调试器
    breakpoint()

    score = user_profile.get("score", 0)
    if score >= 100:
        return 0.8
    return 1.0

if __name__ == "__main__":
    profile_data = {"name": "Alice", "score": 120}
    discount = calculate_user_discount(profile_data)
    print(f"最终折扣: {discount}")
当程序运行到 breakpoint() 处时,终端会弹出一个交互式 (Pdb) 调试控制台:
- 输入
p user_profile即可直接打印出当前字典的实际结构与键值; - 输入
n(Next)单步执行下一行代码; - 输入
c(Continue)让程序恢复全速执行; - 输入
q(Quit)立刻退出调试。
熟练运用 breakpoint() 能够帮助开发者在 30 秒内准确定位任何运行时的逻辑分歧,彻底告别满屏 print 的低效调试习惯。
总结:5 个误区的关键纠偏清单
学习 Python 的过程,本质上是从“被动接受规则”向“主动组织工程逻辑”转变的过程。遇到报错与瓶颈是编码过程中的必经阶段,关键在于建立正向、科学的反馈与验证机制。
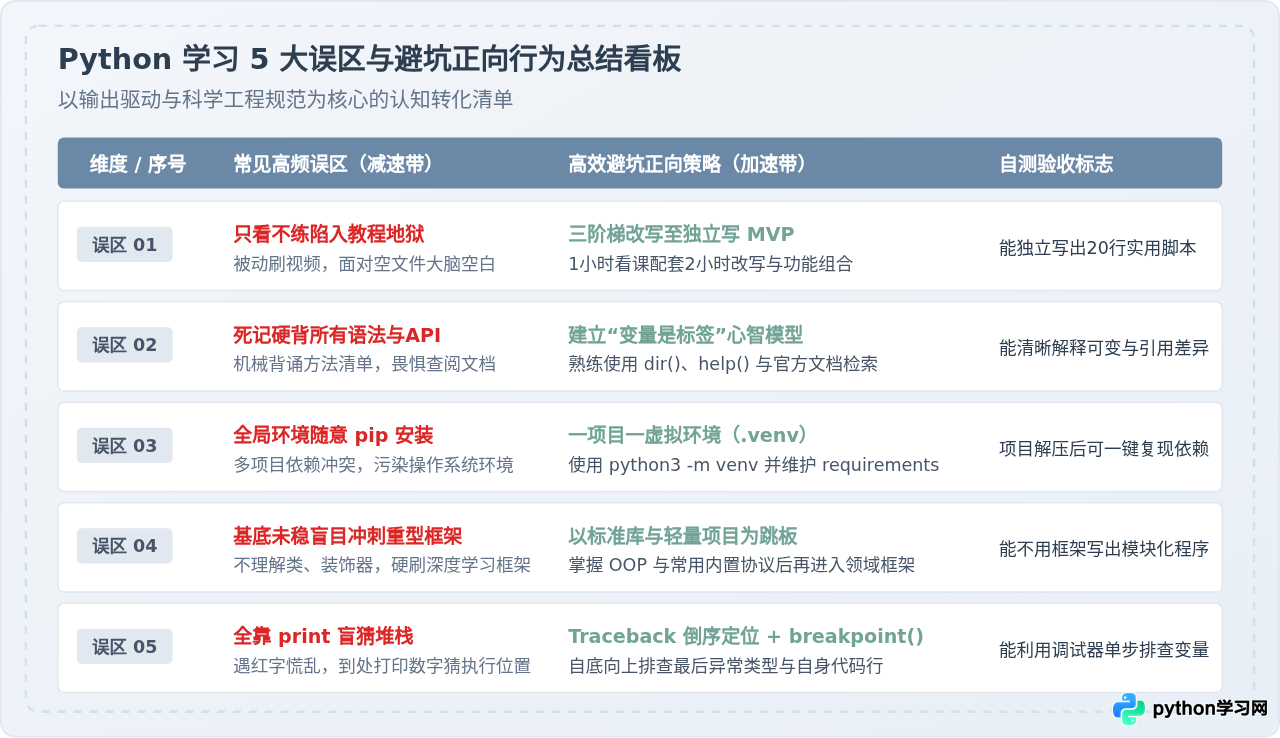
将上述建议落实在日常学习中的三个核心习惯:
- 保持高频输出:每看一段知识点,立刻在终端或空白脚本中动手敲出变体,用具体的运行结果驱动记忆。
- 维护干净边界:无论多小的练习,只要需要安装第三方包,务必使用
.venv进行沙箱隔离。 - 尊重错误信息:把 Traceback 当作最精准的调试导航,从底端逆向追踪代码行,利用交互式断点观察真实数据状态。
只要避开这些常见的消耗型误区,持续通过最小可用项目积累手感,每一位初学者都能稳步建立起坚实的编程能力与工程素养。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









