

Python主流爬虫库对比:Scrapy、Selenium与Playwright该怎么选择
深入对比Python主流爬虫框架Scrapy、Selenium与Playwright的架构原理、通信协议、性能开销与反爬支持,提供详细的代码示例与选型决策指南。
一、三款爬虫库的核心定位与底层架构
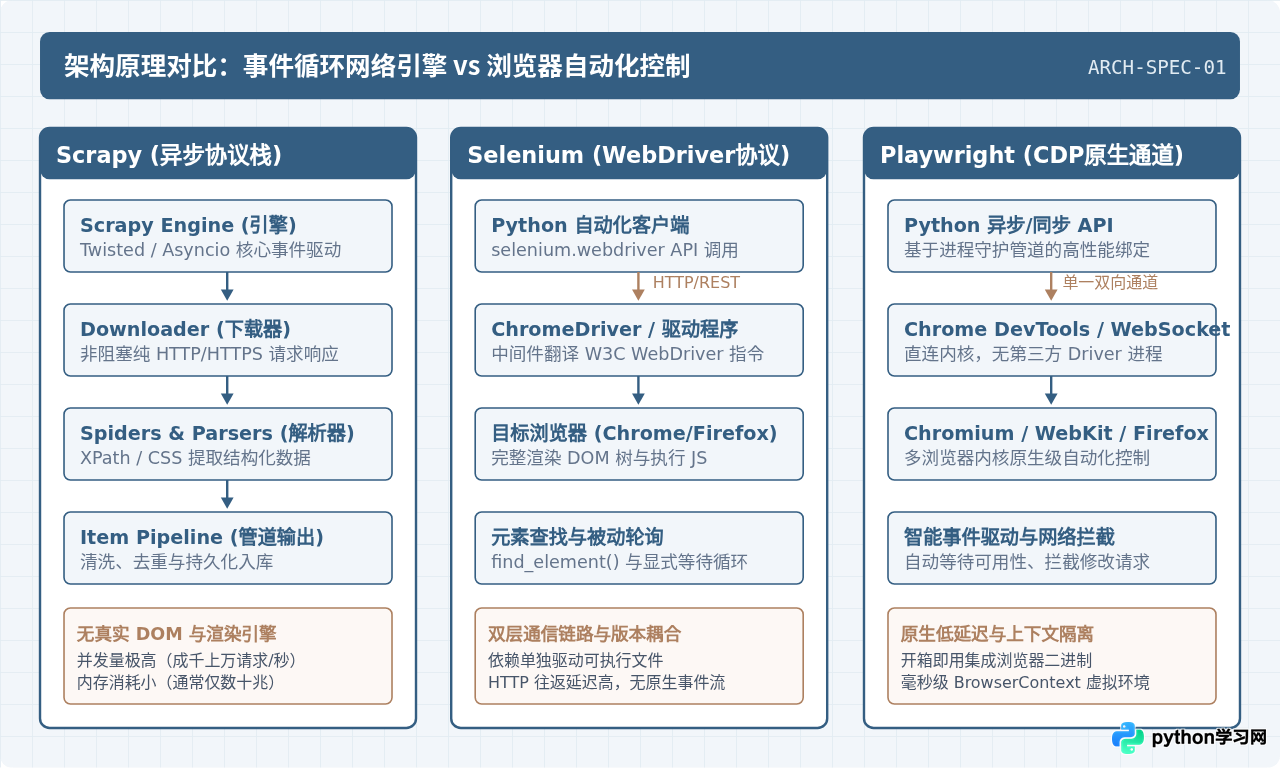
要做出准确的技术选型,首先需要理解三者在设计哲学与运行时架构上的根本分歧。Scrapy 是一个应用级网络抓取框架,而 Selenium 与 Playwright 的本质则是浏览器自动化测试驱动,后两者通过操作真实的渲染内核来间接完成网页抓取。
1. Scrapy:高吞吐量的异步爬虫框架
Scrapy 基于 Twisted 异步事件循环架构(较新版本亦支持 asyncio),其目标是实现极高频率的 HTTP 数据收发。Scrapy 自身不包含 JavaScript 引擎,不会执行网页中的脚本代码,也不会渲染样式表。这意味着它获取的是服务器返回的“初始 HTML 文本”。对于传统门户、列表型接口或服务端渲染(SSR)的网页,Scrapy 能够以单机数百甚至上千请求/秒的速率采集数据,资源利用率极高。
2. Selenium:跨时代的浏览器自动化先行者
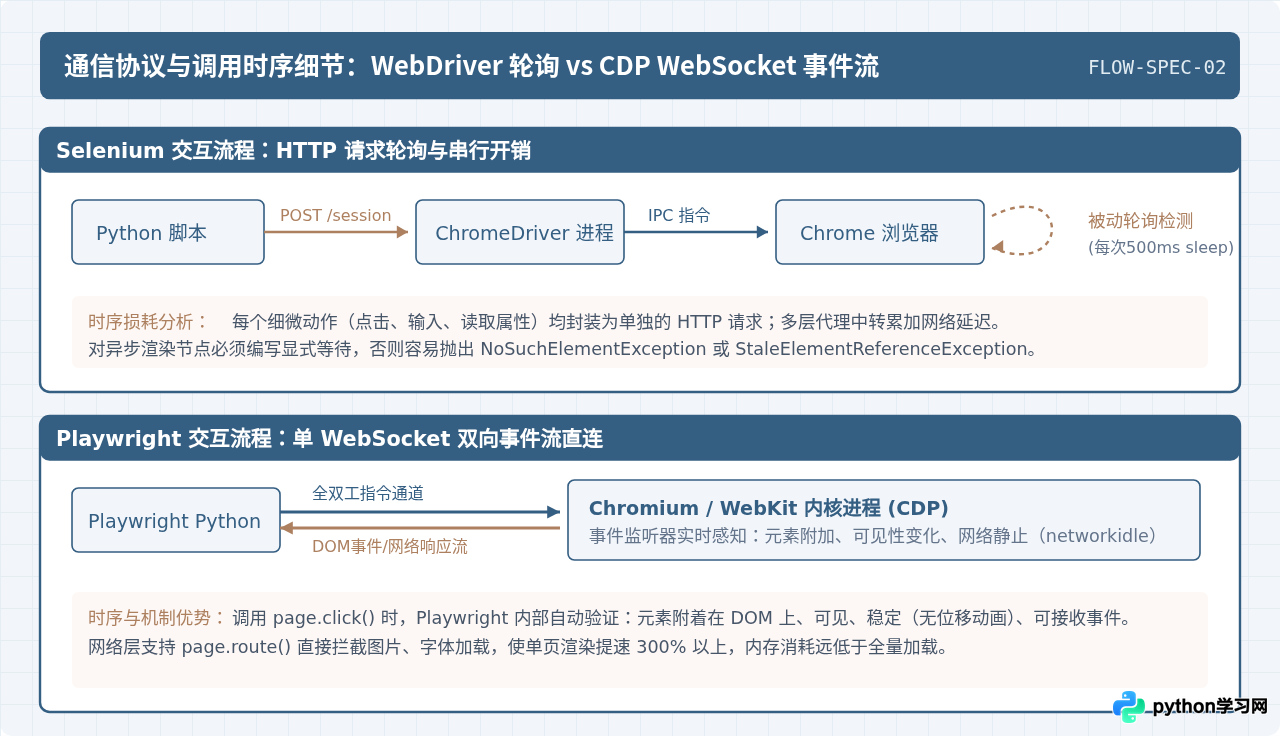
Selenium 诞生于自动化测试领域,其核心是通过 W3C WebDriver 标准协议,由 Python 脚本通过 HTTP 请求向独立的浏览器驱动程序(如 chromedriver 或 geckodriver)发送 REST 指令,驱动程序再通过底层接口操控浏览器。由于每次操作都经历一次“脚本 → HTTP 请求 → 驱动程序 → 浏览器”的往返过程,且对异步动态加载的元素需要反复轮询探测,因此在批量爬虫任务中执行延迟高、资源开销较大。
3. Playwright:专为现代 Web 打造的下一代自动化引擎
微软主导开发的 Playwright 同样使用真实无头浏览器,但摒弃了传统的 WebDriver 中间件模式。它通过单个长连接 WebSocket 直接与浏览器内核的底层调试协议(例如 Chrome DevTools Protocol,简称 CDP)建立双向通信。所有指令、页面事件、DOM 突变与网络流都在这根全双工通道中实时流转,具备原生的自动等待(Auto-waiting)和细粒度网络路由拦截能力。
二、关键指标多维对比
在进行技术选型时,可以通过以下关键工程指标进行横向权衡:
| 对比维度 | Scrapy | Selenium | Playwright |
|---|---|---|---|
| 网页渲染能力 | 无(仅获取静态响应体,需配合插件) | 完整渲染(真实浏览器内核) | 完整渲染(Chromium, WebKit, Firefox) |
| 并发与吞吐量 | 极高(单机轻松支撑 500~2000+ RPS) | 低(受限浏览器实例内存,10~30 实例/机) | 中高(支持轻量 Context,30~80 实例/机) |
| 单任务内存占用 | 极小(通常 20MB ~ 80MB) | 大(单浏览器 300MB ~ 1GB+) | 中等(共享浏览器进程,Context 仅数十MB) |
| 元素等待机制 | 无需等待(直接获取文本) | 被动轮询(需编写 WebDriverWait) | 自动等待(操作前自动检测可见可交互) |
| 网络请求拦截 | 原生支持(Downloader Middleware) | 支持受限(仅新版有限 CDP 支持) | 原生强大(可在网络层模拟、修改或阻止) |
| 环境依赖配置 | 仅需 Python 依赖包 | 需匹配操作系统、浏览器及独立驱动版本 | playwright install 一键安装完备环境 |
| 反爬绕过难度 | 易被 TLS 指纹/WAF/JS 探针识别 | 特征明显(暴露 navigator.webdriver) |
支持隐身上下文与高度定制指纹伪装 |
三、三者代表性代码实现与设计范式
以下针对同一个“获取包含翻页或异步数据的商品列表”需求,分别给出三款工具的规范实现与关键步骤说明。
1. Scrapy 规范实现(基于规则与选择器)
Scrapy 适合批量管道化抓取。代码由标准的 Spider 类驱动,通过生成器输出请求与数据项,支持分布式去重扩展。
# -*- coding: utf-8 -*-
import scrapy

class QuotesSpider(scrapy.Spider):
    name = "quotes"
    allowed_domains = ["quotes.toscrape.com"]
    start_urls = ["https://quotes.toscrape.com/"]

    custom_settings = {
        'CONCURRENT_REQUESTS': 16,
        'DOWNLOAD_DELAY': 0.25,
        'ROBOTSTXT_OBEY': False,
        'LOG_LEVEL': 'INFO'
    }

    def parse(self, response):
        # 1. 直接通过 CSS/XPath 提取静态结构
        for quote in response.css('div.quote'):
            yield {
                'text': quote.css('span.text::text').get(),
                'author': quote.css('small.author::text').get(),
                'tags': quote.css('div.tags a.tag::text').getall(),
            }

        # 2. 跟进下一页链接
        next_page = response.css('li.next a::attr(href)').get()
        if next_page is not None:
            yield response.follow(next_page, callback=self.parse)
2. Selenium 规范实现(显式等待与交互)
在 Selenium 中抓取动态网页时,必须配置无头模式与显式等待(WebDriverWait),避免依赖脆弱的固定延时 time.sleep()。
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from webdriver_manager.chrome import ChromeDriverManager

def fetch_with_selenium():
    options = webdriver.ChromeOptions()
    options.add_argument("--headless=new")
    options.add_argument("--disable-gpu")
    options.add_argument("--no-sandbox")
    options.add_argument("--disable-dev-shm-usage")

    driver = webdriver.Chrome(service=Service(ChromeDriverManager().install()), options=options)
    results = []

    try:
        driver.get("https://quotes.toscrape.com/js/")
        wait = WebDriverWait(driver, 10)

        # 显式等待目标异步渲染容器就绪
        quote_elements = wait.until(
            EC.presence_of_all_elements_located((By.CSS_SELECTOR, "div.quote"))
        )

        for el in quote_elements:
            text = el.find_element(By.CSS_SELECTOR, "span.text").text
            author = el.find_element(By.CSS_SELECTOR, "small.author").text
            results.append({"text": text, "author": author})

        print(f"Selenium 成功获取数据项:{len(results)} 条")
    finally:
        driver.quit()

if __name__ == "__main__":
    fetch_with_selenium()
3. Playwright 规范实现(异步并发与路由拦截)
Playwright 提供了原生 asyncio 接口。以下代码演示其两大杀手级功能:自动等待选择器与资源路由拦截(屏蔽图片与样式表,大幅节省带宽与 CPU 开销)。
import asyncio
from playwright.async_api import async_playwright

async def fetch_with_playwright():
    async with async_playwright() as p:
        # 启动 Chromium 无头浏览器
        browser = await p.chromium.launch(headless=True)
        # 上下文隔离环境(轻量级,启动耗时仅需数十毫秒)
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        )
        page = await context.new_page()

        # 核心优化:拦截不必要的媒体资源,大幅降低内存与加载耗时
        await page.route(
            "**/*.{png,jpg,jpeg,svg,gif,webp,woff,woff2,css}",
            lambda route: route.abort()
        )

        await page.goto("https://quotes.toscrape.com/js/", wait_until="domcontentloaded")

        # 原生自动等待 div.quote 节点就绪并完成渲染
        quotes = await page.locator("div.quote").all()
        results = []

        for q in quotes:
            text = await q.locator("span.text").inner_text()
            author = await q.locator("small.author").inner_text()
            results.append({"text": text, "author": author})

        print(f"Playwright 采集成功:{len(results)} 条")
        await browser.close()

if __name__ == "__main__":
    asyncio.run(fetch_with_playwright())
四、操作指引:爬虫选型与环境验证步骤
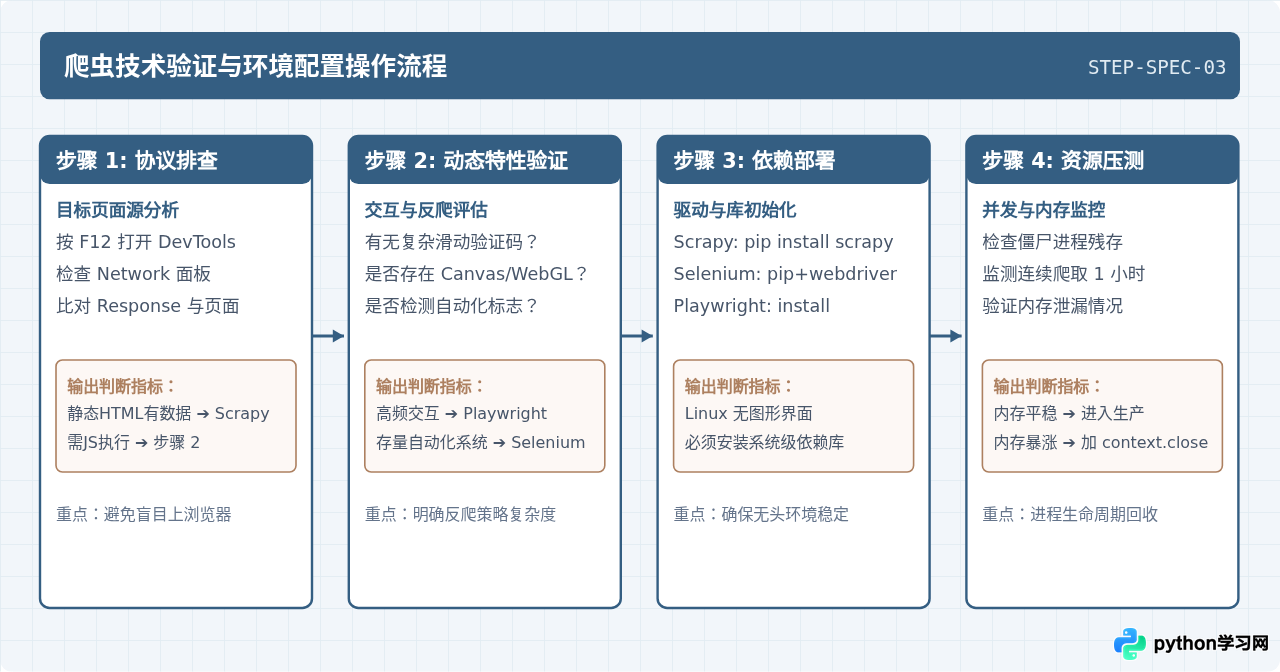
在正式进入工程编码前,建议按照以下四步验证目标网站的响应机制与本地环境:
-
第一步:排查目标接口性质。 在 Chrome 中按
F12切换到 Network 选项卡,筛选Fetch/XHR或Doc。查看返回的原始响应体中是否已包含目标数据。如果数据直接存在于 HTML 或清晰的 JSON 接口中,直接使用 Scrapy,不要引入浏览器内核。 - 第二步:评估交互复杂性。 若数据必须经由前端复杂的加密计算(如动态加签 token)生成,且无法在短期内完成逆向分析,则选择浏览器方案。
-
第三步:部署并验证底层运行时。
对于 Linux 服务器,如果使用 Playwright,执行
playwright install --with-deps chromium可自动配置操作系统级缺失的共享库;如果使用 Selenium,需确保 Chrome 与chromedriver的主版本号保持严格一致。 -
第四步:执行小规模并发内存测试。 在无头浏览器爬虫中,启动 20 个并发任务并连续运行 30 分钟,使用
top或htop观测是否存在未释放的僵尸进程或内存单调递增现象。
五、该怎么选:决策树与场景推荐
为了帮助开发者在实际业务中快速定型,以下将不同业务约束转化为明确的决策路径:
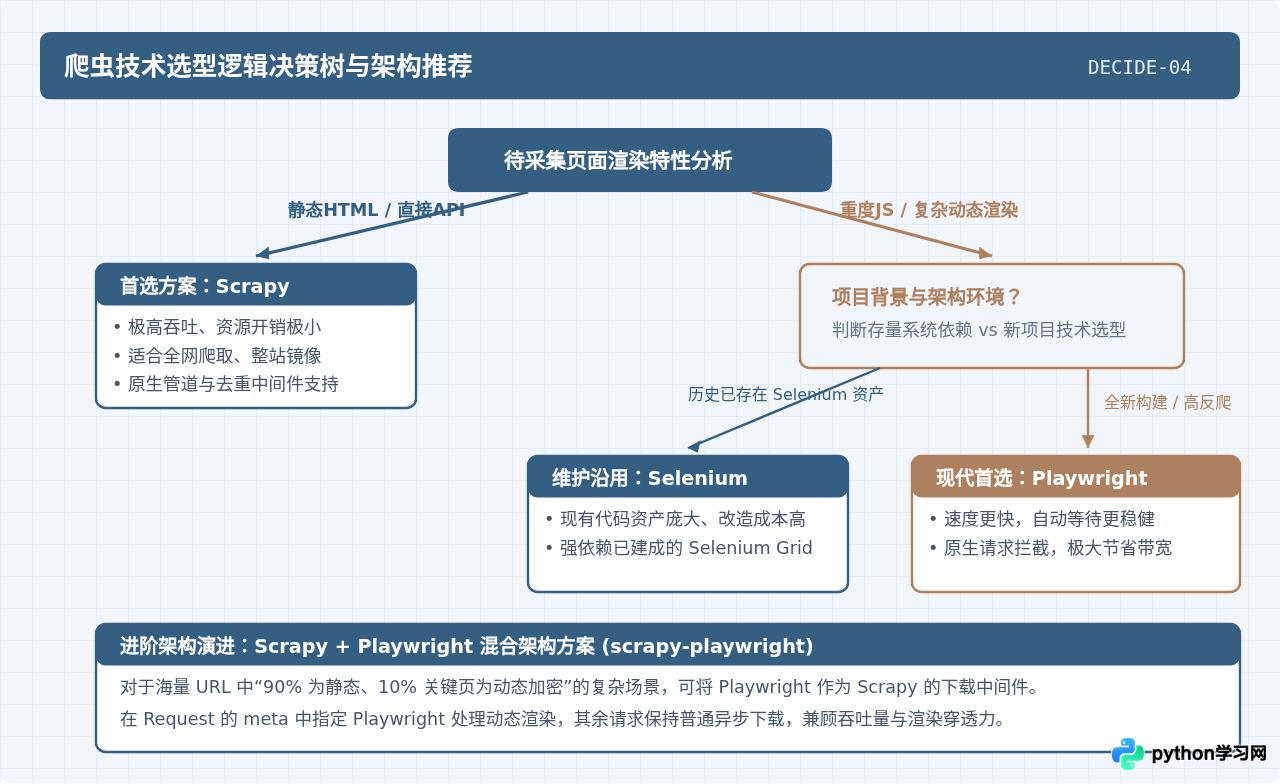
核心选型规则总结
-
规则一(数据源纯净):选择 Scrapy。
只要页面数据能在
requests.get()获取到的源码中找到,或者能通过抓包截获到标准的 JSON API,坚决采用 Scrapy。即使遇到海量网页调度,Scrapy 配合 Redis(scrapy-redis)也能稳定实现分布式横向扩容。 - 规则二(现代动态网页新建项目):选择 Playwright。 如果是近两年新起步的项目,且目标网站大量使用单页应用、前端混淆加密或有严格的交互验证要求,Playwright 是目前综合体验最优秀的库。其开箱即用的浏览器驱动安装、上下文(Context)机制以及自动等待特性,可以减少 80% 因页面未渲染完全引发的偶发报错。
- 规则三(存量框架与特殊平台):保留 Selenium。 若所在团队已有深厚基于 Selenium 的测试用例资产、或基础设施已托管在成熟的私有云 Selenium Grid 集群中,则无需盲目推翻重构;但在新业务中不建议作为第一选择。
-
规则四(大规模复杂爬取):采用 Scrapy + Playwright。
当全网数据采集既需要 Scrapy 强大高效的调度管道与数据清洗持久化机制,又不得不处理部分带有 JS 渲染的验证页面时,使用开源中间件
scrapy-playwright可以无缝结合两者的核心优势。
六、常见工程陷阱与避坑建议
在生产环境中落地爬虫时,以下问题经常导致爬虫运行变慢甚至系统崩溃,需要特别注意:
1. 内存泄漏与僵尸浏览器进程
使用 Selenium 或 Playwright 时,直接在循环中调用 browser.close() 可能因异常中断而跳过执行,导致后台遗留大量无头浏览器进程(例如大量的 chrome --type=renderer),迅速耗尽服务器内存。
解决方法:务必使用上下文管理器(如 async with async_playwright() 或 Python 的 try...finally 块),并在容器化部署(如 Docker)中显式引入 tini 作为 1 号进程,以确保能够正确回收子进程。
2. 反爬识别:navigator.webdriver 标志位
多数风控系统会检测浏览器的 navigator.webdriver 是否为 true。
在 Selenium 中通常需要额外传入参数修改参数;而在 Playwright 中,建议使用 playwright-stealth 库,在页面初始化脚本(init_script)中抹除自动化指纹与通知权限标识。
3. 并发模型误区:多开浏览器 vs 多开上下文
在 Playwright 中,启动一个 Browser 实例开销较大,但创建一个 BrowserContext 仅需数毫秒且完全具备独立的 Cookie、缓存与会话隔离。在爬取多账号或多会话网页时,应维持单个 Browser 常驻,通过频繁创建与销毁 BrowserContext 来实现并发抓取,而不是为每个任务单独拉起一个完整的 Chromium 进程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









