

怎么用Python代码批量读取requirements.txt并自动安装包
深入讲解如何使用Python标准库代码批量检索、解析清洗多个requirements.txt依赖文件,并通过绑定当前解释器的subprocess模块安全、容错地自动安装第三方库。
假设你正在接手一个由多个微服务或功能插件组成的复合工程,项目根目录下分散着不同子目录的 requirements.txt,有的服务还包含了针对调试环境的 requirements-dev.txt。如果完全依靠人工切换目录并逐条运行 pip install -r ...,不仅操作重复冗长,而且一旦某个包因网络超时或构建依赖缺失而中断,整条安装流程就会直接卡死。解决这一问题的直接方案,是编写一段独立的 Python 自动化脚本:利用内置的 pathlib 递归检索所有符合条件的依赖文件,通过文本解析滤除注释与空行,对跨模块依赖进行内存去重,最后利用 subprocess 模块绑定当前 Python 解释器安全执行 pip install 并输出完整的安装审计报告。
一、为什么必须用代码封装与关键原理认知
许多初学者在尝试用 Python 安装包时,最常见的两个失误是直接调用已弃用的内部模块 pip.main(),或是简单地通过 os.system("pip install ...") 发送命令。这两种做法在正式环境中极易引发故障。
第一,pip.main() 属于 pip 团队从不承诺向后兼容的私有接口,在高版本 pip 中已被移出顶层命名空间;并且它在同一 Python 进程内执行时不会清理全局缓存与模块导入状态,连续执行可能引发不可预期的死锁与环境混乱。第二,直接在命令行中输入 pip 会完全依赖当前操作系统的全局 PATH 环境变量。当开发机中同时存在系统 Python、conda 环境或项目专属的虚拟环境(venv)时,终端中的 pip 往往不会指向当前正激活的虚拟环境,导致所有第三方库被误装到全局环境中,甚至因权限不足直接报错退出。
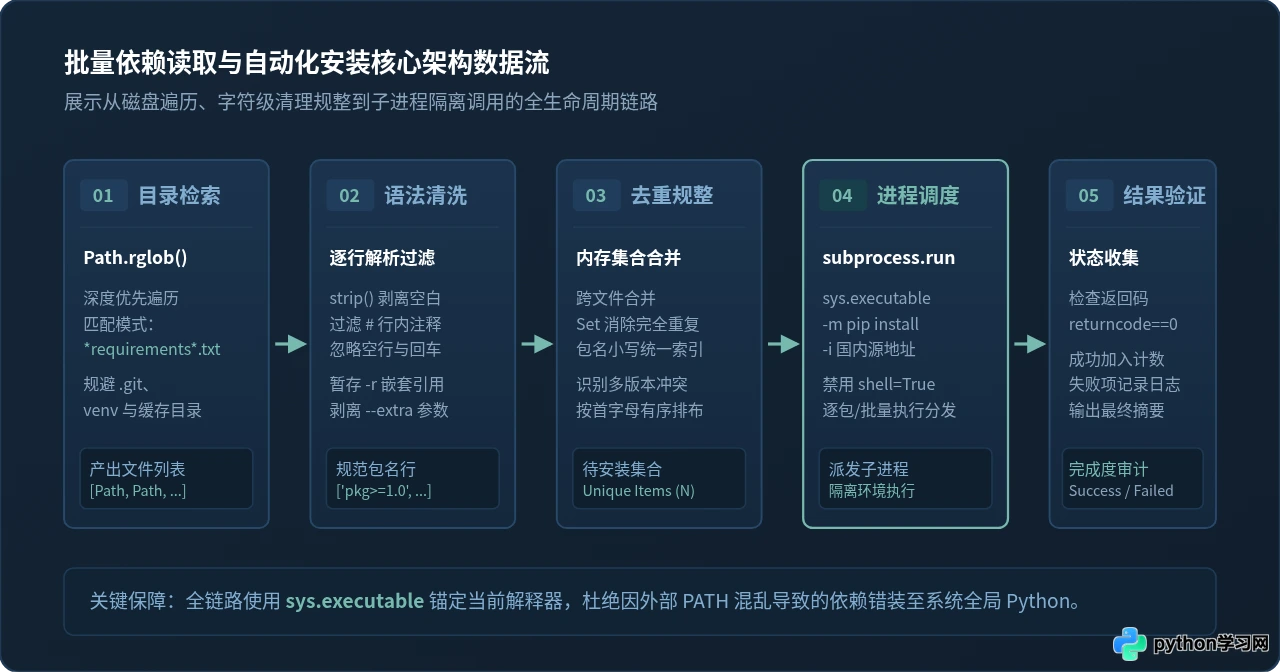
最为稳妥的工业级调用标准,是始终使用 sys.executable。通过 [sys.executable, "-m", "pip", "install", ...],可以确保子进程启动的 pip 绝对精确地绑定到当前正在运行代码的这个 Python 解释器所在的虚拟环境中。配合 subprocess.run() 并以列表形式传参(list of args),还能天然杜绝由于包名参数包含空格或特殊字符引发的 Shell 注入漏洞。
二、依赖文件的规范读取与文本清洗
一个标准的 requirements.txt 文件并不只是纯粹的包名列表,它通常包含版本约束符号(如 ==、>=、~=)、行首或行尾的 # 注释、空白行,甚至可能包含 -r other.txt 嵌套指令或 -i https://... 镜像配置。如果未经清洗就直接将每行内容扔给 pip,极易引发解析异常。
我们首先实现一个健壮的解析函数 parse_requirements(file_path)。该函数逐行读取文本,剥离前后空白字符,剔除 # 及其之后的说明文字,并对空行及选项参数做安全过滤:
from pathlib import Path
from typing import List, Set

def parse_requirements(file_path: Path) -> List[str]:
    """
    安全读取并清洗单个 requirements 文件中的依赖项。
    过滤空白行、行首/行内注释,保留合法的依赖定义。
    """
    valid_packages = []
    if not file_path.exists():
        return valid_packages

    with open(file_path, "r", encoding="utf-8", errors="ignore") as f:
        for raw_line in f:
            # 剥离行首行尾空白与换行符
            line = raw_line.strip()

            # 忽略空行与整行注释
            if not line or line.startswith("#"):
                continue

            # 剥离行内注释,例如 "requests>=2.28 # 网络请求库"
            if "#" in line:
                line = line.split("#", 1)[0].strip()

            # 过滤 pip 自身选项指令(如 -r, -i, -f, --extra-index-url 等)
            if line.startswith("-"):
                continue

            if line:
                valid_packages.append(line)

return valid_packagesopen() 时指定 errors="ignore",可以防止某些包含特殊编码注释或外部历史遗留的 ANSI/GBK 格式依赖文件在读取时抛出 UnicodeDecodeError,从而提升脚本在不同跨平台项目中的兼容性。
三、通过 subprocess 安全执行安装与逐包容错机制
在批量安装场景下,通常存在两种执行思路:一次性全量安装与逐包隔离容错安装。全量安装的速度稍快,但缺点是一旦集合中有一个包存在拼写错误或当前平台缺乏预编译 Wheel,整条安装就会直接崩溃退出。而在运维或多模块初始化场景中,更实用的做法是逐包隔离安装,遇到失败时记录包名并继续安装其余模块,最后汇总失败清单供排查。
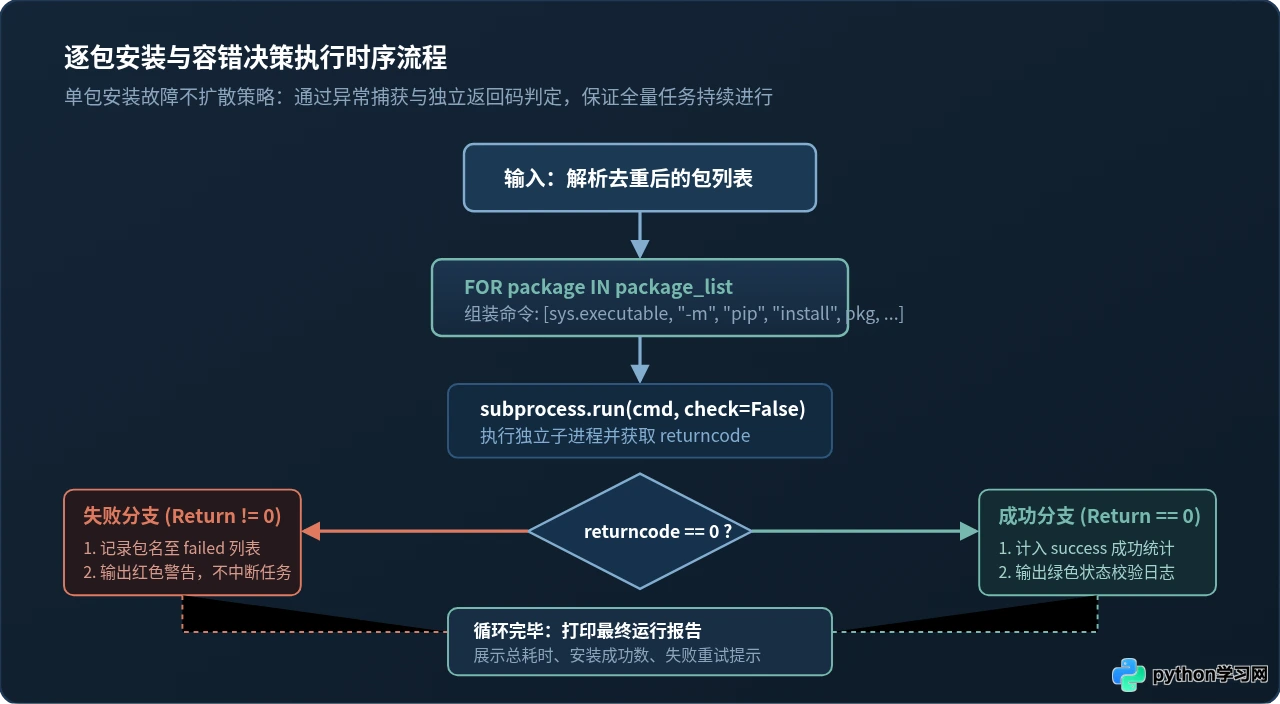
下面是封装了执行调度与容错统计的安装函数 install_packages(),支持配置自定义 PyPI 镜像源与超时时间:
import sys
import subprocess
from typing import List, Tuple

def install_packages(
    packages: List[str],
    index_url: str = "https://pypi.tuna.tsinghua.edu.cn/simple",
    timeout_sec: int = 120
) -> Tuple[List[str], List[str]]:
    """
    逐项安装依赖包,捕获异常并返回 (成功列表, 失败列表)。
    """
    success_list = []
    failed_list = []
    python_bin = sys.executable

    print(f"[INFO] 正在使用 Python 解释器: {python_bin}")
    print(f"[INFO] 准备安装 {len(packages)} 个独立依赖项...\n")

    for index, pkg in enumerate(packages, start=1):
        print(f"[{index}/{len(packages)}] 正在安装: {pkg} ...", end=" ", flush=True)

        # 组装安全执行命令列表
        cmd = [python_bin, "-m", "pip", "install", pkg]
        if index_url:
            host = index_url.split("//")[-1].split("/")[0]
            cmd.extend(["-i", index_url, "--trusted-host", host])

        try:
            # check=False 允许自主检查返回码,capture_output 抑制无谓的冗长刷屏
            proc = subprocess.run(
                cmd,
                check=False,
                stdout=subprocess.PIPE,
                stderr=subprocess.PIPE,
                text=True,
                timeout=timeout_sec
            )

            if proc.returncode == 0:
                print("[成功]")
                success_list.append(pkg)
            else:
                print("[失败]")
                failed_list.append(pkg)
                # 仅输出错误原因首行,便于快速识别
                err_summary = proc.stderr.strip().splitlines()[-1] if proc.stderr.strip() else "未知退出错误"
                print(f"       错误详情: {err_summary}")

        except subprocess.TimeoutExpired:
            print("[超时]")
            failed_list.append(pkg)
            print(f"       错误详情: 超过 {timeout_sec} 秒未响应")
        except Exception as e:
            print("[异常]")
            failed_list.append(pkg)
            print(f"       错误详情: {str(e)}")

    return success_list, failed_list
执行该安装函数时,终端将呈现清晰的逐行进度提示,以下为真实的示例输出效果:
[INFO] 正在使用 Python 解释器: /workspace/.venv/bin/python
[INFO] 准备安装 3 个独立依赖项...
[1/3] 正在安装: requests>=2.28.0 ... [成功]
[2/3] 正在安装: fastapi==0.100.0 ... [成功]
[3/3] 正在安装: non-existent-demo-pkg-xyz ... [失败]
错误详情: ERROR: No matching distribution found for non-existent-demo-pkg-xyz
四、跨目录批量扫描与去重合并自动化管线
在多模块微服务或单体仓库(Monorepo)中,各个子服务的依赖往往分散存放在不同目录下。如果单纯重复执行单文件安装,由于公共依赖库(例如 requests 或 pydantic)在多个文件中均有声明,不仅会重复进行元数据比对,还容易因为各模块声明的版本约束范围微调而耗费多余的解析开销。
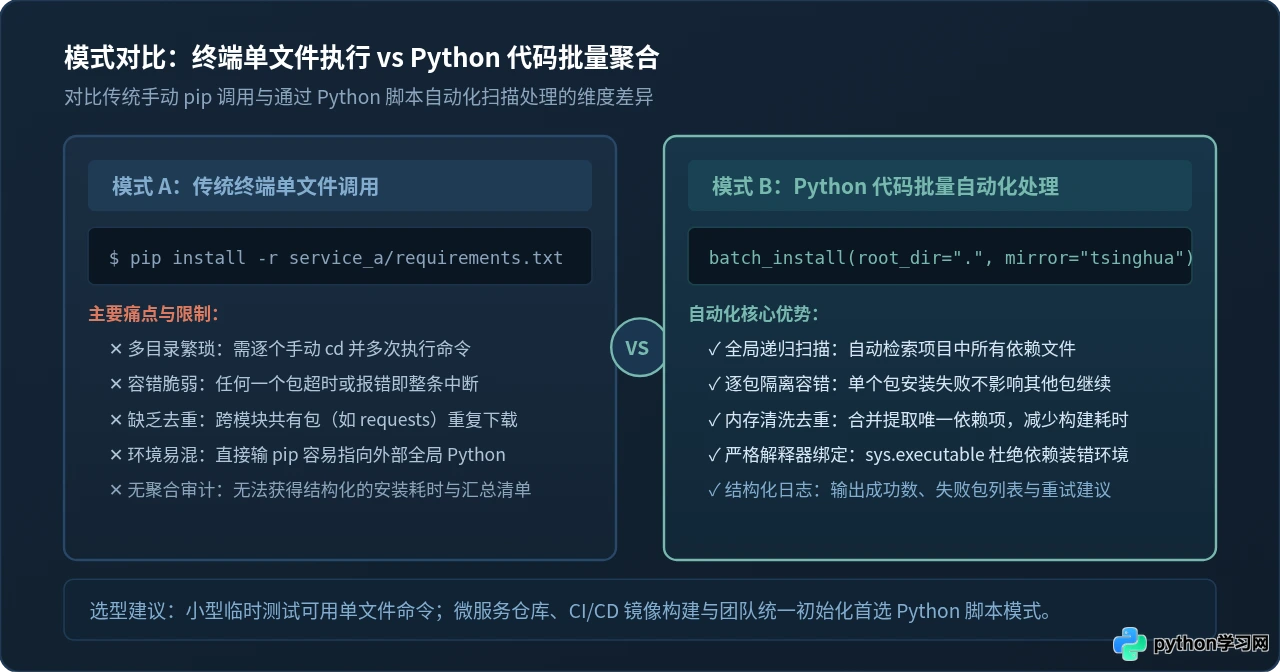
利用 pathlib.Path.rglob(),我们可以编写一个完整的入口脚本,自动遍历目录、排除 .git 或现有的 venv 目录、汇总所有 requirements*.txt 并通过集合去重。下面是完整的独立可运行脚本 batch_install_pipeline.py:
import sys
import time
import subprocess
from pathlib import Path
from typing import List, Set, Tuple

# 忽略无需扫描的目录名
EXCLUDE_DIRS = {".git", ".venv", "venv", "__pycache__", "build", "dist", ".idea", ".vscode"}

def find_all_requirements_files(root_path: Path) -> List[Path]:
    """
    递归检索指定根目录下的所有 requirements*.txt 文件,排除虚拟环境和构建缓存目录。
    """
    matched_files = []
    for p in root_path.rglob("*requirements*.txt"):
        # 检查路径各层级,跳过被排除的目录
        if not any(part in EXCLUDE_DIRS for part in p.parts):
            if p.is_file():
                matched_files.append(p)
    return sorted(matched_files)

def parse_and_aggregate(files: List[Path]) -> List[str]:
    """
    从多个依赖文件中提取并合并所有包声明,利用集合完成自动去重。
    """
    unique_packages: Set[str] = set()
    for f in files:
        packages = parse_requirements(f)
        for pkg in packages:
            unique_packages.add(pkg)
    return sorted(list(unique_packages))

def main():
    start_time = time.time()
    workspace_dir = Path(__file__).resolve().parent

    print("==================================================")
    print(" Python 依赖文件批量检索与自动化安装管线")
    print("==================================================")
    print(f"扫描根目录: {workspace_dir}")

    # 1. 检索所有需求文件
    req_files = find_all_requirements_files(workspace_dir)
    if not req_files:
        print("[WARN] 未找到任何符合命名规则的 requirements 文件,流程退出。")
        return

    print(f"\n[发现依赖文件 (共 {len(req_files)} 个)]:")
    for f in req_files:
        print(f"  - {f.relative_to(workspace_dir)}")

    # 2. 提取并清洗去重
    package_list = parse_and_aggregate(req_files)
    print(f"\n[聚合依赖分析]: 消除跨文件重复项后,最终提取到 {len(package_list)} 个待安装包。")

    # 3. 执行安装
    success, failed = install_packages(
        package_list,
        index_url="https://pypi.tuna.tsinghua.edu.cn/simple"
    )

    # 4. 输出统计报表
    cost = time.time() - start_time
    print("\n================ 运行报告汇总 ================")
    print(f"执行耗时: {cost:.2f} 秒")
    print(f"成功数量: {len(success)}")
    print(f"失败数量: {len(failed)}")
    if failed:
        print("\n安装失败的依赖项清单:")
        for item in failed:
            print(f"  ✕ {item}")
        print("建议:请核对包名拼写、Python 版本兼容性或系统 C 编译环境后重试。")
    else:
        print("\n状态确认:所有依赖项均已顺利安装至当前环境!")
    print("==================================================")

if __name__ == "__main__":
    main()
五、安装结果验证与环境确认
安装完成后,建议通过代码或命令行对当前环境中的包状态进行核实,确保安装结果真实有效。
在 Python 3.8 及以上版本中,可以通过标准库 importlib.metadata 直接在脚本内查询某个包是否成功安装及其具体版本号,而无需实际 import 该模块引发无关的代码执行:
import importlib.metadata

def verify_installed(package_name: str) -> bool:
    # 剥离版本符号(如 requests>=2.28 提取 requests)
    clean_name = package_name.split("=")[0].split(">")[0].split("<")[0].split("~")[0].strip()
    try:
        version = importlib.metadata.version(clean_name)
        print(f"已安装: {clean_name} (版本: {version})")
        return True
    except importlib.metadata.PackageNotFoundError:
        print(f"未找到包: {clean_name}")
        return False
如果需要在终端中通过命令统一验证,可以使用以下命令输出当前环境的所有已安装包列表:
python -m pip listPackage Version
------------------ ---------
fastapi 0.100.0
pip 23.3.1
requests 2.31.0
setuptools 68.2.2
六、生产环境常见陷阱与注意事项
在企业级持续集成(CI/CD)或复杂工程中运行此类自动安装脚本时,有几个关键的技术陷阱需要特别留意:
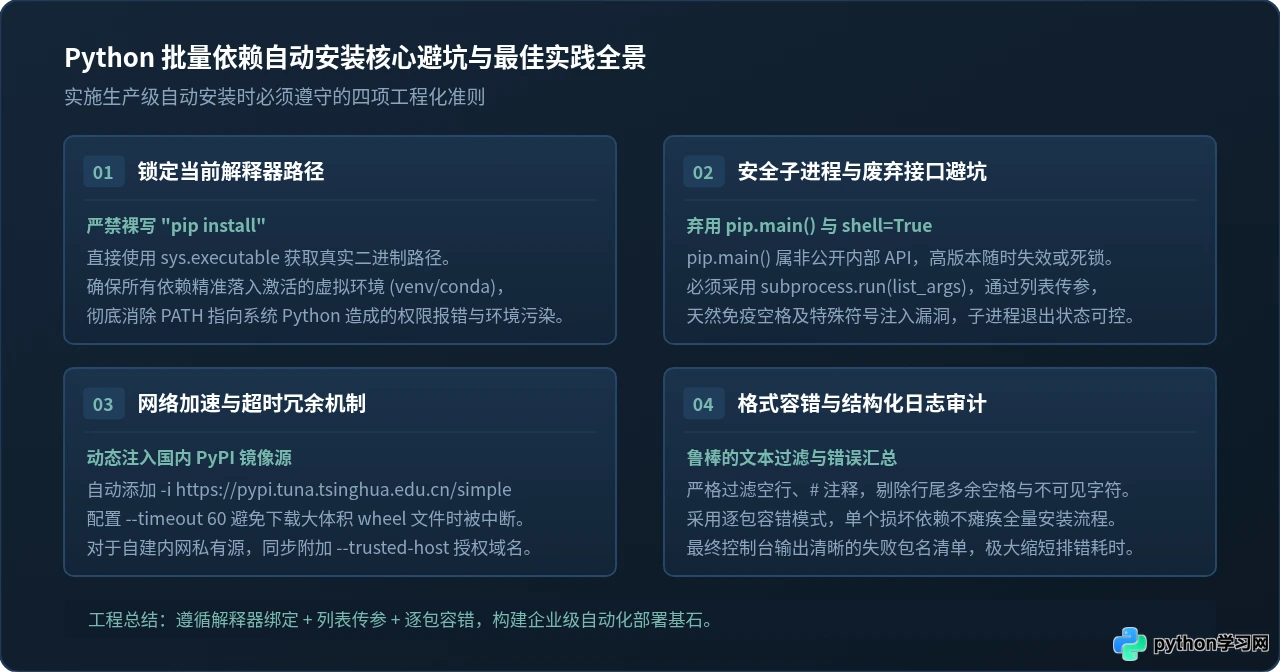
-
避免无意识污染宿主机系统 Python:
在运行自动安装前,可以在脚本开头加入虚拟环境判断逻辑。如果
sys.prefix == sys.base_prefix,说明当前正处于全局系统 Python 环境下运行,脚本可选择主动抛出警告或终止,防止意外修改系统底层组件。 -
国内镜像源的安全信任域名参数(trusted-host):
使用非官方默认 PyPI 源时,部分网络环境对自建私有镜像服务器会报 SSL 证书警告。组装命令时应随
-i同步追加--trusted-host参数,避免 pip 因证书安全校验策略中断下载。 -
复杂版本依赖冲突(Version Conflict):
若不同模块的
requirements.txt中定义了互斥的版本约束(例如 A 模块要求urllib3<2.0,B 模块要求urllib3>=2.0),逐包安装可能会发生“后安装的版本覆盖前一个版本”的情况。在大型项目中,更建议使用pip-tools先行编译锁定版本,或将聚合列表统一写入临时文件后执行一次性全量解析。 -
二进制 Wheel 与 C/C++ 编译环境缺失:
部分科学计算库(如
scipy、grpcio)如果在当前 Python 版本或特定操作系统架构下没有现成的预编译 wheel 包,pip 会尝试在本地进行源码编译。这要求操作系统必须预先安装好对应的编译工具链(如 Linux 的gcc / python3-dev或 Windows 的Visual C++ Build Tools)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









