

怎么用Python实现冒泡排序和快速排序
实用中文教程:从核心原理、完整Python代码实现、逐步执行图解到复杂度对比,手把手掌握冒泡排序与快速排序的具体实现及工程优化。
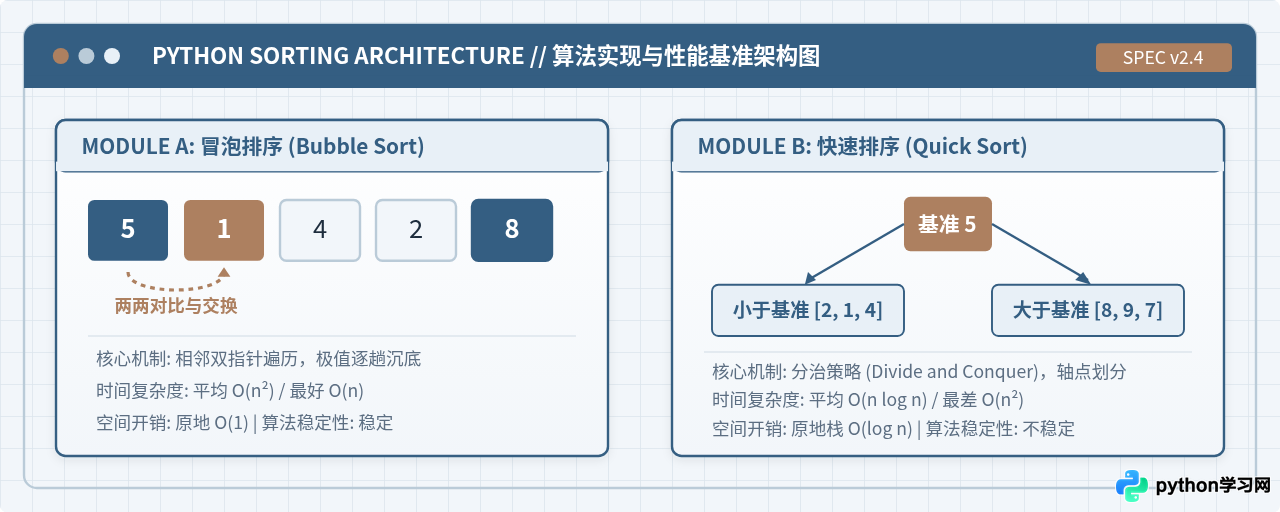
一、冒泡排序 (Bubble Sort) 的 Python 实现
冒泡排序是一种直观的交换排序算法。它的核心直觉非常简单:从数组的首项开始,依序对相邻的两个元素进行两两比较。如果前一个元素大于后一个元素,就将它们的位置互换;依次推进一趟后,整个数组中最大的那个数值就会被移动到最右侧的正确位置。
1. 基础版实现与逐步分析
在 Python 中,可以通过双重 for 循环直接实现。外层循环控制总共需要执行多少趟遍历,内层循环则负责在未排序区间内执行相邻元素的比对与交换:
def bubble_sort_basic(arr):
    n = len(arr)
    # 外层循环:控制遍历总轮数(共需 n - 1 轮)
    for i in range(n - 1):
        # 内层循环:比较相邻元素,已锁定的后 i 个元素无需再比
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                # Python 惯用的优雅解构赋值,实现原地元素互换
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
    return arr

# 示例调用
data = [5, 1, 4, 2, 8]
print("排序结果:", bubble_sort_basic(data))
# 示例输出: 排序结果: [1, 2, 4, 5, 8]
2. 引入标志位的提前终止优化
基础版冒泡排序存在一个明显缺陷:即便输入的序列已经完全有序(例如 [1, 2, 3, 4, 5]),内层循环依然会傻傻地执行所有比对。
改进方法是增加一个布尔变量 swapped。如果在某一整趟的相邻元素比对中没有触发过任何一次交换,说明当前数组已经全局有序,此时可以直接 break 提前跳出循环。
def bubble_sort_optimized(arr):
    n = len(arr)
    for i in range(n - 1):
        swapped = False
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        # 若本轮未发生交换,证明已有序,立刻提前终止
        if not swapped:
            break
    return arr
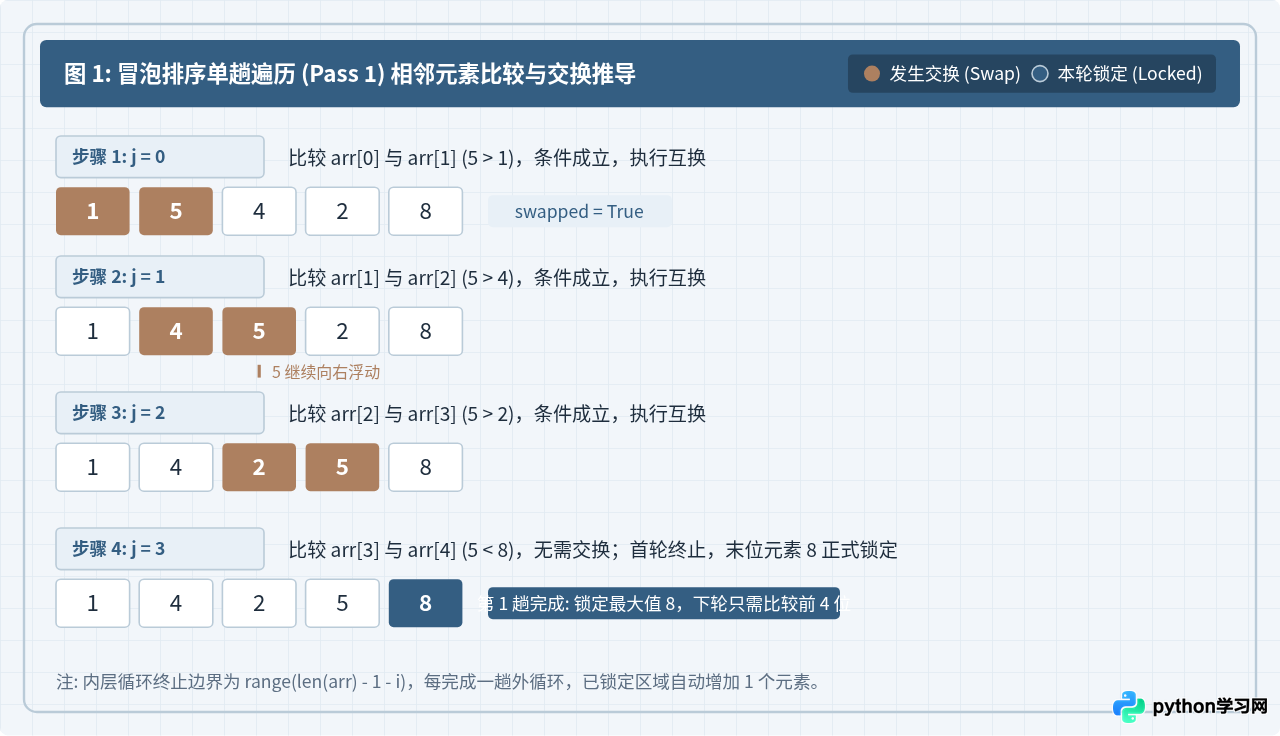
- 内循环的边界必须是
n - 1 - i而不是n - 1。因为每跑完一轮,右端就已经有i个数归位,重复比较已排好序的区间会带来白白的算力消耗。 - 数组访问下标谨防越界:在比较
arr[j]与arr[j+1]时,若内循环直接写成range(n)会抛出IndexError。
二、快速排序 (Quick Sort) 的 Python 实现
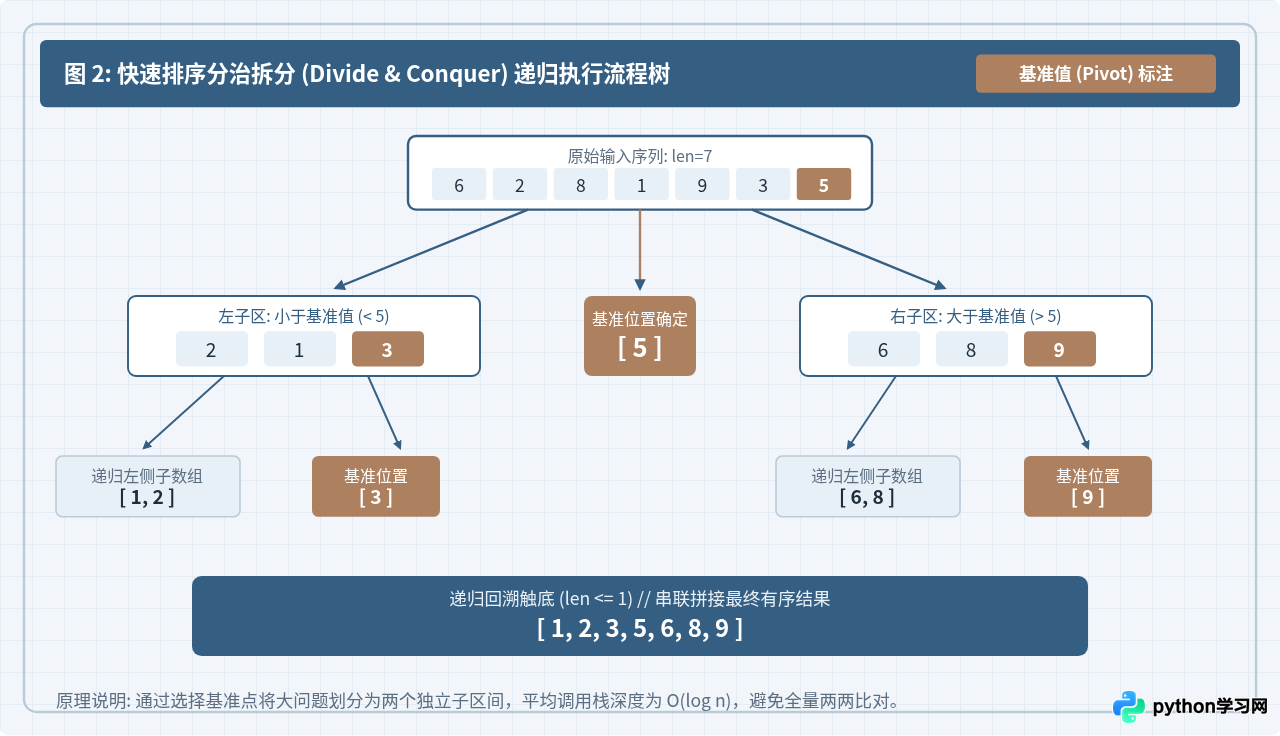
快速排序由托尼·霍尔(Tony Hoare)提出,运用了经典的“分而治之”(Divide and Conquer)策略。它不需要像冒泡那样逐个相邻传递,而是每次挑出一个数值作为“基准”(Pivot),一趟将原序列分为两部分:所有比基准小的都放在其左边,所有比基准大的都放在其右边。随后对左右两个分区递归调用相同的过程,直到子区间长度为 0 或 1 为止。
1. 教学直观版(列表推导式实现)
如果追求代码的可读性与直观性,在 Python 中利用列表推导式可以写出极其简洁的快速排序。这种写法极其符合数学定义,非常适合初学者理解分治结构:
def quick_sort_simple(arr):
    # 递归出口:空数组或单元素数组天然有序
    if len(arr) <= 1:
        return arr

    # 选取中间元素作为基准值(Pivot)
    pivot = arr[len(arr) // 2]

    # 根据与基准值的数值大小关系划分为三部分
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]

    # 递归合并左右两侧子数组
    return quick_sort_simple(left) + middle + quick_sort_simple(right)

# 示例调用
sample_data = [6, 2, 8, 1, 9, 3, 5]
print("快速排序结果:", quick_sort_simple(sample_data))
# 示例输出: 快速排序结果: [1, 2, 3, 5, 6, 8, 9]
2. 原地双指针版(In-Place Partition 工程实现)
列表推导式版本虽然逻辑优美,但在每一层递归中都开辟了新的列表容器(left、middle、right),产生了 O(n) 级别的额外空间开销。在内存敏感或高吞吐的工程场景中,通常使用双指针在原列表上直接进行数据交换:
def quick_sort_inplace(arr, low=0, high=None):
    if high is None:
        high = len(arr) - 1

    def partition(sub_arr, l, h):
        # 选取右边界元素作为基准
        pivot = sub_arr[h]
        i = l - 1  # 小于基准区间的右边界指针

        for j in range(l, h):
            if sub_arr[j] <= pivot:
                i += 1
                sub_arr[i], sub_arr[j] = sub_arr[j], sub_arr[i]

        # 将基准值放到正确的位置 i + 1
        sub_arr[i + 1], sub_arr[h] = sub_arr[h], sub_arr[i + 1]
        return i + 1

    if low < high:
        # 获取基准点归位后的索引
        pi = partition(arr, low, high)
        # 递归对左半段和右半段就地排序
        quick_sort_inplace(arr, low, pi - 1)
        quick_sort_inplace(arr, pi + 1, high)

    return arr
如果始终死板地选取数组的第一个或最后一个元素作为基准,一旦输入本身就是一个已经升序或逆序的数组,快速排序每次只能切掉 1 个元素,分治树将退化为高度为 n 的单链表。此时时间复杂度恶化为 O(n²),且深层递归可能触发 Python 的 RecursionError: maximum recursion depth exceeded。因此,实际中推荐选择中位数或随机基准。
三、冒泡排序与快速排序的核心性能对比
为了在实际编写代码时做出正确的决策,我们需要清晰认识两者在计算复杂度、内存占用与稳定性上的技术差异:
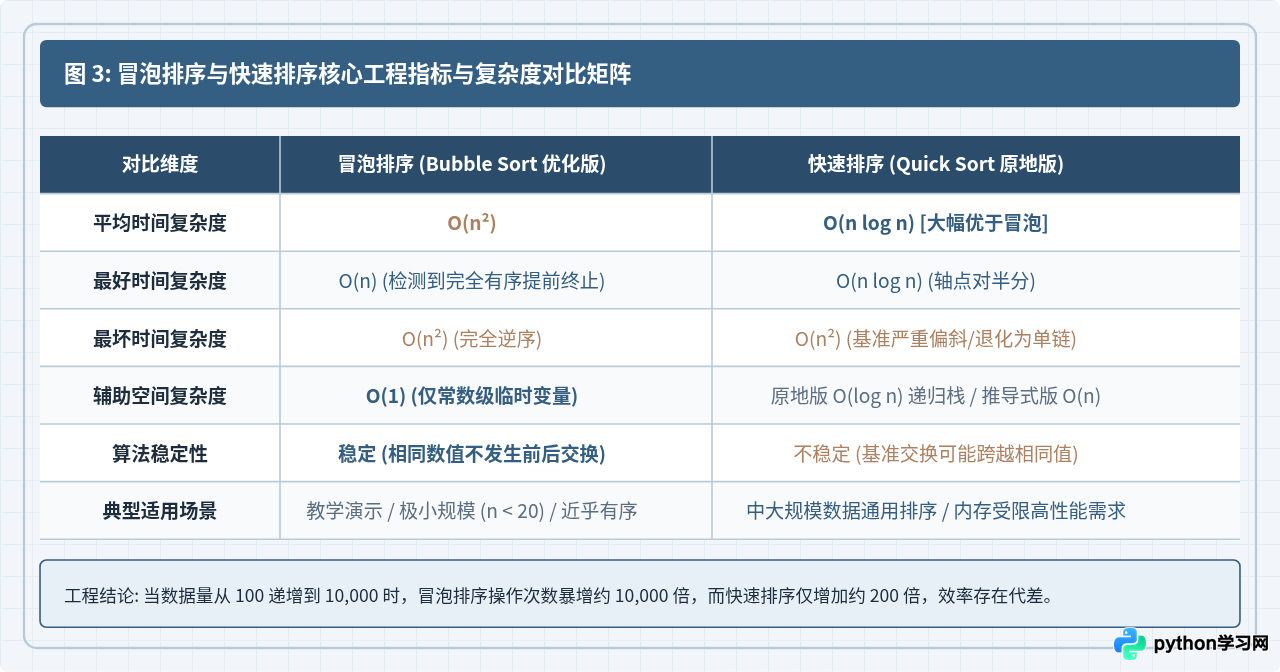
| 特性指标 | 冒泡排序 (Bubble Sort) | 快速排序 (Quick Sort) | 工程意义与实践解释 |
|---|---|---|---|
| 平均时间复杂度 | O(n²) | O(n log n) | 数据量达到 10 万级时,快排几毫秒完成,冒泡可能耗时数分钟。 |
| 空间复杂度 | O(1) 原地常数 | O(log n) 原地递归栈 | 原地快排仅需保存函数调用上下文,空间成本完全可接受。 |
| 算法稳定性 | 稳定 (Stable) | 不稳定 (Unstable) | 若键值相同的两个对象必须保持原有相对前后次序,快排可能打乱次序。 |
| 实现代码量 | 极短,逻辑直观 | 中等,涉及递归与指针控制 | 冒泡适合教学排查,快排适合通用算法底座。 |
四、实际应用中的选型指南与决策流程
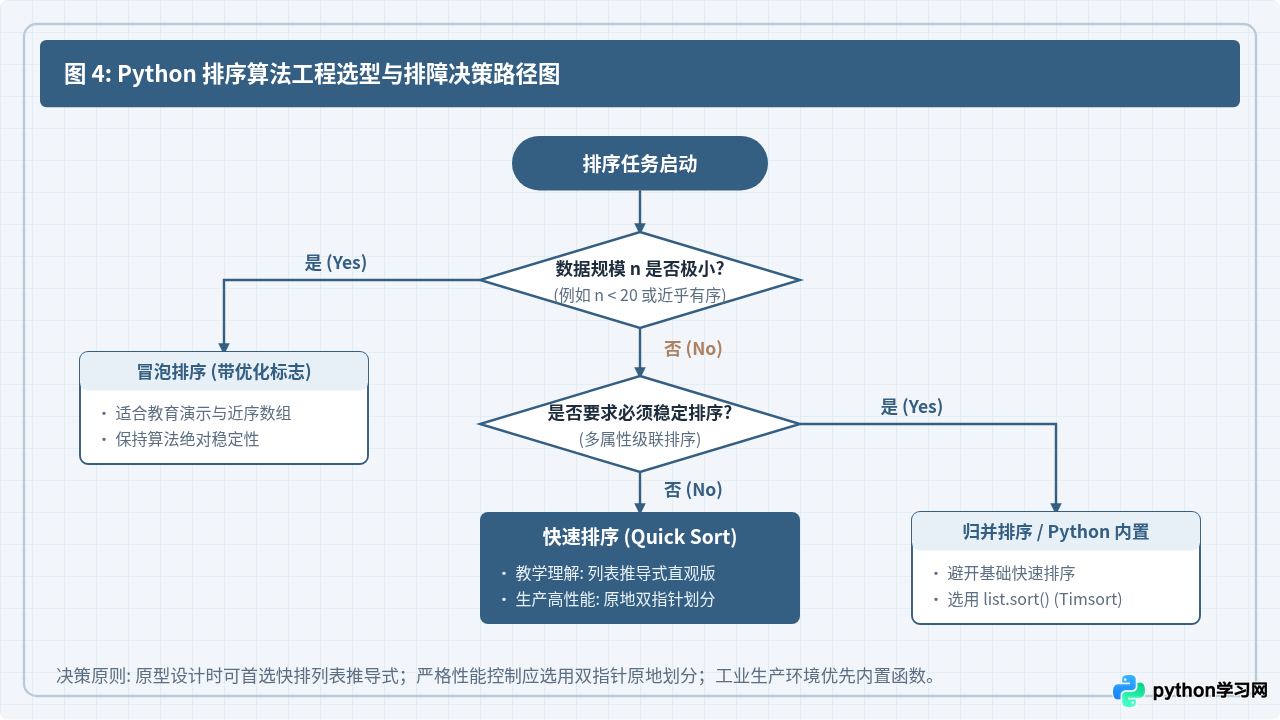
在实际项目与面试场景中,究竟该在何时采用冒泡排序,何时采用快速排序?可以根据数据量大小、初始有序度以及内存与稳定性约束进行技术选型:
-
选择冒泡排序的场景:
仅适用于教学演示、编写极简的自测逻辑,或者明确得知输入数组规模极小(如
n < 20)且大部分数据已经基本有序、同时强制要求算法稳定性的情景。 - 选择快速排序的场景: 当面临无序的中大规模数据(如数值序列、文件偏移量处理、高频数据检索预处理)且需要极高运行速度时,快速排序是优先算法。
-
生产环境首选内置函数:
必须指出,在 Python 商业级生产业务中,首选方案永远是 Python 内置的
list.sort()或sorted()。Python 内置排序基于 Timsort 算法(结合了归并排序与插入排序的高性能混合算法),用 C 语言底层实现,具备O(n log n)的最坏时间保证以及完全的稳定性,并针对真实世界中局部有序的数据进行了深度优化。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









