

Python len()配合range()进行序列索引遍历的写法
深入讲解 Python 中 len() 配合 range() 进行序列索引遍历的标准写法、底层运作机制、典型业务场景与边界避坑指南。
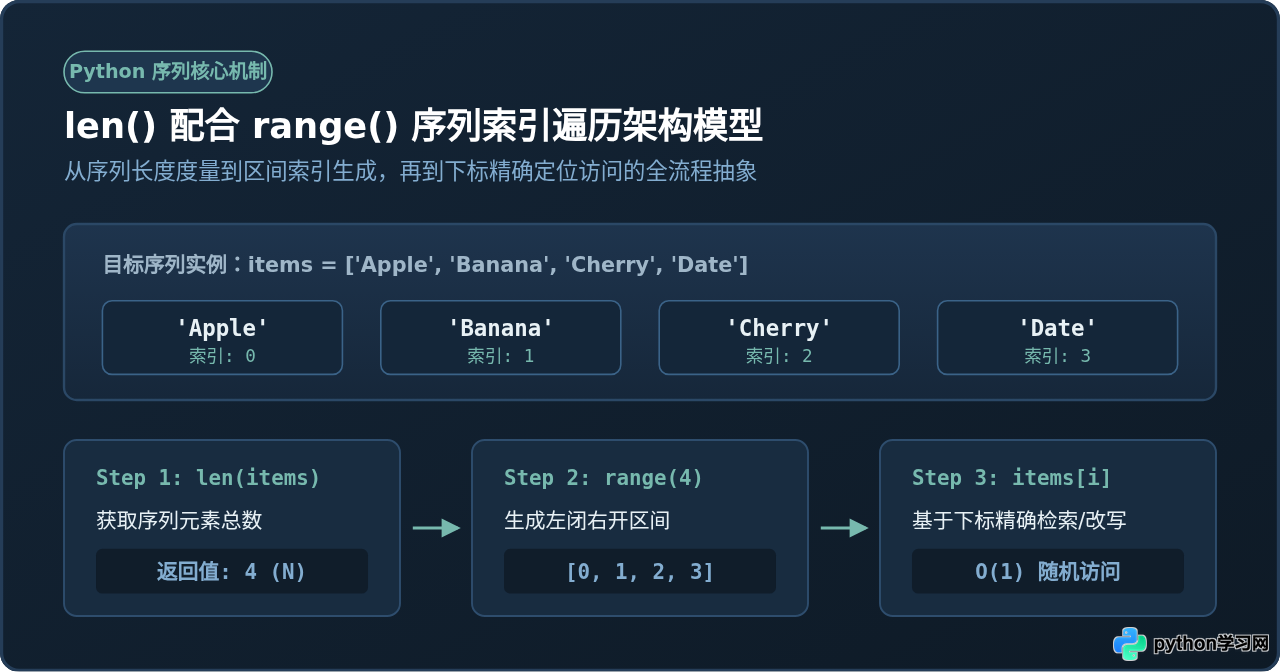
for i in range(len(sequence)): 配合下标 sequence[i] 是完成序列索引遍历的经典写法。其解决路径是通过内置函数 len() 确定序列元素总数 $N$,再利用 range(N) 生成自 $0$ 至 $N-1$ 的整数索引序列,使循环体能够直接依托具体下标进行位置读取、相邻元素差值比对或列表元素的原地修改。
一、核心写法与执行机制推导
假定我们需要对一个存储服务器节点名称的列表进行逐项处理,并打印出每个节点在集群中的物理排位编号。标准的基础代码形态如下:
# 示例:基础索引遍历定义与执行
nodes = ["master-01", "worker-01", "worker-02", "worker-03"]

for i in range(len(nodes)):
print(f"索引 [{i}] 对应节点名称: {nodes[i]}")索引 [0] 对应节点名称: master-01
索引 [1] 对应节点名称: worker-01
索引 [2] 对应节点名称: worker-02
索引 [3] 对应节点名称: worker-03
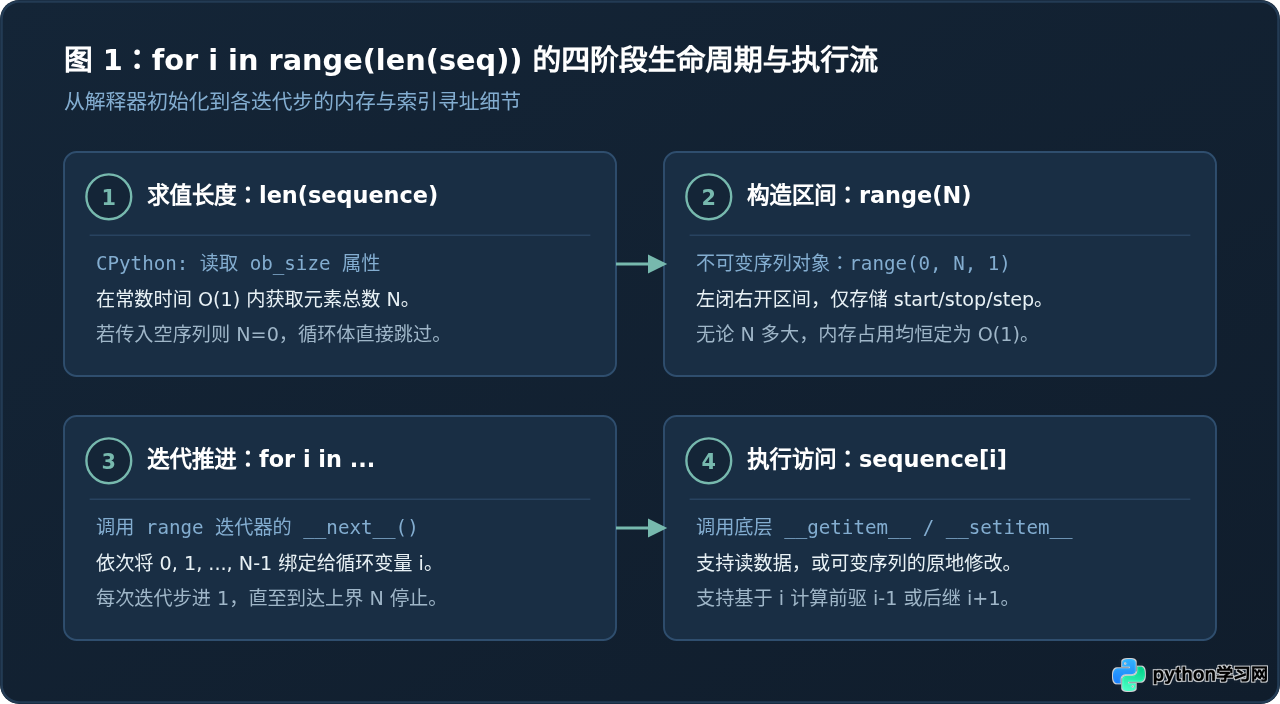
为了准确掌握这一写法的运作全貌,可以将解释器的执行过程拆解为三个紧密关联的环节:
- 长度测算(len 阶段):在 CPython 实现中,列表、元组或字符串均属于变长对象(PyVarObject)。调用
len(nodes)时无需从头到尾逐个扫描元素,而是直接从对象头部读取结构体成员ob_size,时间复杂度为严格的 $O(1)$。在此处,列表包含 4 个元素,因而求值结果为整数4。 - 区间构造(range 阶段):单参数调用
range(4)等价于range(0, 4, 1)。在 Python 3 中,range是一个不可变序列类型,而非一次性生成包含所有数值的庞大列表。它内部仅存储start=0、stop=4、step=1三个属性,内存占用保持恒定 $O(1)$,并按照左闭右开区间 $[0, 4)$ 依次产出整数0, 1, 2, 3。 - 循环推进与下标寻址(for 与 [] 阶段):
for循环驱动range迭代器逐次将下标赋给局部变量i。随后在循环体内,表达式nodes[i]触发__getitem__协议,在连续内存阵列中通过基地址加偏移量直接定位目标指针,同样在 $O(1)$ 复杂度内完成取值。
二、典型适用业务场景与实操示例
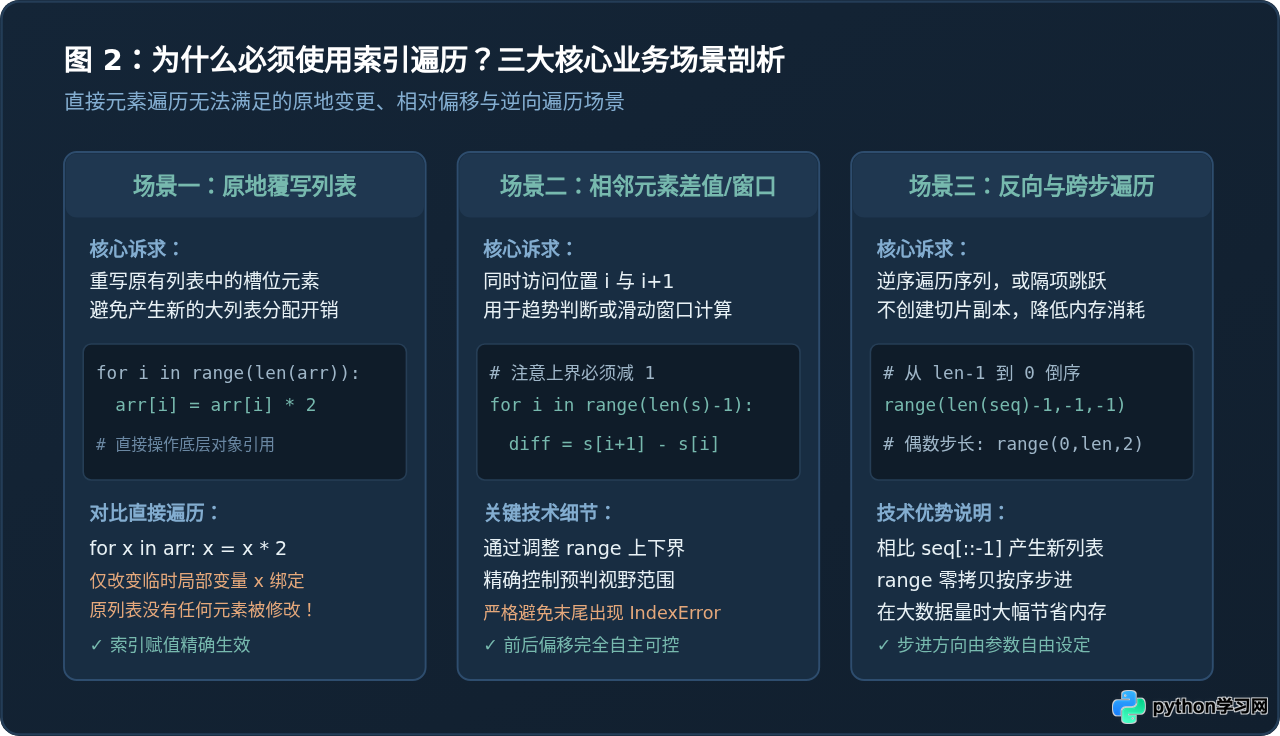
许多初学者在熟悉了可以直接获取元素的 for item in sequence: 语法后,往往疑惑何时才必须退回使用看似更冗长的 range(len()) 语法。在实际工程中,以下三类场景必须或优先依托显式下标:
1. 原地修改可变列表中的元素
如果使用直接元素迭代并在循环内对变量赋值,修改的仅仅是临时循环变量的内存指向,原列表本身纹丝不动。若要原地重写原列表元素(如进行数值归一化处理),必须依靠下标进行槽位覆写:
# 示例:原地将所有端口数值加倍
ports = [8080, 8081, 8082, 8083]

for i in range(len(ports)):
    ports[i] = ports[i] * 2  # 通过索引精准修改原列表对象内存槽位

print("修改后列表:", ports)修改后列表: [16160, 16162, 16164, 16166]
2. 相邻元素滑动比较与前瞻检查
在时间序列分析或有序性校验场景中,往往需要同时获取当前项 sequence[i] 与下一项 sequence[i + 1]。此时,只需将 range 的停止边界收缩为 len(sequence) - 1,即可安全实现前向探测:
# 示例:检查监控指标采样值是否严格递增
metrics = [12, 18, 25, 24, 30]
is_increasing = True

for i in range(len(metrics) - 1):
    if metrics[i] > metrics[i + 1]:
        print(f"在索引 {i} 处检测到指标下滑: {metrics[i]} -> {metrics[i+1]}")
        is_increasing = False
break在索引 2 处检测到指标下滑: 25 -> 24
3. 自定义步长跨跃与逆向倒序遍历
利用 range(start, stop, step) 提供的三参数重载,可以非常高效地控制遍历方向与步长,避免使用切片 sequence[::-1] 生成多余的内存拷贝:
# 示例:从末尾向开头倒序遍历
commands = ["INIT", "AUTH", "CONNECT", "SYNC"]

for i in range(len(commands) - 1, -1, -1):
print(f"逆序执行清理步骤 [{i}]: {commands[i]}")逆序执行清理步骤 [3]: SYNC
逆序执行清理步骤 [2]: CONNECT
逆序执行清理步骤 [1]: AUTH
逆序执行清理步骤 [0]: INIT
三、常见边界错误与排错指南
尽管 len() 与 range() 的配合直接明了,但在实际编写时,受自然语言计数习惯影响,开发者极易陷入以下两个典型陷阱:
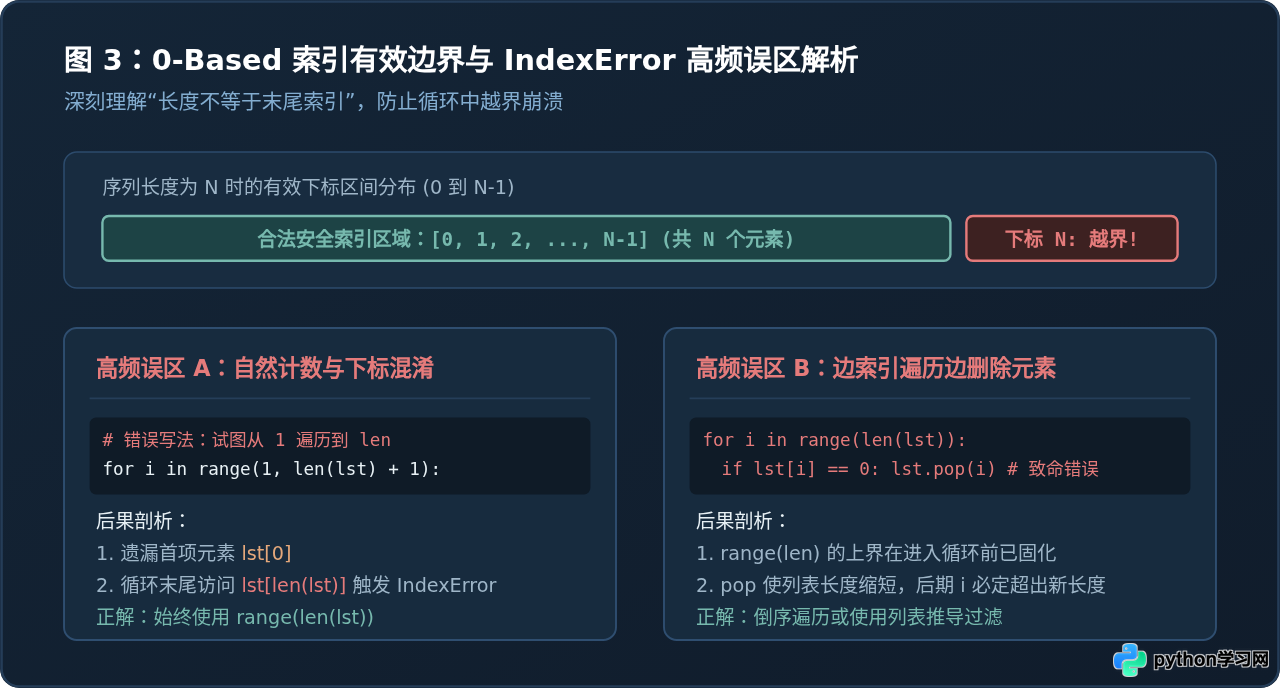
Python 序列严格采用 0 起始计数(0-Based)。长度为 $N$ 的序列,其合法正向索引范围为 $0$ 到 $N-1$。如果误将长度数值本身用当下标去检索,必将抛出 IndexError: list index out of range。
1. 误将自然计数区间套入 range
有些开发者容易下意识地写出 range(1, len(lst) + 1)。这段代码产出的索引区间为 $[1, N]$:循环从 $1$ 开始,导致首个元素 lst[0] 被无视;当循环走到最后一轮 $i = N$ 时,执行 lst[N] 立即触发越界崩溃。牢记正向遍历全量元素的唯一安全写法就是 range(len(lst))。
2. 在索引循环过程中动态增删列表元素
另一个致命陷阱是在基于索引遍历时,在循环体内直接调用 pop(i) 或 del lst[i]。因为 range(len(lst)) 的上界在进入循环前已由求值结果固定。一旦在迭代中删除了元素,列表的实际长度变短,后续轮次递增出来的索引便会超过此时的实际有效长度,直接引发越界异常,甚至造成跳过相邻元素的严重业务逻辑缺陷。
四、工程选型:何时使用 range(len) 与替代方案
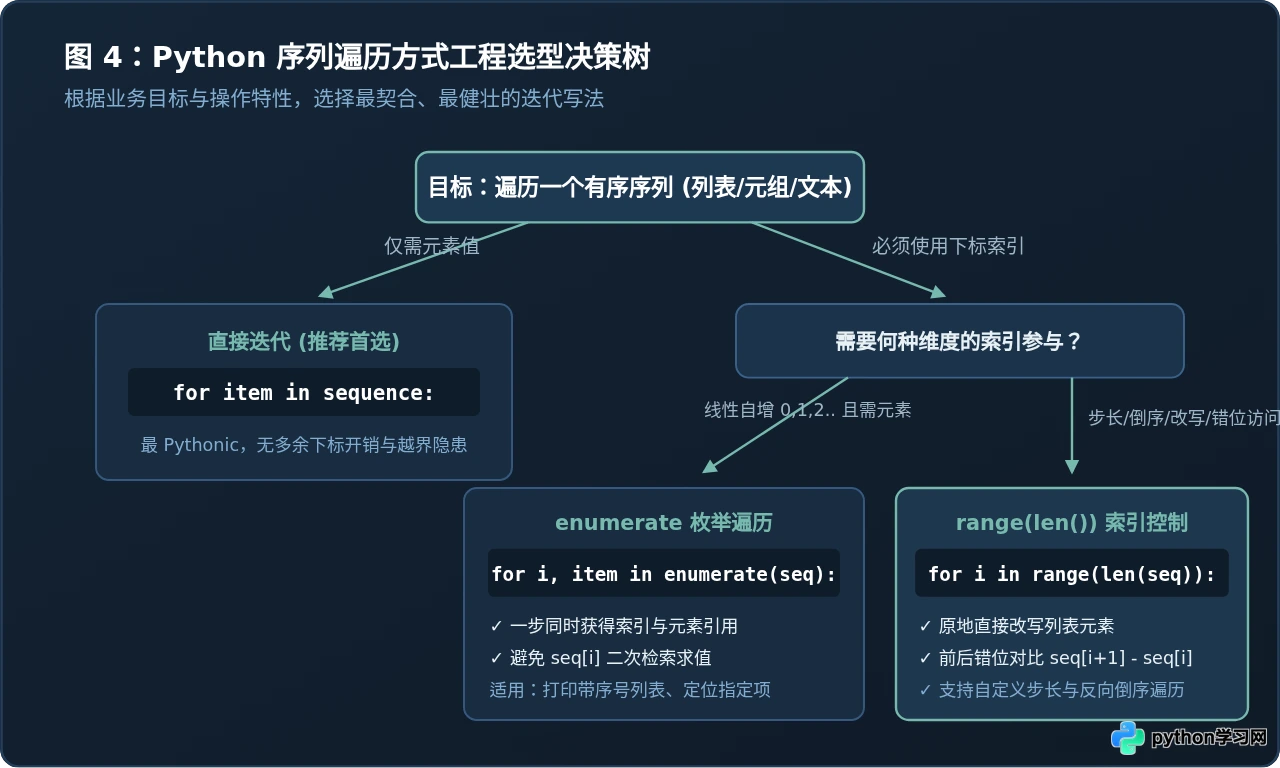
在日常开发实践中,应根据具体的处理目标权衡采用哪种遍历模式:
- 仅需读取元素内容:直接使用
for item in sequence:。代码语义最为纯粹清晰,执行路径省去了下标哈希寻址与校验开销。 - 同时需要递增序号与元素值:优先使用
for i, item in enumerate(sequence):。enumerate内置迭代器在单次推进中同时产出索引序号与元素对象的元组,代码可读性远优于sequence[i]。 - 需要原地覆写原列表、非线性跨步、逆序回溯或滑动窗口计算:坚持选用
for i in range(len(sequence)):配合下标。这是此类需求在 Python 中最直接、边界控制能力最强的方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









