

Python代码检测警告太多怎么办?自定义忽略规则详解
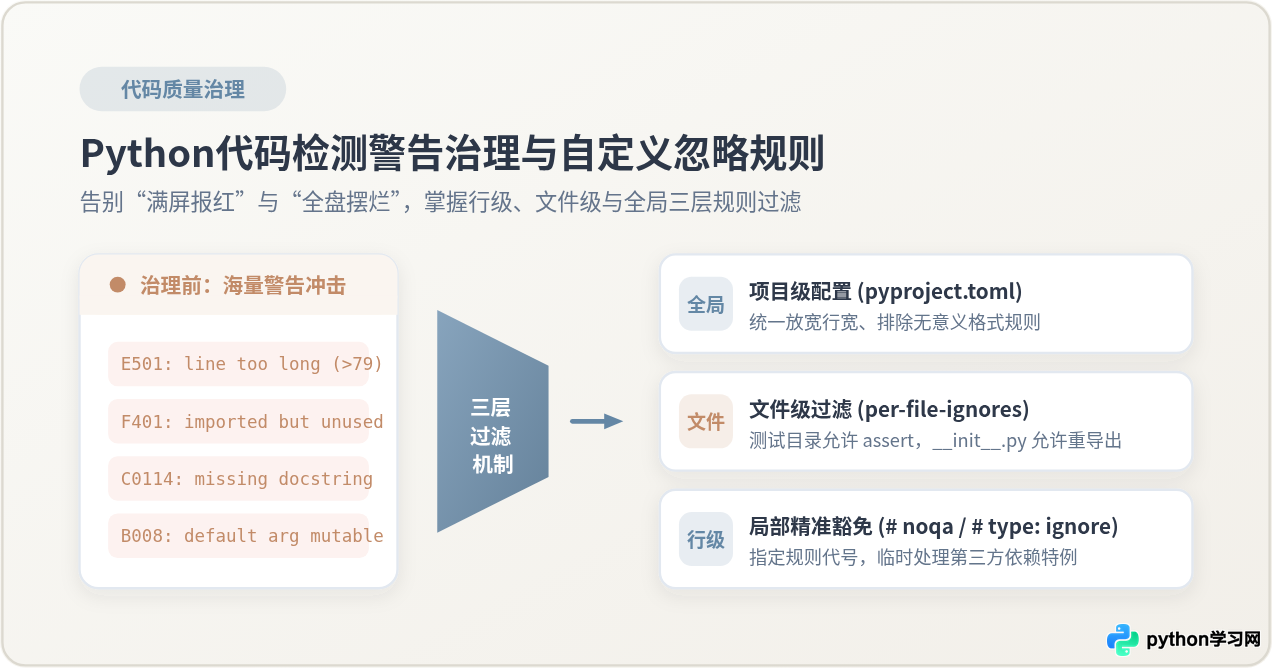
面对Python代码静态检查工具报告的成百上千条警告,详解如何通过单行局部豁免、文件目录过滤与全局策略配置三层机制进行科学降噪,兼顾代码质量与开发效率。
在 Python 项目中引入代码静态检查工具(如 Ruff、Flake8、Pylint 或 Mypy)时,初次执行扫描往往会遭遇数百乃至上千条警告。全盘关闭检测会让项目丧失质量与安全底线,而强行逐条机械修改又会打乱正常的开发节奏。解决这一困境的核心方法,是建立“分层过滤机制”:准确区分无害的风格差异、特殊目录的合理特例与真实潜在缺陷,通过单行局部精准豁免、文件与目录级规则映射,以及全局项目策略配置三个层级,对检查规则进行针对性过滤。本文将详细讲解这一分层治理体系与实操配置。
一、理解告警成因与三层过滤机制
面对终端或编辑器中密密麻麻的告警信息,首先需要认清告警的性质。通常,代码检测工具抛出的警告集中在三类维度:
- 风格偏好与格式规范:例如单行长度超过限制(E501)、空行数量不符(E302/E303)、模块导入未按字母排序(I001)。这类警告通常不影响程序运行,但受制于团队约定或显示设备差异。
- 上下文相关的语法特例:例如测试用例中频繁使用的
assert语句、__init__.py中用于对外暴露公共接口的“已导入但未使用”变量(F401),以及自动生成的数据库迁移脚本。这些特例在通用规则下是警告,但在特定场景下属于合规用法。 - 潜在逻辑缺陷与类型异常:例如默认参数使用可变对象(B006/B008)、未捕获的宽泛异常(W0703/BLE001)、变量在使用前可能未定义(F821)以及参数类型不匹配。这类警告代表真实的潜在缺陷,绝不能轻易忽略。
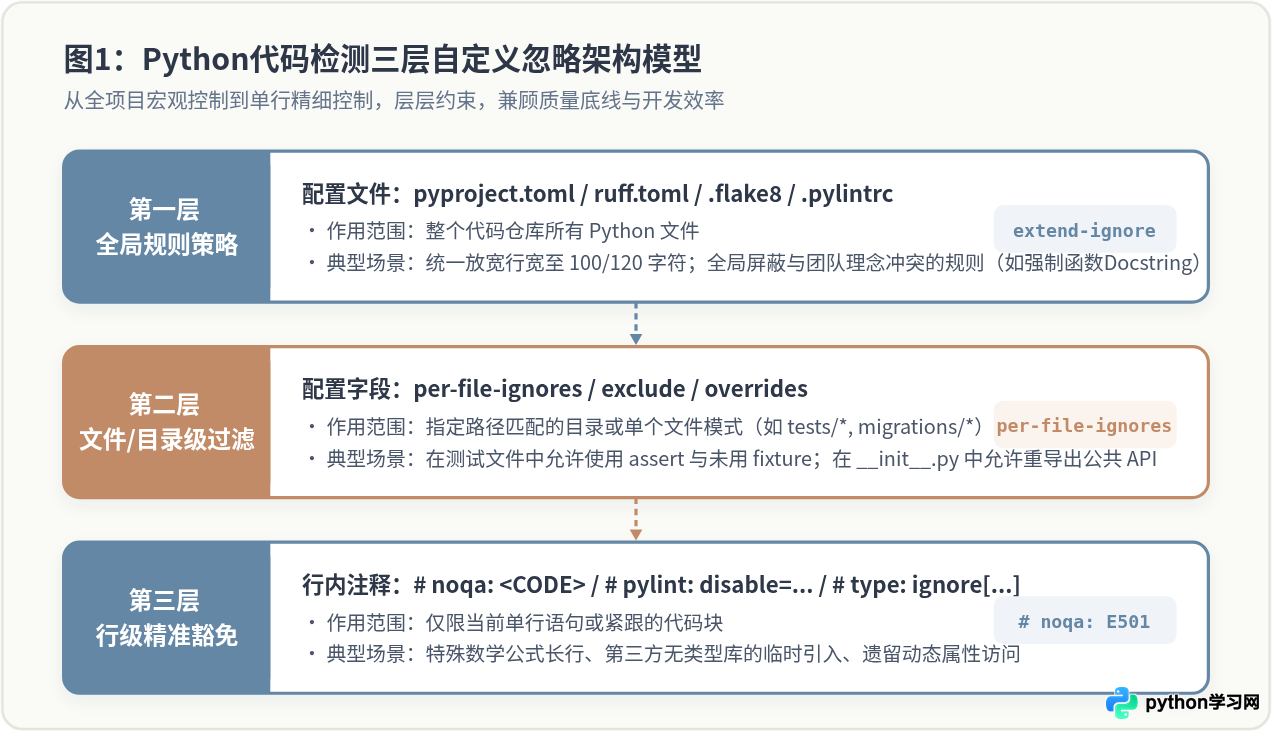
基于上述分类,工业级工程实践形成了清晰的“三层过滤机制”。针对不同范围和性质的规则冲突,应在对应的层级实施自定义忽略,而不是在单个配置文件里粗暴地关闭整套规则库。
二、第一层:行级局部精准豁免(行内注释语法)
当代码中的某一行语句因为不可避免的客观原因触发了告警,且该原因仅存在于局部时,应当使用行级注释进行精确豁免。行级注释能够将豁免范围严格限定在单行内,既解决了局部特殊需求,又不会影响同文件中其他代码的检查强度。
1. Flake8 与 Ruff 中的 # noqa 规范用法
在 Flake8 以及现代极速静态检查器 Ruff 中,行内忽略采用 # noqa 语法。切忌使用没有任何代号参数的裸 # noqa,因为裸注释会吞噬该行抛出的所有类型警告(包括潜在的致命语法错误),必须显式指明规则代号。
# 示例 1:由于超长外部 API 地址或不可折行正则表达式导致的行宽超限,显式指定 E501
REMOTE_ENDPOINT_URL = "https://internal-service.cluster.local/api/v2/telemetry/metrics/stream"  # noqa: E501

# 示例 2:同一行同时豁免多条规则,规则代号以逗号分隔
from legacy_module import Client, Config  # noqa: F401, E402

# 示例 3:良好的工程习惯应当紧跟注释说明豁免的具体原因
DEFAULT_TIMEOUT = 120  # noqa: PLR2004  # 契约协议规定的硬编码超时常量
2. Pylint 的 # pylint: disable=... 语法
Pylint 具备更深入的代码逻辑分析能力,其行内忽略语法为 # pylint: disable=规则名称或代号。Pylint 既支持单行末尾标记,也支持按代码块作用域开启与恢复。
def process_task(task_id: str, context: dict) -> None:
    # 局部针对未使用的形参进行忽略,避免重写接口签名
    # pylint: disable=unused-argument
    print(f"Executing task: {task_id}")

# 针对整个紧凑代码块禁用特定规则并在之后重新启用
# pylint: disable=too-many-locals
def complex_matrix_calculation(matrix_a, matrix_b):
    temp_x = 1
    temp_y = 2
    # 大量局部计算逻辑...
    return temp_x + temp_y
# pylint: enable=too-many-locals
3. Mypy 静态类型检查的行内豁免
对于类型检测工具 Mypy,当引入了缺少类型存根(Type Stubs)的第三方旧库,或者执行动态元编程时,可以使用 # type: ignore[规则代号]。
# 精确指定 import-untyped,只忽略无存根库的导入,不掩盖本文件的其他类型错误
import third_party_untyped_lib  # type: ignore[import-untyped]

# 忽略特定属性可能不存在的联合类型报错
result = response.data.custom_field # type: ignore[union-attr]# noqa 或 # type: ignore,应当要求提交者补充具体的规则编号与说明,防止掩盖真实的隐患。
三、第二层:文件与目录级批量规则定制(Per-File Ignores)
在实际项目中,许多告警具有强烈的“目录特征”。例如:
- 测试目录(
tests/):在编写单元测试用例时,assert是最核心的断言机制(常被安全检查规则如 S101 报警);同时测试夹具(Pytest Fixtures)作为参数传入却未显式调用,常触发参数未使用告警。 - 包初始化入口(
__init__.py):通常用于将子模块的关键类或函数导出为公共 API,其导入的符号本身不在__init__.py内部执行,因此必然触发 F401(导入但未使用)。 - 脚手架与迁移脚本(如 Alembic
migrations/):由工具自动生成的代码通常遵循固定模板,不适合用常规代码风格进行严苛约束。
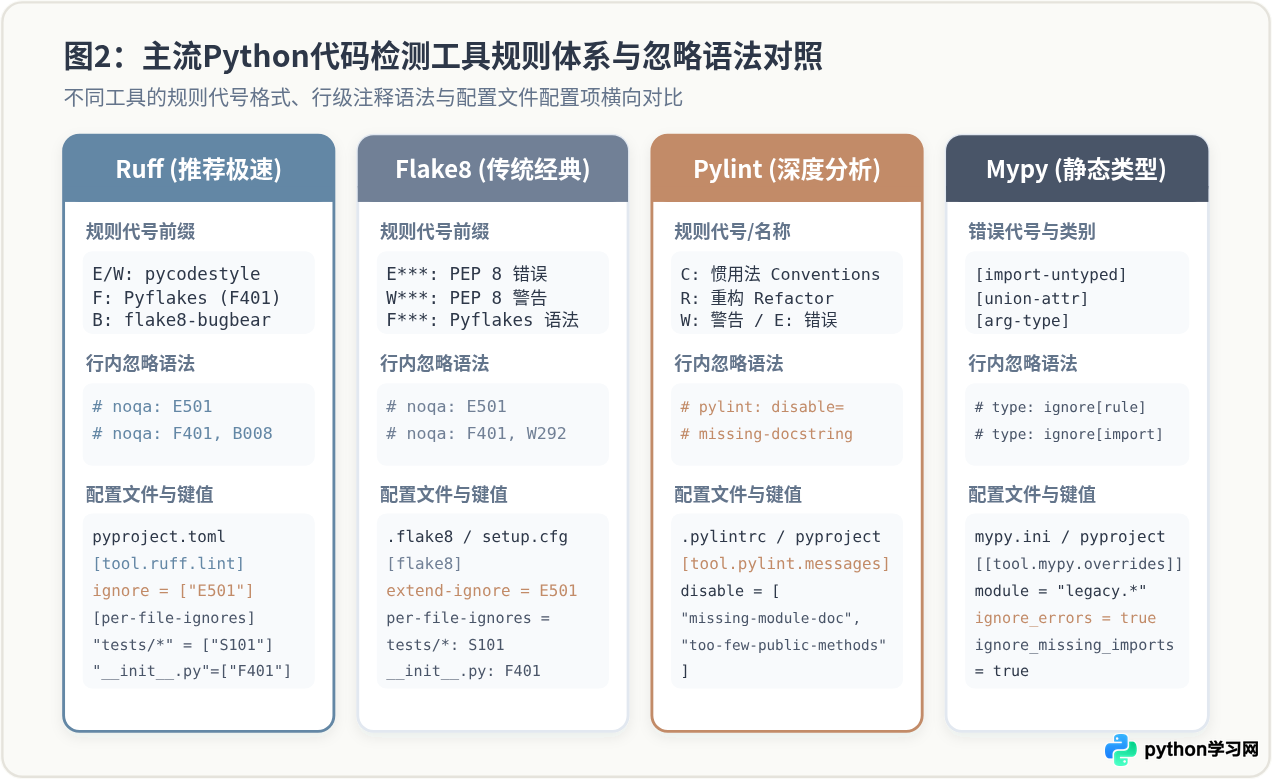
若在这些场景中逐行添加 # noqa,会导致代码被大量注解污染。正确的做法是在项目配置文件中定义路径匹配映射。
1. Ruff 中的 per-file-ignores 配置
在现代 Python 项目根目录的 pyproject.toml 中,可以直接在 [tool.ruff.lint.per-file-ignores] 下声明匹配路径与忽略规则列表:
[tool.ruff.lint.per-file-ignores]
# 允许所有 __init__.py 导入未使用的模块(用于API聚合暴露)
"__init__.py" = ["F401"]

# 针对测试用例目录放宽规则:允许断言(S101)、允许魔法数值(PLR2004)、允许夹具参数未使用(ARG001)
"tests/**/*" = ["S101", "PLR2004", "ARG001"]

# 针对自动生成的数据库迁移脚本放宽单行超长与无意义命名
"migrations/*" = ["E501", "N806"]
2. Flake8 中的 per-file-ignores 配置
如果项目使用的是经典 Flake8 工具链,可以在 .flake8 或 setup.cfg 文件的 [flake8] 小节中配置:
[flake8]
max-line-length = 100
# 针对特定路径规则匹配,每行一条映射,路径支持通配符
per-file-ignores =
    # 模块入口允许未引用的导入
    __init__.py: F401
    # 测试目录允许断言与未使用的测试参数
    tests/*: S101, F841
    # 文档示例目录允许全局导入顺序不合规
    docs/*: E402
四、第三层:项目全局策略配置(统一项目基准)
当某些规则与整个团队的技术选型、项目特点存在根本性冲突,或者规则本身收益微弱且带来显著阻碍时,应在全项目层级统一定义忽略规则。
1. 使用 pyproject.toml 统一管理现代规则库
以 Ruff 为例,现代 Python 工程通常只维护一份 pyproject.toml 文件,避免在代码仓库中分散散落多个配置。以下是一份具备生产级工业可用性的检测配置范本:
[tool.ruff]
# 设定团队约定的代码行宽限制(现代开发通常推荐 100 或 120,替代古老的 79)
line-length = 100
target-version = "py310"

# 全局排除无需检测的辅助目录
exclude = [
    ".git",
    ".venv",
    "build",
    "dist",
    "migrations",
]

[tool.ruff.lint]
# 显式挑选启用的核心规则集
# E/W: PEP 8 错误与警告
# F: Pyflakes 语法缺陷
# B: Flake8-Bugbear 常见隐藏缺陷
# I: isort 导入排序规范
# UP: pyupgrade 现代语法升级提示
select = ["E", "W", "F", "B", "I", "UP"]

# 全局忽略的项目级规则
# 提示:切勿在此处写入单个字母(如 ignore = ["E"]),必须提供完整编号
ignore = [
    "E501",  # 行宽超限交给格式化工具(如 ruff format 或 black)统一排版,无需静态检测二次报错
    "B008",  # 允许在函数形参中使用依赖注入构造调用(FastAPI 的 Depends、Typer 必备用法)
]
2. 关键概念辨析:ignore 与 extend-ignore 的陷阱
在配置 Flake8 或旧版工具时,最常见的致命失误就是混淆了 ignore 与 extend-ignore:
ignore(覆盖式):会完全替换掉工具出厂自带的默认忽略列表。如果你只写了ignore = E501,工具原本默认忽略的杂项警告(如与 PEP 8 自动换行相关的 W503、W504)将被意外激活,导致告警数量不降反升。extend-ignore(增量式,推荐):在保留工具官方内置安全过滤的基础上,仅追加当前项目需要豁免的规则。因此在编写.flake8配置文件时,应始终优先使用extend-ignore。
| 配置字段 | 作用机制 | 推荐使用场景 | 潜在风险 |
|---|---|---|---|
select |
白名单机制:仅启用显式声明的规则族 | 项目初建或推行渐进式质量标准时精确收敛范围 | 未选中的安全缺陷规则将完全不执行 |
extend-ignore |
增量黑名单:在默认规则基础上追加豁免 | 日常微调,排除少数与技术栈冲突的风格规则 | 配置条目清晰,风险极低 |
ignore |
全量覆盖:覆盖内置默认忽略清单 | 仅在需要完全重定义工具底层策略的特殊场景 | 极易意外激活大量底层冲突警告 |
五、从海量警告到清爽报告的四步实战流程
面对已有数万行代码但从未推行过静态检查的历史项目,直接开启检查会瞬间喷出上千条警告。不能盲目地挨个文件修改,必须有一套有章可循的降噪推进决策流程。
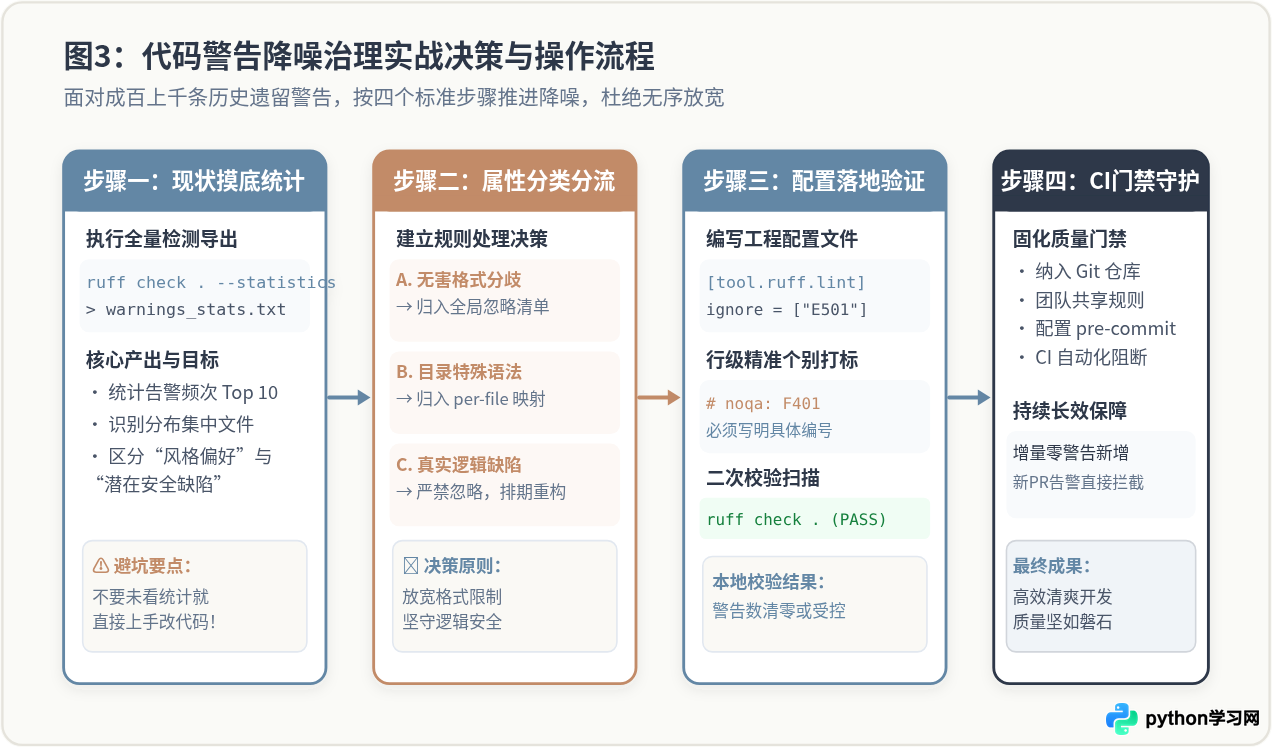
步骤一:全量扫描与频次聚合统计
治理的第一步不是改代码,而是摸清告警的“分布规律”。通过统计命令,快速输出告警排行榜:
终端诊断命令# 使用 Ruff 统计警告分布频次排名(示例)
$ ruff check . --statistics
# 示例输出:
# 342 E501 line-too-long
# 128 F401 unused-import
# 86 B008 function-call-in-default-argument
# 45 S101 assert-used
# 6 F821 undefined-name
# -----------------------------------------------
# 扫描总计发现 607 条告警步骤二:按属性决策分类分流
观察统计结果,通常会发现 80% 以上的告警集中在前两三类规则中。对高频规则逐一进行价值判断:
- 高频项 E501(行宽):项目是否已引入代码格式化工具?如果是,可直接在
pyproject.toml的ignore中加入"E501",将排版职责全权交由格式化器管理,告警数量瞬间减少 342 条。 - 高频项 B008(默认实参调用):检查项目是否基于 FastAPI、Typer 构建。如果是,属于框架正规模式,直接归入项目全局忽略。
- 高频项 S101(assert):检查告警集中在哪些路径。发现 95% 出现在
tests/目录,立即配置per-file-ignores = { "tests/*" = ["S101"] }。 - 严重告警 F821(未定义名称):仅有 6 条,但代表真实存在的变量名拼写错误或逻辑破绽。此类告警坚决不予忽略,记录在清单中分配给对应负责人修复。
步骤三:写入配置并重新扫描验证
将梳理出的规则写入 pyproject.toml,并在本地重新执行检测。此时告警数量应从数百条迅速回落至极少数可直接修复的条目:
# 再次运行校验
$ ruff check .

# 此时仅剩下个别真实缺陷与零星特殊行
# 按需在特殊行添加规范的 # noqa 注释,修复 6 处逻辑缺陷后:
$ ruff check .
All checks passed!
步骤四:固化为持续集成(CI)门禁,杜绝反弹
本地通过并不代表治理完成。必须将检测命令加入团队的 pre-commit 钩子和 CI/CD 流水线(如 GitHub Actions、GitLab CI)。一旦有新代码提交产生未授权的告警,流水线立即中断并告警,确保团队代码库始终维持“零警告新增”的健康状态。
六、常见踩坑点与工程维护规范
自定义忽略规则是一把双刃剑:合理的规则配置能过滤噪音,而不加节制的放宽则会彻底摧毁静态检测的防护价值。在实际工程落地中,务必对照以下要点自查。
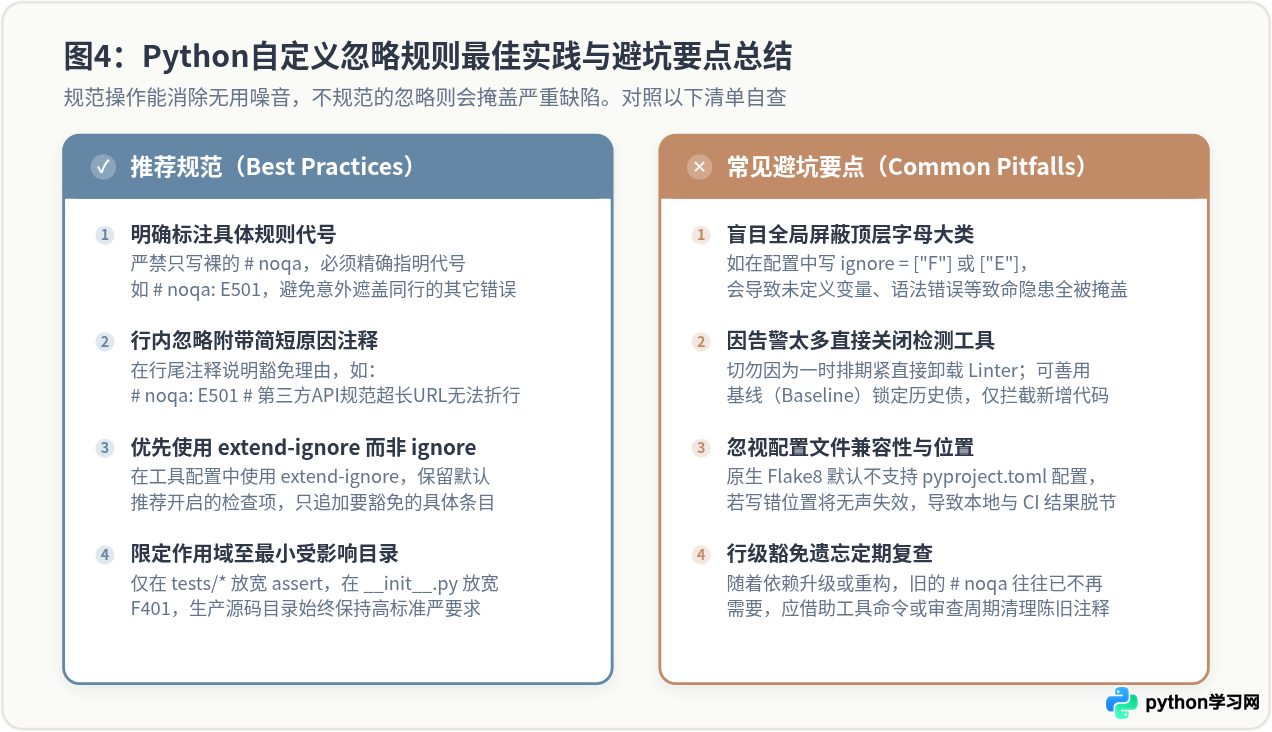
1. 绝不使用粗粒度的字母大类通配
某些开发者为了图省事,在配置文件中直接填写 ignore = ["E", "F"]。这样做极其危险:
E类下既包含无关紧要的空格缩进,也包含语法层面的语法不一致;F类(Pyflakes)几乎全部是与程序正确性直接相关的致命问题,如F821(变量未定义运行必挂)、F811(函数名重复定义导致覆盖)。一旦将"F"全局屏蔽,Linter 就形同虚设。
2. 避免配置文件放置位置或格式冲突
不同工具支持的配置文件格式存在差异:
- Ruff 与 Black:原生深度支持
pyproject.toml,所有配置统一放置于此。 - 原生 Flake8:截至官方最新标准版本,默认只读取
.flake8、setup.cfg或tox.ini,原生不支持在pyproject.toml中读取配置(除非额外安装第三方插件flake8-pyproject)。直接将[tool.flake8]写入pyproject.toml会导致配置在无任何提示的情况下彻底失效。 - 路径匹配基准:在配置
per-file-ignores时,指定的 glob 模式通常相对于配置文件所在的根目录,编写路径时不要加入无意义的绝对路径。
3. 历史包袱过重时的“基线(Baseline)”过渡策略
如果代码仓库规模达到数十万行,连修复核心告警都需要跨部门数周时间,切勿因噎废食而关闭检测。此时可采用基线(Baseline)机制:
将当前已有的全部历史警告导出一份基准文件(例如使用 ruff check . --output-format json > baseline.json,或使用对应工具的 --baseline 参数)。CI 检测仅比对增量差异:允许历史存量警告继续存在,但任何新提交的代码只要产生新的警告,立即予以阻断。随后利用常规迭代周期逐步消化历史清单。
4. 建立定期复审与过时忽略清理机制
随着 Python 版本升级(如 3.8 升级至 3.12)或底层依赖库完善了类型存根,以往添加的许多 # noqa 或 # type: ignore 往往已经失效或不再必要。过多的废弃注释反过来又会造成代码污染。
可以使用自动化命令定期排查冗余注释。例如在 Ruff 中执行 ruff check . --fix 或通过专门规则扫描无效注释,及时剔除过时的豁免标记,保持代码库的清爽整洁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









