

怎么写出 Pythonic 代码:Python 3 编码规范与常见误区避坑

写出符合“Pythonic”风格的代码,本质上是在尊重 Python 语言哲学(The Zen of Python)的前提下,充分运用其内置的数据结构和现代语言特性,写出直观、清晰、紧凑且易于维护的代码。要实现这一目标,需要建立对 PEP 8 编码规范的直觉认知、掌握迭代器与上下文管理器等核心惯用法,并系统性避开诸如可变默认参数、类型硬编码检查以及隐蔽异常吞没等典型陷阱。本文围绕 Python 3 的真实开发场景,从核心心智模型、规范落地细节、语法重构实践与高频避坑清单四个维度展开全面讲解。
一、理解 Pythonic 的核心心智模型
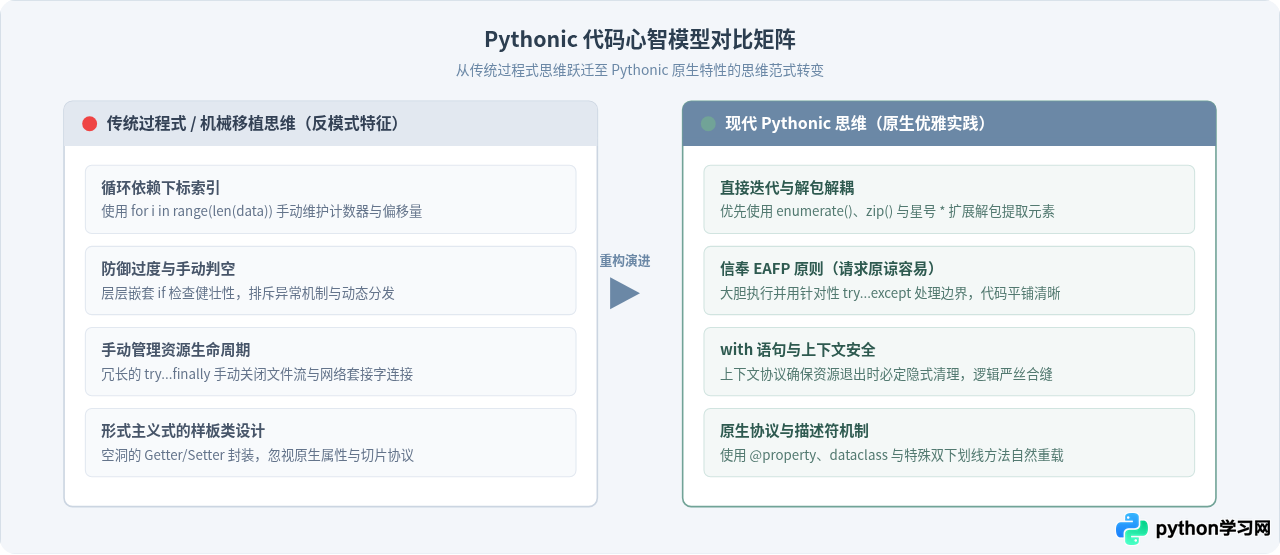
许多初学 Python 或从 C++、Java 转来的开发者,往往会下意识地把原有语言的习惯生搬硬套到 Python 中。例如使用索引下标进行双重循环、大量编写冗长的 getter/setter 方法、过度使用类继承等。这种代码虽然能够正常运行,但丧失了 Python 的表达优势,属于典型的“以 Python 语法写 C 语言”。
真正 Pythonic 的代码遵循《Python 之禅》(可在交互式解释器中输入 import this 查看)所倡导的几大核心原则:
- 优美胜于丑陋,明了胜于晦涩(Explicit is better than implicit):优先通过清晰明确的变量命名和原生语义表达逻辑,减少不必要的黑魔法或过度缩减的单行恶趣味。
- 简洁胜于复合,复合胜于复杂(Simple is better than complex):以最直接的方式解决问题,不为了设计模式而过度抽象。
- 扁平胜于嵌套,稀疏胜于密集(Flat is better than nested):通过提早返回(Early Return)和生成器扁平化代码分支。
- 可读性至关重要(Readability counts):代码被阅读的频率远高于编写的频率,代码排版与语义流动应顺畅自然。
二、Python 3 核心编码规范(PEP 8 落地精要)
PEP 8 是官方制定的 Python 代码风格指南。它不是教条式的限制,而是社区历经数十年沉淀出的通用语言。遵循 PEP 8 能让团队成员在阅读彼此代码时减少不必要的视觉与心理阻力。
1. 命名规范:清晰表达意图
- 模块与包名:采用简短全小写字母,若能提升可读性可使用下划线,如
user_service.py、math_utils。 - 类名:采用帕斯卡命名法(PascalCase),例如
OrderProcessor、HttpRequestHandler。 - 函数与变量名:采用小写字母并以下划线分隔(snake_case),例如
calculate_tax()、retry_count。 - 常量:采用全大写字母加下划线,例如
MAX_BUFFER_SIZE、DEFAULT_TIMEOUT。 - 受保护成员与私有成员:单下划线前缀
_helper_func表示内部受保护属性;双下划线__mangled_var触发名称修饰(Name Mangling),仅在避免子类命名冲突时使用,不要随意用于普通私有封装。
2. 排版、缩进与空白节奏
- 严格使用 4 个空格缩进:严禁混用 Tab 和空格(Python 3 默认禁止并抛出
TabError)。 - 合理限制行宽:PEP 8 建议常规代码不超过 79 字符,现代宽屏显示器实践中多放宽至 88(Black 默认)或 100 字符,但绝不能任由代码单行突破屏幕横向滚动条。
- 空行节奏:顶级函数与类定义之间保留 2 个空行;类内部各方法之间保留 1 个空行;函数内部逻辑块之间保留 1 个空行以划分思考阶段。
- 二元运算符与空格:赋值号
=、比较符==、布尔符and两侧各留 1 个空格;函数默认参数的=前后不要加空格(如def query(limit=10):),但如果带有类型注解则保留空格(如def query(limit: int = 10):)。
3. 显式导入与依赖隔离
严禁使用通配符导入(如 from module import *)。这会严重污染本地命名空间,隐藏变量真实来源,极易导致意外的名称覆盖。规范的导入顺序应分为三组,组间以单空行分隔:
# 1. 标准库导入
import os
import sys
from datetime import datetime

# 2. 第三方依赖库导入
import requests
from pydantic import BaseModel

# 3. 本地应用/业务模块导入
from myapp.core.config import settings
from myapp.services.auth import verify_token
4. 现代 Python 3 类型注解(Type Hints)实践
从 Python 3.5 引入并在 3.9+ 完善的类型系统,使得 Pythonic 代码在保持动态灵活性的同时,获得了静态检查和优秀 IDE 提示支持。现代 Python 3 推荐使用原生类型进行标注,尽量避免引入弃用的旧式小写容器包装:
# Python 3.9+ 推荐的现代标注方式
def batch_process(
    items: list[str],
    weights: dict[str, float],
    scale: float | None = None
) -> list[float]:
    factor = scale if scale is not None else 1.0
    return [weights.get(item, 0.0) * factor for item in items]
三、惯用法实战:从“能跑”到“Pythonic”
许多初学者写出的 Python 代码能正确输出结果,但代码显得笨拙冗长。掌握以下高频核心惯用法,能迅速精简代码并提升其专业质感。
1. 遍历与解包艺术
在遍历序列时,如果同时需要索引和元素,不要使用 range(len(...)),而应使用内置的 enumerate();需要成对处理两个相关列表时,使用 zip():
# 繁琐且易出错的做法
names = ["Alice", "Bob", "Charlie"]
scores = [85, 92, 78]

for i in range(len(names)):
    print(f"Index {i}: {names[i]} got {scores[i]}")

# Pythonic 惯用法
for index, (name, score) in enumerate(zip(names, scores), start=1):
    print(f"Rank {index}: {name} got {score}")
此外,灵活利用星号表达式(Extended Iterable Unpacking)可以优雅地拆分数据结构头部与尾部:
record = ["2026-10-23", "ERROR", "DBConn", "Timeout connecting to host", 504]
date, level, service, *details, status_code = record
# details 自动捕获中间变长内容列表:['Timeout connecting to host']
2. 字典取值与默认状态聚合
避免通过 if key in my_dict: 再取值的低效二重查询。简单的取默认值直接使用 dict.get();面对复杂的分组或累计逻辑,使用 collections.defaultdict 或 dict.setdefault():
from collections import defaultdict

# 传统做法:手工判定 key 是否存在并初始化列表
grouped_data = {}
for category, item in stream_items:
    if category not in grouped_data:
        grouped_data[category] = []
    grouped_data[category].append(item)

# Pythonic 做法:声明结构默认形态
grouped_data = defaultdict(list)
for category, item in stream_items:
    grouped_data[category].append(item)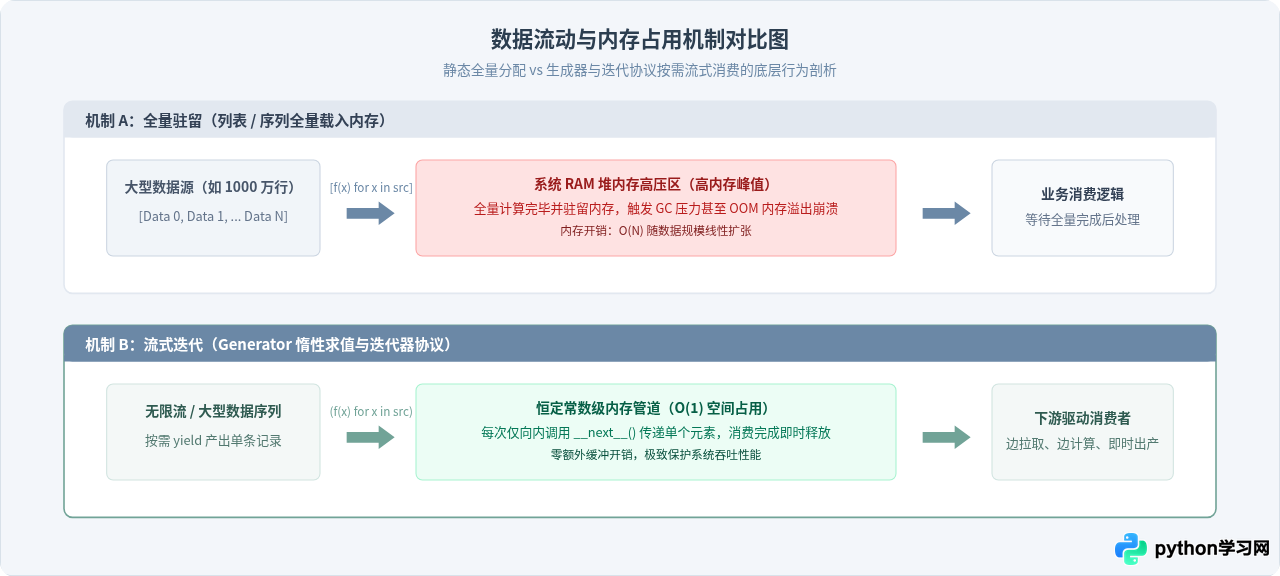
3. 上下文管理器与安全生命周期控制
在涉及文件读写、网络连接、数据库事务或互斥锁时,必须使用 with 语句管理资源。它保证无论代码块正常退出还是意外抛出异常,都会自动调用 __exit__ 释放句柄:
from contextlib import contextmanager

# 自定义轻量上下文管理器
@contextmanager
def execution_timer(label: str):
    import time
    start = time.perf_counter()
    try:
        yield
    finally:
        elapsed = time.perf_counter() - start
        print(f"[{label}] Execution finished in {elapsed:.4f}s")

# 业务使用
with execution_timer("Data Filter Task"):
    filtered = [x for x in range(1000000) if x % 7 == 0]
四、高频反模式排查与避坑指南
许多破坏代码健壮性的 bug,往往来自于对 Python 内部机制的误解。以下五个高频反模式是在工程实践中最容易踩坑的重灾区。
1. 误区一:使用可变对象作为函数默认参数
这是 Python 中最经典的陷阱。函数的默认参数只在模块被初次加载、定义函数对象时求值一次,而不是每次函数调用时重新创建。如果默认参数是可变类型(如 list、dict 或自定义实例),所有调用者将共享同一个对象状态!
# 危险的反模式代码!
def append_log(message: str, logs: list = []) -> list:
    logs.append(message)
    return logs

print(append_log("Event A"))  # 输出: ['Event A']
print(append_log("Event B"))  # 意外输出: ['Event A', 'Event B']!logs 变量被污染!

# 正确的 Pythonic 做法:使用 None 哨兵值
def append_log(message: str, logs: list[str] | None = None) -> list[str]:
    if logs is None:
        logs = []
    logs.append(message)
    return logs
2. 误区二:使用 type() 硬编码检查类型
在判断变量类型时,使用 type(obj) is int 会破坏面向对象的多态性(它无法识别子类继承)。应当使用 isinstance(),并且在绝大多数场景下,更应遵循“鸭子类型(Duck Typing)”哲学——只要一个对象具备所需的方法或行为,就可以直接调用:
# 糟糕的硬编码检查
if type(data) is list:
    total = sum(data)

# 更加灵活稳固的 Pythonic 检查
from collections.abc import Iterable

if isinstance(data, Iterable):
    total = sum(data)
3. 误区三:过度滥用单行推导式造成认知灾难
推导式是 Python 的利器,但推导式的核心价值在于简洁映射与过滤。当推导式中出现多层 for 循环嵌套,或者包含复杂的 if...else 三元判断时,其可读性会断崖式下跌。如果一行代码不能在 3 秒内看清意图,应当拆解为清晰的传统循环或独立辅助函数:
# 极难维护的单行推导式(强烈反对)
res = [f(x, y) for row in matrix for x in row if x > 0 for y in target_set if (x + y) % 2 == 0]

# Pythonic 做法:拆分阶段或使用生成器函数
def extract_valid_pairs(matrix, targets):
    for row in matrix:
        for x in row:
            if x <= 0:
                continue
            for y in targets:
                if (x + y) % 2 == 0:
                    yield f(x, y)
4. 误区四:宽泛捕获(bare except)吞没致命错误
写出 except: 或 except Exception: pass 是极其危险的坏习惯。这不仅会吞掉真正的业务逻辑 bug,甚至会拦截 KeyboardInterrupt(用户按下 Ctrl+C)与 SystemExit,导致程序无法正常退出或调试困难:
# 危险的反模式:静默吞没所有异常
try:
    result = fetch_remote_resource()
except:
    result = None  # 语法错误、网络中断、内存耗尽全被掩盖

# Pythonic 做法:明确捕获预期范围内的具体异常
try:
    result = fetch_remote_resource()
except (ConnectionError, TimeoutError) as err:
    logger.warning("Network failure occurred: %s, using fallback", err)
    result = None
5. 误区五:在循环中以“+”频繁拼接字符串
由于 Python 字符串是不可变对象(Immutable),每次使用 str1 + str2 都会在内存中重新申请空间并完整复制已有字符。在循环大量拼接时,时间复杂度会恶化为 $O(N^2)$。正确的做法是收集碎片后统一调用 str.join():
# 低效反模式:频繁分配内存
final_text = ""
for line in text_chunks:
    final_text += line + "\n"

# 高效的 Pythonic 做法:O(N) 线性分配
final_text = "\n".join(text_chunks) + "\n"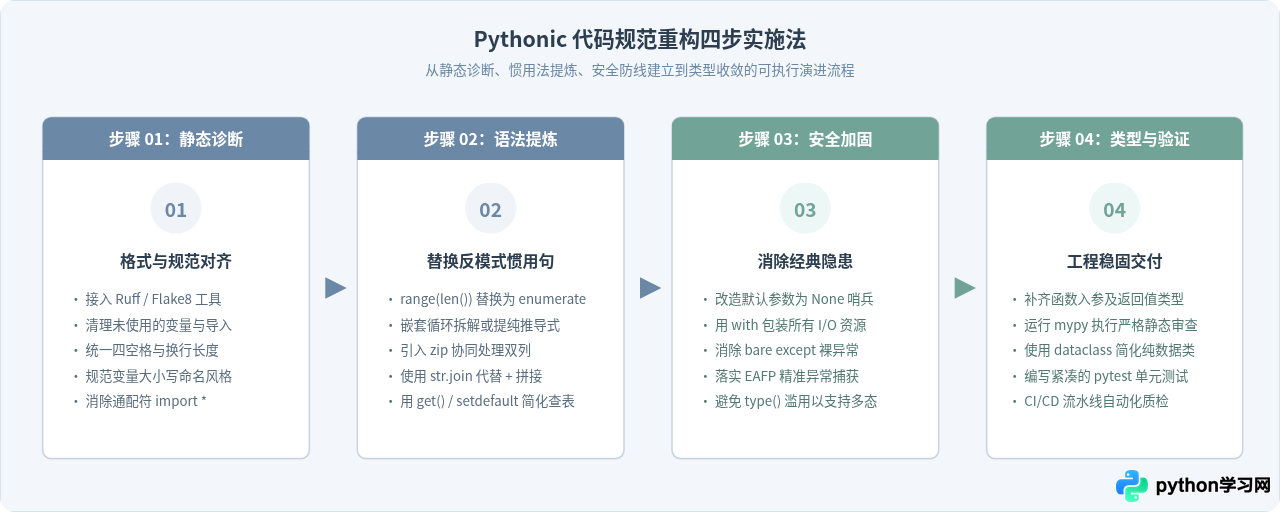
五、工程化落地与实践总结
写出高质量的 Pythonic 代码并非一朝一夕之功,也不是依靠机械记忆规则,而应当融入日常的自动化研发工具链中:
- 格式化工具选择:推荐在编辑器或提交钩子(pre-commit)中集成
Ruff或Black。它们能彻底终结团队关于单双引号、缩进空格与换行的无谓争论。 - 静态类型检查:在关键基础库和业务核心模块中启用
mypy或pyright,尽早将原本在运行时才暴露的 AttributeError 和 KeyError 拦截在编码阶段。 - 克制与平衡:永远牢记“简单胜于复杂”。不要为了展现 Python 特性而强行套用复杂的元类(Metaclass)、重载非常见双下划线运算符,或者写出超过三层的推导式。
| 维度 | 常见反模式(Non-Pythonic) | Pythonic 惯用法 | 核心收益 |
|---|---|---|---|
| 数据遍历 | for i in range(len(arr)): print(arr[i]) |
for item in arr: print(item) |
去除索引间接寻址,直观易读 |
| 带序遍历 | 手动维护 idx = 0; idx += 1 |
for idx, item in enumerate(arr): |
杜绝计数器遗漏或越界风险 |
| 资源清理 | 手动 f = open(...); try ... finally: f.close() |
with open(...) as f: |
异常安全保障,资源 100% 回收 |
| 默认参数 | def add_item(val, container=[]): |
def add_item(val, container=None): |
避免模块生命周期内跨调用数据污染 |
| 字典聚合 | 先判断 if k not in d: d[k] = [] 再 append |
defaultdict(list) 或 d.setdefault() |
单次哈希寻址,逻辑高度紧凑 |
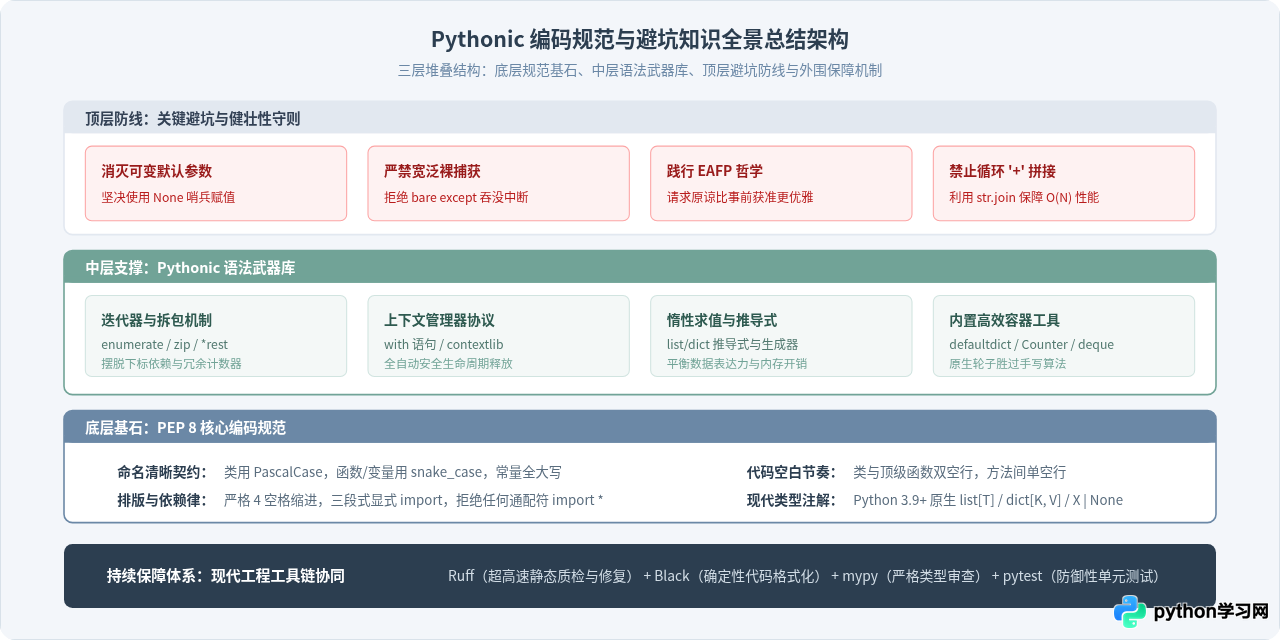
编写 Pythonic 代码从来不是追求晦涩的高级技巧,而是将“直观、显式、安全”的原则内化到每一行代码中。通过用原生迭代替代索引、用上下文管理器管理状态边界、用精准异常保护业务链路,并借助现代静态检查工具持续收敛代码异味,你便能持续写出不仅能够正确执行,而且令同事与自己都感到赏心悦目的高质量 Python 3 程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









