

Python实现分治法求解二维数组局部峰值

本文介绍使用Python通过分治法求解二维数组局部峰值的高效算法。核心思路是通过划分“田”字形区域,比较边界与中心元素找到最大值所在象限,从而缩小搜索范围至O(n)复杂度。同时附带一种贪心算法作为对比,尽管最坏情况复杂度仍为O(n^2),但提供了另一种解题视角。
题目要求在n*m的二维数组中寻找一个局部峰值。局部峰值的定义是:该位置的值严格大于其上下左右四个相邻元素(若处于边界,则视边界外元素为负无穷)。例如,若找到峰值A[j][i],需满足A[j][i] > A[j+1][i]、A[j][i] > A[j-1][i]、A[j][i] > A[j][i+1]以及A[j][i] > A[j][i-1]。最终需要返回该峰值所在的坐标及其数值。
最直观的方法是遍历数组中的所有元素,逐一判断其是否满足峰值条件。这种方法实现简单,但时间复杂度较高,为O(n^2)。
一种优化思路是先求出每一行(或每一列)的最大值,然后利用二分查找法在这些最大值中寻找峰值(具体逻辑可参考一维数组求峰值的方法)。这种算法的时间复杂度可以优化至O(logn)。
本文重点讨论一种时间复杂度为O(n)的算法,其核心思路包含以下步骤:
1、构建“田”字区域。该区域包括当前搜索范围的外围四条边以及中间横向和纵向的两条分割线(如图中绿色部分所示)。比较该区域内所有元素的大小,确定最大值的位置(如图中显示的数值7)。
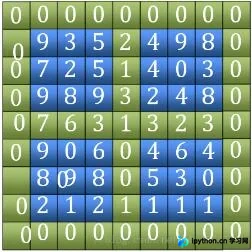
2、定位到“田”字中的最大值后,首先判断该值是否为局部峰值。如果是,则直接返回其坐标;如果不是,则记录其上下左右四个相邻点中数值最大的那个点的坐标。根据该相邻点所在的象限,将搜索范围缩小至该象限,并继续对下一个“田”字区域进行比较。
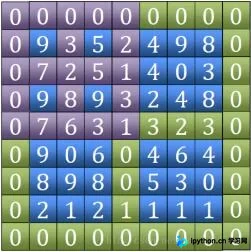
3、当搜索范围缩小至3*3的子矩阵时,必定能找到局部峰值(当然也可能在之前的步骤中已经找到)。
关于为何在当前选择的范围内一定存在峰值,可以这样理解:既然已知圈内至少有一个元素大于圈上所有元素,那么该圈内部必然存在一个最大值。
这一逻辑可能稍显抽象,建议多思考其几何意义,或者通过数学反证法进行严格证明。
理解算法逻辑后,接下来进行代码实现。这里使用Python语言(作为初学者,代码风格可能不够简洁,敬请谅解)。首先展示完整代码:
import numpy as np
def max_sit(*n):     #返回最大元素的位置
 temp = 0
 sit = 0
 for i in range(len(n)):
  if(n[i]>temp):
   temp = n[i]
   sit = i
 return sit
def dp(s1,s2,e1,e2):
 m1 = int((e1-s1)/2)+s1   #row
 m2 = int((e2-s1)/2)+s2   #col
 nub = e1-s1
 temp = 0
 sit_row = 0
 sit_col = 0
 for i in range(nub):
  t = max_sit(list[s1][s2+i],     #第一排
     list[m1][s2+i],     #中间排
     list[e1][s2+i],     #最后排
     list[s1+i][s2],     #第一列
     list[s1+i][m2],     #中间列
     list[s1+i][e2],     #最后列
     temp)
  if(t==6):
   pass
  elif(t==0):
   temp = list[s1][s2+i]
   sit_row = s1
   sit_col = s2+i
  elif(t==1):
   temp = list[m1][s2+i]
   sit_row = m1
   sit_col = s2+i
  elif(t==2):
   temp = list[e1][s2+i]
   sit_row = e1
   sit_col = s2+i
  elif(t==3):
   temp = list[s1+i][s2]
   sit_row = s1+i
   sit_row = s2
  elif(t==4):
   temp = list[s1+i][m2]
   sit_row = s1+i
   sit_col = m2
  elif(t==5):
   temp = list[s1+i][e2]
   sit_row = s1+i
   sit_col = m2
 t = max_sit(list[sit_row][sit_col],   #中
    list[sit_row-1][sit_col],  #上
    list[sit_row+1][sit_col],  #下
    list[sit_row][sit_col-1],  #左
    list[sit_row][sit_col+1])  #右
 if(t==0):
  return [sit_row-1,sit_col-1]
 elif(t==1):
  sit_row-=1
 elif(t==2):
  sit_row+=1
 elif(t==3):
  sit_col-=1
 elif(t==4):
  sit_col+=1
 if(sit_row<m1):
  e1 = m1
 else:
  s1 = m1
 if(sit_col<m2):
  e2 = m2
 else:
  s2 = m2
 return dp(s1,s2,e1,e2)
f = open("demo.txt","r")
list = f.read()
list = list.split("\n")       #对行进行切片
list = ["0 "*len(list)]+list+["0 "*len(list)] #加上下的围墙
for i in range(len(list)):      #对列进行切片
 list[i] = list[i].split()
 list[i] = ["0"]+list[i]+["0"]    #加左右的围墙
list = np.array(list).astype(np.int32)
row_n = len(list)
col_n = len(list[0])
ans_sit = dp(0,0,row_n-1,col_n-1)
print("找到峰值点位于:",ans_sit)
print("该峰值点大小为:",list[ans_sit[0]+1,ans_sit[1]+1])
f.close()
输入数据存储在txt文本文件中,通过字符串处理转换为二维数组。具体的转换过程可参考之前的博客文章——“Python中字符串转换为二维数组”。需要注意的是,在Windows环境下,split操作后的列表末尾通常没有空元素,因此无需执行list.pop()。此外,我在二维数组的四周添加了值为“0”的围墙,这样在判断峰值时无需额外处理边界条件。
max_sit(*n)函数用于找出多个数值中最大值的位置并返回。由于Python内置的max函数仅返回最大值本身,因此需要自定义此函数。参数*n表示不定长参数,因为在比较“田”字区域和判断峰值时都需要用到该功能。
def max_sit(*n):     #返回最大元素的位置
 temp = 0
 sit = 0
 for i in range(len(n)):
  if(n[i]>temp):
   temp = n[i]
   sit = i
 return sit
dp(s1,s2,e1,e2)函数中的四个参数分别代表startx、starty、endx、endy,即当前搜索范围的左上角坐标和右下角坐标。
m1和m2分别是row(行)和col(列)的中间值,也就是“田”字区域的中心点坐标。
def dp(s1,s2,e1,e2):
 m1 = int((e1-s1)/2)+s1   #row
 m2 = int((e2-s1)/2)+s2   #col
依次比较3行3列中的值以找到最大值。注意,此逻辑假设二维数组为正方形,如果数组为矩形,则需要对代码进行相应调整。
 for i in range(nub):
  t = max_sit(list[s1][s2+i],     #第一排
     list[m1][s2+i],     #中间排
     list[e1][s2+i],     #最后排
     list[s1+i][s2],     #第一列
     list[s1+i][m2],     #中间列
     list[s1+i][e2],     #最后列
     temp)
  if(t==6):
   pass
  elif(t==0):
   temp = list[s1][s2+i]
   sit_row = s1
   sit_col = s2+i
  elif(t==1):
   temp = list[m1][s2+i]
   sit_row = m1
   sit_col = s2+i
  elif(t==2):
   temp = list[e1][s2+i]
   sit_row = e1
   sit_col = s2+i
  elif(t==3):
   temp = list[s1+i][s2]
   sit_row = s1+i
   sit_row = s2
  elif(t==4):
   temp = list[s1+i][m2]
   sit_row = s1+i
   sit_row = m2
  elif(t==5):
   temp = list[s1+i][e2]
   sit_row = s1+i
   sit_row = m2
判断“田”字中的最大值是否为峰值,如果不是,则找出其相邻四个方向中数值最大的那个。
t = max_sit(list[sit_row][sit_col],   #中
    list[sit_row-1][sit_col],  #上
    list[sit_row+1][sit_col],  #下
    list[sit_row][sit_col-1],  #左
    list[sit_row][sit_col+1])  #右
 if(t==0):
  return [sit_row-1,sit_col-1]
 elif(t==1):
  sit_row-=1
 elif(t==2):
  sit_row+=1
 elif(t==3):
  sit_col-=1
 elif(t==4):
  sit_col+=1
根据相邻最大值的坐标缩小搜索范围,并递归调用dp函数继续求解。
 if(sit_row<m1):
  e1 = m1
 else:
  s1 = m1
 if(sit_col<m2):
  e2 = m2
 else:
  s2 = m2

 return dp(s1,s2,e1,e2)
至此,代码的主要逻辑分析完毕。如果仍有不清楚的地方,欢迎在下方留言讨论。
除了上述分治算法外,我还编写了一种贪心算法来解决此问题。遗憾的是,在最坏情况下,该算法的时间复杂度仍为O(n^2)。
贪心算法的基本思路是从中间位置开始,找到其相邻4个点中最大的点,然后以该点为中心,继续寻找其相邻的最大点,如此迭代,最终必然找到一个峰值点。有兴趣的读者可以参考以下代码:
#!/usr/bin/python3
def dp(n):
 temp = (str[n],str[n-9],str[n-1],str[n+1],str[n+9])  #中 上 左 右 下
 sit = temp.index(max(temp))
 if(sit==0):
  return str[n]
 elif(sit==1):
  return dp(n-9)
 elif(sit==2):
  return dp(n-1)
 elif(sit==3):
  return dp(n+1)
 else:
  return dp(n+9)
f = open("/home/nancy/桌面/demo.txt","r")
list = f.read()
list = list.replace(" ","").split()  #转换为列表
row = len(list)
col = len(list[0])
str="0"*(col+3)
for x in list:      #加围墙 二维变一维
 str+=x+"00"
str+="0"*(col+1)
mid = int(len(str)/2)
print(str,mid)
p = dp(mid)
print (p)
f.close()
以上关于Python分治法求解二维数组局部峰值的内容就是小编分享给大家的全部信息,希望能对大家有所帮助。也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









