

非程序员学Python有什么用?办公自动化与数据处理实战案例
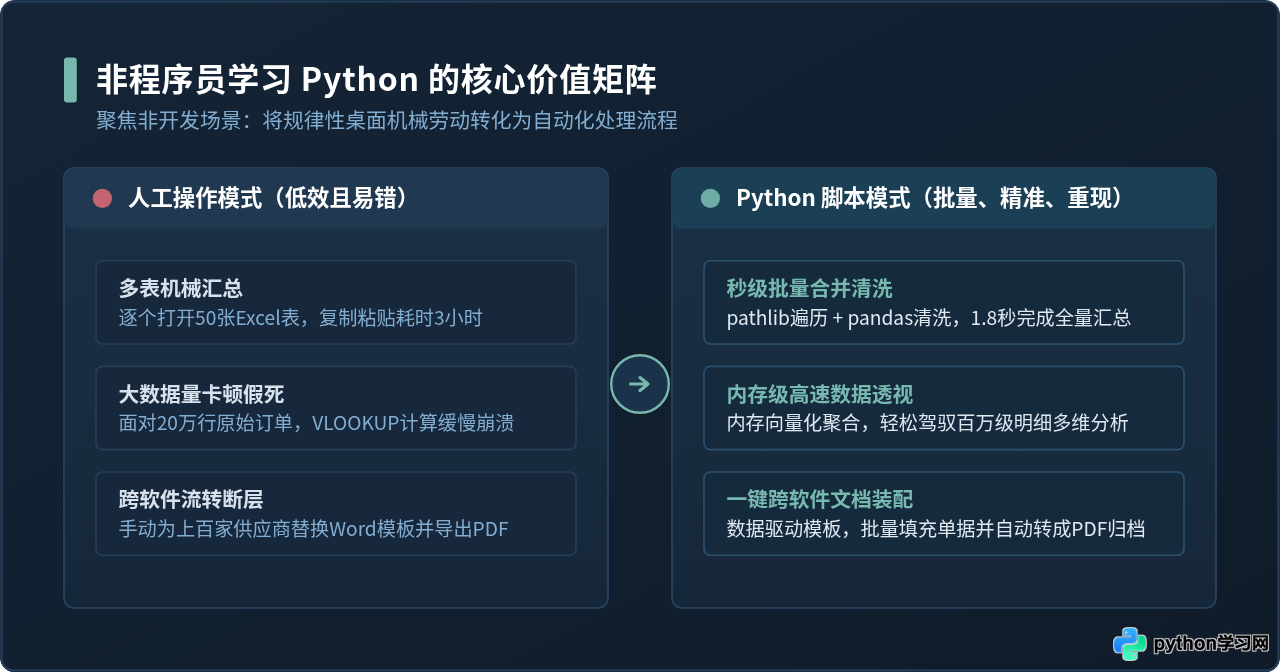
非程序员学习Python的真正价值不在于开发软件或刷算法题,而在于将日常桌面办公中的高频机械劳动自动化,并解决Excel处理海量数据时的卡顿瓶颈。本文通过50份报表批量合并、20万行销售数据清洗透视及批量生成合同PDF三个实战案例,拆解非程序员学Python的切实用途与学习边界。
非程序员学习 Python 的核心答案非常清晰:并不是为了开发软件、搭建网站或研究前沿算法,而是为了把日常工作中具有明确规则的机械重复劳动转化为脚本一键执行,并在数据量超出桌面电子表格承载上限时保持高效处理。
在企业日常办公场景中,大量精力被消耗在文件整理、格式搬运、多表拼接与跨软件录入上。这些工作单调且易错,正是 Python 最擅长发挥杠杆效应的领域。掌握基础语法与两三个核心模块后,非程序员即可搭建自己的数字化工具箱。
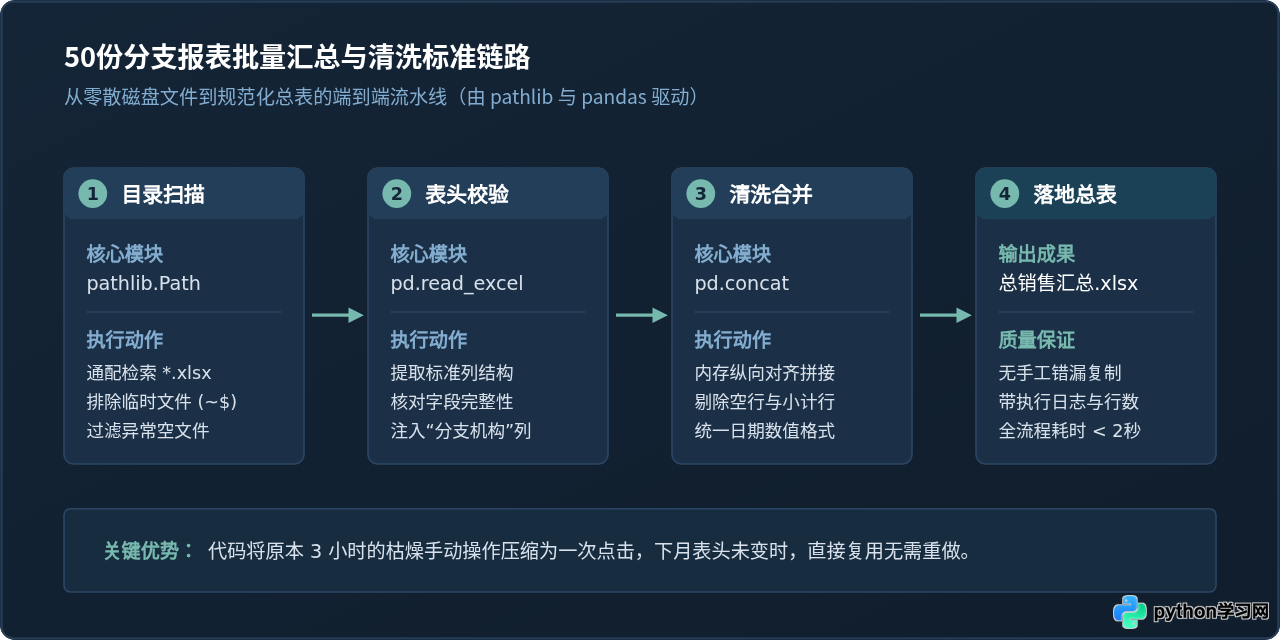
一、实战案例 1:50 份分支报表批量汇总与格式清洗
在常规办公流程中,多文件合并往往是最高频的重复工作之一。例如各城市分公司按月上报《月度销售明细.xlsx》,数据存放在统一文件夹中。人工处理时需要重复 50 次“打开、复制、粘贴、关闭”;而在 Python 中,借助内置的 pathlib 库扫描磁盘,搭配 pandas 库进行结构化拼接,仅需不到 20 行代码即可完成。
1. 操作环境与依赖准备
本任务需要安装数据分析标准库 pandas 以及读写 Excel 所需的底层引擎 openpyxl。在终端或命令提示符中执行以下安装命令:
pip install pandas openpyxl2. 完整合并脚本
假设 50 份分店报表存放在本地文件夹 ./branch_reports/ 中,每个表格包含“销售日期、产品名称、单价、销量、销售额”等字段,且表格前两行为标题和说明,有效数据从第 3 行开始。
import time
from pathlib import Path
import pandas as pd

def batch_merge_branch_reports(report_folder: str, output_file: str):
    start_time = time.time()
    folder_path = Path(report_folder)

    # 步骤 1:检索所有有效的 Excel 文件,排除临时文件
    excel_files = [f for f in folder_path.glob("*.xlsx") if not f.name.startswith("~$")]
    if not excel_files:
        print("未检测到有效 Excel 文件,请确认路径。")
        return

    data_frames = []

    # 步骤 2:遍历读取并标注来源
    for file_path in excel_files:
        # 跳过前2行说明文字,直接提取真实列名
        df = pd.read_excel(file_path, skiprows=2)

        # 增加一列“分支机构”,便于溯源
        branch_name = file_path.stem.replace("_月度销售明细", "")
        df["分支机构"] = branch_name

        # 步骤 3:清洗无效尾行(例如人工填写的“总计”或全空行)
        df = df.dropna(subset=["产品名称"])
        df = df[df["产品名称"] != "总计"]

        data_frames.append(df)

    # 步骤 4:内存纵向拼接
    merged_df = pd.concat(data_frames, ignore_index=True)

    # 导出至统一总表
    merged_df.to_excel(output_file, index=False, engine="openpyxl")

    duration = time.time() - start_time
    print(f"处理完成!成功合并 {len(excel_files)} 份报表,总计 {len(merged_df)} 行数据。")
    print(f"脚本总耗时:{duration:.2f} 秒,文件已导出至 {output_file}")

if __name__ == "__main__":
batch_merge_branch_reports("./branch_reports", "./全国汇总_2026年10月.xlsx")处理完成!成功合并 50 份报表,总计 14,820 行数据。
脚本总耗时:1.78 秒,文件已导出至 ./全国汇总_2026年10月.xlsx
~$ 开头的临时隐藏文件。如果不加 if not f.name.startswith("~$") 进行排除,脚本会尝试解析临时文件而抛出损坏异常。
二、实战案例 2:20 万行海量销售明细的高速清洗与多维透视
当业务数据体量超过一定规模时,Excel 的运行效率会显著衰减。虽然现代 Excel 理论上限为 1,048,576 行,但在实际体验中,单表数据超过 10 万行并套用多重公式(如 VLOOKUP 或 SUMIFS)时,电脑极易陷入卡死甚至闪退。
Python 的 pandas 基于底层 C 语言向量化计算,将整个数据集保存在连续内存块中,处理 20 万行数据的缺失值填补、日期标准化与跨维度汇总仅需数百毫秒。
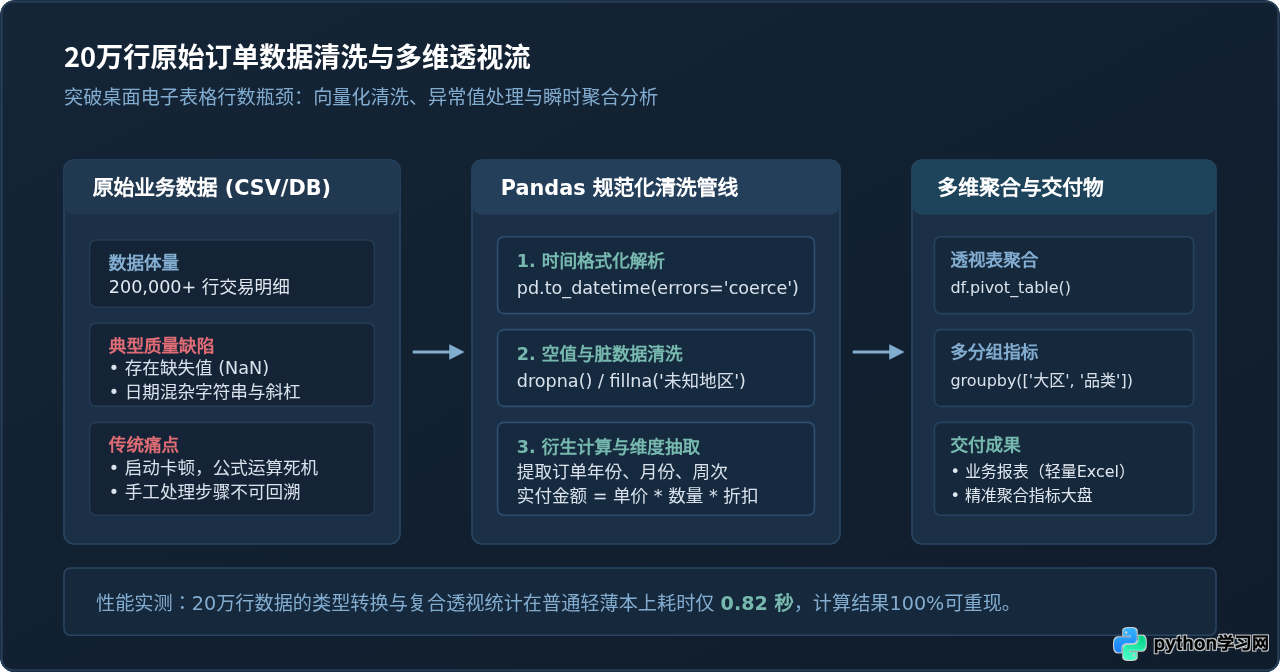
1. 数据特征与处理需求
业务系统中导出的 orders_2026.csv 包含 20 万行交易数据。原始数据存在以下质量问题:
- 日期格式不规整:部分为
2026/10/01,部分为2026-10-01,甚至夹杂无法解析的非法字符串; - 缺失地区信息:存在约 1,200 条地区为空的记录,需要规范标注为“未分配”;
- 汇总需求:需要瞬时计算出每个销售大区、每个品类在各季度的销售总额与平均订单客单价。
2. 向量化清洗与聚合脚本
import time
import pandas as pd

def process_large_order_data(csv_path: str):
    t0 = time.time()

    # 读取大规模 CSV
    df = pd.read_csv(csv_path)
    initial_rows = len(df)

    # 步骤 1:日期类型转换与非法值过滤
    # errors='coerce' 会将无法解析的异常值自动转为 NaT(空时间)
    df["订单日期"] = pd.to_datetime(df["订单日期"], errors="coerce")
    df = df.dropna(subset=["订单日期"])

    # 衍生计算:提取年份与季度字段
    df["季度"] = df["订单日期"].dt.to_period("Q")

    # 步骤 2:空值填充与金额有效性校验
    df["大区"] = df["大区"].fillna("未分配")
    df["实付金额"] = pd.to_numeric(df["实付金额"], errors="coerce")
    df = df[df["实付金额"] > 0]

    # 步骤 3:构建多维透视汇总表
    pivot_result = pd.pivot_table(
        df,
        values="实付金额",
        index=["大区", "品类"],
        columns="季度",
        aggfunc=["sum", "mean"],
        fill_value=0
    )

    # 保存结果(透视后的表格体积小,适合导出给业务部门传阅)
    pivot_result.to_excel("./各区品类季度透视分析.xlsx")

    elapsed = time.time() - t0
    print(f"清洗完毕:原始数据 {initial_rows} 行,过滤保留有效数据 {len(df)} 行。")
    print(f"内存计算总耗时:{elapsed:.2f} 秒,分析结果已写入 Excel。")

if __name__ == "__main__":
process_large_order_data("./orders_2026.csv")内存计算总耗时:0.82 秒,分析结果已写入 Excel。
借助这一处理链路,原本需要在表格软件中反复等待“正在计算 4 个线程”数分钟的操作,被压缩至 1 秒以内,且后续只要有新数据更新,重新运行一次脚本即可获得标准报表。
三、实战案例 3:跨软件批量生成个性化合同与自动转 PDF
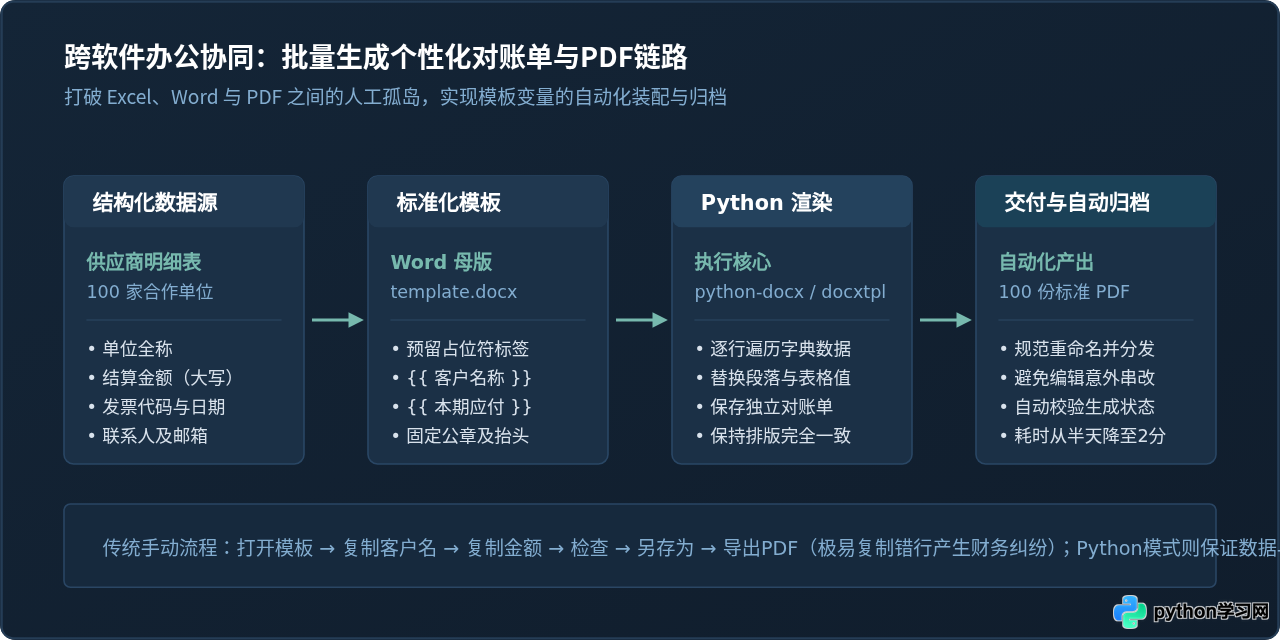
办公自动化不仅限于表格本身,还在于打通 Excel(数据源)→ Word(排版文档)→ PDF(定稿交付物) 之间的断层。在人力资源、采购和法务岗位上,向数百名员工发放薪资条,或向数百家合作商出具个性化对账确认函,传统做法是使用“邮件合并”或人工复制粘贴。手工复制面临格式移位与信息串行的严重风险。
1. 所需扩展工具库
使用 docx 模块对 Word 文档段落中的占位符进行精准替换,并借助系统打印驱动或 docx2pdf 将文档转换为不可篡改的 PDF 文件。
pip install python-docx docx2pdf2. 批量装配与格式转换脚本
from pathlib import Path
import pandas as pd
from docx import Document
from docx2pdf import convert

def generate_reconciliation_letters(data_excel: str, template_word: str, output_dir: str):
    out_path = Path(output_dir)
    out_path.mkdir(parents=True, exist_ok=True)

    # 步骤 1:读取结构化供应商台账
    df = pd.read_excel(data_excel)
    total_count = len(df)

    print(f"开始批量处理,共计 {total_count} 家单位...")

    # 步骤 2:逐行遍历,填充模板
    for idx, row in df.iterrows():
        doc = Document(template_word)

        # 待替换的动态映射字典
        context = {
            "{{COMPANY_NAME}}": str(row["单位全称"]),
            "{{CONTRACT_NO}}": str(row["合同编号"]),
            "{{SETTLE_AMOUNT}}": f"{float(row['结算金额']):,.2f} 元",
            "{{DUE_DATE}}": str(row["结算截止日"])
        }

        # 扫描文档内所有段落进行文本替换
        for paragraph in doc.paragraphs:
            for key, val in context.items():
                if key in paragraph.text:
                    paragraph.text = paragraph.text.replace(key, val)

        # 临时保存为单独的 Word
        safe_name = str(row["单位全称"]).strip().replace("/", "_")
        word_target = out_path / f"对账函_{safe_name}.docx"
        pdf_target = out_path / f"对账函_{safe_name}.pdf"

        doc.save(word_target)

        # 步骤 3:直接转为 PDF 格式
        convert(str(word_target), str(pdf_target))
        # 转换完成后可按需删除过程 Word 文件
        word_target.unlink()

    print(f"全部完成!{total_count} 份独立 PDF 对账单已生成至 {output_dir}")

if __name__ == "__main__":
generate_reconciliation_letters("./供应商台账.xlsx", "./对账单模板.docx", "./已出具对账单/")docx2pdf 在调用时会依赖本地环境中的 Word 软件或 LibreOffice 办公套件。在服务器或无图形界面环境中执行批量渲染时,推荐使用 reportlab 或 weasyprint 方案直接渲染 HTML 至 PDF,可避免桌面软件弹窗冲突。
四、非程序员该如何取舍?Excel 与 Python 的决策边界
学习 Python 并不意味着要完全抛弃 Excel。相反,最高效的办公模式往往是“Python 负责幕后脏活累活,Excel 负责台前灵活展示”。明确两者的优势边界,可以避免技术投入的浪费。
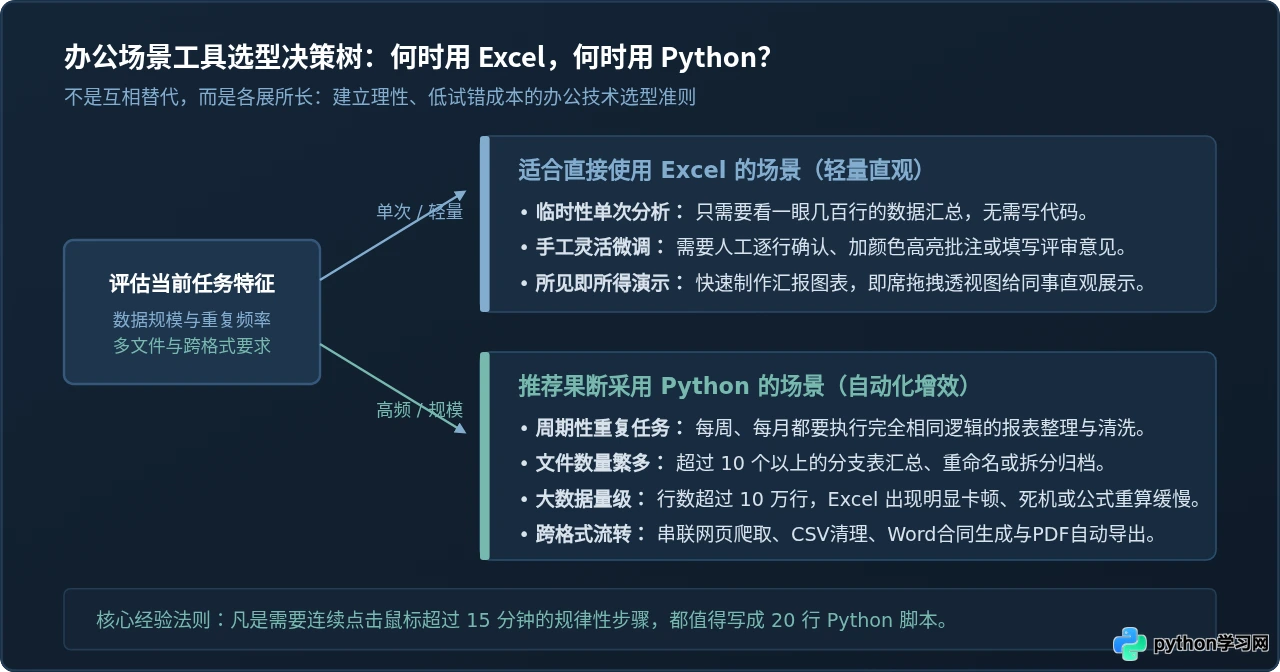
| 评估维度 | 推荐使用 Excel | 推荐使用 Python |
|---|---|---|
| 任务频率 | 偶发、单次的即席临时探索 | 每周、每月固定的周期性标准化任务 |
| 数据体量 | 10 万行以内,文件小于 30MB | 10 万行以上至千万级,或跨数十个独立文件 |
| 协作交互 | 需要人工逐行审阅、添加批注与高亮颜色 | 无人值守自动清洗、格式转换与规则校验 |
| 跨软件连接 | 局限于单表或 Office 内部基础链接 | 串联 API、数据库、文件夹、邮件与自动化报表 |
| 错误排查 | 单元格公式容易被误删或破坏相对引用 | 代码逻辑独立于数据,处理流程 100% 可重现 |
五、避坑建议与务实学习路径
许多非程序员在尝试学习编程时中途放弃,主要原因在于选错了学习路线。按照计算机专业的培养方式,从数据结构、递归算法、二叉树或刷 LeetCode 算法题入门,不仅耗时耗力,而且与办公场景严重脱节。
对于以提升日常效率为目标的职场人,建议遵循以下务实原则:
-
只学最小实用子集:
把精力集中在变量、循环(
for)、条件分支(if)、字典、文件读写(pathlib)以及核心数据处理库pandas。面向对象设计模式、复杂多线程并发等概念在常规自动化中极少使用,初期完全可以跳过。 - 从自己当前的痛点场景倒推: 不要泛泛地看完整本教材再去写代码。选定一个这周就要做的繁琐任务(例如“给 200 个客户重命名收据文件”),带着具体问题查阅代码并拼装运行,在跑通第一个可用脚本的过程中建立正向反馈。
-
养成规范的路径处理习惯:
Windows 路径中的反斜杠(
\)在编程语言中是转义字符,初学者常因写错路径报错。务必使用pathlib.Path或在字符串前加r(例如r"C:\Users\Reports")来处理路径。
掌握 Python 之后,电脑将不再只是一个被动接受鼠标点击的显示器,而是一个随时可以接收指令、在后台不知疲倦处理海量任务的数字助手。把机械劳动交给脚本,才能将更多时间投入到对业务洞察与价值创造之中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









