

怎么通过实战项目巩固Python基础:适合新手的练习案例
针对Python初学者掌握语法后难以独立编写程序的困境,本文系统梳理从语法记忆到实际编程的转化路径,提供4个精简可运行的标准库小项目,深入讲解数据组织、模块拆分、文件操作与异常防御,帮助读者扎实巩固Python基础。
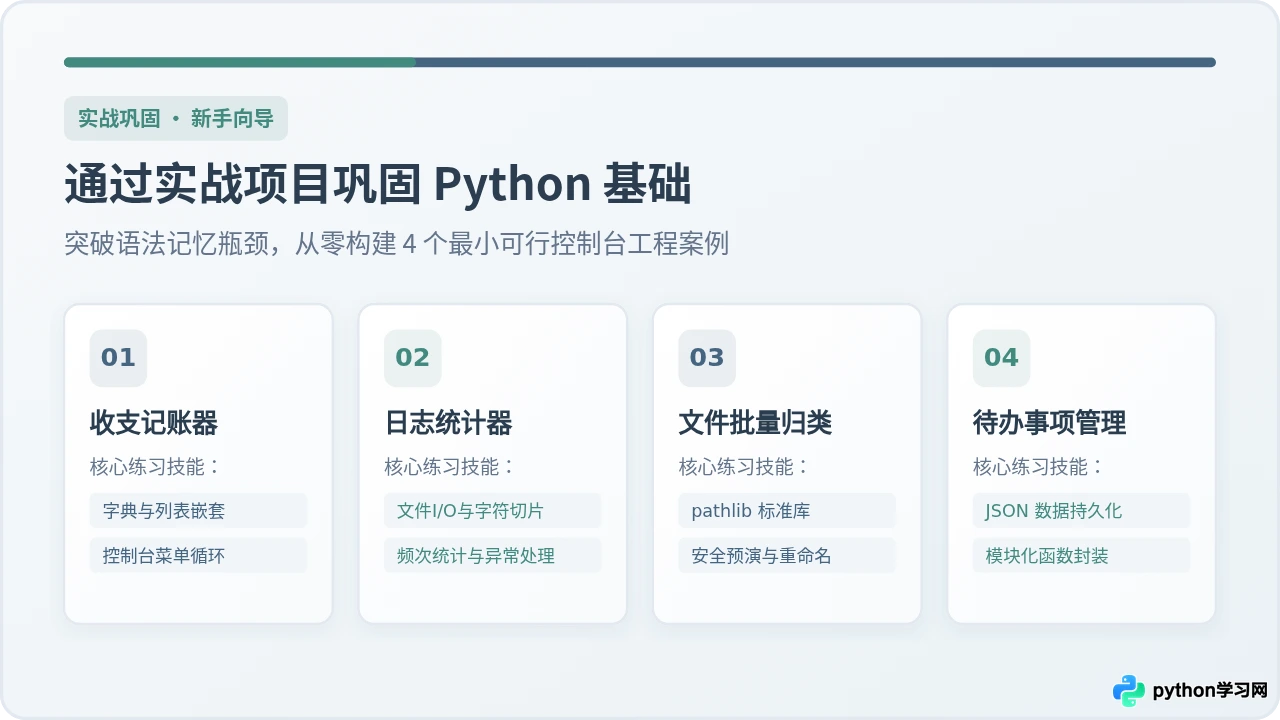
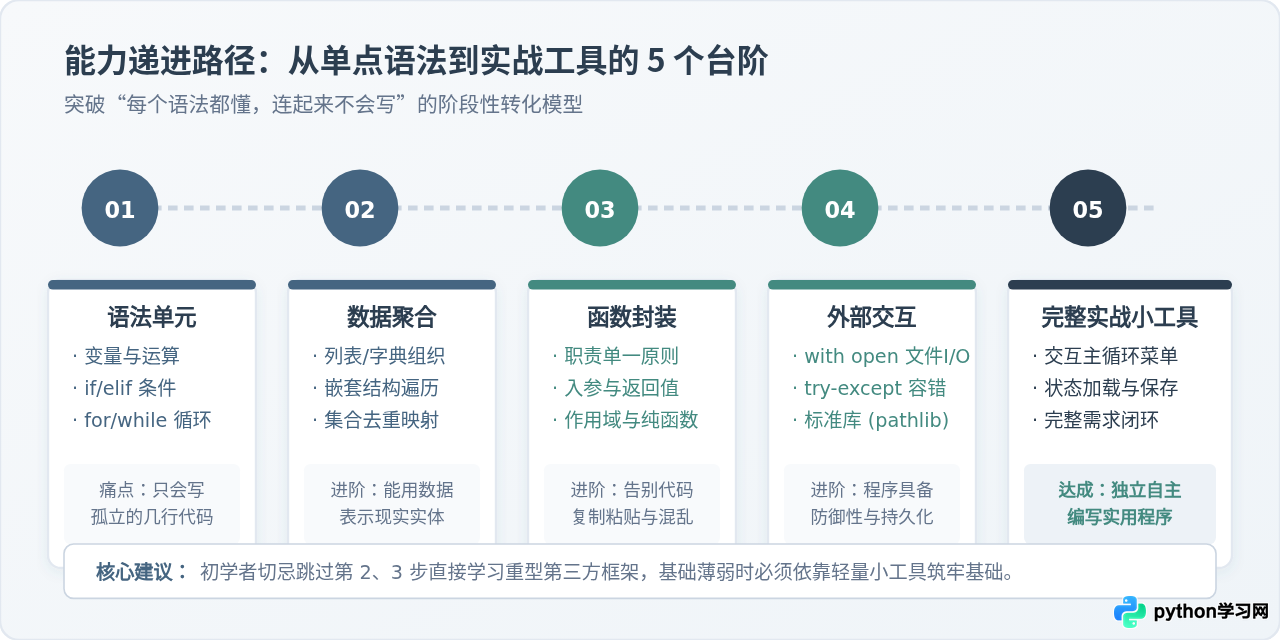
掌握了 Python 的基础语法——例如基本数据类型、if/else 条件分支、for/while 循环结构以及简单的函数定义后,许多初学者往往会陷入“能看懂教材案例,但面对空白文件却敲不出完整代码”的脱节状态。巩固基础语法的最高效路径,是跳过繁杂臃肿的大型框架,直接编写 3 到 4 个不依赖任何第三方库、完全基于标准库的微型控制台或脚本工具。通过自给自足的代码组织,读者可以在真实的问题闭环中掌握变量传递、容器嵌套、文件读写和异常防御的本质。
一、从语法到实战:为什么小体量项目是巩固基础的关键
很多初学者在学完语法后急于上手 Django、Flask、PyTorch 或 Pandas 等流行框架,结果发现大量时间耗费在理解框架约定的配置、复杂的第三方 API 以及环境配置上,反而对 Python 基础语言特性的运用越发模糊。
通过设计严密的小型实战工具来巩固基础,其核心逻辑在于将单一分散的语法点组合成完整的“输入-处理-输出”闭环:
- 建立数据建模思维:用原生的
list、dict、tuple表达现实中的事务与业务状态,理解引用传递与就地修改的差别。 - 掌握控制流的组合:不再停留在教材中单一的九九乘法表,而是学会在主事件循环(
while True)中配合分支跳转与状态更新。 - 具备防御性编程意识:面对用户的非法输入或缺失的文件,能够熟练运用
try-except捕获特定异常,而不是让程序直接崩溃退出。
二、案例一:命令行个人收支记账器(巩固容器嵌套与流程控制)
该案例的目标是实现一个交互式的记账工具。用户可以通过控制台输入多笔消费记录,系统支持按分类(餐饮、交通、购物等)记录金额与备注,并能随时生成账单汇总与统计数据。
1. 核心巩固知识点
- 数据类型转换:从
input()接收字符串并安全转换为浮点数float()。 - 容器组合嵌套:外层使用列表
list存储所有的账单记录,内层使用字典dict存储单条明细(包含category、amount、desc键)。 - 主循环与菜单交互:使用
while True构建常驻终端菜单,通过条件分支分发操作指令。 - 数据聚合遍历:使用
for循环配合累加器计算总支出,并基于字典统计各分类占比。
2. 完整可执行代码
# 记账小工具:expense_tracker.py
def main():
    records = []  # 存放账单明细,元素为字典

    while True:
        print("\n=== 个人收支记账控制台 ===")
        print("1. 记录一笔新支出")
        print("2. 查看所有支出明细")
        print("3. 查看分类统计与总额")
        print("4. 退出程序")

        choice = input("请选择操作 (1-4): ").strip()

        if choice == "1":
            category = input("请输入消费分类 (如 餐饮/交通/娱乐): ").strip()
            if not category:
                print("【提示】消费分类不能为空!")
                continue

            amount_str = input("请输入消费金额 (元): ").strip()
            try:
                amount = float(amount_str)
                if amount <= 0:
                    print("【提示】金额必须大于 0!")
                    continue
            except ValueError:
                print("【错误】请输入有效的数值!")
                continue

            desc = input("请输入备注说明: ").strip()

            # 将结构化记录存入列表
            item = {
                "category": category,
                "amount": amount,
                "desc": desc if desc else "无备注"
            }
            records.append(item)
            print(f"【成功】已记录:{category} 消费 {amount:.2f} 元")

        elif choice == "2":
            if not records:
                print("【提示】暂无任何消费记录。")
                continue

            print("\n--- 历史支出明细 ---")
            print(f"{'序号':<4} {'分类':<8} {'金额(元)':<10} {'备注'}")
            for index, item in enumerate(records, start=1):
                print(f"{index:<4} {item['category']:<8} {item['amount']:<10.2f} {item['desc']}")

        elif choice == "3":
            if not records:
                print("【提示】暂无消费记录,无法统计。")
                continue

            total = 0.0
            category_totals = {}
            for item in records:
                total += item["amount"]
                cat = item["category"]
                category_totals[cat] = category_totals.get(cat, 0.0) + item["amount"]

            print(f"\n--- 收支统计汇总 (共 {len(records)} 笔) ---")
            print(f"累计总支出:{total:.2f} 元")
            print("各分类汇总:")
            for cat, subtotal in category_totals.items():
                ratio = (subtotal / total) * 100
                print(f"  - {cat}: {subtotal:.2f} 元 ({ratio:.1f}%)")

        elif choice == "4":
            print("程序已安全退出,再见!")
            break
        else:
            print("【提示】无效选项,请输入数字 1 到 4。")

if __name__ == "__main__":
    main()
统计分类时使用 category_totals.get(cat, 0.0) + item["amount"] 是 Python 统计频次与聚合累加的经典写法,它能避免先写 if cat not in category_totals: ... else: ... 的繁琐判断,有效提升代码可读性。
三、案例二:文本日志快速分析与统计器(巩固文件读写与字符串操作)
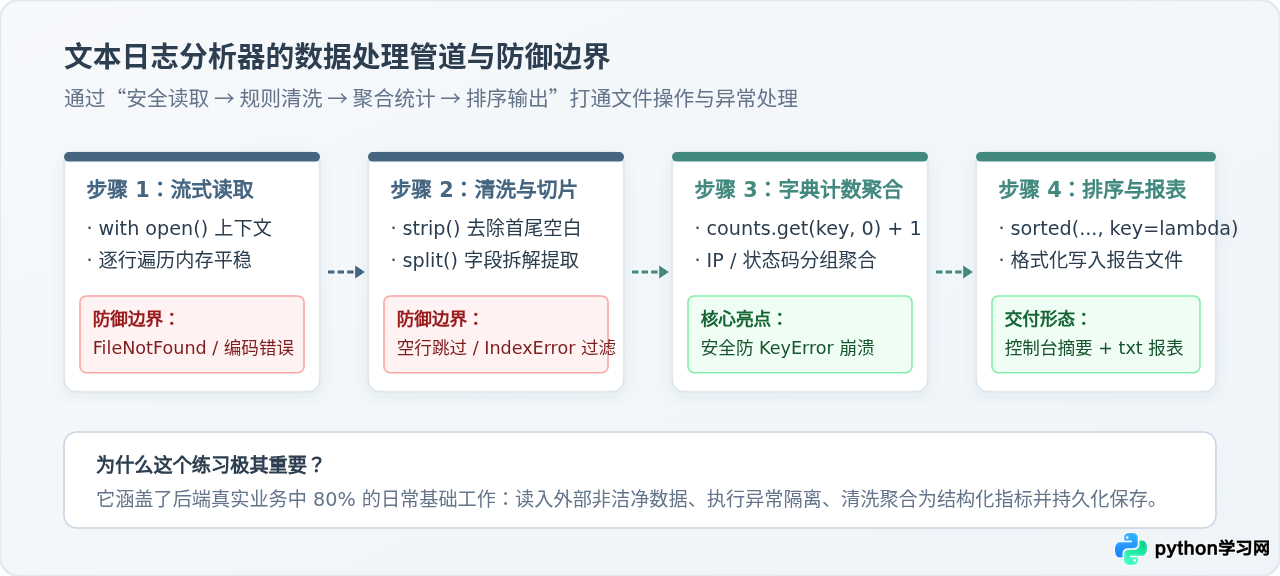
在日常运维与数据处理中,解析纯文本日志是出现频率极高的场景。这个案例将从一个模拟的 Web 访问日志中提取 IP、请求路径和 HTTP 响应状态码,统计独立访问 IP 数、404/500 异常错误比例,并把分析结果导出到新的文本文件中。
1. 核心巩固知识点
- 上下文管理器:使用
with open(..., 'r', encoding='utf-8')安全打开和自动关闭文件。 - 字符串切片与清洗:使用
str.strip()清理换行符,使用str.split()按空格或分隔符准确提取字段。 - 频次统计与排序:结合内置字典与
sorted()高阶函数,配合lambda表达式对统计结果按出现次数从大到小排序。 - 文件输出:以写模式(
'w')向磁盘写出格式化的分析报告。
2. 完整可执行代码
# 日志分析工具:log_analyzer.py
from typing import Dict, List, Tuple

def parse_log_line(line: str) -> Tuple[str, str, int]:
    """
    解析单行日志,期望格式:
    192.168.1.10 - GET /index.html 200
    返回: (ip, path, status_code)
    """
    parts = line.strip().split()
    if len(parts) < 5:
        raise ValueError("日志格式不符合规范,字段不足")

    ip = parts[0]
    path = parts[3]
    status_code = int(parts[4])
    return ip, path, status_code

def analyze_log_file(file_path: str) -> Dict:
    """读取并汇总分析日志文件"""
    ip_counter = {}
    status_counter = {}
    total_lines = 0
    error_lines = 0

    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if not line:
                continue  # 跳过空行
            total_lines += 1
            try:
                ip, path, code = parse_log_line(line)
                ip_counter[ip] = ip_counter.get(ip, 0) + 1
                status_counter[code] = status_counter.get(code, 0) + 1
            except (ValueError, IndexError):
                error_lines += 1
                continue

    return {
        "total_lines": total_lines,
        "valid_lines": total_lines - error_lines,
        "error_lines": error_lines,
        "ip_stats": ip_counter,
        "status_stats": status_counter
    }

def export_report(report_data: Dict, output_path: str):
    """将分析报告输出到文本文件"""
    # 按访问次数对 IP 降序排列
    sorted_ips = sorted(report_data["ip_stats"].items(), key=lambda x: x[1], reverse=True)
    sorted_status = sorted(report_data["status_stats"].items(), key=lambda x: x[1], reverse=True)

    with open(output_path, "w", encoding="utf-8") as out:
        out.write("====== Web 访问日志分析报告 ======\n")
        out.write(f"处理行数: {report_data['total_lines']}\n")
        out.write(f"解析成功: {report_data['valid_lines']}\n")
        out.write(f"解析失败: {report_data['error_lines']}\n\n")

        out.write("--- 访问频次最高的前 5 个 IP ---\n")
        for ip, count in sorted_ips[:5]:
            out.write(f"IP: {ip:<16} 访问次数: {count}\n")

        out.write("\n--- HTTP 状态码分布 ---\n")
        for code, count in sorted_status:
            out.write(f"状态码 {code}: {count} 次\n")

if __name__ == "__main__":
    # 生成测试用的日志样本文件
    test_log_path = "access.log"
    report_output_path = "analysis_summary.txt"

    sample_logs = [
        "192.168.1.1 - GET /index.html 200\n",
        "192.168.1.2 - GET /about 200\n",
        "192.168.1.1 - POST /login 200\n",
        "10.0.0.5 - GET /secret 403\n",
        "192.168.1.1 - GET /notfound 404\n",
        "invalid_corrupted_log_entry\n",  # 测试异常防御
        "192.168.1.3 - GET /api/data 500\n"
    ]
    with open(test_log_path, "w", encoding="utf-8") as f:
        f.writelines(sample_logs)

    # 执行分析与报表导出
    results = analyze_log_file(test_log_path)
    export_report(results, report_output_path)
    print(f"日志分析已完成,分析结果已写入 {report_output_path}")
四、案例三:批量文件分类与规范化重命名脚本(巩固标准库与模块化思维)
新手往往只在课后题里操作字符串和数字,很少触碰操作系统底层的文件系统。利用现代 Python 推荐的 pathlib 库编写一个“下载目录自动整理器”,能够按扩展名将散乱的文件自动迁移到对应的分类子文件夹中,并添加时间前缀。
1. 核心巩固知识点
- 面向对象路径操作:摒弃过时的
os.path.join(),使用pathlib.Path对象进行路径拼接、后缀提取(.suffix)与存在性判断。 - 预演机制(Dry-Run):在真正调用
Path.rename()或shutil.move()之前,提供预览模式,先打印将要执行的操作清单,避免写错代码直接误删或改坏真实文件。 - 字典映射规则:使用字典将文件后缀归纳到固定类别文件夹,实现灵活的扩展策略。
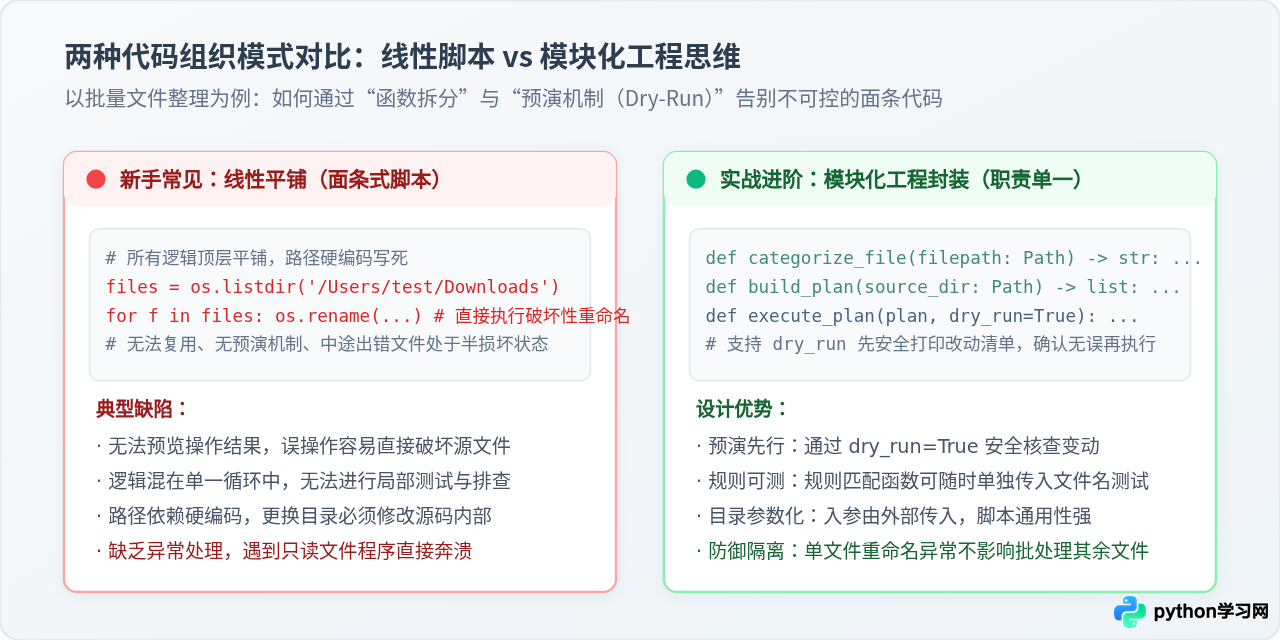
2. 完整可执行代码
# 文件分类脚本:organize_files.py
from pathlib import Path
from typing import Dict, List, Tuple
import datetime

# 扩展名到目标文件夹名称的映射字典
CATEGORY_MAP: Dict[str, str] = {
    ".jpg": "Images",
    ".png": "Images",
    ".gif": "Images",
    ".pdf": "Documents",
    ".docx": "Documents",
    ".txt": "Documents",
    ".zip": "Archives",
    ".tar": "Archives",
    ".mp3": "Media",
    ".mp4": "Media"
}

def plan_organization(target_dir: Path) -> List[Tuple[Path, Path]]:
    """
    扫描目标目录,规划每一个文件的迁移路径
    返回待移动的 (原路径, 新目标路径) 元组列表
    """
    move_plan = []
    today_str = datetime.date.today().strftime("%Y%m%d")

    for item in target_dir.iterdir():
        # 只处理当前目录下的常规文件,忽略已存在的子目录
        if not item.is_file():
            continue

        # 匹配对应类别,未配置的归入 "Others"
        ext = item.suffix.lower()
        sub_folder_name = CATEGORY_MAP.get(ext, "Others")
        category_dir = target_dir / sub_folder_name

        # 新文件名:日期前缀_原文件名
        new_filename = f"{today_str}_{item.name}"
        destination = category_dir / new_filename
        move_plan.append((item, destination))

    return move_plan

def execute_plan(plan: List[Tuple[Path, Path]], dry_run: bool = True):
    """
    执行文件迁移计划
    dry_run=True 时仅模拟打印,不产生真实磁盘修改
    """
    if not plan:
        print("未发现需要整理的文件。")
        return

    mode_label = "[预演模式 - DRY RUN]" if dry_run else "[执行模式 - LIVE RUN]"
    print(f"\n开始执行文件整理,当前模式:{mode_label}")

    for src, dst in plan:
        if dry_run:
            print(f"[PREVIEW] {src.name} -> {dst.parent.name}/{dst.name}")
        else:
            # 确保目标子目录存在
            dst.parent.mkdir(parents=True, exist_ok=True)
            # 目标文件若已存在则给出警示
            if dst.exists():
                print(f"[SKIP] 目标文件已存在,跳过: {dst.name}")
                continue
            src.rename(dst)
            print(f"[MOVED] {src.name} -> {dst.relative_to(src.parent.parent)}")

if __name__ == "__main__":
    # 创建模拟的测试沙盒目录
    test_sandbox = Path("demo_workspace")
    test_sandbox.mkdir(exist_ok=True)

    # 生成若干临时测试文件
    (test_sandbox / "sample_contract.pdf").write_text("dummy contract")
    (test_sandbox / "photo_travel.jpg").write_text("dummy photo")
    (test_sandbox / "todo_notes.txt").write_text("dummy notes")
    (test_sandbox / "archive_backup.zip").write_text("dummy zip")

    # 第一阶段:安全预演(仅打印计划,不改动文件)
    plan = plan_organization(test_sandbox)
    execute_plan(plan, dry_run=True)

    # 第二阶段:确认无误后真正落地执行
    execute_plan(plan, dry_run=False)
初学者容易使用字符串加号(如 path + "/" + filename)处理文件路径。不同操作系统的路径分隔符不同(Windows 为反斜杠 \,Linux/macOS 为正斜杠 /)。统一使用 pathlib.Path 的斜杠运算符 parent_dir / child_name,不仅优雅而且跨平台兼容。
五、案例四:待办事项管理器(巩固数据持久化与模块化拆分)
前三个案例中,数据要么停留在内存中随程序关闭而丢失,要么只是简单追加写入文本。该案例通过 Python 标准库的 json 模块,构建一个带结构化本地持久化存储的待办事项管理系统(Todo CLI),掌握数据在内存字典与本地磁盘文件之间的双向转换。
1. 核心巩固知识点
- JSON 序列化与反序列化:掌握
json.load()(从文件句柄反序列化为 Python 对象)与json.dump()(将 Python 列表字典序列化并写入文件)的使用。 - 函数单一职责:严格将业务逻辑细分为读取、写入、新增、列举、状态翻转等纯函数,避免在一个函数中混杂多种职责。
- 时间戳与状态模型:利用每个任务的唯一自增 ID 或生成时间维护任务状态(完成/未完成)。
2. 完整可执行代码
# 待办任务管理器:todo_manager.py
import json
from pathlib import Path
from typing import List, Dict
import datetime

DATA_FILE = Path("tasks_db.json")

def load_tasks() -> List[Dict]:
    """从本地读取任务列表,若文件不存在则返回空列表"""
    if not DATA_FILE.exists():
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, OSError):
        print("【警告】本地数据损坏,将重新初始化。")
        return []

def save_tasks(tasks: List[Dict]) -> None:
    """将任务列表持久化写入本地 JSON 文件"""
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        # indent=2 使生成的 JSON 便于人类阅读,ensure_ascii=False 正常保存中文
        json.dump(tasks, f, indent=2, ensure_ascii=False)

def add_task(title: str) -> None:
    """新增一条待办任务"""
    tasks = load_tasks()
    # 生成递增 ID
    next_id = max([t["id"] for t in tasks], default=0) + 1
    new_item = {
        "id": next_id,
        "title": title,
        "completed": False,
        "created_at": datetime.datetime.now().strftime("%Y-%m-%d %H:%M")
    }
    tasks.append(new_item)
    save_tasks(tasks)
    print(f"【成功】已创建任务 [#{next_id}]:{title}")

def list_tasks() -> None:
    """展示所有任务及其完成状态"""
    tasks = load_tasks()
    if not tasks:
        print("当前没有任何待办任务!")
        return

    print("\n=== 我的任务清单 ===")
    for t in tasks:
        status_tag = "[✔ 已完成]" if t["completed"] else "[  待处理]"
        print(f"{t['id']:>2}. {status_tag} {t['title']} (创建于: {t['created_at']})")

def toggle_task(task_id: int) -> None:
    """切换任务的完成状态"""
    tasks = load_tasks()
    for t in tasks:
        if t["id"] == task_id:
            t["completed"] = not t["completed"]
            save_tasks(tasks)
            state_text = "已完成" if t["completed"] else "待处理"
            print(f"【更新】任务 [#{task_id}] 状态已更改为:{state_text}")
            return
    print(f"【错误】未找到编号为 {task_id} 的任务!")

def main():
    while True:
        print("\n=== 极简待办事项 (Todo CLI) ===")
        print("1. 查看任务列表")
        print("2. 添加新任务")
        print("3. 标记完成/待处理")
        print("4. 退出")
        choice = input("请选择操作 (1-4): ").strip()

        if choice == "1":
            list_tasks()
        elif choice == "2":
            title = input("请输入任务内容: ").strip()
            if title:
                add_task(title)
            else:
                print("【提示】任务内容不能为空!")
        elif choice == "3":
            tid_str = input("请输入要切换状态的任务编号: ").strip()
            try:
                tid = int(tid_str)
                toggle_task(tid)
            except ValueError:
                print("【错误】请输入有效的数字编号!")
        elif choice == "4":
            print("数据已安全保存,感谢使用!")
            break
        else:
            print("【提示】无效输入,请重新选择。")

if __name__ == "__main__":
    main()
六、实战过程中的常见误区与巩固闭环
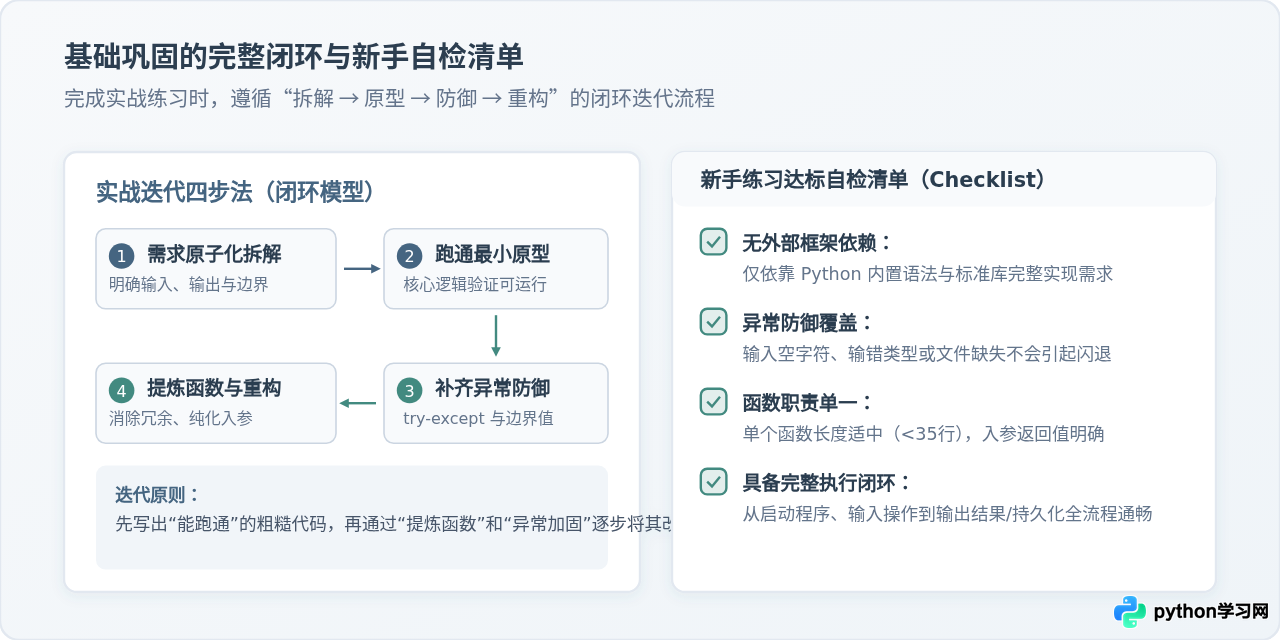
完成以上 4 个小项目的练习后,初学者已经实际覆盖了核心数据类型、容器嵌套遍历、字符串解析、文件流操作、异常捕获、pathlib 与 json 标准库的运用。在实际编写与练习过程中,请特别留意以下几个容易走弯路的误区:
| 常见新手误区 | 典型负面表现 | 推荐纠偏策略 |
|---|---|---|
| 过早引入重型第三方库 | 写个爬虫引入庞大框架,结果 90% 的精力都在研究框架配置与报错,原生语法依然不会用。 | 前期的 3-5 个练习项目坚持只用 Python 内置库(sys、os、pathlib、json、math),先吃透标准库。 |
| 只阅读代码不亲手敲 | 看别人代码觉得“都会了”,一关上浏览器自己从零建文件连主入口和循环都写不顺畅。 | 只看需求和输入输出定义,关闭参考代码,完全从零建立 .py 文件自主敲完并测试运行。 |
| 遇到报错直接推翻重写 | 一看到终端红字报错就恐慌,全部删掉重新搜答案,丧失追踪 Bug 的机会。 | 仔细看 Traceback 的最后一行(异常类型与错误行号),学会利用 print() 打印关键变量,逐步缩小排查范围。 |
| 把所有逻辑堆在一个函数 | 一个 main() 函数写了两百行,既做输入又做计算还做文件写入,排查问题无从下手。 |
坚持模块化:一个函数只做一件事,长度尽量控制在 25-35 行以内,输入输出依靠参数和返回值流动。 |
七、总结:如何规划你接下来的实战练习
巩固编程语言基础的本质,是将抽象的语法规则转化为解决具体现实问题的肌肉记忆。对于 Python 新手而言,千万不要把学习过程变成孤立记忆 API 名字的死记硬背。
推荐按照以下节奏推进练习:
- 第一阶段:先不抄任何现成代码,根据本文给出的四个案例的需求描述(记账、日志分析、文件整理、待办持久化),尝试在自己本地新建工程,独立写出能够正常运行的第一版代码。
- 第二阶段:给这四个工具各增加一项新功能。例如:为记账器增加“按月份筛选”功能,为日志分析器增加“正则匹配提取 URL 参数”功能,为待办管理器增加“按截止时间排序”功能。
- 第三阶段:为每个函数补齐异常处理和参数校验,确保在用户恶意输入或外部文件损坏时,程序能够给出友好的提示信息而不是直接闪退。
只要脚踏实地走完这套闭环,你所积累的就不仅是几门语法概念,而是真正的工程化代码组织能力,随后无论转向 Web 开发、自动化运维还是数据分析,都会感到游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









