

Scrapy框架教程:构建高效稳定的Python大规模爬虫项目
本教程针对海量数据采集场景,系统讲解如何基于Python Scrapy框架构建高并发、高可用的大规模爬虫项目。深入剖析Twisted异步事件循环机制、核心并发参数调优、分布式布隆过滤器去重、智能代理中间件及异步无阻塞管道设计。
一、架构总览:Scrapy 异步引擎与大规模数据流转
理解 Scrapy 的底层运行原理,是大规模爬虫调优的第一步。与使用 requests 结合多线程或多进程的传统脚本不同,Scrapy 建立在 Twisted 异步事件循环(Reactor) 之上。在 Twisted 反应器中,所有的网络套接字(Socket)读写均注册为非阻塞事件,单线程即可同时维系上千个并发连接,避免了操作系统在成百上千个线程间来回切换产生的上下文开销。
在生产环境中,整个系统由 Scrapy Engine(引擎) 作为中央枢纽,协调以下五个核心组件高效闭环运转:
- Spiders(爬虫逻辑类):负责产出初始请求(Seed Requests),解析响应文本,抽取业务字段并构造数据实体(Item),同时提取新链接派发新请求。
- Scheduler(调度器):统一维护待抓取请求队列,并负责请求的指纹比对与去重,决定何时将请求送入引擎。
- Downloader(下载器):基于异步 HTTP/HTTPS 协议栈完成网络资源的实际拉取,生成 Response 对象并回传给引擎。
- Item Pipeline(数据管道):对 Spider 输出的 Item 执行数据清洗、字段校验、去重和持久化入库操作。
- Downloader & Spider Middlewares(中间件机制):在请求发送前和响应返回后提供钩子拦截点,用于无侵入式注入代理 IP、轮换 User-Agent、重试异常请求等。
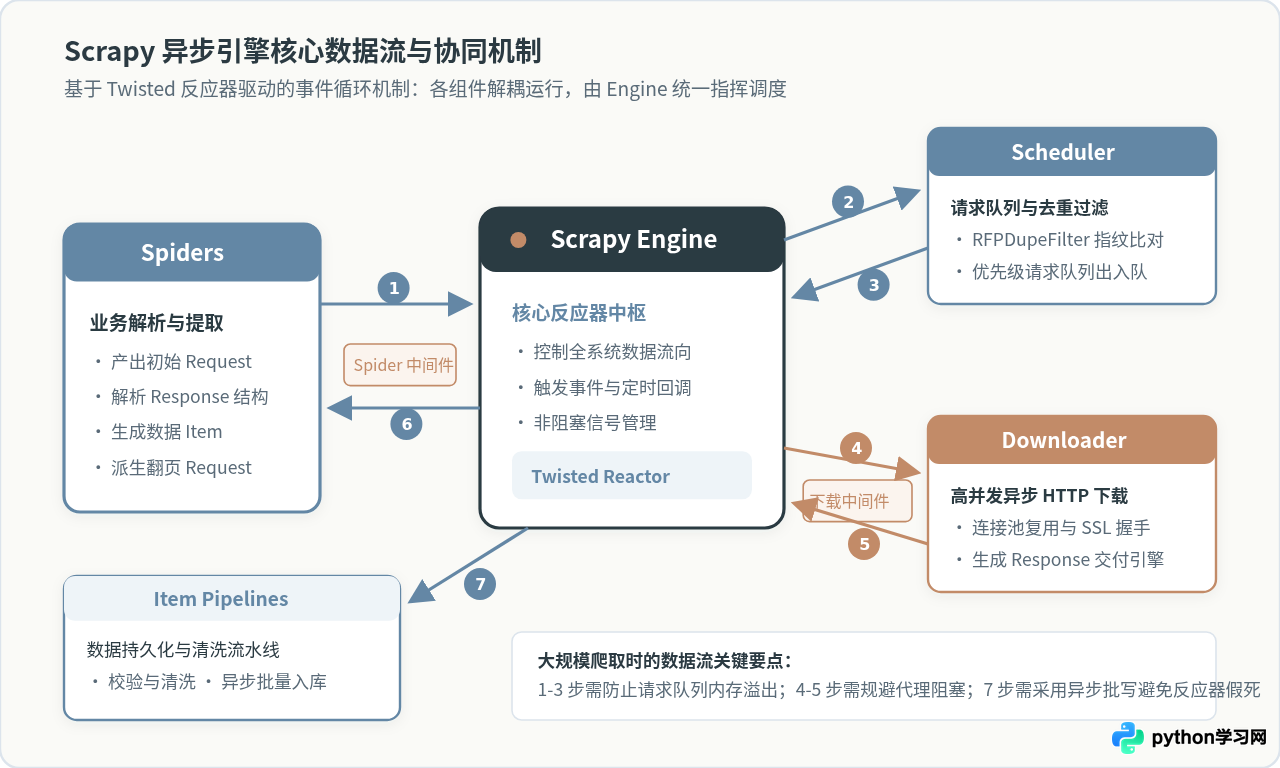
如上图所示,大规模爬取过程中的数据流存在明确的因果链条(1 至 8 步)。必须特别注意的是,所有组件之间的交互都必须维持非阻塞特性。一旦在 Spider 解析函数或 Item Pipeline 中执行了耗时的同步阻塞代码(如使用 time.sleep() 或同步执行数据库插入),整个 Twisted 反应器都会被暂停挂起,导致所有并发下载任务全部停顿,吞吐量断崖式下跌。
二、规范化工程设计与高可用 Spider 编写
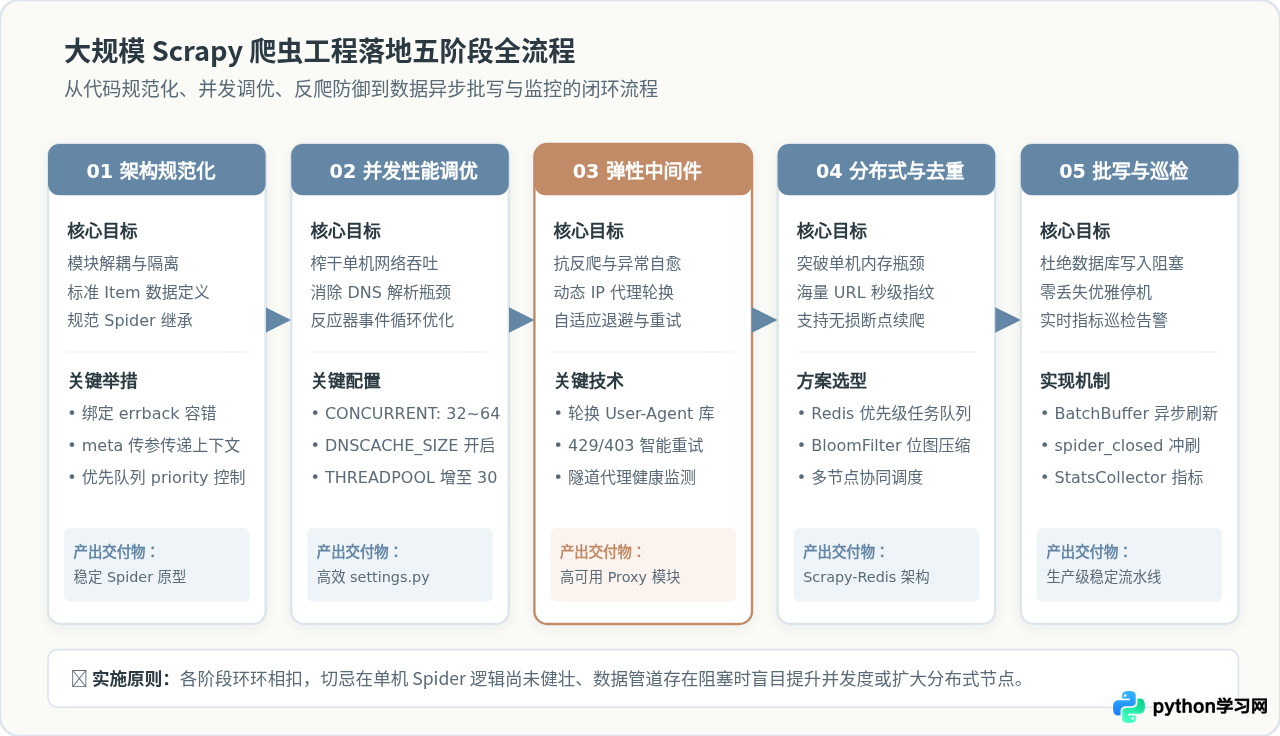
在大规模工程中,代码结构的规范性直接决定了系统的可维护性与容错边界。一个标准的 Scrapy 大规模项目应当采用严格的分层目录架构,确保爬取逻辑、数据结构、中间件策略和持久化通道彻底解耦。
1. 工业级项目标准目录布局
cluster_crawler/
├── cluster_crawler/
│   ├── __init__.py
│   ├── items.py              # 明确定义强类型字段与数据契约
│   ├── middlewares.py        # 动态代理池、User-Agent 轮换及退避重试
│   ├── pipelines.py          # 异步批量持久化与数据清洗
│   ├── settings.py           # 并发调优、扩展与资源限制配置
│   └── spiders/
│       ├── __init__.py
│       └── commerce_spider.py # 核心业务 Spider 实现
├── scrapy.cfg                 # 部署配置文件
└── requirements.txt
2. 具备完善容错机制的 Spider 编写范式
编写大规模爬虫时,Spider 类切忌将网络重试、参数解析与状态管理混杂在一起。必须规范利用 Request.meta 传递上下文,设置 priority 控制队列调度次序,并通过显式声明 errback 捕获网络超时或连接中断等异常:
import scrapy
from cluster_crawler.items import ProductItem
from twisted.python.failure import Failure

class CommerceSpider(scrapy.Spider):
    name = "commerce_spider"
    allowed_domains = ["example.com"]

    def start_requests(self):
        base_url = "https://example.com/products?page="
        # 预先生成初始列表页请求,分配标准优先级
        for page in range(1, 101):
            yield scrapy.Request(
                url=f"{base_url}{page}",
                callback=self.parse_list,
                errback=self.handle_error,
                priority=10,
                meta={"page_index": page}
            )

    def parse_list(self, response):
        # 1. 抽取详情页链接并提高抓取优先级,确保深度数据快速回流
        detail_links = response.css("div.product-card a.detail::attr(href)").getall()
        for link in detail_links:
            full_url = response.urljoin(link)
            yield scrapy.Request(
                url=full_url,
                callback=self.parse_detail,
                errback=self.handle_error,
                priority=20,  # 详情页优先级高于翻页,控制内存中待处理堆积量
                meta={"source_page": response.meta["page_index"]}
            )

    def parse_detail(self, response):
        # 2. 字段抽取并填充 Item
        item = ProductItem()
        item["sku_id"] = response.css("span#sku::text").get(default="").strip()
        item["title"] = response.css("h1.title::text").get(default="").strip()
        item["price"] = response.css("span.price::text").re_first(r"\d+\.?\d*")
        item["crawl_url"] = response.url
        yield item

    def handle_error(self, failure: Failure):
        # 3. 错误统一拦截,记录失败指标
self.logger.error(f"Request failed: {failure.request.url}, Trace: {failure.getErrorMessage()}")priority=20),可以让系统尽快消化详情页产出 Item,保持内存队列平稳。
三、吞吐最大化:关键并发与网络性能调优
Scrapy 的默认配置出于对目标服务器的礼貌性保护,参数设置相对保守(如默认 16 并发)。在合法授权或面对高承载的大型平台进行海量采集时,必须系统化调优 settings.py 中的并发、DNS 解析和事件循环参数。
| 配置项名称 | 默认值 | 推荐生产优化值 | 调优目的与作用机制 |
|---|---|---|---|
CONCURRENT_REQUESTS |
16 | 64 ~ 128 | Scrapy Downloader 同时维持的最大并行下载请求总数。 |
CONCURRENT_REQUESTS_PER_DOMAIN |
8 | 32 ~ 64 | 针对单域名并发上限。在有多出口 IP 代理池保护下可适度上调。 |
DOWNLOAD_TIMEOUT |
180 | 15 ~ 25 | 超时剔除阈值。大规模爬虫切忌等待过长,应快速超时并交由重试机制换 IP 重试。 |
REACTOR_THREADPOOL_MAXSIZE |
10 | 30 ~ 50 | Twisted 处理 DNS 解析及磁盘线程池大小。防止海量请求在 DNS 阶段排队。 |
DNSCACHE_ENABLED |
True | True | 开启内存 DNS 缓存。对固定域名抓取至关重要,规避操作系统级网络解析延迟。 |
DNSCACHE_SIZE |
10000 | 50000 | 增大 DNS 缓存条目上限,保证多域名爬取时不频繁发生缓存替换。 |
COOKIES_ENABLED |
True | False (按需) | 无需会话保持的纯公共页面禁用 Cookie,可显著削减内存与 HTTP 请求头体积。 |
高性能 settings.py 推荐模版
# settings.py 并发核心优化
CONCURRENT_REQUESTS = 64
CONCURRENT_REQUESTS_PER_DOMAIN = 32
DOWNLOAD_TIMEOUT = 20
RETRY_TIMES = 3

# DNS 解析提速
REACTOR_THREADPOOL_MAXSIZE = 40
DNSCACHE_ENABLED = True
DNSCACHE_SIZE = 50000

# 禁用不必要的默认扩展,减少处理链耗时
COOKIES_ENABLED = False
ROBOTSTXT_OBEY = False
TELNETCONSOLE_ENABLED = False

# 开启底层反应器优化 (可选 uvloop,需预先 pip install uvloop)
# TWISTED_REACTOR = 'twisted.internet.asyncioreactor.AsyncioSelectorReactor'CONCURRENT_REQUESTS 设置为 256 或 512,往往会导致本机 CPU 软中断升高、带宽占满出现大量 TimeoutError,甚至引起目标机直接拉黑整个 IP 网段。建议根据出口带宽、代理 IP 池吞吐上限及机器核心数逐步阶梯式测试,寻找到响应延迟不发生劣化时的最佳临界点。
四、海量请求调度与分布式布隆去重
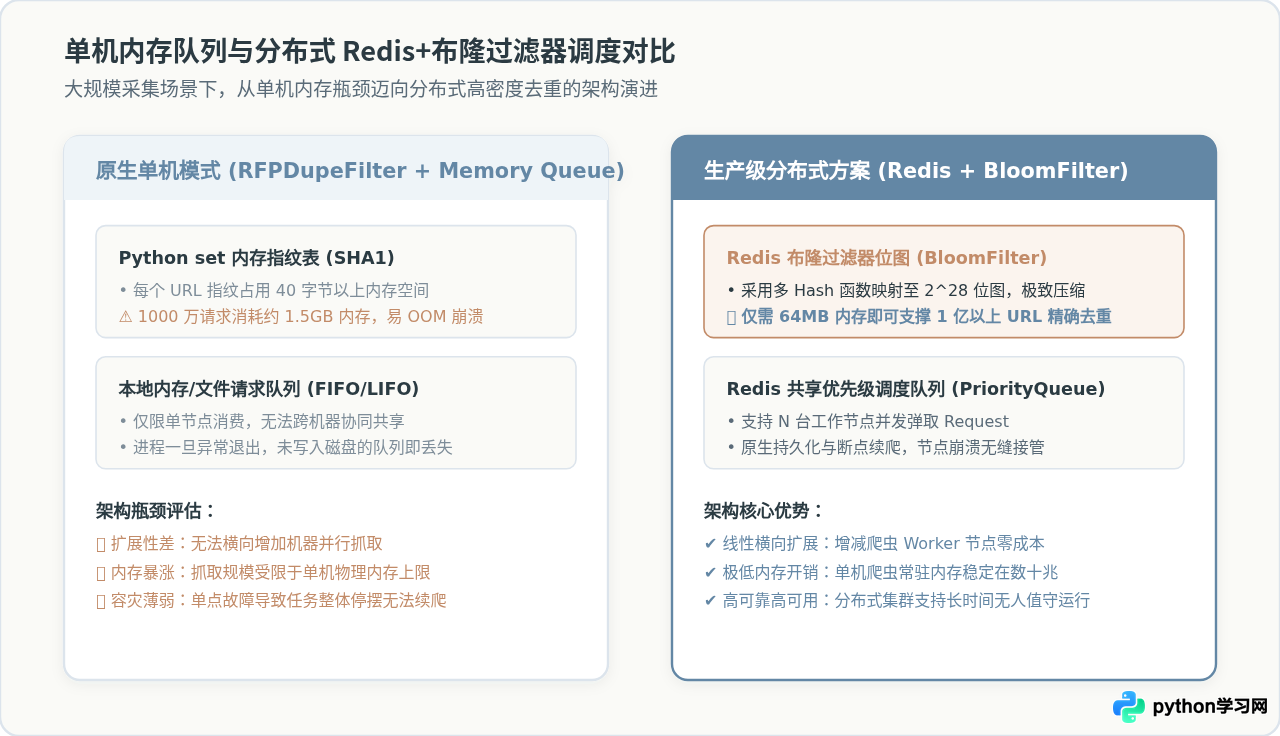
当单次爬取任务涉及的 URL 数量达到数千万或数亿级别时,Scrapy 原生的内存调度与去重机制将成为致命瓶颈。默认情况下,Scrapy 的 RFPDupeFilter 会将每个已访问请求的 160 位 SHA1 字符串保存在 Python 的 set 集合中。
在 Python 底层,由于集合哈希表扩容及对象指针开销,存储 1000 万条 URL 指纹将消耗约 1.2GB~1.8GB 纯物理内存;一旦突破 5000 万条,单机进程将极易触碰系统内存上限并被内核强制终止(OOM)。
1. Redis + BloomFilter 去重机制
解决海量去重与多节点协同的最佳实践,是将请求调度队列与去重过滤转移至外部高性能 Redis 集群。通过引入 布隆过滤器(BloomFilter),利用位图(BitMap)和多个独立哈希函数将 URL 指纹压缩至极小空间。
在典型配置下,一个大小为 2^28 位(即仅 32MB 内存)的布隆过滤器位图,在允许 0.001(千分之一)的微小误判率下,可轻松容纳 2000 万个请求去重;若配置 64MB 位图,即可毫无压力地应对超过 1 亿级别 的海量 URL 去重。
2. 接入 Scrapy-Redis 与 BloomFilter 关键配置
# settings.py 集成分布式调度与 BloomFilter 去重组件
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
DUPEFILTER_CLASS = "scrapy_redis_bloomfilter.dupefilter.RFPDupeFilter"

# 布隆过滤器容量与散列函数深度配置
BLOOMFILTER_HASH_NUMBER = 6       # 使用 6 个散列函数
BLOOMFILTER_BIT = 28              # 2^28 bit 空间 (约 32MB 内存)
DUPEFILTER_DEBUG = False

# 保持调度队列持久化,支持异常中断后恢复进度
SCHEDULER_PERSIST = True
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.PriorityQueue"

# Redis 连接配置
REDIS_HOST = "10.0.0.12"
REDIS_PORT = 6379
REDIS_PARAMS = {'password': 'crawler_secure_pass', 'db': 1}
五、稳定性防护:下载中间件与反爬自适应处理
大规模爬取是攻防持续对抗的过程。当爬虫以几十甚至上百 QPS 访问目标域名时,极易触发目标服务器的反爬风控规则,典型表现为频繁返回 HTTP 403 Forbidden、HTTP 429 Too Many Requests 以及 HTTP 503 Service Unavailable。
为了保证爬虫系统连续稳定运转而不被中断,必须在 Downloader Middleware 中构建具备 动态身份伪装、代理故障转移 与 智能退避重试 功能的防护屏障。
高可用弹性下载中间件代码实现
import random
import time
from scrapy.downloadermiddlewares.retry import RetryMiddleware
from scrapy.utils.response import response_status_message

class ResilientCrawlerMiddleware(RetryMiddleware):
    def __init__(self, settings):
        super().__init__(settings)
        # 预加载通用主流浏览器 User-Agent 库
        self.user_agents = [
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36"
        ]
        # 动态隧道代理网关或代理池地址
        self.proxy_endpoint = settings.get("PROXY_ENDPOINT", "http://tunnel-proxy.corp.internal:8080")

    def process_request(self, request, spider):
        # 1. 动态注入随机 User-Agent 与出口代理
        request.headers["User-Agent"] = random.choice(self.user_agents)
        request.meta["proxy"] = self.proxy_endpoint

        # 为需要保持会话的请求添加动态指纹
        request.headers["Accept-Language"] = "zh-CN,zh;q=0.9,en;q=0.8"

    def process_response(self, request, response, spider):
        # 2. 识别风控状态码 (403 封禁 / 429 频控超限)
        if response.status in [403, 429, 503]:
            retries = request.meta.get("retry_times", 0) + 1
            if retries <= self.max_retry_times:
                # 实施指数退避延迟(例如:1s, 2s, 4s...)
                delay = 2 ** (retries - 1)
                spider.logger.warning(
                    f"Hit status {response.status} on {request.url}. Backing off for {delay}s (Retry {retries}/{self.max_retry_times})"
                )
                time.sleep(delay)
                return self._retry(request, response_status_message(response.status), spider)
        return response

    def process_exception(self, request, exception, spider):
        # 3. 处理网络超时、DNS 失败等底层异常
        spider.logger.error(f"Network exception on {request.url}: {exception}")
        return self._retry(request, str(exception), spider)
六、无阻塞持久化:高性能异步数据管道
在大规模爬虫项目中,最容易被忽视却破坏力极强的架构缺陷,是在 Item Pipeline 中进行同步数据库写入。
例如,如果在 process_item 方法中直接调用 pymysql.connect().cursor().execute(),由于网络 I/O 阻塞,单次操作耗时通常在 5~50 毫秒之间。在这几十毫秒内,Twisted 反应器的单线程事件循环无法继续调度任何下载任务。当并发量达到 64 时,整个系统的网络下载器会频繁陷入等待状态,抓取速率骤降 90% 以上。
异步批量聚合写入 Pipeline 设计
标准解决方案是采用 内存缓冲区批量提交(Batch Flush) 机制,配合定时器或数量阈值聚合提交;或者使用 Twisted 原生支持的 twisted.enterprise.adbapi 异步线程池进行无阻塞数据库持久化。
import logging
from scrapy import signals

class BatchAsyncPipeline:
    # 高吞吐批量持久化管道:汇聚内存批量达到阈值或爬虫终止时触发批量入库,绝不阻塞 Reactor
    def __init__(self, batch_size=500):
        self.batch_size = batch_size
        self.buffer = []
        self.logger = logging.getLogger(__name__)

    @classmethod
    def from_crawler(cls, crawler):
        pipeline = cls(batch_size=crawler.settings.getint("DB_BATCH_SIZE", 500))
        # 绑定爬虫关闭信号,确保退出时缓冲区残留数据全部刷盘
        crawler.signals.connect(pipeline.spider_closed, signal=signals.spider_closed)
        return pipeline

    def process_item(self, item, spider):
        self.buffer.append(dict(item))
        if len(self.buffer) >= self.batch_size:
            self._flush(spider)
        return item

    def _flush(self, spider):
        if not self.buffer:
            return
        items_to_save = self.buffer.copy()
        self.buffer.clear()

        try:
            # 执行批量入库 (例如 MongoDB insert_many 或 MySQL executemany)
            self.logger.info(f"Flushing {len(items_to_save)} items to persistence storage...")
            # db_client.collection.insert_many(items_to_save, ordered=False)
        except Exception as e:
            self.logger.error(f"Database batch insert error: {e}")

    def spider_closed(self, spider):
        # 爬虫结束前做最后一次清理冲刷,杜绝遗漏
        self._flush(spider)
        self.logger.info("BatchAsyncPipeline closed gracefully, all buffers flushed.")
七、运维监控与工程健康度巡检
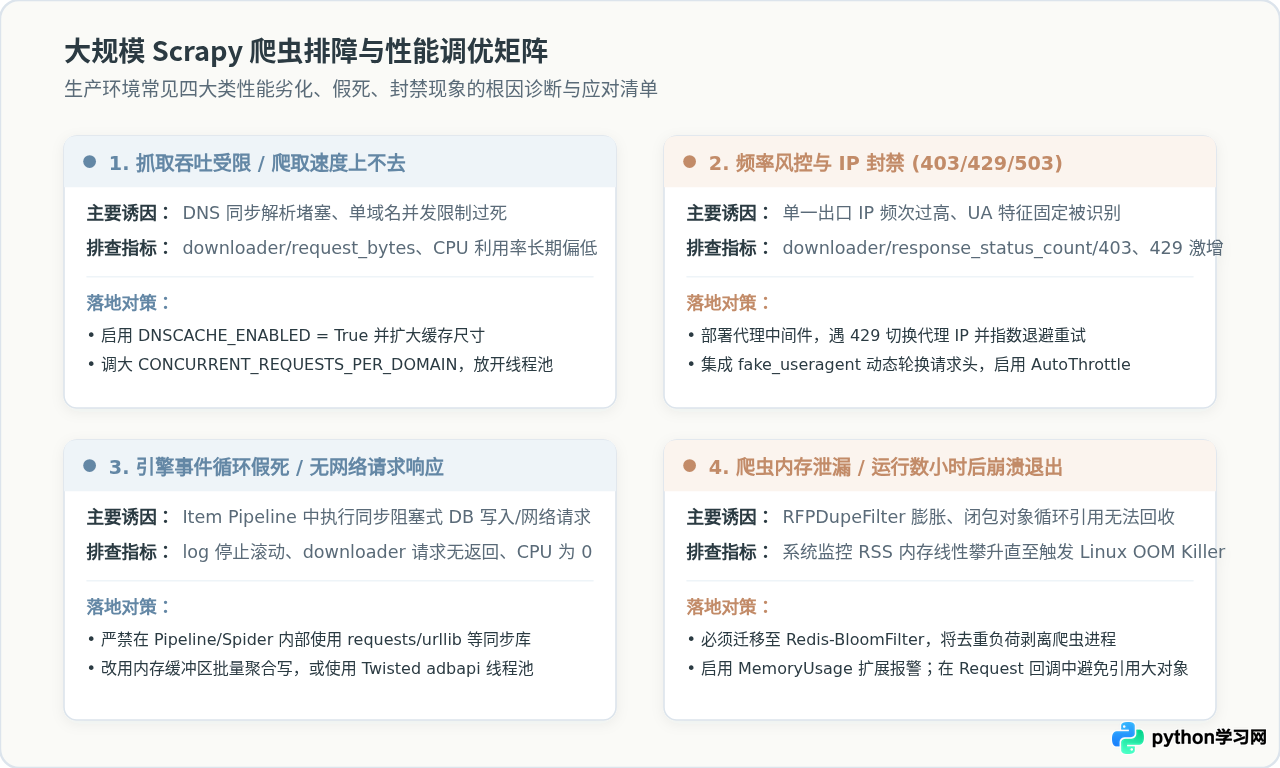
在生产环境中部署长期运行的大规模爬虫,监控指标的收集和故障排查至关重要。Scrapy 内部自带了 StatsCollector,会在爬虫运行期间统计请求吞吐量、响应状态码分布和解析异常数量。
1. 核心监控指标含义与健康基线
item_scraped_count / min(数据入库速率):核心生产力指标。若该数值持续下降而网络请求数未减,说明抓取规则可能失效或遭遇反爬重定向。downloader/response_status_count/200:正常响应比例应稳定在 95% 以上。downloader/response_status_count/403 & 429:一旦该类状态码占比超过 3%,必须立刻检查代理池存活率并降低单 IP 抓取速率。memusage/max_rss:常驻内存占用。若随时间呈严格线性增长,应重点排查 Spider 类变量中是否存在未释放的列表累加,或将单机去重替换为 Redis-BloomFilter。
2. 生产上线前必备 Checklist
| 巡检维度 | 检查项 | 达标要求 |
|---|---|---|
| 并发与资源 | REACTOR_THREADPOOL_MAXSIZE 与 DNS 缓存 | DNSCACHE 已启用,线程池已扩大至 30 以上,消除解析排队。 |
| 内存安全性 | 千万级 URL 去重选型 | 单机任务内存稳定;亿级任务已切换至 Redis BloomFilter,杜绝 OOM。 |
| 反爬防护力 | Downloader Middleware 代理与重试 | 具备 403/429 指数退避重试,User-Agent 具备随机轮换池。 |
| 持久化稳定性 | Item Pipeline 异步批量写入 | 严禁同步单条写库;已实现批量写入并绑定 spider_closed 冲刷信号。 |
| 日志与告警 | 异常日志分级与自动停止 | 配置 CLOSESPIDER_ERRORCOUNT,当异常达到阈值时自动安全停机。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









