

Python range对象为什么也是序列?惰性求值与内存优势
深入解析Python中range对象为什么属于不可变序列而非迭代器。通过剖析CPython底层内存结构、惰性算术通项映射、O(1)随机索引与包含判定算法,全面解答range的高性能与内存优势。
range(1_000_000) 时,不少初学者的第一直觉往往会把它归为迭代器(Iterator)或生成器(Generator),因为它在被遍历时才逐个产生数字且几乎不占内存。然而在 Python 3 的类型规范里,range 对象是一个血统纯正的不可变序列(Sequence),与 tuple、str 处于完全相同的抽象层级。本文将直接回答为什么 range 是序列,解剖其仅有数十字节的紧凑内存模型,并揭示其如何通过数学通项公式实现 O(1) 复杂度的随机索引、切片与高速成员检测。
一、细微却关键的身份认知:range 是序列,而非迭代器
很多开发者容易把“能够按需产出数据的对象”统称为迭代器。但如果我们在交互式终端中做一次类型检测,结果会清晰地打破这种直觉:
# 执行环境:Python 3.9+ 交互式解释器环境
from collections.abc import Sequence, Iterator

r = range(10)

print(isinstance(r, Sequence))  # 示例输出: True
print(isinstance(r, Iterator))  # 示例输出: False
isinstance(r, Iterator) 返回 False 的直接原因在于:range 对象根本没有实现 __next__() 方法。若尝试对它直接执行 next(r),Python 会立刻抛出 TypeError: 'range' object is not an iterator。
在 Python 的抽象容器架构中,迭代器(Iterator)代表的是一种一次性消耗的流式数据源。一旦遍历完成,迭代器便进入耗尽状态,无法回到起点。而序列(Sequence)则代表一个有确定顺序、有明确长度、可以通过整数下标随机访问且支持无限次重复迭代的数据集合。
# 演示可复用性与不可逆耗尽的本质差异
r = range(3)

# 第一次遍历
for item in r:
    pass

# 第二次遍历:完全正常,数据依然存在
print(list(r))  # 示例输出: [0, 1, 2]

# 对比真正的迭代器:
g = (x for x in range(3))
list(g)         # 示例输出: [0, 1, 2]
print(list(g))  # 示例输出: [] (生成器已耗尽,不可重用)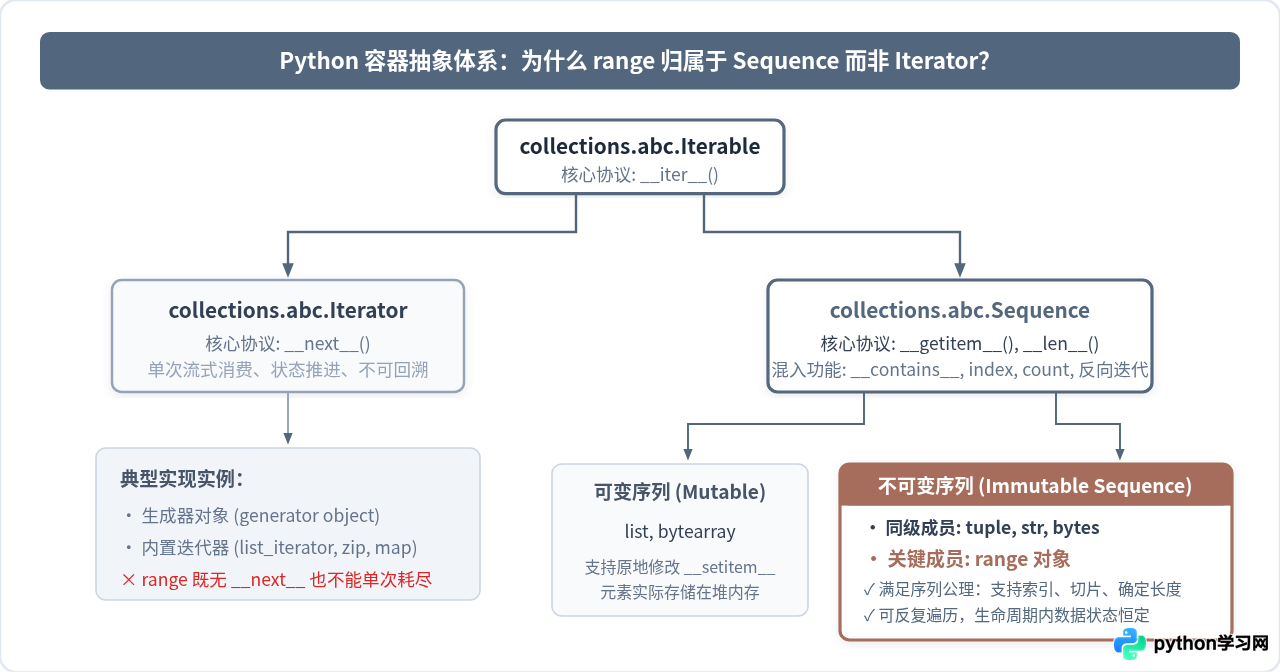
如图 1 所示,range 完整实现了 Sequence 协议所要求的两个核心特殊方法:__len__() 与 __getitem__()。通过继承 Sequence 的混入方法(Mixin Methods),它自然获得了 index()、count()、反向迭代 reversed() 以及序列切片等全部标准行为。
二、惰性求值的本质:公式驱动而非实体指针存储
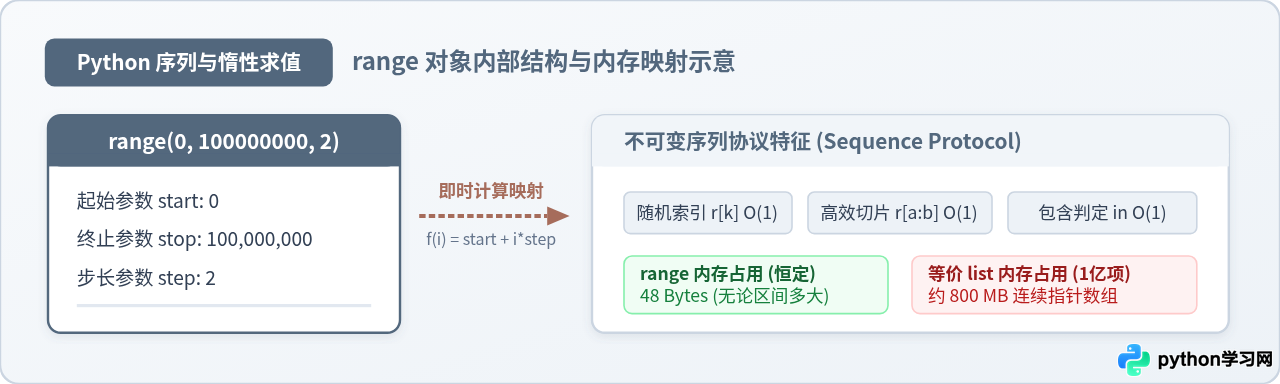
为什么同样是容纳一亿个数字,list 会占用高达几百兆字节内存,而 range 却始终只有 48 个字节?
在 CPython 解释器的底层实现(可查阅源码 Objects/rangeobject.c)中,range 对象对应的结构体 rangeobject 非常紧凑,它在 64 位机器上实质上只维护了极其有限的几个字段:
PyObject_HEAD:包含引用计数(8 字节)和类型指针&PyRange_Type(8 字节);start:序列的起始数值对象指针(8 字节);stop:序列的终止上界数值对象指针(8 字节);step:步长数值对象指针(8 字节);length:预先计算出的序列元素总个数(8 字节)。
这 5 个核心字段在 64 位操作系统中固定占用 48 字节。不论你创建的是 range(10) 还是 range(0, 10**18, 5),它在内存中都仅仅保留这几个数学边界参数,并不会为区间内的任何一个数字单独分配内存空间。
# 验证不同规模下对象的实际内存占用 (sys.getsizeof)
import sys

r_small = range(10)
r_huge = range(0, 100_000_000_000, 2)

print(f"r_small 内存占用: {sys.getsizeof(r_small)} 字节")  # 示例输出: 48 字节
print(f"r_huge  内存占用: {sys.getsizeof(r_huge)} 字节")  # 示例输出: 48 字节

# 作为对比,即使只容纳 100 万项的列表:
lst = list(range(1_000_000))
print(f"100万项列表内存占用: {sys.getsizeof(lst)} 字节")    # 示例输出: 约 8000056 字节 (约 8MB)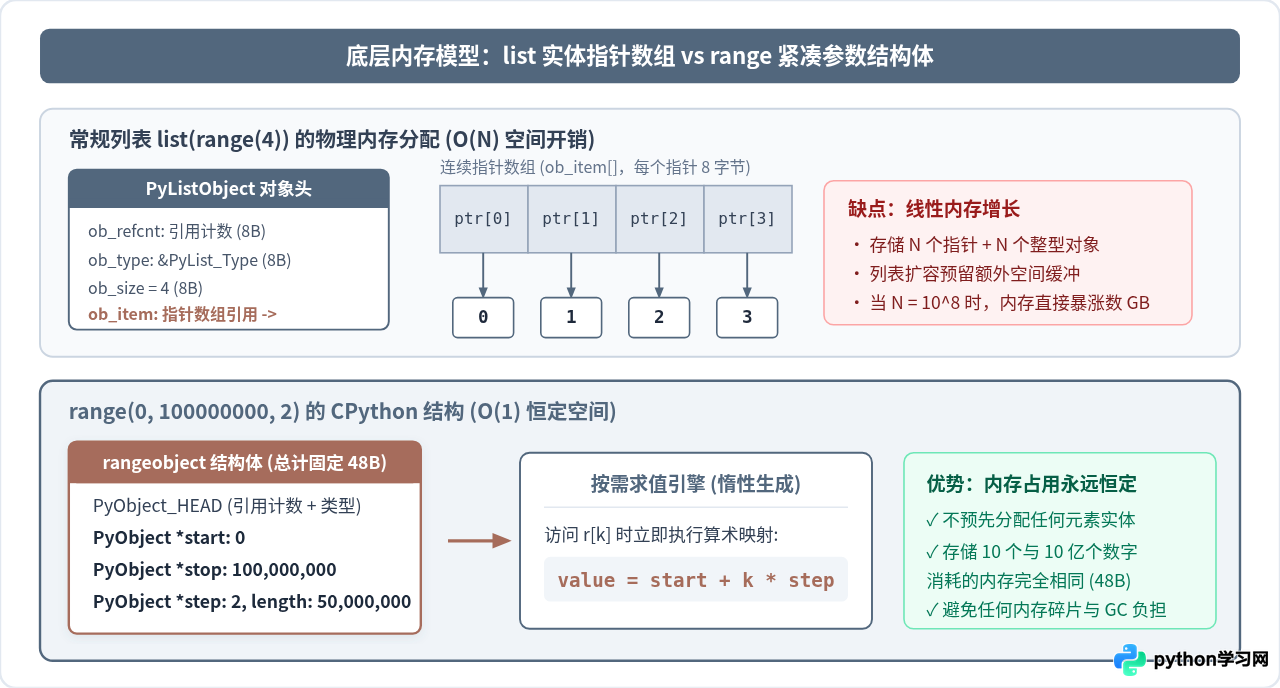
这就是所谓的惰性求值(Lazy Evaluation)与虚拟序列(Virtual Sequence)。列表在内存中铺满了指向真实整数对象的连续指针数组;而 range 则像是一部紧凑的“等差数列计算器”。元素在逻辑上是存在的,但在物理内存中它们并不存在,直到你在遍历或索引访问时明确向它索要,它才立刻依据数学公式实时推导出对应的数值。
三、数学通项带来的性能优势:O(1) 索引、切片与包含检测
许多开发者知道 range 节省内存,但往往低估了它在随机访问与条件查询上的执行效率。因为它是具有严格等差特性的序列,底层不需要像迭代器那样从头“数”到目标位置,而是全部通过代数运算完成。
1. 随机索引访问:直接代入通项公式
当你访问 r[k] 时,CPython 执行的操作不是循环累加,而是先检查 0 <= k < r.length(若 k < 0 则折算为 k + r.length),随后直接调用乘法与加法算术指令:
value = r.start + k * r.step
这一过程与列表寻址同样是纯粹的 O(1) 常数时间复杂度。无论 k 是一百还是十亿,耗时都在数纳秒级别。
2. 切片操作:数学参数的 O(1) 重映射
当对列表进行切片 lst[10:5000:2] 时,Python 会开辟一块新的内存,并逐个把这几千个指针复制过去,时间复杂度与切片长度成正比。但对 range 进行切片时,返回的仍然是一个新的 range 对象:
r = range(0, 100_000_000, 2)
sub_r = r[100:5000:3]
print(sub_r)  # 示例输出: range(200, 10000, 6)
切片过程通过 slice.indices() 方法将子切片区间映射为母序列上的新起点、新终点和新步长,完全零内存拷贝,耗时与切片跨度大小毫无关系。
3. 成员判定 (x in r):从 O(N) 到 O(1) 的质变
在常规列表或生成器中执行 x in obj,底层必须进行线性遍历(Linear Scan),最坏情况下需要比对 N 次。但在 Python 3 的 range 对象中,in 操作被重写为高效的数学验证算法:
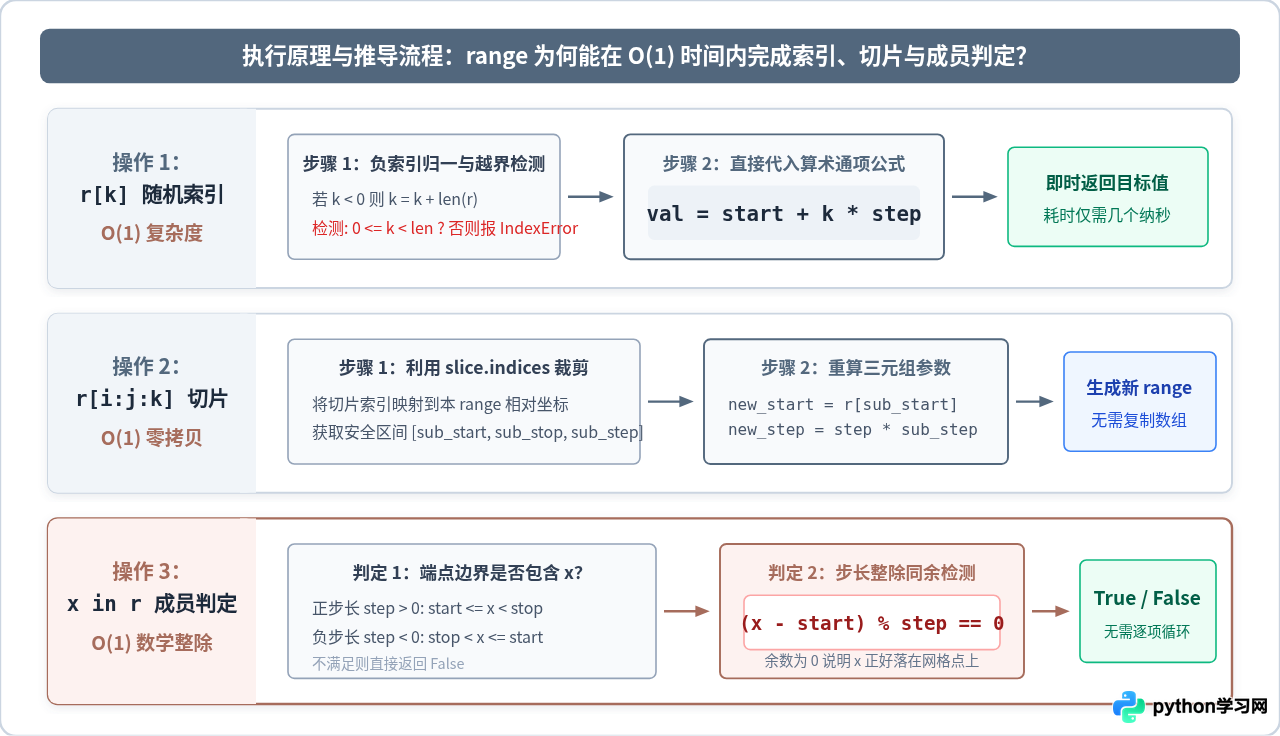
只要满足两项检验:第一,数值 x 位于 [start, stop) 区间内;第二,(x - start) % step == 0。只要能被步长整除,说明 x 必定落在等差数列的离散点上。这种常数时间的整除判定使得在包含数亿项的 range 中查找数字时,耗时与在只包含 5 个数字的 range 中完全一样:
# 演示超大区间内 in 操作的瞬时响应
big_range = range(0, 1_000_000_000_000_000, 3)

# 瞬间完成判定,耗时通常不足 1 微秒:
print(999_999_999_999_998 in big_range)  # 示例输出: False (不能被 3 整除)
print(999_999_999_999_999 in big_range)  # 示例输出: True  (整除且在边界内)
四、边界细节与使用权衡
尽管 range 对象性能出众,但在实际工程运用中仍有几个值得警惕的细节与适用边界:
range(0) == range(2, 1, 3) 判定为 True,因为它们都代表空序列;同理,range(0, 3, 2) == range(0, 4, 2) 亦为 True,因为它们生成的序列均为 [0, 2]。
range 不接受 float 参数。若需要浮点数等步长区间,应使用 numpy.arange()、numpy.linspace() 或自定义生成器函数。
此外,虽然 range 对象的创建和属性查询是 O(1) 的,但如果你要在 for 循环中把 10 亿次循环真正执行完,CPU 依然需要逐次推进并完成 10 亿次指令调度。内存上的“免费”并不等于 CPU 计算上的“免费”。
五、综合对比与总结
为了帮助读者在不同开发场景下准确选型,下表及图 4 对 Python 中最常见的三种迭代与序列工具进行了系统性比对:
| 特性维度 | 列表 (list) | 范围对象 (range) | 生成器 (generator) |
|---|---|---|---|
| 所属类别 | 可变序列 (Mutable Sequence) | 不可变序列 (Immutable Sequence) | 迭代器 (Iterator) |
| 内存占用 | O(N),随项数线性膨胀 | O(1),无论范围多大恒定 48 字节 | O(1),仅保存当前调用栈与局部变量 |
| 遍历可复用性 | 支持,可重复遍历任意多次 | 支持,不可变状态,可无限次复用 | 不支持,单次遍历后立即耗尽 |
| 随机索引与切片 | 支持,切片产生 O(K) 浅拷贝 | 支持,切片产生 O(1) 新 range | 不支持下标语法,需 islice 辅助 |
| 成员检测 (in) | O(N) 线性扫描 | O(1) 数学边界与同余判定 | O(N) 线性扫描且会破坏性消耗元素 |
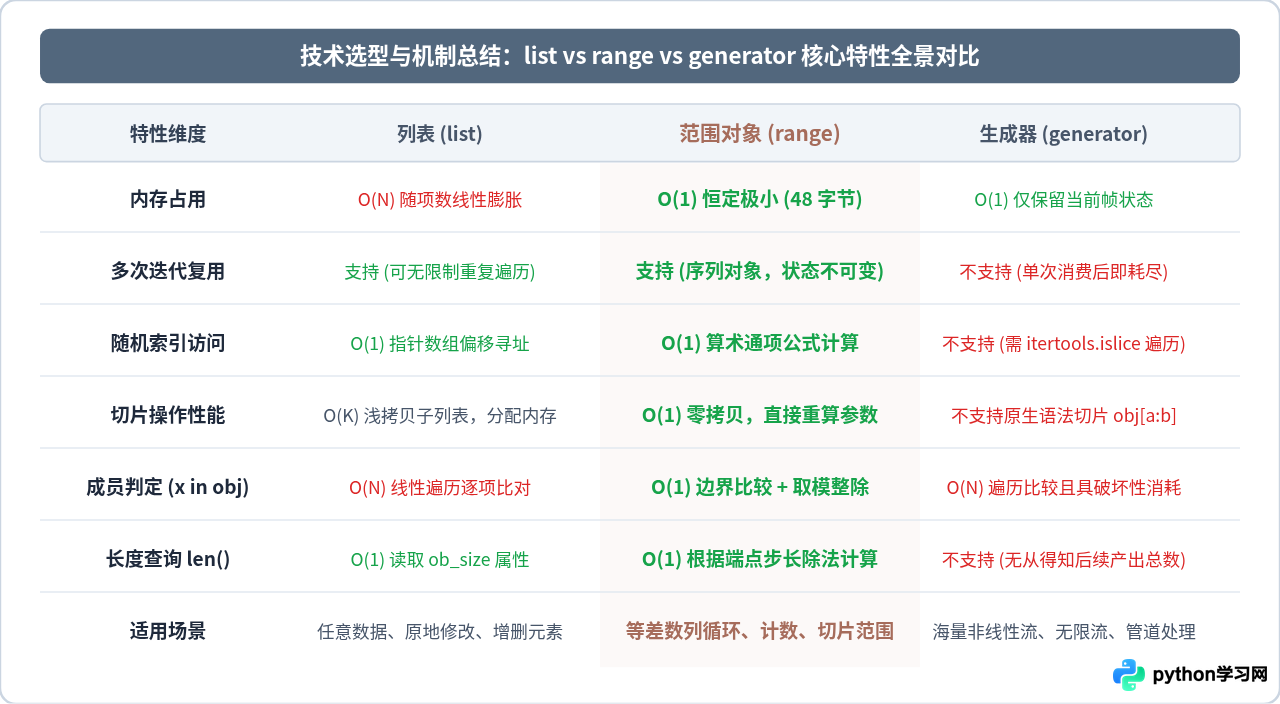
总结而言,Python 3 的 range 对象之所以是序列,是因为它严格遵守了序列协议的语义契约——保证有序、可重复、支持下标准确检索与切片。而它之所以能拥有比拟迭代器的极限内存优势,靠的正是“公式化虚拟序列”的惰性求值思想。理解这一点,不仅能帮助我们写出更省内存的循环,更能让我们深刻体会到面向对象抽象协议在 Python 语言设计中所展现的优雅与克制。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









