

Python字典与列表操作代码汇总:增删改查常用方法
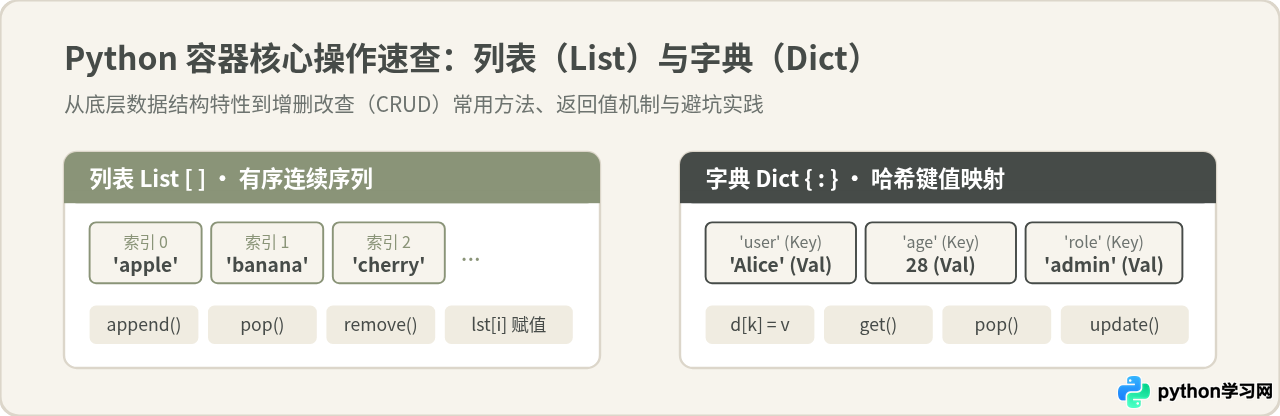
系统汇总Python列表与字典在增加、删除、修改、查询四大维度下的常用操作语法、标准代码示例、返回值机制、时间复杂度与高频避坑实践。
list)与字典(dict)是 Python 中最核心的两大数据结构。列表属于基于连续内存的有序序列,依赖整数下标进行寻址;字典属于基于散列表(Hash Table)的键值对映射,依赖不可变键的哈希值进行极速检索。本文系统汇总两者在“增、删、改、查”四大常用场景下的核心语法、典型代码实现、返回值特征与高频边界避坑规则,帮助读者建立标准、严谨的代码实践方案。
一、列表与字典的底层存储与寻址模型差异
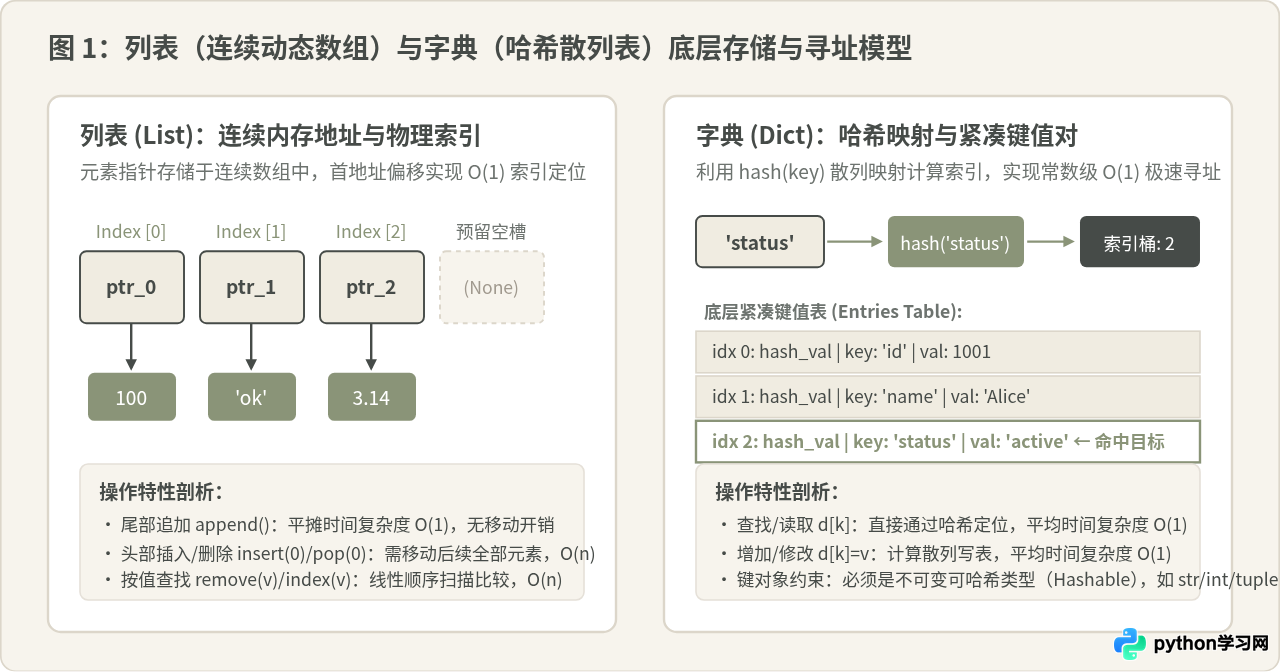
要熟练且不出错地使用列表和字典,首先需要理解两者在底层数据结构上的根本差异。许多初学者在编写代码时经常困惑于“为什么在大列表中使用 in 检查元素会变慢,而在字典中检查键却几乎不受数据规模影响”,这本质上是由它们的内存组织形式决定的。
Python 的列表底层基于连续动态数组实现。列表内保存的是指向具体对象的指针,这些指针在物理内存中依次紧密排列。当通过索引访问元素时(如 lst[0] 或 lst[5]),解释器直接使用首地址加上固定步长的物理偏移量,一步命中目标位置,因此按索引读取的时间复杂度为常数级 O(1)。然而,当在列表头部或中间插入/删除元素时,为了保持连续性,后续的所有指针都必须集体向后或向前搬移一位,时间复杂度退化为 O(n)。
相比之下,Python 字典底层基于散列表(Hash Table)与紧凑键值数组。当存入一个键值对时,Python 首先调用内置函数 hash(key) 计算键的哈希值,然后根据哈希值映射到具体的索引桶中。这种机制允许字典在查找、增加和删除键值对时直接完成散列定位,平均时间复杂度均为 O(1)。代价是字典的键必须是可哈希(不可变)的对象,且哈希机制需要预留一定冗余内存以避免碰撞。
二、列表(List)常用操作:增删改查代码汇总
1. 增加元素(Create)
列表提供了多种增加元素的方法,针对单个追加、批量拼接与指定位置插入有着明确的方法分工:
append(x):将元素x追加到列表末尾。这是最常用的操作,平摊时间复杂度为O(1)。该方法是原地修改,返回值为None。extend(iterable):接收一个可迭代对象,解包并将其中的每个元素依次追加到末尾。等价于原地+=运算。insert(index, x):在指定索引index前插入元素x。由于需要移动插入点之后的所有元素,时间复杂度为O(n)。- 加号拼接(
+):连接两个列表,返回一个全新的列表对象,原列表保持不变。
# 基础列表初始化
fruits = ['apple', 'banana']

# 1. append 追加单个元素(注意返回值为 None)
fruits.append('orange')

# 2. extend 批量追加列表内容
fruits.extend(['grape', 'melon'])

# 3. insert 在指定索引处插入
fruits.insert(1, 'cherry')

# 4. 加号拼接产生新列表
combined = fruits + ['mango']combined 内容为: ['apple', 'cherry', 'banana', 'orange', 'grape', 'melon', 'mango']
2. 删除元素(Delete)
删除操作依据“按索引下标删除”还是“按具体匹配值删除”分为两大阵营:
pop([index]):移除并返回指定索引处的元素。若未传入参数,默认弹出最后一个元素(index=-1)。若索引越界会触发IndexError。del lst[index]:Python 关键字语句,按索引删除元素,支持切片删除(如del lst[1:3])。无返回值。remove(value):从左到右查找并移除首个匹配项value。若列表中不存在该值,会抛出ValueError。clear():清空列表内的全部元素,列表长度变为 0。
nums = [10, 20, 30, 40, 20, 50]

# 1. pop 弹出末尾元素并接收返回值
last_item = nums.pop()       # 弹出 50

# 2. pop 弹出指定下标元素
second_item = nums.pop(1)    # 弹出下标 1 的 20

# 3. remove 移除首个值为 20 的项(建议配合 in 检查)
if 20 in nums:
    nums.remove(20)

# 4. del 按索引删除
del nums[0] # 删掉此时下标 0 的 10second_item: 20
nums 最终内容为: [30, 40]
3. 修改元素(Update)
列表属于可变数据类型(Mutable),支持直接通过下标或切片对指定区间进行内容覆盖与重构:
- 单索引赋值:
lst[index] = new_value,直接覆写指定位置的对象指针。 - 切片赋值:
lst[start:stop] = iterable,可替换一段连续区间,替换长度可以与原区间长度不一致。 - 原地重排:
sort()实现升序或自定义关键字排序,reverse()实现元素首尾颠倒。两者均为原位修改,返回None。
items = ['a', 'b', 'c', 'd', 'e']

# 1. 索引单值修改
items[0] = 'alpha'

# 2. 切片区间替换(将下标 1 到 2 替换为三个新项)
items[1:3] = ['beta', 'gamma', 'delta']

# 3. 原地排序与倒序
num_list = [5, 2, 9, 1]
num_list.sort()              # 变为 [1, 2, 5, 9]
num_list.reverse() # 变为 [9, 5, 2, 1]num_list 内容为: [9, 5, 2, 1]
4. 查询与检索(Retrieve)
列表提供了从正向/反向索引、切片截取到成员包含判断与频次统计的全套查询方案:
- 下标读取:
lst[i]支持正向索引(从0开始)与负向索引(-1代表最后一项)。 - 切片读取:
lst[start:stop:step],提取子列表,产生新对象。 - 成员检测:
x in lst,按顺序遍历比对,时间复杂度O(n)。 - 索引查找:
lst.index(x, [start, stop]),查找首个匹配项索引,查无时抛出ValueError。 - 频次统计:
lst.count(x),统计x在列表中出现的完整次数。
letters = ['a', 'b', 'c', 'b', 'd']

# 1. 下标访问与切片
first = letters[0]           # 'a'
last = letters[-1]           # 'd'
sub = letters[1:4]           # ['b', 'c', 'b']

# 2. 存在性与频次
has_c = 'c' in letters       # True
b_count = letters.count('b') # 2
b_idx = letters.index('b') # 1has_c: True, b_count: 2, b_idx: 1
三、字典(Dict)常用操作:增删改查代码汇总
1. 增加与修改(Create / Update)
在 Python 字典中,“新增键值对”与“修改已有键值”在基础语法上高度统一:
- 直接下标赋值
d[key] = value:若key尚不存在,则新增该条目;若key已存在,则无条件覆盖其旧值。 update([other]):接收另一个字典或键值对迭代器,批量合并至当前字典。重复键将被覆盖。setdefault(key, default):若key存在,则直接返回其当前值且不作修改;若不存在,则将key: default写入字典并返回default。常用于分组累加初始化。- 字典合并运算符(Python 3.9+):
d1 | d2生成新字典,d1 |= d2原地就地合并更新。
user = {'id': 101, 'name': 'Alice'}

# 1. 下标赋值:增加新键与修改已有键
user['role'] = 'admin'       # 键不存在 -> 新增
user['name'] = 'Alice W.'    # 键已存在 -> 修改更新

# 2. update 批量合并
user.update({'city': 'Beijing', 'status': 'active'})

# 3. setdefault 安全初始化(若已存在则不动)
user.setdefault('status', 'offline') # 依然保持 'active'
user.setdefault('tags', []).append('developer') # 初始化列表并追加2. 删除条目(Delete)
字典提供了对条目的精准提取、批量剔除与清空机制:
del d[key]:直接删除指定键及其对应的值。若key不存在,抛出KeyError。pop(key[, default]):删除key并返回对应的值。若提供default参数,当键缺失时不报错而是返回该默认值;若未提供且键不存在,抛出KeyError。popitem():按照后进先出(LIFO)顺序移除并返回最后一个插入的(key, value)元组。字典为空时调用抛出KeyError。clear():清空字典所有键值对。
session = {'sid': 'abc-123', 'auth': True, 'exp': 3600, 'temp': 99}

# 1. pop 弹出并提取值(带默认值防止异常)
exp_time = session.pop('exp', None)     # 返回 3600
missing = session.pop('token', 'EMPTY') # 键不存在,返回 'EMPTY'

# 2. popitem 弹出最后插入的一项
last_entry = session.popitem()          # 返回 ('temp', 99)

# 3. del 删除指定键
del session['sid']session 剩余内容: {'auth': True}
3. 查询与检索(Retrieve)
字典在日常业务代码中查询频次极高,必须熟练掌握安全取值与各类遍历视图:
- 下标读取
d[key]:速度最快,但在键不存在时会直接抛出KeyError中断程序。 get(key, default=None):安全取值方法。若键存在返回其值;若键不存在则返回传入的default,程序不会崩溃。- 键存在性测试
key in d:检查key是否存在于字典中,时间复杂度为O(1)。注意:in仅比对键,不比对值。 - 视图对象:
keys()(所有键)、values()(所有值)、items()(键值对元组),支持动态视图迭代。
config = {'host': '127.0.0.1', 'port': 8080}

# 1. 安全取值与契约取值
host = config['host']                   # 业务强制要求的键直接取
timeout = config.get('timeout', 30)     # 可选配置优雅兜底

# 2. 键存在判断
if 'port' in config:
    print(f"Port is active: {config['port']}")

# 3. 遍历键值对视图
for k, v in config.items():
print(f"{k} -> {v}")Port is active: 8080
host -> 127.0.0.1
port -> 8080
四、常用操作场景选择与代码避坑决策流
虽然增删改查的基础语法简洁明了,但在具体业务逻辑组合使用时,若忽视边界条件极易埋下难以定位的隐蔽 Bug。下图梳理了在列表元素删除和字典取值查询时的高频决策路径:
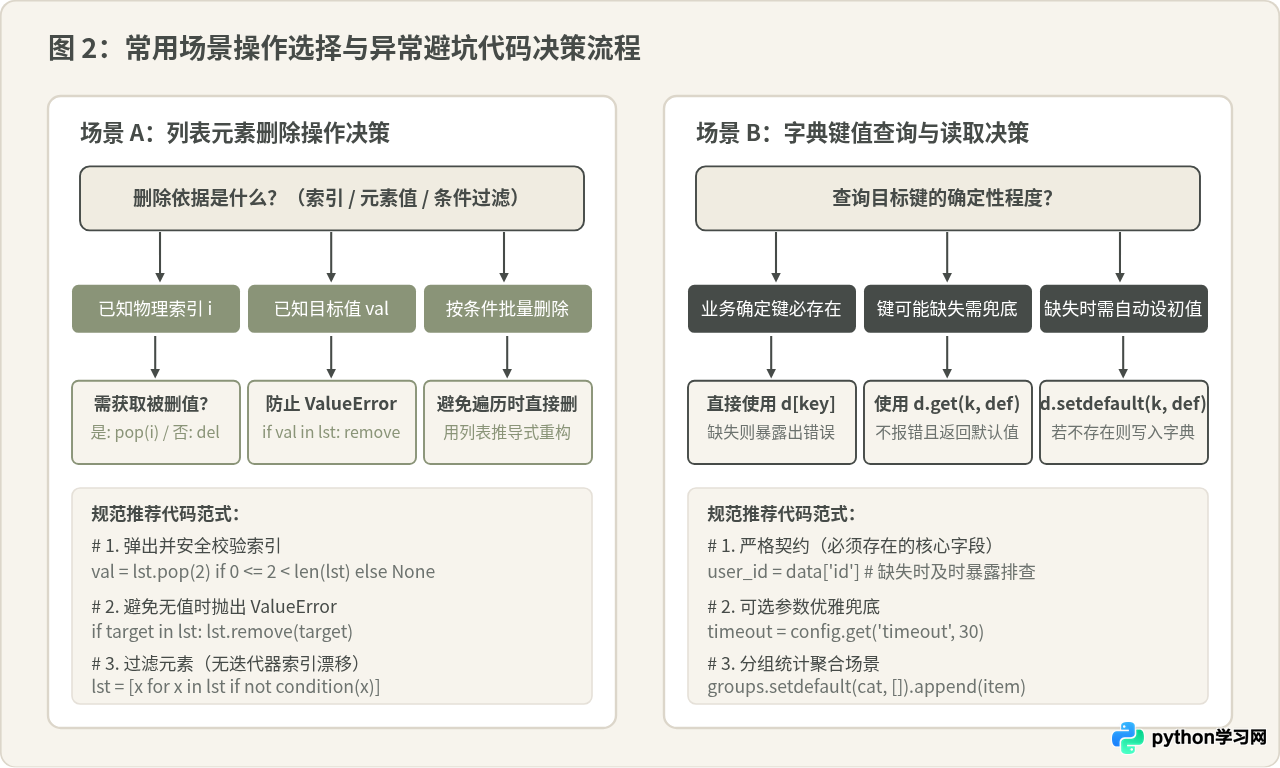
初学者常常写出类似 for x in lst: if condition(x): lst.remove(x) 的代码。这种写法在逻辑上看似“发现不符合的项就删掉”,但在执行时会造成严重的迭代器索引漂移(Index Drift)。
Python 的 for 循环在内部维护了一个隐式的整数游标(从 0, 1, 2... 递增)。当删除了下标为 1 的元素后,原下标为 2 的元素立刻向前移动补位成为新的下标 1。而下一步循环游标自增到 2,导致原本移动过来的元素被直接跳过,根本没有接受条件判断。结果就是偶数连续项被漏删。
标准修正做法:不要原地删除,而是使用列表推导式直接过滤出保留项:
lst = [x for x in lst if not condition(x)]
如果确实需要原地修改同一个列表引用,应使用倒序遍历 for i in range(len(lst) - 1, -1, -1) 或对副本进行遍历 for x in list(lst)。
如果尝试执行 d = {[1, 2]: 'data'},Python 会立即报错 TypeError: unhashable type: 'list'。
这是因为字典的常数级寻址完全依赖键的 __hash__() 返回值来确定存储桶位置。如果允许可变对象(如列表)做键,当修改了列表内容(例如向其 append 元素)后,列表的潜在哈希特征必然改变。但字典不会自动重新给它换桶,导致通过修改后的列表再去查询时,在散列表中再也无法检索到该数据。因此 Python 从语言层面强制规定:字典的键必须是不可变(可哈希)类型,如整数、浮点数、字符串或元素全不可变的元组(tuple)。
d.get() 是否总是优于直接下标 d[key]?很多开发者为了防止程序报 KeyError,盲目将所有字典取值全写成 d.get(k)。这种做法看似安全,实则隐藏了严重隐患。
在业务契约中,如果是系统运行必须依赖的核心字段(例如用户数据的 user_id、接口响应的 status_code),使用 d[key] 能够让缺失异常在源头第一时间爆发并记录明确的堆栈信息;若误用 d.get('user_id'),由于不报错返回 None,错误会被静默传递至后续几十行甚至其他模块,最终在执行 user_id.upper() 时抛出难以定位根源的 AttributeError: 'NoneType' object has no attribute 'upper'。
建议准则:核心强契约字段必须使用 d[key];可选配置或具有明确默认备用值的参数,使用 d.get(key, default)。
五、核心方法的原位修改机制与返回值规则
在增删改查的操作中,另一个最容易导致初学者产生困惑的问题是:操作完成后,变量接收到的到底是什么?
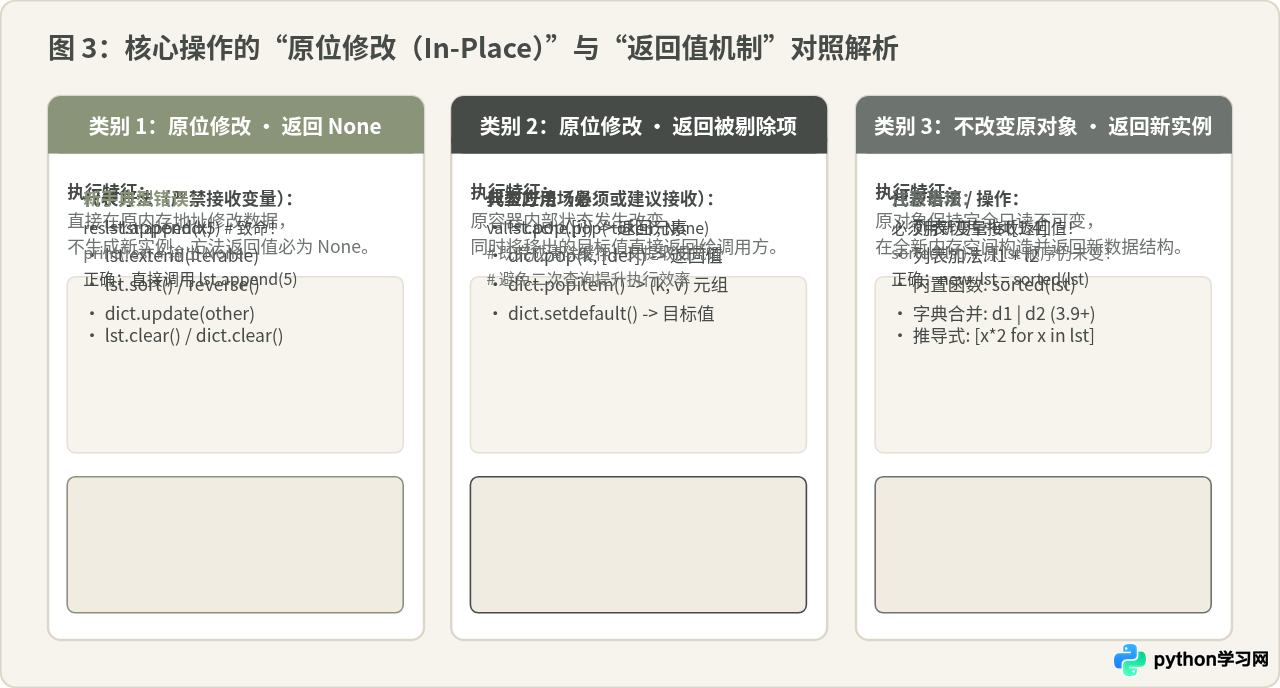
Python 中对于容器修改主要遵循三大设计原则:
1. 原地修改并返回 None(如 append(), sort(), update()):设计者故意让其返回 None,以强提醒开发者“当前操作直接改变了原对象,不需要重新赋值”。若误写 lst = lst.append(5),lst 变量会立刻变为 None。
2. 原地修改并返回被剔除项(如 pop(), popitem()):在改变原容器的同时,将被移除的数据作为结果交出,方便实现栈或消费队列。
3. 不修改原容器并返回全新实例(如切片 lst[:], sorted(), d1 | d2):原对象不受任何影响,调用方必须使用变量接收返回的新容器。
六、字典与列表“增删改查”核心方法全景对照总结
为了便于日常编码快速查阅与选型,下表将列表与字典在增删改查四个维度的代表方法、时间复杂度、原位修改特性与常见报错风险进行了系统横向对比:
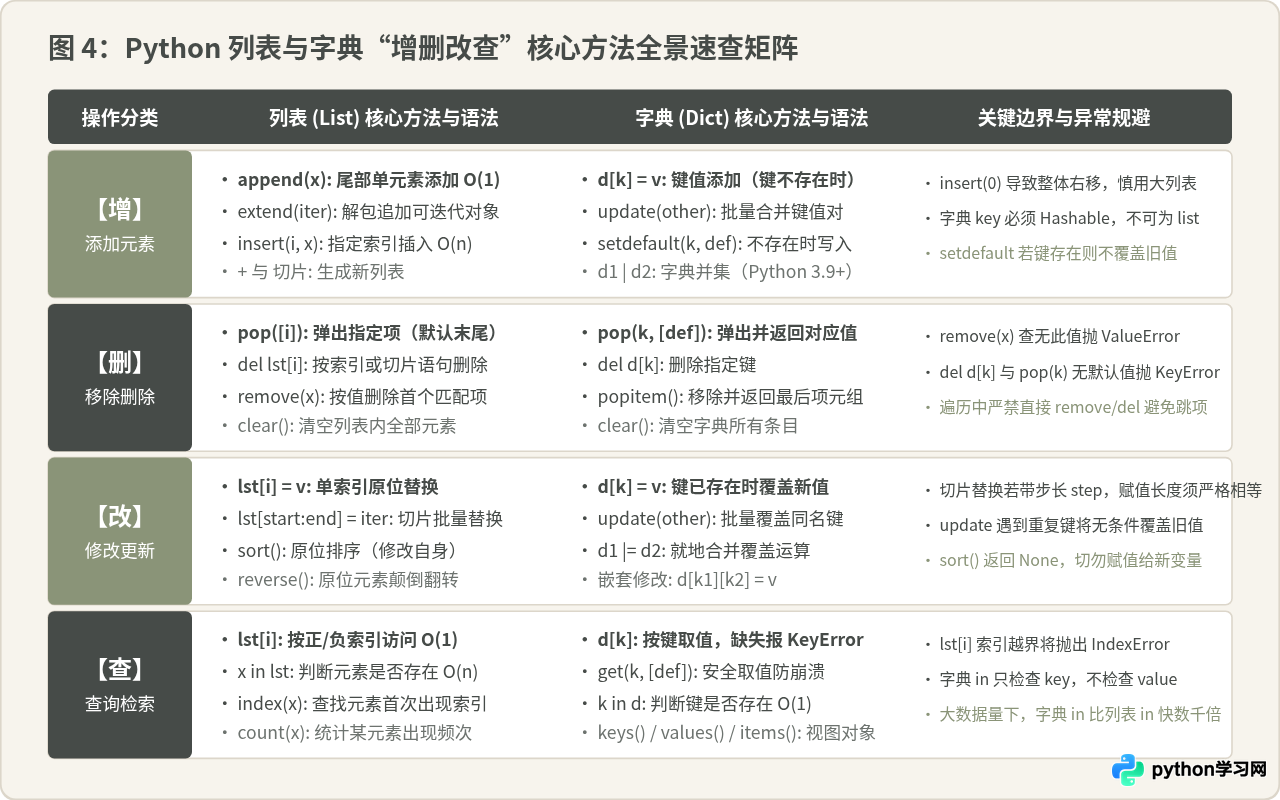
| 操作维度 | 列表 (List) 典型方法 | 字典 (Dict) 典型方法 | 返回值与原位特性 | 核心注意事项 |
|---|---|---|---|---|
| 【增】添加元素 | append(x)extend(iter)insert(i, x) |
d[k] = vupdate(other)setdefault(k, def) |
原位修改,返回 None( setdefault 返回对应值) |
列表 insert(0) 存在全量右移开销;字典键必须为可哈希对象。 |
| 【删】移除数据 | pop([i])del lst[i]remove(x)clear() |
pop(k, [def])del d[k]popitem()clear() |
pop 返回被移出项;del/clear/remove 无返回值 |
remove 查无此值报 ValueError;未设默认值的 pop 查无键报 KeyError;禁止在遍历中直接删列表项。 |
| 【改】修改更新 | lst[i] = vlst[a:b] = itersort() / reverse() |
d[k] = vupdate(other)d1 |= d2 |
原位修改,返回 None |
列表索引越界抛出 IndexError;sort() 返回 None 切勿二次赋值覆盖变量。 |
| 【查】检索读取 | lst[i] / lst[a:b]x in lstindex(x) / count(x) |
d[k]get(k, def)k in ditems() / keys() |
返回目标元素、子列表或视图对象 | 列表 in 为 O(n) 顺序比对,字典 in 为 O(1) 哈希比对;字典 in 只检查键不检查值。 |
在实际工程开发中,应根据数据特性与访问频次合理选型:凡涉及高频按标识符随机读取、排重关联的场景,优先采用字典;凡重视相对顺序、频繁截取切片或进行队列进出的场景,优先采用列表。掌握增删改查的底层时间复杂度与返回值特性,能够从根源上写出兼具可读性、高性能与健壮性的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









