

Python爬虫遇到403 Forbidden或IP被封怎么办
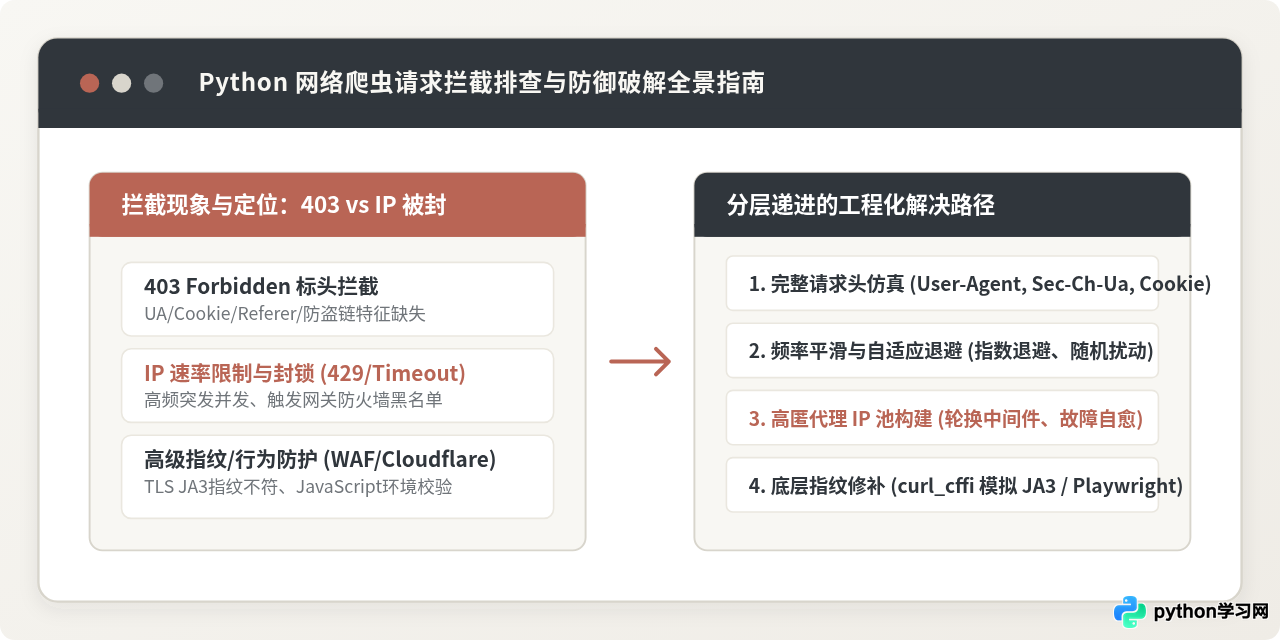
针对Python爬虫运行中遭遇的403 Forbidden与IP封禁问题,提供从故障现象定性排查、请求标头仿真、并发频控调优、高匿代理池轮换到TLS指纹伪装的完整工程化解决方案。
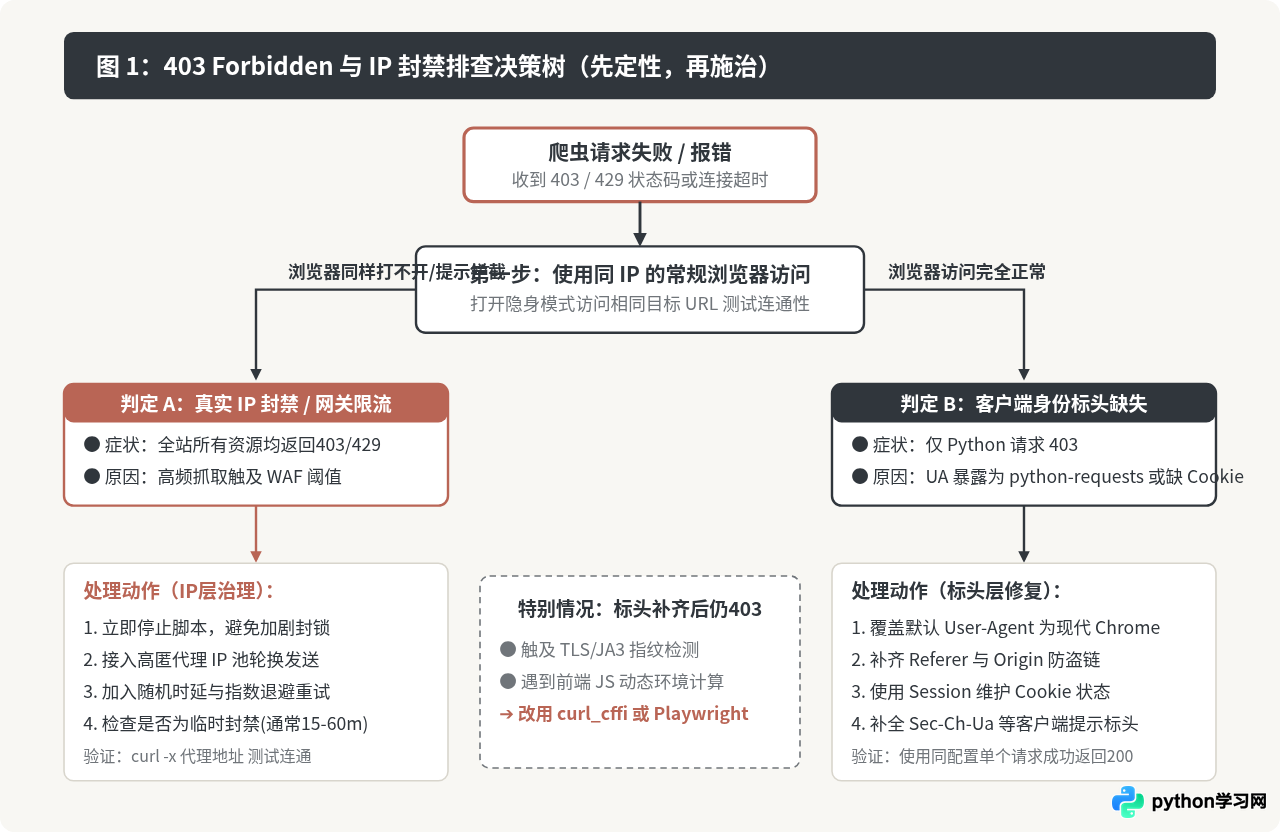
一、先定性:区分 403 Forbidden 与真正的 IP 封禁
在遇到爬虫报错时,许多开发者常将“403 状态码”与“IP 被封”混为一谈。事实上,HTTP 403 Forbidden 仅表示“服务器理解了本次请求,但拒绝执行该请求”。这既可能是接口鉴权拦截,也可能是防盗链机制,并不必然意味着你的 IP 地址已被封锁。如果未经排查就盲目付费采购代理 IP,往往既浪费成本,又无法解决本质问题。
排查定位的核心手段是“对照测试法”。在爬虫报错的第一时间,请保持当前网络环境不变(即使用相同的本地宽带或服务器出口 IP),使用常规桌面浏览器打开无痕模式(隐身窗口)访问相同的目标 URL。
- 情况 A(浏览器可正常打开,仅 Python 脚本返回 403):这说明你的本地 IP 处于安全放行状态,服务端仅仅是通过分析请求头参数识别出了爬虫身份。此时只需针对请求头、Cookie 或特定会话参数进行补齐伪装即可恢复。
- 情况 B(浏览器同样返回 403、429、或页面持续转圈直到连接超时):这表明服务端的 WAF(Web Application Firewall)防火墙或网关已对你当前的公网 IP 实施了临时或永久封禁。此时即使修改请求头也无法生效,必须依靠代理 IP 轮换或等待冷却解封。
二、标头层修复:消除 80% 的初级 403 拦截
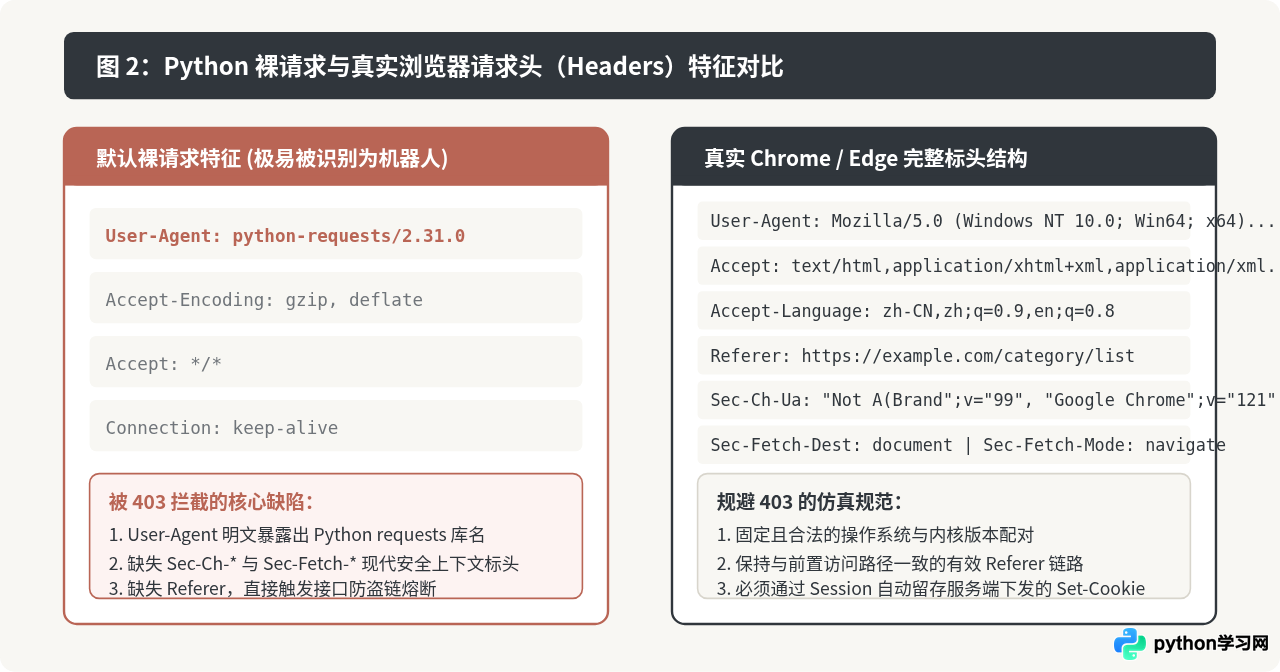
当确认本地浏览器可以正常访问,而 Python 脚本被 403 阻断时,问题几乎全部出在 HTTP 请求标头的差异上。官方 Python requests 库在发起请求时,默认附带的标头极度简陋,甚至直接声明 User-Agent: python-requests/2.x.x。对任何部署了基础反爬策略的网站而言,这是最直观的拦截特征。
1. 规范构造现代浏览器 User-Agent
不要随意手写一个简短过时的 UA 字符串。现代浏览器的 UA 结构具有严格的命名规则与版本依赖关系。推荐使用近期主流 Chrome 版本的稳定标识,并搭配规范的操作系统信息:
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-User": "?1",
    "Upgrade-Insecure-Requests": "1"
}
2. 补齐关键防盗链标头:Referer 与 Origin
许多数据列表页或 API 接口虽然不强制登录,但严格校验请求来源。如果直接在爬虫中请求 /api/data/list,服务端检测到 Referer 为空,就会判定为非站内合法跳转,立刻触发 403。解决办法是:将 Referer 设置为对应的前置详情页或频道导航页 URL。
3. 使用 Session 维持 Cookie 状态流转
很多网站在首页首次加载时,会通过 Set-Cookie 在客户端注入临时会话凭据(如会话 ID 或 CSRF Token)。如果每次都使用单独的 requests.get() 发起无状态调用,就会因为缺少前置 Cookie 而被后续页面阻断。必须使用 requests.Session() 对象维持完整的连接池与 Cookie 容器:
session = requests.Session()
session.headers.update(headers)

# 先访问入口页面,自动获取前置 Cookie
welcome_resp = session.get("https://example.com/portal", timeout=10)

# 再带着获取到的 Cookie 访问目标数据接口,补齐 Referer
session.headers["Referer"] = "https://example.com/portal"
data_resp = session.get("https://example.com/api/data/items", timeout=10)

if data_resp.status_code == 200:
    print("标头与会话补齐成功,数据已正常获取")
else:
    print(f"请求失败,状态码: {data_resp.status_code}")
三、频控调优:消除高并发触发的限流与封锁
如果爬虫在最初几十次请求表现完全正常,但几分钟后突然连续报错 429(Too Many Requests)或 403,这属于典型的频控型封禁。服务端的流控组件(如 Nginx limit_req、Redis 滑动窗口计数器)捕捉到了非人力的请求节奏。
time.sleep(1))同样具备极强的机械特征。现代防御系统不仅统计单秒请求量,还会通过时序方差(Variance)判断请求是否具有生物学的不确定性。
1. 引入随机时延(Random Jitter)
在每次请求间隔中引入正态分布或区间随机浮动,模拟真实用户的浏览阅读停顿:
import time
import random

def polite_sleep(base_seconds: float = 1.5, jitter_range: float = 1.0):
    """产生带有随机抖动的暂停时间,避免固定的请求时序特征"""
    actual_delay = base_seconds + random.uniform(0.1, jitter_range)
    time.sleep(actual_delay)
2. 建立带指数退避(Exponential Backoff)的重试机制
当检测到 429、503 或偶发 403 时,切忌立即发起下一次重试,这会导致服务端惩罚计时器不断重置。应当成倍延长等待时间:
def fetch_with_backoff(session, url, max_retries=4):
    delay = 2.0
    for attempt in range(1, max_retries + 1):
        try:
            resp = session.get(url, timeout=8)
            if resp.status_code == 200:
                return resp
            elif resp.status_code in (403, 429):
                print(f"[警告] 遭遇拦截 (状态码: {resp.status_code}),开始第 {attempt} 次指数退避,等待 {delay:.1f} 秒...")
                time.sleep(delay)
                delay *= 2  # 等待时间翻倍:2s, 4s, 8s, 16s
            else:
                resp.raise_for_status()
        except requests.exceptions.RequestException as err:
            print(f"[异常] 网络传输失败: {err},等待重试...")
            time.sleep(delay)
            delay *= 2
    return None
四、网络层治理:高可用代理 IP 池的构建与自愈
当排查确认目标网站确实对出口 IP 施加了严格封锁时,代理 IP 池是唯一从网络层绕过限制的工程解法。但在选型与接入过程中,有三个关键准则必须明确:
| 代理类型 | HTTP 头 REMOTE_ADDR | HTTP_X_FORWARDED_FOR | 防封可用性结论 |
|---|---|---|---|
| 透明代理 (Transparent) | 代理服务器 IP | 包含真实客户端 IP | 完全无效,服务端可直接识破原 IP |
| 普通匿名代理 (Anonymous) | 代理服务器 IP | 包含代理自身或伪造值 | 一般,服务端仍能识别出使用了代理 |
| 高匿代理 (Elite Proxy) | 代理服务器 IP | 完全不透传任何代理标识 | 唯一推荐,服务端视同普通访问者 |
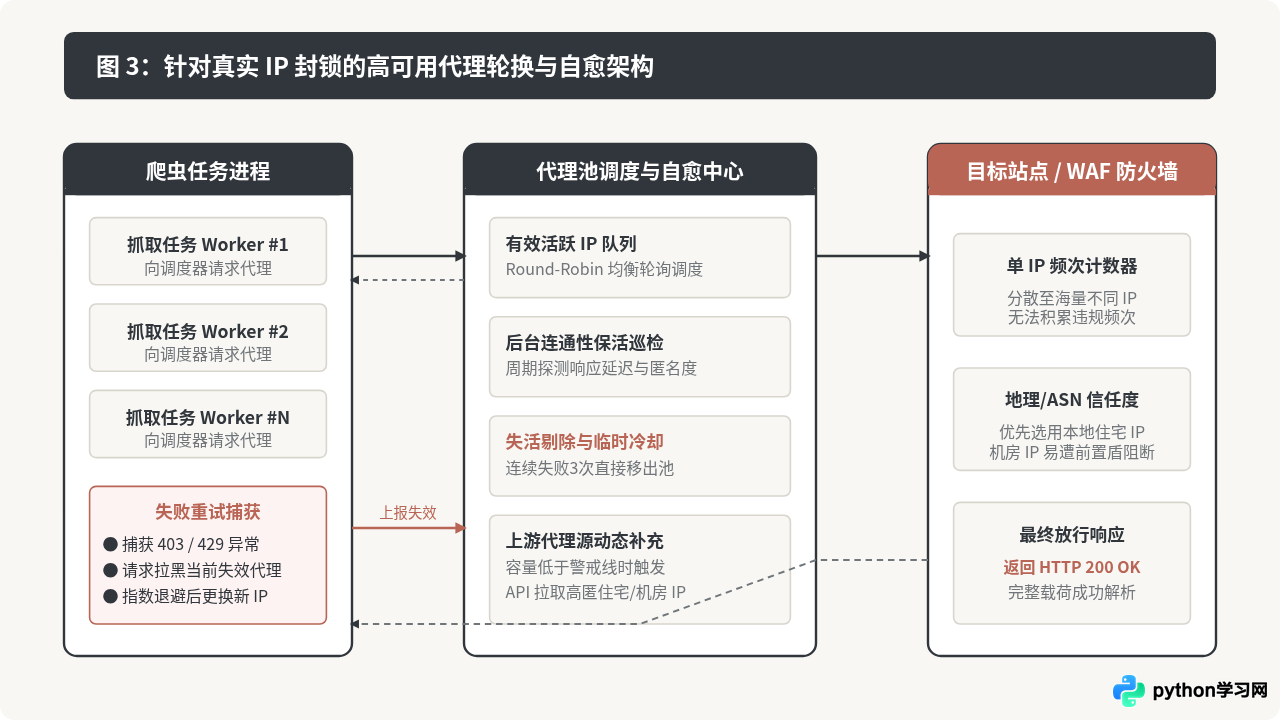
生产级代理轮换与失效剔除示例
以下代码演示了如何在 Python 中将代理池接入 Session,当某节点返回 403 或超时失效时,自动上报剔除并切换下一可用节点:
import requests
from typing import List, Optional

class ResilientProxyClient:
    def __init__(self, proxy_list: List[str]):
        self.proxy_pool = list(proxy_list)
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36"
        })

    def _get_next_proxy(self) -> Optional[str]:
        return self.proxy_pool[0] if self.proxy_pool else None

    def _mark_proxy_failed(self, failed_proxy: str):
        if failed_proxy in self.proxy_pool:
            self.proxy_pool.remove(failed_proxy)
            print(f"[代理中心] 节点 {failed_proxy} 被拦截或超时,已从活跃池移出,当前剩余: {len(self.proxy_pool)}")

    def execute_request(self, target_url: str, max_attempts: int = 5) -> Optional[requests.Response]:
        for attempt in range(max_attempts):
            current_proxy = self._get_next_proxy()
            if not current_proxy:
                print("[错误] 可用代理池已耗尽,请补充代理源")
                return None

            proxy_dict = {
                "http": current_proxy,
                "https": current_proxy
            }

            try:
                # 严格限制单次代理连接超时为 5 秒,避免卡死
                resp = self.session.get(target_url, proxies=proxy_dict, timeout=5)

                # 如果依然被目标站点返回 403,说明该代理已被目标 WAF 拉黑
                if resp.status_code == 403:
                    print(f"[拦截] 代理 {current_proxy} 返回 403,触发轮换")
                    self._mark_proxy_failed(current_proxy)
                    continue

                if resp.status_code == 200:
                    # 轮转队列尾部,实现均衡使用
                    self.proxy_pool.append(self.proxy_pool.pop(0))
                    return resp

            except (requests.exceptions.ProxyError, requests.exceptions.Timeout, requests.exceptions.ConnectionError):
                self._mark_proxy_failed(current_proxy)

        return None

# 初始化测试
initial_proxies = [
    "http://user:pass@198.51.100.12:8080",
    "http://user:pass@198.51.100.15:8080",
    "http://user:pass@203.0.113.88:8080"
]
crawler = ResilientProxyClient(initial_proxies)
# result = crawler.execute_request("https://example.com/api/product")
五、高级对抗:解决 TLS/JA3 指纹与动态行为防护
在当今大型企业与主流防护体系(如 Cloudflare、Akamai、Imperva、AWS WAF)下,你可能会发现一个诡异现象:已经完整复制了浏览器的全部 Headers,也使用了干净的住宅代理,但 Python 脚本依然百分之百返回 403。
这是因为现代安全网关的防护层已经深入到了传输层安全协议(TLS)握手过程。Python requests 底层基于 OpenSSL,其在 Client Hello 阶段声明的密码套件(Cipher Suites)、扩展顺序(Extensions)与椭圆曲线(Elliptic Curves)会计算出一个唯一的 JA3 / JA4 指纹。这个指纹与 Google Chrome 或 Apple Safari 存在明显的二进制差异。服务端甚至无需解析 HTTP 报文内容,在 TCP 握手刚结束时便判定为非浏览器环境并直接下发 403。
1. 使用 curl_cffi 模拟真实浏览器 TLS 指纹(首选高效方案)
curl_cffi 是目前解决此类高级 403 阻断的高性能库。它通过底层注入技术完整模拟了 Chrome 等浏览器的 TLS 握手特征与 HTTP/2 帧协商逻辑,运行速度与 requests 无异,开销极低:
# 环境准备: pip install curl_cffi
from curl_cffi import requests

# 指定 impersonate="chrome120",底层将完全模拟 Chrome 120 的 JA3/JA4 与 HTTP/2 行为
response = requests.get(
    "https://nowsecure.nl",  # 典型 Cloudflare 防护站点
    impersonate="chrome120",
    timeout=10
)

print(f"响应状态码: {response.status_code}")
if response.status_code == 200:
    print("成功绕过 TLS 指纹校验,获得正常页面内容")
2. 使用 Playwright 自动化处理复杂的 JavaScript 验证码与 5 秒盾
如果目标站点不仅校验 TLS,还会在前端动态执行复杂的 JavaScript 算力挑战(例如 Cloudflare Turnstile 或滑动拼图),纯 HTTP 请求库将无法完成客户端动态计算。此时必须使用现代化无头浏览器方案。
# 环境准备: pip install playwright && playwright install chromium
import asyncio
from playwright.async_api import async_playwright

async def run_stealth_browser():
    async with async_playwright() as p:
        # 启动真实浏览器内核,关闭自动化扩展特征标识
        browser = await p.chromium.launch(
            headless=True,
            args=[
                "--disable-blink-features=AutomationControlled",
                "--no-sandbox"
            ]
        )
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            viewport={"width": 1920, "height": 1080},
            locale="zh-CN"
        )

        # 注入脚本,抹除 navigator.webdriver 属性
        await context.add_init_script("""
            Object.defineProperty(navigator, 'webdriver', {
                get: () => undefined
            });
        """)

        page = await context.new_page()
        await page.goto("https://example.com/protected-page", wait_until="networkidle")

        content = await page.content()
        print(f"成功获取页面,源码长度: {len(content)}")
        await browser.close()

# asyncio.run(run_stealth_browser())
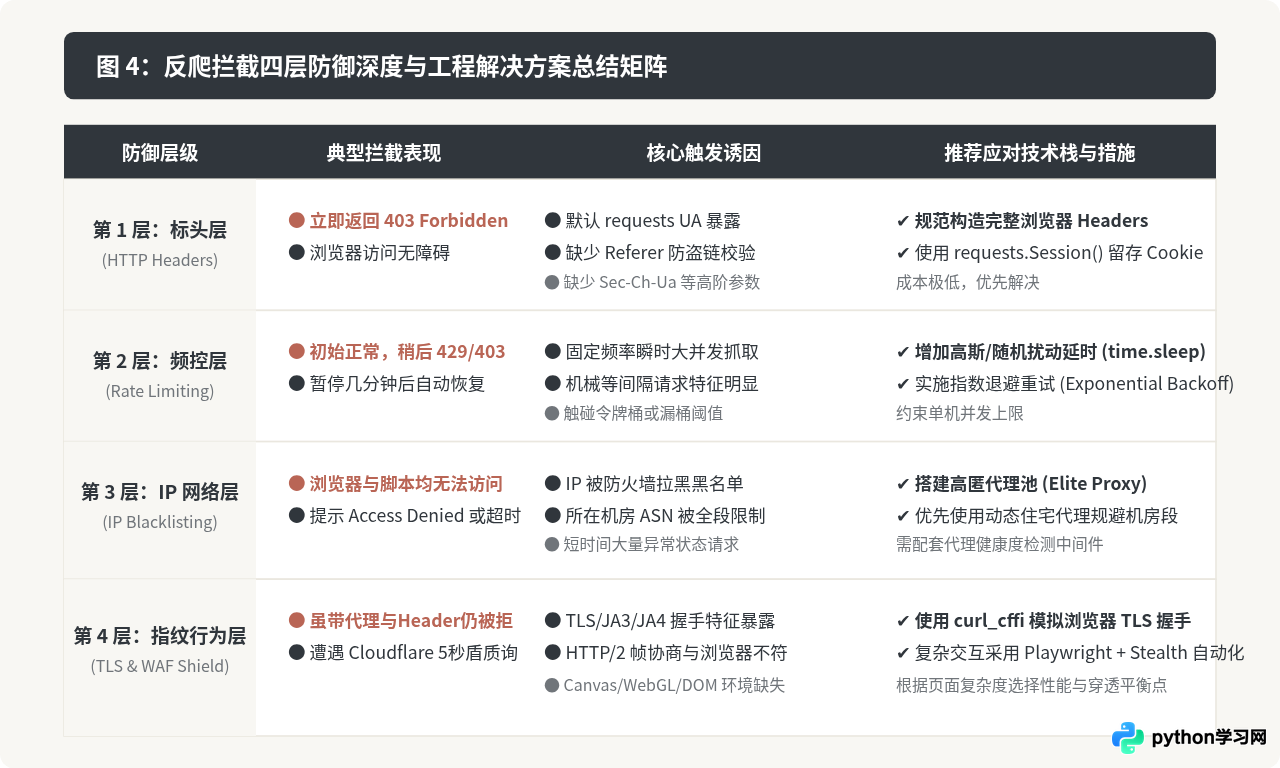
六、工程总结:四层防御解法矩阵
面对 Python 爬虫的 403 Forbidden 与封禁问题,解决思路应遵从“轻重结合、逐步推进”的工程逻辑。下表总结了四个核心防御层级的对应表现与最优技术选型:
robots.txt,将请求速率控制在目标服务器承受范围之内。当遭遇封锁时,优先优化请求效率与数据增量策略,避免对公共网络服务造成拒绝服务式的高负荷冲击。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









