

学术研究用R语言,企业开发用Python?两者适用场景详解
深入对比R语言与Python在学术研究与企业工业开发中的定位、生态与适用场景,提供技术选型判断依据与多语言协同实践方案。
在一支同时包含生物统计学家和后台系统工程师的团队中,常会出现这样的场景:统计学者希望使用 R 语言,仅用几行代码完成复杂的混合效应模型检验并导出出版级图表;而工程负责人则坚持要求全部改写为 Python,以便将数据预处理流水线直接打包进 Docker,并通过 FastAPI 挂载到线上微服务架构中。这种分歧并非单纯的个人习惯之争,而是源于两门语言在设计初衷、生态构成以及最终交付目标上的本质差异。“学术研究用R,企业开发用Python”这一概括总体反映了技术生态的分工现状,但两者并不是互斥对立的,理解各自的技术基因与适用边界,才能在具体项目中做出合理的架构决策。
一、语言底层基因与设计哲学的本质差异
要理解两者的场景分化,首先需要考察两门语言最初是为解决什么问题而诞生的:
- R 语言的统计学血统:R 源自贝尔实验室的 S 语言,自诞生起就是专门面向统计计算、数据探索和图形绘制的领域专用环境。在 R 的语法体系中,向量(Vector)、因子(Factor)、矩阵与数据框(data.frame)被视为一等公民。其核心目标是让研究人员以接近数学推导的表达方式,快速完成统计建模与假设检验。
- Python 的通用软件工程基因:Python 是一门通用的多范式编程语言,设计哲学强调“代码可读性、显式优于隐式、正交解耦”。它不仅支持过程式、面向对象和函数式编程,而且遵循标准的软件工程规范。对 Python 而言,数据科学库(如 NumPy、pandas)只是其通用生态上的一个分支,它天然具备与网络通信、操作系统、文件存储及分布式计算集群交互的能力。
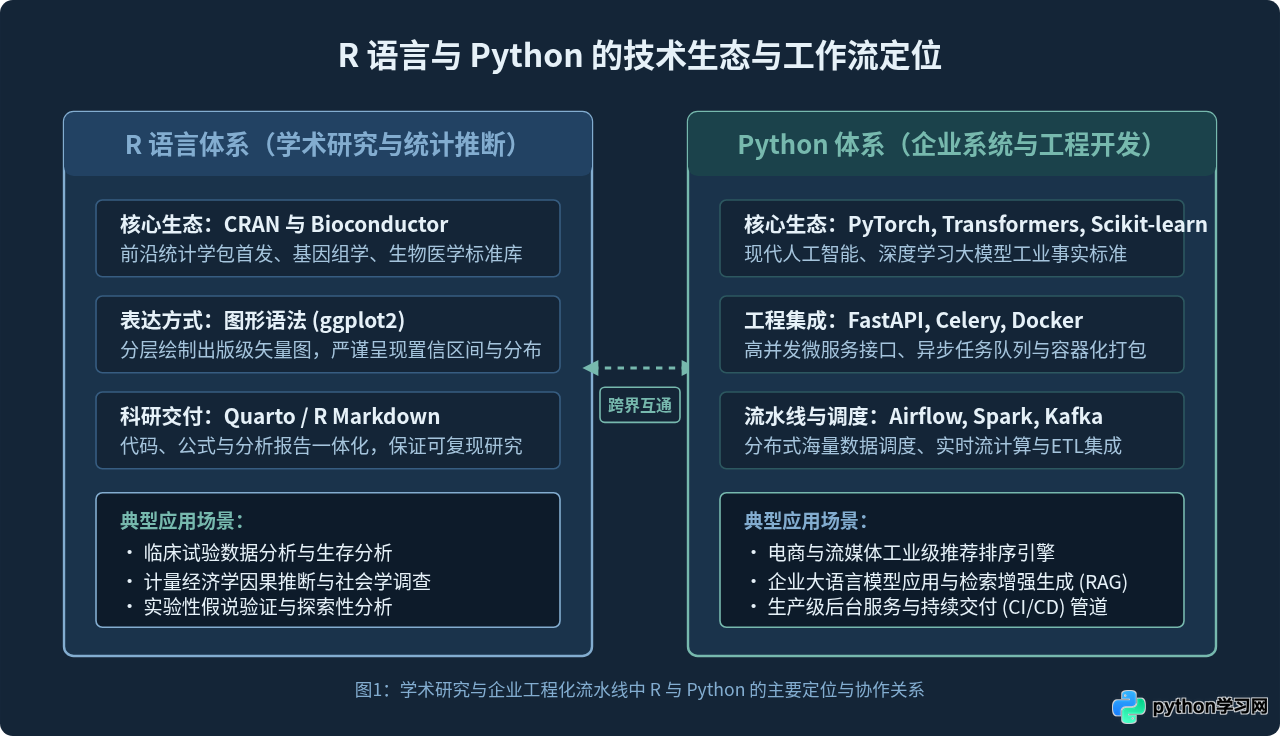
为了直观说明两者代码层面的思维差异,以最基础的普通最小二乘法线性回归(OLS)为例:在 R 中,统计推断是核心,调用 lm() 函数配合公式语法 y ~ x1 + x2 即可直接得到标准误差、t检验值、p值、残差分布与F统计量;而在 Python 中,传统数据分析库更倾向于面向对象封装,需要使用 statsmodels 模拟统计学公式输出,或使用 scikit-learn 进行面向预测的权重拟合。
# R 语言:一行代码获得详尽的统计学检验报告
fit <- lm(weight ~ height + age, data = sample_data)
summary(fit)  # 自动输出拟合优度、显著性标记、标准误及F检验
# Python 语言:工业界常使用 scikit-learn 进行拟合(侧重特征预测,不默认输出p值)
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X_train, y_train)
predictions = model.predict(X_test) # 侧重将模型输出对接下游接口二、学术研究为何偏爱 R 语言
在高校、科研院所、生物医药实验室与公共卫生统计领域,R 语言长期保持着极高的占有率。这主要得益于以下四个核心支柱:
1. 前沿统计理论与专业算法的首发地
统计学期刊上的新方法、新型混合效应模型、小样本生存分析算法通常首先由统计学教授及其团队开发为 R 的 CRAN 包。例如在生物信息学领域,涵盖数千个经过严格同行评审算法的 Bioconductor 平台构成了全球基因组学分析的事实标准。如果科研人员需要在小样本、高维度数据下做精确因果推断,在 R 中可以直接找到对应学术成果的原作者实现包;而在 Python 中,很多冷门或前沿统计学包可能尚未移植,或者仅有社区初级实现。
2. 语法驱动的出版级图表绘制(ggplot2)
学术论文对数据可视化有极高要求:误差棒、置信带、分面排版(Faceting)、散点边际分布等必须严谨准确。基于 Leland Wilkinson《The Grammar of Graphics》构建的 ggplot2 提供了高度统一且模块化的绘图逻辑。研究者通过声明数据映射、几何图元、坐标系与统计变换,可以快速生成符合 Nature、Science 等期刊审稿标准的矢量 PDF 图表。
3. 可复现研究与学术文档体系(Quarto / R Markdown)
科研成果的可重复性(Reproducibility)至关重要。R 生态内的 R Markdown 以及新一代的 Quarto 工具,允许科研人员将 R 代码、计算结果、数学公式(LaTeX)和分析文字无缝编织在同一个源文件中。数据发生变化时,只需重新编译即可自动更新所有图表和表格,极大降低了手动校对可能带来的学术疏漏。
三、企业开发为何重度依赖 Python
与学术界追求“统计精确性与可发表性”不同,企业开发的关注点在于“吞吐量、高可用性、可维护性与整体工程集成”。在工业级落地场景中,Python 展现出压倒性优势:
1. 现代人工智能与深度学习的事实标准
从计算机视觉、自然语言处理(NLP)到目前的大语言模型(LLM),全球主流的 AI 基础设施——包括 PyTorch、TensorFlow、Hugging Face Transformers、vLLM 和 LangChain——几乎完全以 Python 作为核心交互界面。企业若要将大模型、向量数据库以及复杂深度学习模型引入业务线,Python 是无法绕开的通用语言。
2. 完备的通用软件工程支持
在企业中,一个算法模型不能只停留在本地笔记本(Jupyter Notebook)里,它必须接入数据库、监听消息队列、响应网络请求并进行日志审计。Python 拥有庞大而成熟的 Web 框架(FastAPI、Django)、异步任务调度工具(Celery)、连接器与 ORM(SQLAlchemy)。数据科学家用 Python 训练出来的模型,软件工程师无需重写语言,即可直接用几行代码将其封装为标准化 RESTful API。
3. 工业级数据管道与基础设施集成
在海量数据环境下,企业需要处理每天数百 GB 甚至数 TB 的日志流。Apache Airflow、Apache Spark(PySpark)等企业级大数据调度平台深度集成 Python。Python 可以顺畅地在 CI/CD 流程中进行单元测试、类型检查(mypy)、打包为 Docker 镜像,并在 Kubernetes 集群中实现弹性扩缩容。
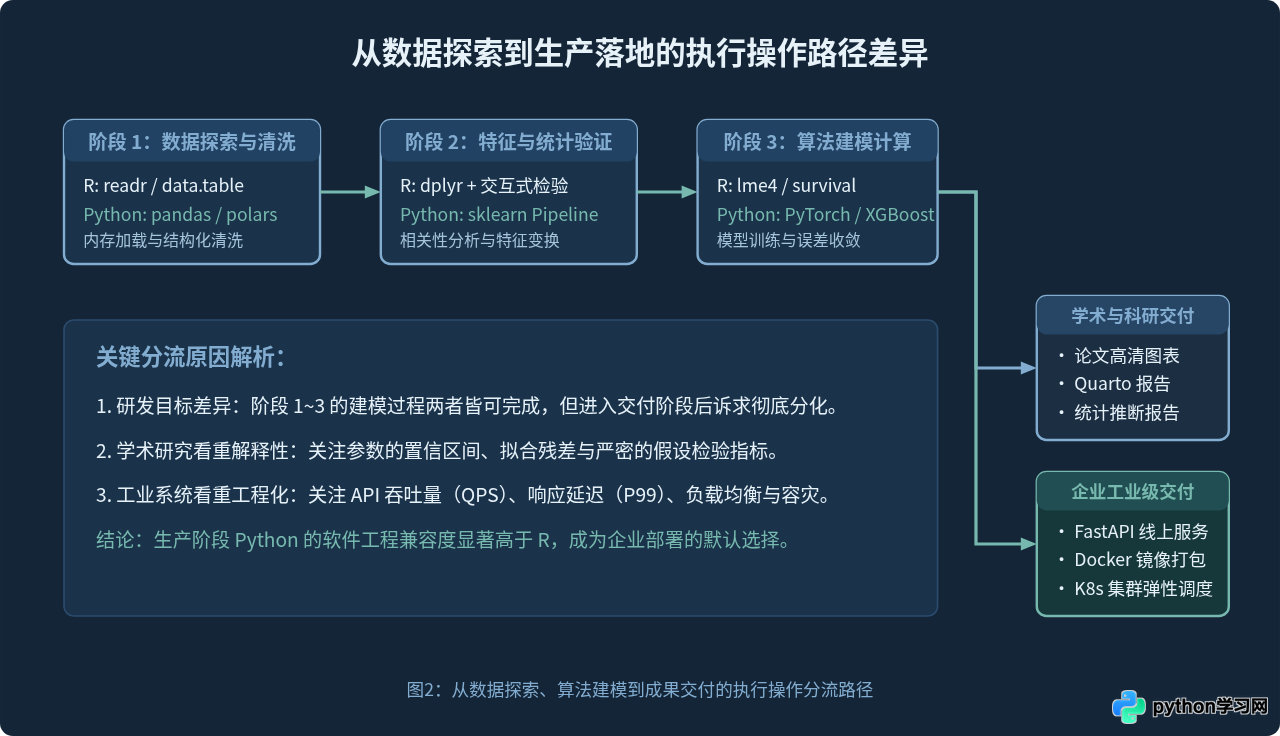
四、技术选型决策判断流程
当面临技术方案选择时,切忌盲目站队。可以从最终产出形式、团队背景与系统吞吐三个明确维度建立决策模型:
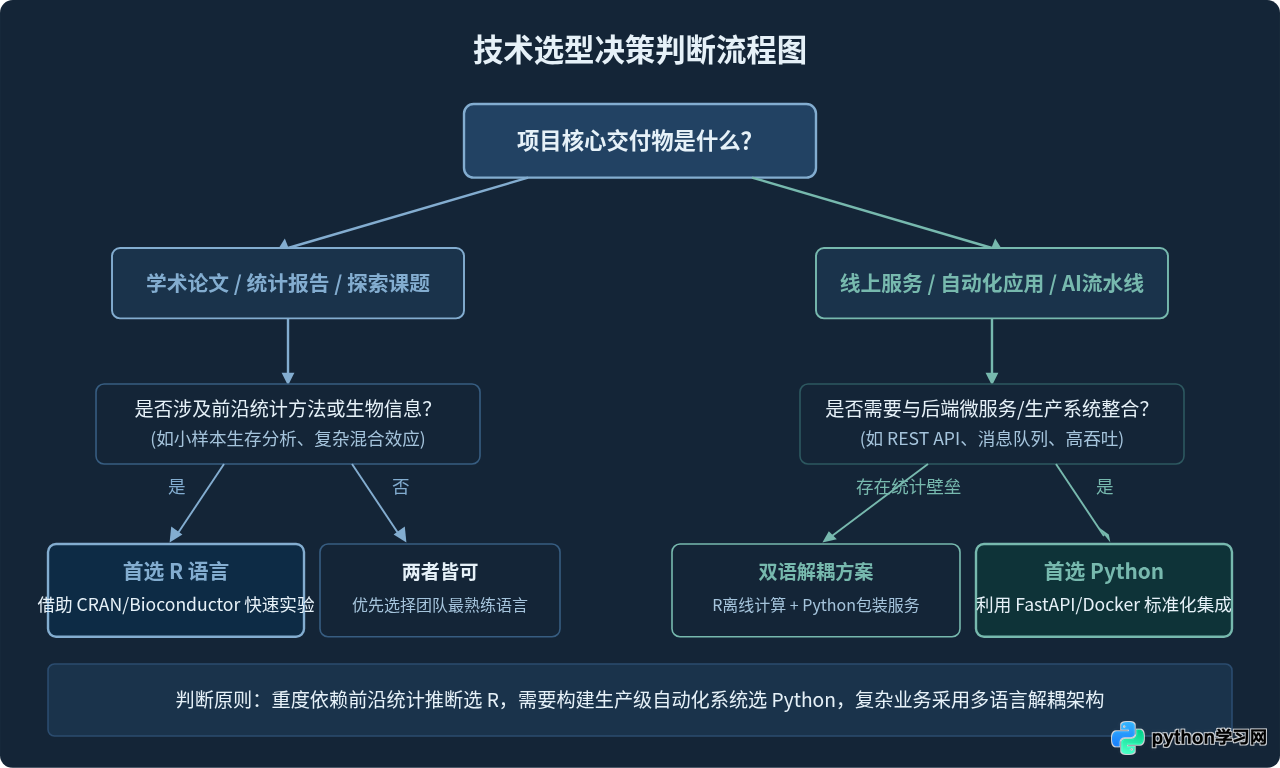
五、企业与学术界的融合之道:双语协同实践
现实中,成熟团队很少陷入非此即彼的语言争执,而是采用“分层解耦”的混合架构:
1. 职责划分与接口隔离
在研发阶段,生物医学或金融风控团队的统计学家完全可以在 R 语言环境中进行数据探索、参数估计与算法验证;当模型通过统计学检验后,团队将其固化为两种协同路径:
- 离线批处理解耦:统计模型通过 R 脚本每天定时执行,将输出特征或得分存储至 PostgreSQL 或 Redis 中,Python 后台仅负责读取数据并响应用户端请求。
- 轻量级微服务化:若必须实时调用 R 代码,可通过 R 的
plumber包将其封装为一个只接受 JSON 报文的独立微服务,部署于专用容器内,Python 主系统仅通过 HTTP/gRPC 进行远程调用,实现运行环境的完全隔离。
2. 语言级互操作(reticulate 与 rpy2)
对于单机或中轻量级任务,两门语言都提供了出色的互操作桥梁:
- 在 R 中调用 Python(reticulate):允许 R 开发者直接导入 Python 模块(如 TensorFlow、scikit-learn),并在 R 数据结构与 NumPy 数组之间自动双向转换。
- 在 Python 中调用 R(rpy2):允许 Python 工程师在数据流水线中直接调用 R 的专有算法包(如 Bioconductor 中的基因比对算法),保持底层统计学结果的纯正性。
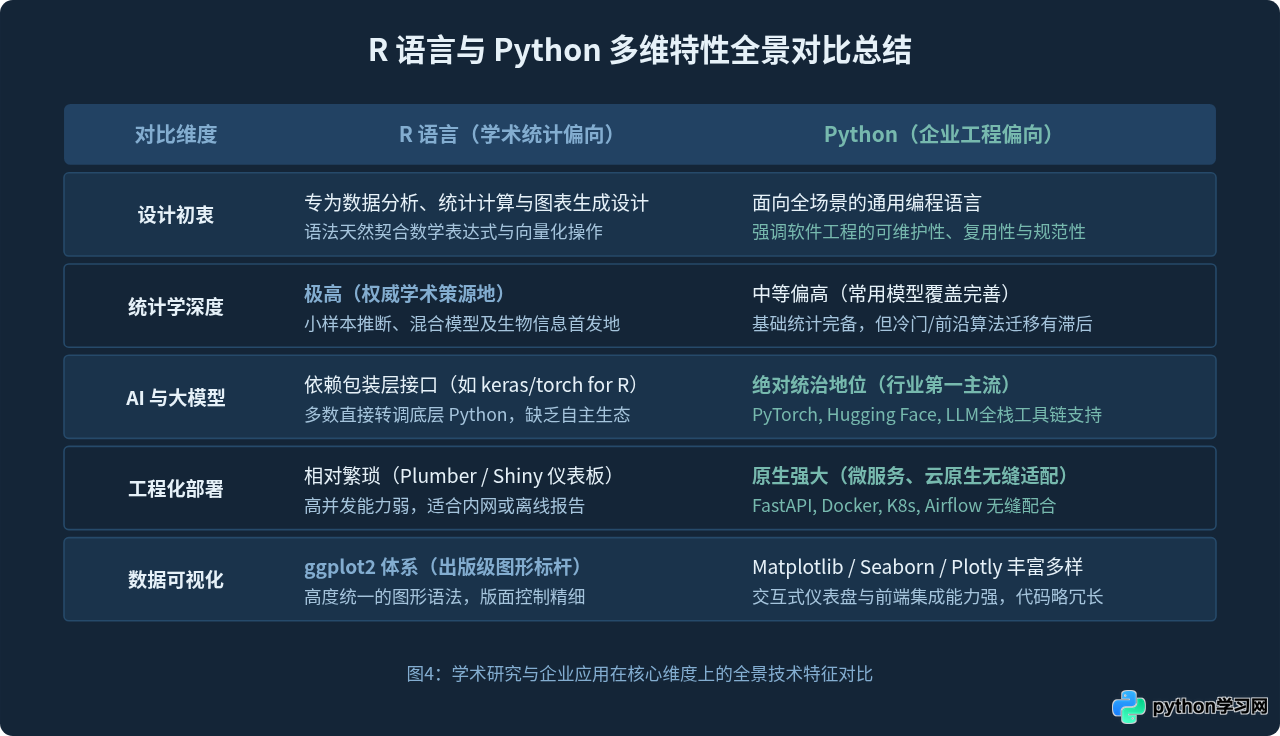
六、实践中的常见认知误区
并非如此。如果从事生物医药、基因测序、临床试验、计量经济、社会统计或前沿实验科学,绝大部分经典数据集和同行最新算法都发布在 R 上。即使日常开发以 Python 为主,掌握基本的 R 语言阅读和调用能力,也是复现高水平论文与获取专业算法库的必备技能。
这是一种过度简化的片面认知。在金融、保险精算和制药企业中,R 语言长期运行在核心合规与风险定价系统中。通过 RStudio Connect、Posit Workbench 以及基于 Docker 的微服务封装,R 同样能够支撑高价值的生产决策。它的限制在于不适合处理高并发、低延迟的实时 Web 请求,而非不能胜任生产级批处理与精算业务。
在基础统计(均值、方差、常见回归、ANOVA)上,Python 的 scipy.stats 和 statsmodels 能够良好运行;但在非平衡设计、复杂随机效应结构、高维变量选择及专业生存分析中,R 的计算精度、警告提示以及默认处理策略(如因子对照矩阵的设定)经过了数十年统计学家的严格检验,更符合统计学规范。
七、总结
“学术研究用 R,企业开发用 Python”这句话的本质,是专业统计推断工具与通用软件工程系统之间的分工差异。R 语言是数据分析师与科研工作者手中锋利的手术刀,在统计建模、假设检验与可视化发表上无可替代;Python 则是构建现代工业数字基础设施的瑞士军刀,在软件架构、深度学习与云原生微服务中牢牢占据中心地位。技术选型不应受限于门户之见,明确交付目标——是追求严密的学术推断,还是稳定高并发的业务落地——才是做出正确决策的唯一准绳。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









