

Python中copy模块的性能开销与使用建议
深入剖析Python标准库copy模块中浅拷贝与深拷贝的底层运行机制、memo字典与反射开销,结合基准测试提供针对高频复制场景的具体优化建议与工程替代方案。
copy 模块提供了 copy.copy()(浅拷贝)与 copy.deepcopy()(深拷贝)。然而,深拷贝由于需要遍历完整的对象拓扑图、维护查重字典并进行多重动态反射,往往带来比原生操作高出数十倍甚至数百倍的时间与内存开销。本文将拆解其性能损耗的底层根源,并给出具体的测试数据与工程优化建议。
一、赋值、浅拷贝与深拷贝的底层模型差异
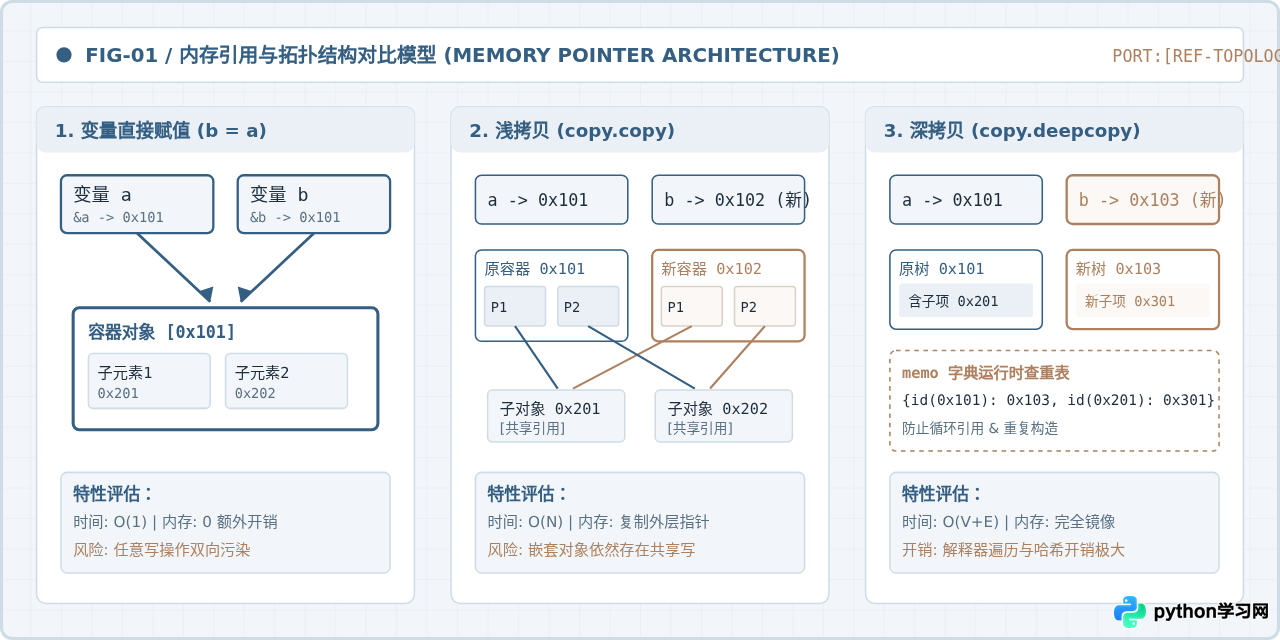
理解 copy 模块的开销,首先要理清 Python 中变量、引用与对象在内存中的组织形式。在 Python 的执行模型中,变量名本质上是指向对象内存地址的指针:
- 变量赋值(
b = a):仅在当前作用域命名空间中新增一个指针绑定,底层对象完全共享,时间复杂度为O(1),没有对象创建开销。 - 浅拷贝(
b = copy.copy(a)):构造一个全新的外层容器对象,但容器内部所包含的子元素依然只是复制了原有的引用指针。如果原对象是一维扁平结构,浅拷贝足以实现数据解耦;但若包含嵌套结构,修改子元素依然会影响原对象。 - 深拷贝(
b = copy.deepcopy(a)):递归地遍历并复制源对象所能触达的全部子对象。为了防止复杂图结构中的循环引用导致无限递归,它必须在运行时建立一张记录已复制对象的映射表(memo)。
二、copy 模块的性能瓶颈根源剖析
在实际性能分析中,许多开发者发现调用 copy.deepcopy() 比简单的对象初始化或数据处理慢数百倍。这种性能劣势并非实现上的缺陷,而是由其通用性算法保障所带来的固有工程代价:
1. 递归对象图遍历(Object Graph Traversal)
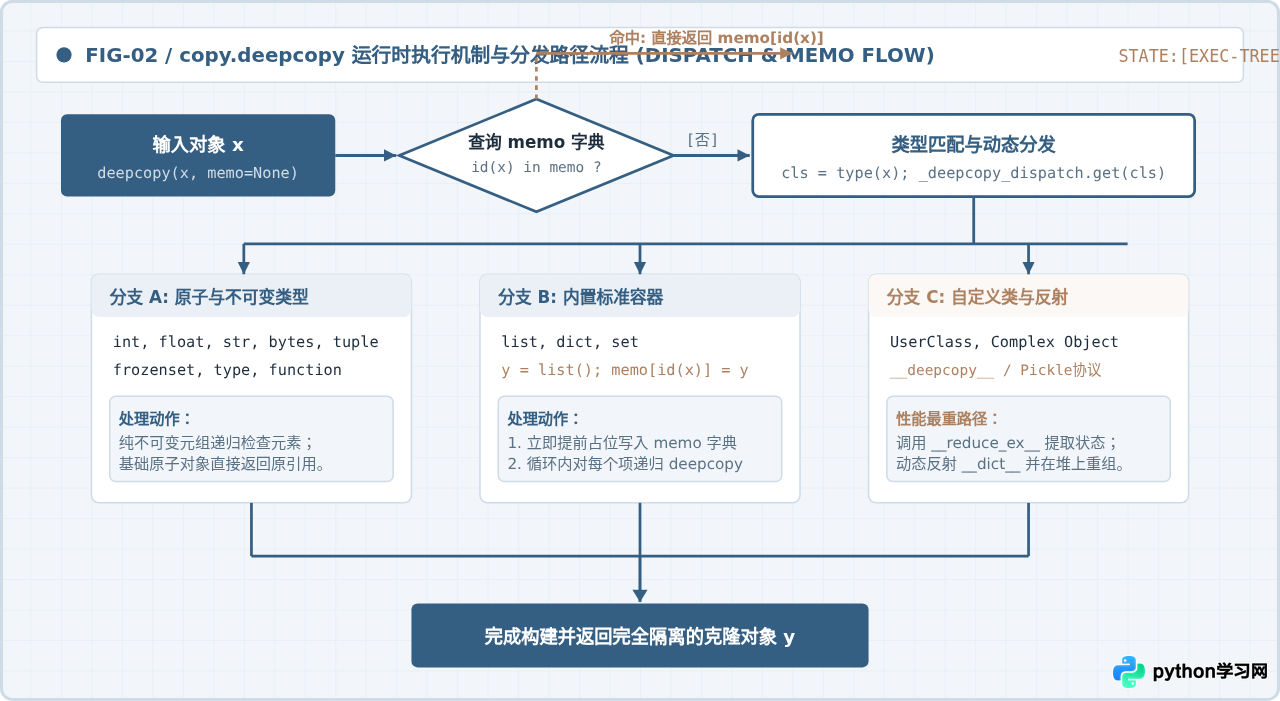
Python 允许任意复杂的数据结构相互嵌套,甚至形成包含双向引用的有向图。deepcopy 必须把输入对象视为一张图的根节点,依次递归访问每个子对象。每下潜一层,都会在 Python 虚拟机中压入一层函数调用栈帧,产生显著的栈管理与调度开销。
2. memo 字典的哈希查找与动态维护
为了解决“同一个子对象被多处引用时只复制一份”以及“环形引用导致死循环”这两个核心难题,deepcopy 在每次调用时都会显式或隐式地创建一个字典 memo = {}。
每遇到一个对象 x,函数首先计算 id(x) 并查询 memo:
d = memo.get(id(x))
if d is not None:
    return d
这意味着无论被拷贝的对象有多么简单,只要其所包含的元素数量巨大,就会产生数以万计的哈希运算、字典扩容与键值对插入操作。
3. 动态分发机制与反射(Reflection Overhead)
copy.py 内部维护了一个分发字典 _deepcopy_dispatch,将类型映射到具体的深拷贝处理函数上。对于用户自定义的类或非内置类型,标准库无法预知其内部结构,必须依次尝试以下反射流程:
- 检查对象是否具有
__deepcopy__方法并执行动态绑定调用; - 检查是否实现了
__reduce_ex__或__reduce__(即 Pickle 协议); - 通过
hasattr、getattr检查并遍历对象的__dict__以及__slots__。
这种高度动态的内省机制在保证通用性的同时,彻底失去了底层 C 语言级别批量内存拷贝(memcpy)的优化可能。
三、基准性能测试与数据量化
为了具体量化 copy 模块各操作的性能差距,我们构建标准测试用例,分别在扁平容器与嵌套结构下对比直接切片、构造器浅拷贝、copy.copy() 以及 copy.deepcopy() 的耗时表现。
测试场景一:包含 10,000 个整数的扁平列表
扁平列表内部仅包含不可变的整数对象。分别测试原生切片、内置构造器、copy.copy() 与 copy.deepcopy() 复制该列表的平均耗时:
import copy
import timeit

setup_code = "data = list(range(10000))"

# 1. 列表切片
t_slice = timeit.timeit("data[:]", setup=setup_code, number=1000)
# 2. list 构造函数
t_list = timeit.timeit("list(data)", setup=setup_code, number=1000)
# 3. copy.copy
t_copy = timeit.timeit("copy.copy(data)", setup="import copy; " + setup_code, number=1000)
# 4. copy.deepcopy
t_deepcopy = timeit.timeit("copy.deepcopy(data)", setup="import copy; " + setup_code, number=1000)| 操作方式 | 实现机制 | 单次平均耗时 | 相对切片耗时倍数 |
|---|---|---|---|
data[:] |
C 语言底层连续内存拷贝 | ~28 μs | 1.0x (基准) |
list(data) |
内置类型构造器浅拷贝 | ~34 μs | 1.2x |
copy.copy(data) |
模块函数分发与浅拷贝 | ~38 μs | 1.35x |
copy.deepcopy(data) |
递归检查、memo查重及逐项分发 | ~2,950 μs | 105x |
deepcopy 也需要对 10,000 个整数逐一执行 memo 查找与不可变类型过滤判定。仅此一项操作,就让执行耗时从微秒级陡增了两个数量级。
测试场景二:嵌套字典与复杂自定义对象
当数据结构扩展为包含 100 个嵌套字典(每个字典包含 10 个子项与自定义实例)时,deepcopy 需要处理对象的 __dict__,并反复执行反射协议。耗时将从亚毫秒级上升至数十毫秒。在 Web 服务或高并发数据清洗循环中,这一延迟会导致严重的 CPU 占用与垃圾回收(GC)压力。
四、工程优化指南与四步替代方案
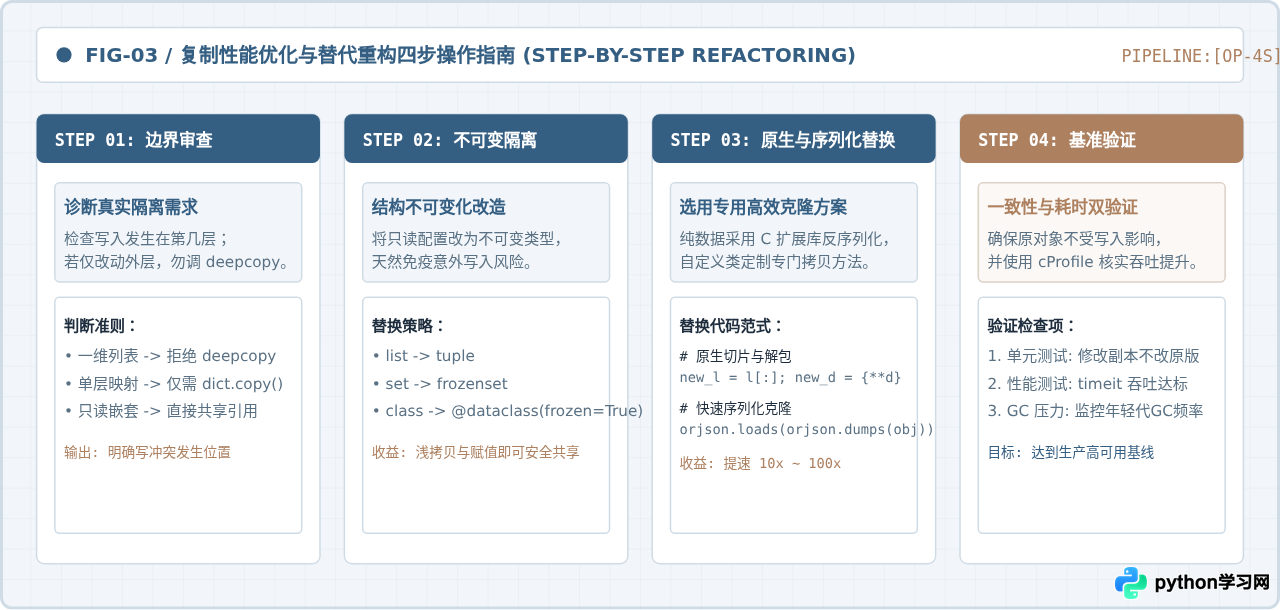
在性能敏感的生产代码中,避免滥用 deepcopy 是保障系统吞吐量的重要原则。针对需要数据隔离的业务场景,可以按照以下四个步骤逐步完成性能重构:
替代方案实施示例
1. 列表与字典的原生浅拷贝替代方案
对于单层数据结构,始终优先使用 Python 内置语法:
# 列表复制:优先使用切片或 list 构造
new_list = old_list[:]
# 字典复制:优先使用 copy 方法或解包表达式
new_dict = old_dict.copy()
new_dict_alt = {**old_dict}
2. 基于快速序列化库的深度克隆
如果待拷贝的数据是纯粹由字典、列表、数字和字符串构成的嵌套 JSON 结构(如 API 响应或配置项),借助 C 语言编写的高性能序列化库进行“序列化 + 反序列化”,其速度通常比 copy.deepcopy() 快 10 到 30 倍:
import orjson

# 使用 orjson 进行快速深拷贝
fast_cloned_data = orjson.loads(orjson.dumps(nested_data))
3. 自定义类的 __deepcopy__ 钩子优化
对于包含复杂上下文(例如只读数据库连接、日志记录器或大型静态缓存)的自定义类,标准 deepcopy 会顺着属性指针将整个连接池与缓存全部克隆。此时应实现自定义的 __deepcopy__,明确指定只复制可变的状态字段:
class OrderContext:
    def __init__(self, order_id, items, db_session):
        self.order_id = order_id
        self.items = items            # 需要深拷贝的可变列表
        self.db_session = db_session  # 只读共享组件,切勿深拷贝

    def __deepcopy__(self, memo):
        # 针对性拷贝 items,db_session 保持共享引用
        new_items = copy.deepcopy(self.items, memo)
        new_obj = OrderContext(self.order_id, new_items, self.db_session)
        memo[id(self)] = new_obj
        return new_obj
五、复制策略决策树与使用建议总结
为了在日常开发中准确权衡代码安全性与执行效率,可以参考下面的决策流程图来选择最适配的对象复制方式:
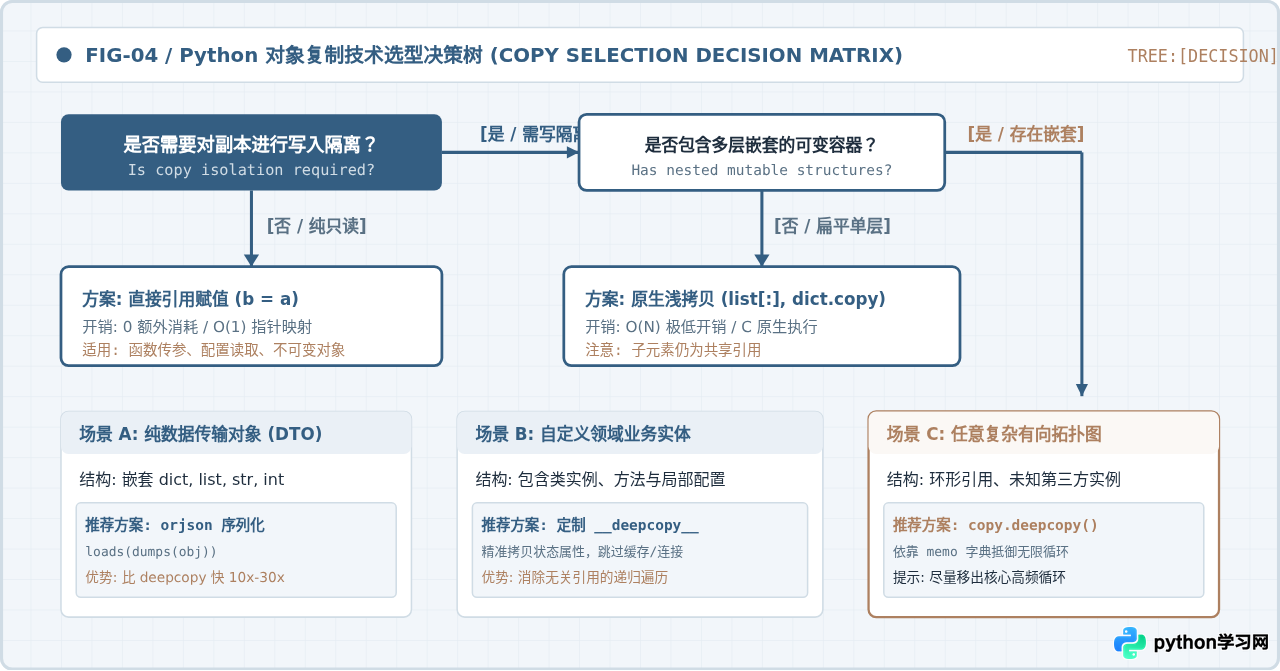
核心使用建议总结
- 防御性深拷贝的陷阱:避免仅仅为了“以防万一”在函数入口处对大型字典或列表调用
deepcopy。明确读写边界,只对确实会被原地修改的字段进行拷贝。 - 不可变优于事后复制:在架构设计阶段,尽量通过
tuple、NamedTuple或@dataclass(frozen=True)表达不可变业务配置。不可变对象天然具备线程安全与零拷贝共享特性。 - 警惕多线程环境下的竞态:标准库的
copy.copy()与deepcopy()并非原子操作。在遍历包含大量子对象的结构时,若其他线程并发修改该结构,可能引发RuntimeError: dictionary changed size during iteration或产生脏状态副本。必要时需加锁保护。 - 移出高频循环体:如果深拷贝不可避免,尽量通过原型模式(Prototype Pattern)在循环外预先克隆一份基础模板,或者在必要时重构数据流,避免每次迭代都执行全量深拷贝。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









