

Python csv库怎么用DictReader按表头读取数据
详细讲解在Python中使用内置csv库的DictReader类按表头读取CSV数据的方法、代码示例、参数配置、与csv.reader的对比及避坑指南。
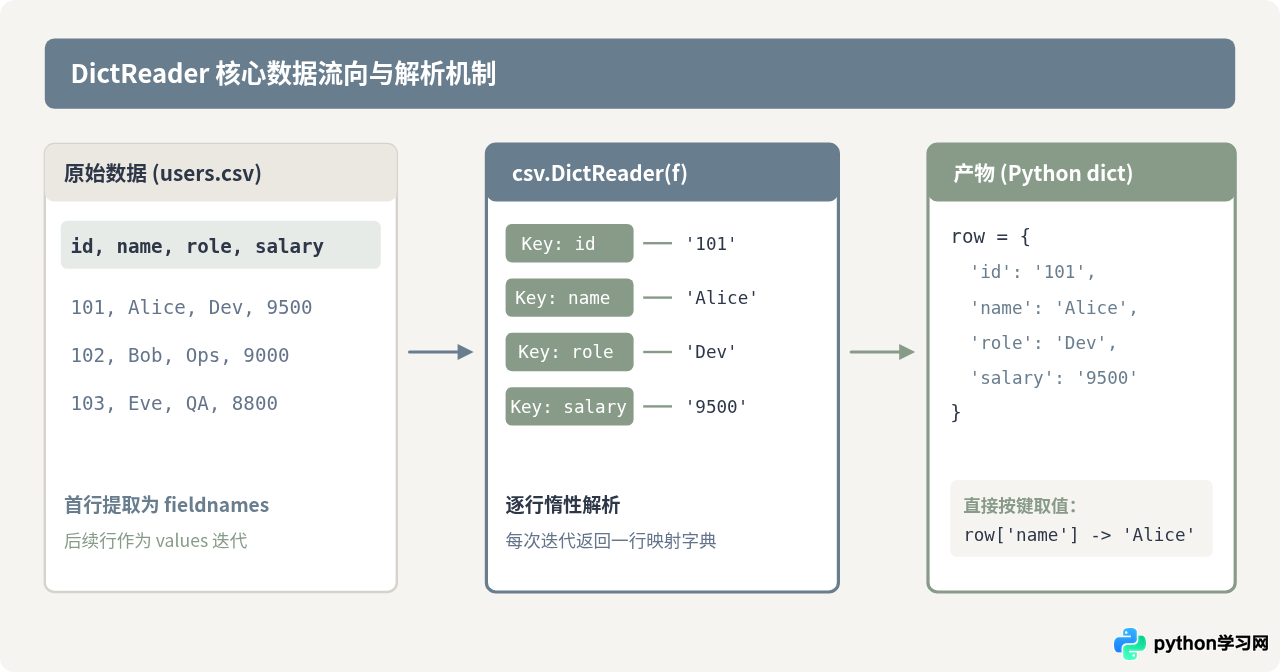
在处理包含表头的 CSV 文件时,Python 内置的 csv.DictReader 是最直观、健壮的读取工具。它会将 CSV 文件的第一行数据自动提取为字段名(Keys),并在后续迭代中将每一行记录转换为以列名为键、单元格内容为值的字典(在 Python 3.8 及更高版本中为标准 dict 类型)。相比依赖位置下标的传统切片读取,按表头读取不仅让业务代码具备自解释性,还能在表格增减列或调换列次序时保证逻辑正常运行。
一、基础用法:三步按表头读取 CSV 数据
使用 DictReader 不需要安装任何第三方依赖,直接导入 Python 标准库的 csv 模块即可。标准流程包含三个步骤:以只读模式打开文件、实例化 DictReader、循环遍历字典对象。
1. 准备示例 CSV 文件
假设在当前工作目录下有一个名为 users.csv 的文件,内容如下:
id,name,role,department
101,张伟,工程师,技术部
102,李娜,设计师,体验设计部
103,王强,产品经理,商业化部
2. 编写读取代码
打开文件时,推荐使用 with 上下文管理器确保文件自动关闭,同时显式传入 encoding='utf-8' 和 newline='' 参数:
import csv

def read_users(file_path):
    with open(file_path, mode='r', encoding='utf-8', newline='') as f:
        reader = csv.DictReader(f)

        # reader.fieldnames 可以直接查看解析出的表头列表
        print(f"解析到的表头: {reader.fieldnames}")

        # 逐行遍历字典
        for row in reader:
            user_id = row['id']
            user_name = row['name']
            role = row['role']
            dept = row['department']
            print(f"[{user_id}] {user_name} - {role} ({dept})")

if __name__ == '__main__':
read_users('users.csv')[101] 张伟 - 工程师 (技术部)
[102] 李娜 - 设计师 (体验设计部)
[103] 王强 - 产品经理 (商业化部)
在循环体中,变量 row 本身就是一个字典。你可以直接通过 row['列名'] 获取指定单元格的文本,也可以使用字典的 row.get('列名', 默认值) 方法进行防御性读取,避免因个别行缺字段而抛出 KeyError 异常。
二、核心机制对比:为什么优先使用 DictReader 而非 reader
在 Python 的 csv 模块中,最常见的两个读取类是 csv.reader 和 csv.DictReader。它们在输入方式上完全一致,但在数据结构返回形式、业务可维护性及抗变动能力上存在显著差异。
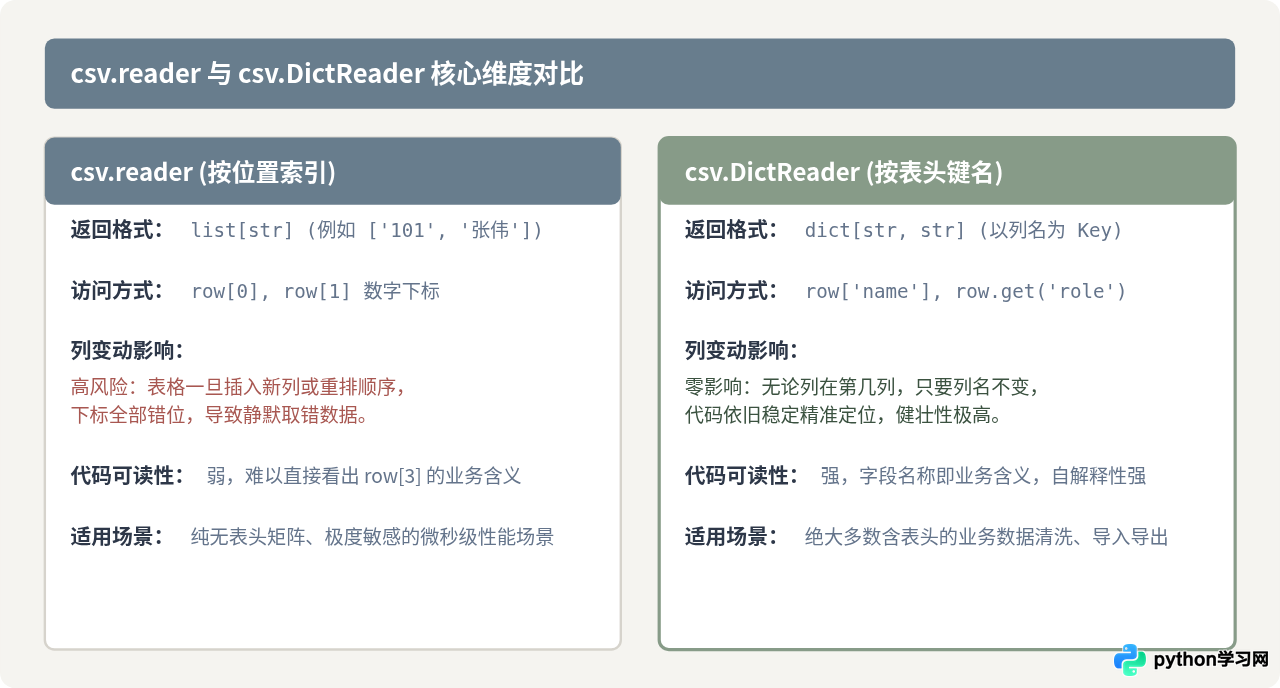
这种差异在团队协作和业务迭代中尤为明显。如果上游业务方在导出 CSV 时临时在前排插入了“部门编码”列,所有使用 row[1] 读取姓名的脚本都会瞬间取成部门编码;而使用 row['name'] 的代码完全不会受到任何干扰。
三、进阶控制:自定义表头、缺列与多列处理
csv.DictReader 提供了若干可选参数,用来应对实际开发中并不完美的 CSV 数据源:例如文件没有首行表头、某一行数据少写了字段、或者某一行多出了若干逗号分隔值。
csv.DictReader(f, fieldnames=None, restkey=None, restval=None, dialect='excel', *args, **kwds)1. 文件本身无表头:手动指定 fieldnames
当 CSV 文件没有标题行,直接从第一行就是纯数据时,可以通过传入列表 fieldnames 显式指定各列的键名。此时,DictReader 不会将第一行当作表头吞掉,而是直接从第一行开始生成数据字典:
import csv

# 假设 raw_data.csv 中没有表头,只有纯数据:
# 201,周杰,北京
# 202,吴芳,上海

with open('raw_data.csv', mode='r', encoding='utf-8', newline='') as f:
    headers = ['emp_id', 'full_name', 'city']
    reader = csv.DictReader(f, fieldnames=headers)
    for row in reader:
        print(row)
2. 数据列缺失与多列对齐机制:restval 与 restkey
现实中的 CSV 数据可能存在行长度不一致的问题。DictReader 提供了清晰的容错机制:
- 当数据列少于表头长度时:缺少的键对应的值将被赋为
restval,默认是None。你可以将其设置为''或其他标记值。 - 当数据列多于表头长度时:多出来的全部字段会被收集为一个列表,存入以
restkey为键的项中。restkey默认为None,你也可以将其设置为有业务意义的字符串(如'extra')。
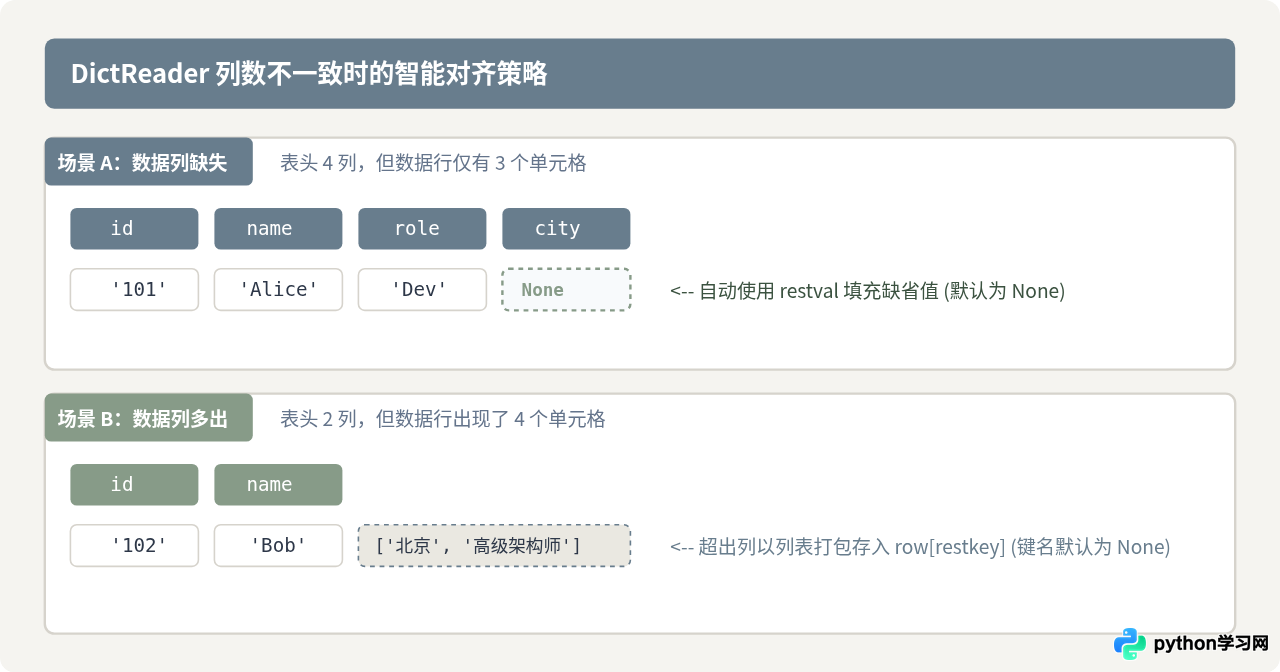
如果希望多余的数据保存在明确的字段名下,可以在实例化时指定 restkey='extra_data';如果希望缺少的字段默认返回空字符串而非 None,可以指定 restval='':
reader = csv.DictReader(f, restval='', restkey='extra_data')四、实际应用中的高频问题与避坑指南
虽然 DictReader 逻辑非常简洁,但在不同操作系统和各类软件(特别是微软 Excel)导出的 CSV 文件中,经常会遇到以下几个隐蔽的细节问题。
1. Excel 导出的 BOM 乱码导致第一列名解析失败
使用 Excel 保存为 CSV 时,Windows 默认通常会在文件开头写入一个 UTF-8 BOM(字节顺序标记 \xef\xbb\xbf)。如果仅使用 encoding='utf-8' 打开,这个标记会被附加到第一个表头名称中,例如第一列是 id,解析出的字典键却变成了 '\ufeffid'。此时调用 row['id'] 会直接报 KeyError: 'id'。
encoding='utf-8-sig' 打开。Python 会自动检测并安全剥除开头的 BOM 标记。
2. 打开文件必须加上 newline=''
在调用 open() 时,必须传递 newline='' 参数:
with open('data.csv', mode='r', encoding='utf-8', newline='') as f:
    reader = csv.DictReader(f)
如果不指定 newline='',Python 内置的文件读取器会将文本中的所有换行符转换为统一的 \n。而 CSV 规范中单元格内部是可以包含嵌入式换行符的(用双引号包裹)。如果不关闭通用换行符转换,csv 模块内部的双引号多行内容解析就会出现混乱。
3. 表头可能包含未去除的空格
如果原始 CSV 的表头书写为 id, name , role,DictReader 默认不会自动去除两侧的空白字符,解析出的键名将是带有空格的 ' name '。如果需要对表头做统一清洗,可以在打开文件后提前修改 reader.fieldnames:
reader = csv.DictReader(f)
# 统一去除表头所有字段前后的空白字符
reader.fieldnames = [col.strip() for col in reader.fieldnames]
4. 所有值读取出来均为字符串类型
DictReader 不会自动推断数据类型,无论原单元格写的是数字 101、浮点数 99.5 还是布尔值 True,读取出的值均为字符串 '101'、'99.5'、'True'。在执行数学计算或入库校验前,务必手动进行类型转换:
user_id = int(row['id'])
salary = float(row['salary'])
五、DictReader 规范使用速查全景
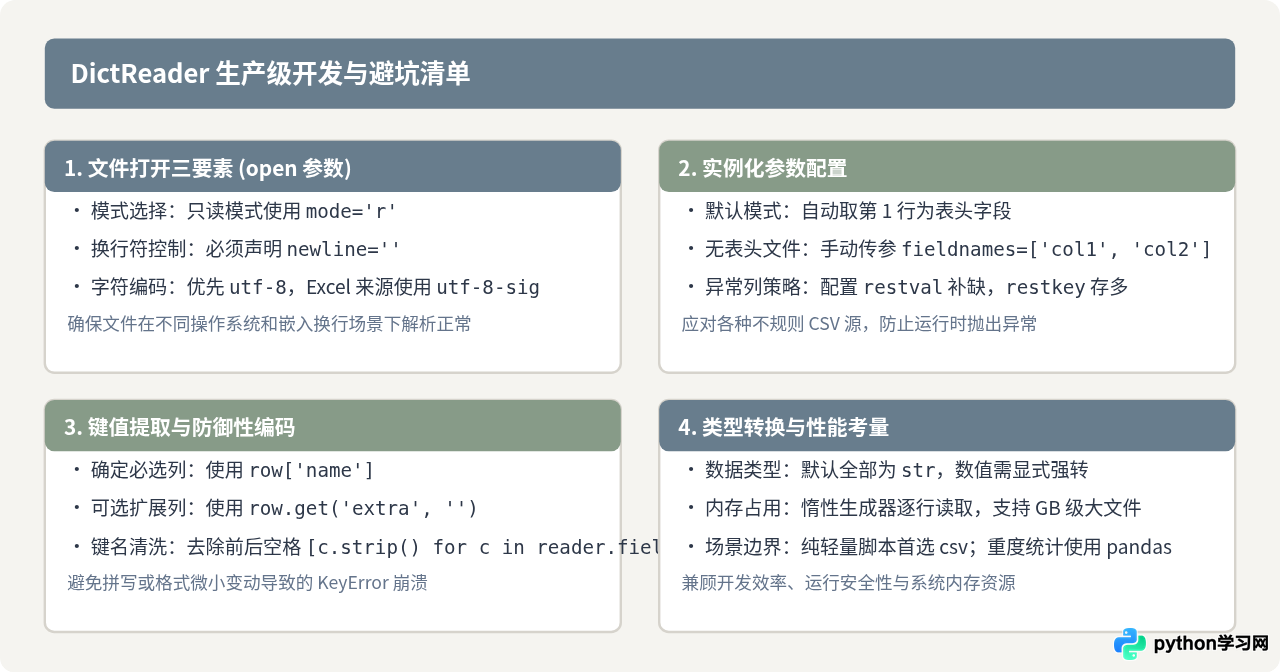
为了让读者在实际编写项目代码时快速对照核验,下方的全景速查图梳理了从打开文件、参数配置、字典遍历到异常预防的标准落地规范:
总结
Python 标准库的 csv.DictReader 是日常脚本与服务端处理 CSV 表头数据的标准解决方案。掌握它的关键在于理清三个核心要素:一是用好 newline='' 和 encoding='utf-8-sig' 规范打开文件;二是理解首行自动映射到 fieldnames 的机制,必要时通过 restval 与 restkey 保障非规整数据的兼容性;三是坚持按键名安全读取并显式完成类型转换。通过这种方式编写的 CSV 解析代码,无论在可读性还是在面对列变动的健壮性上,都能达到工程级要求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









